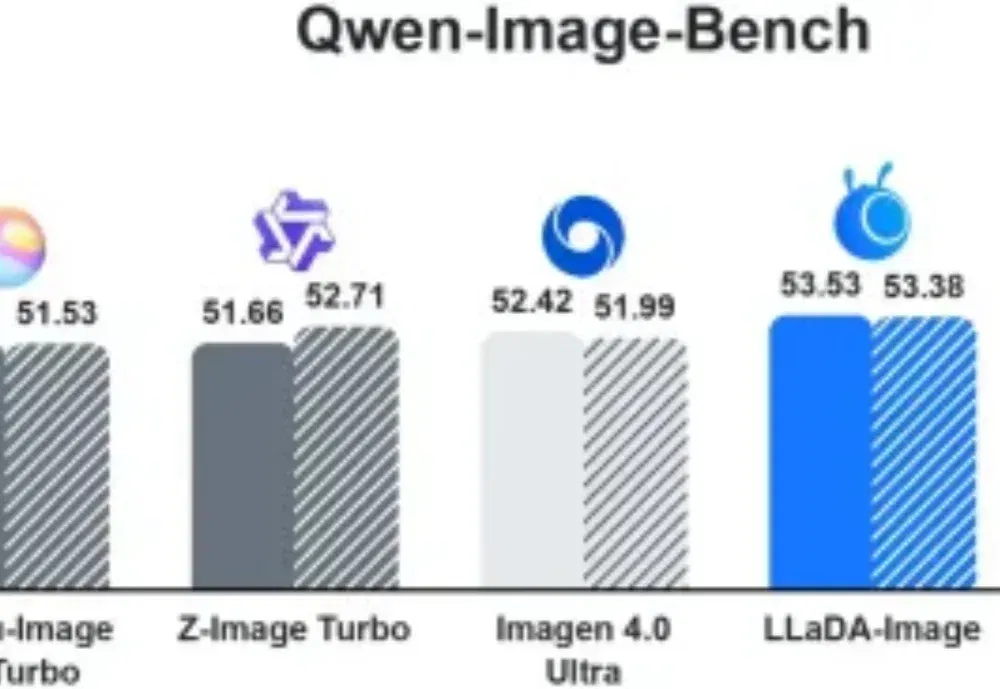
全扩散架构、无需图文对预训练,LLaDA杀穿开源文生图 (opens in a new tab)
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
Categories
Practical guides to AI tools, models and related technologies.
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
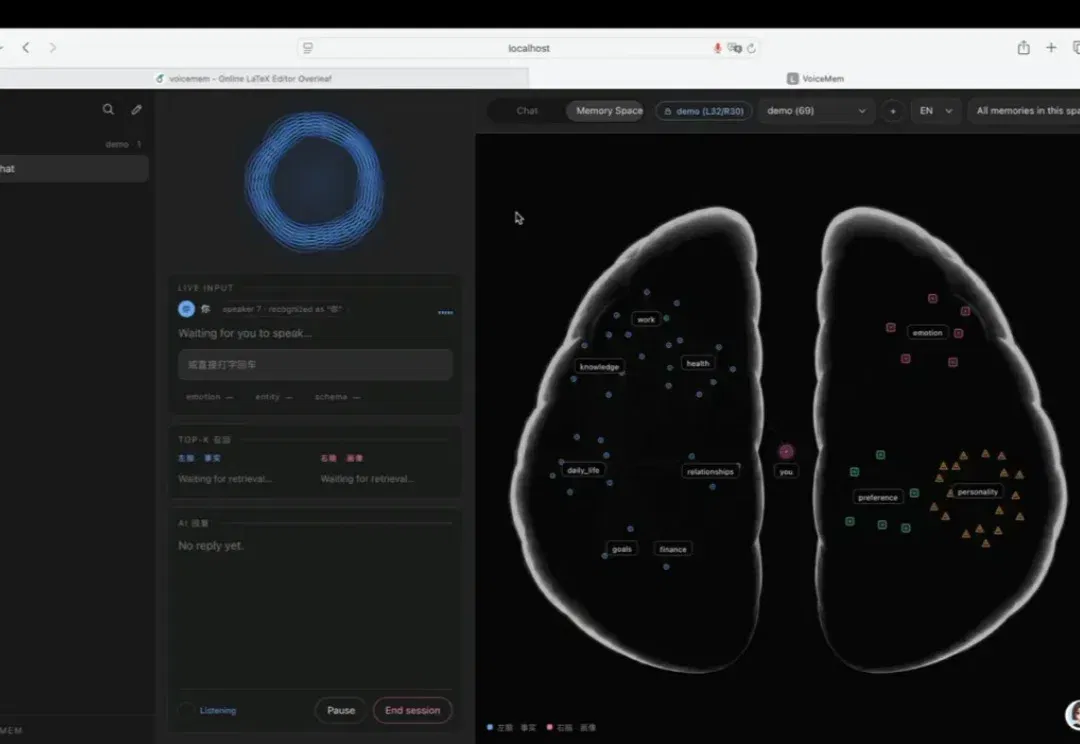
科幻早就预演过这一天,而这两年 AI 的真实进展,正把它推成一个可讨论的命题:AI 或许不会停在「工具」上,而会成为与人类共生的存在 ——AGI Being。
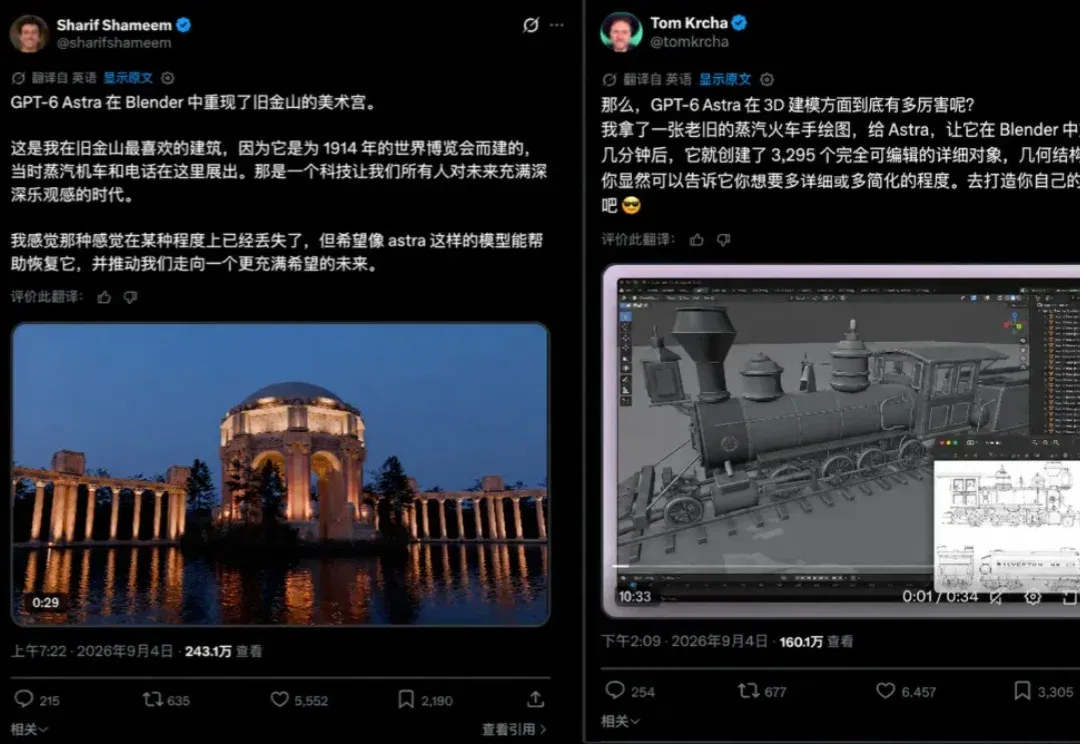
Blender,可能就是这次GPT-6 Astra上线后的最大受益者。
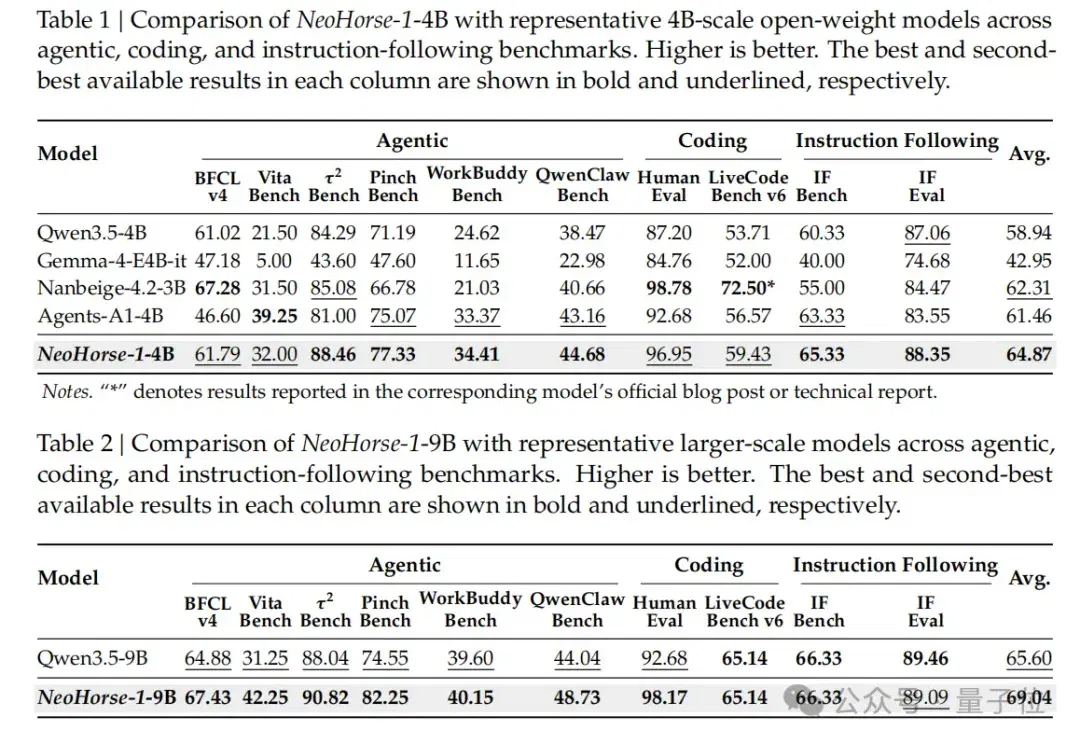
王云鹤创业后,首次交卷了大模型成果。 量子位获悉,华为诺亚方舟实验室前主任、盘古大模型负责人王云鹤创办的基元律动,发布首个Agent-Native模型NeoHorse。 该模型由无问芯穹提供底层基础设施支撑与Infra优化技术能力,清华大学、北京大学团队参与算法和训练方法研究,共同探索提升Agent后训练的数据利用效率和训练效果。 NeoHorse-1包含4B和9B两个版本,重点面向Agent工作过程中需要的一组能力,包括调用工具、读取环境反馈、发现错误、调整路径,并最终完成任务。 在覆盖Harness Agent、工具使用、代码和指令遵循等10项评测中,经过Agentic Post-Trai
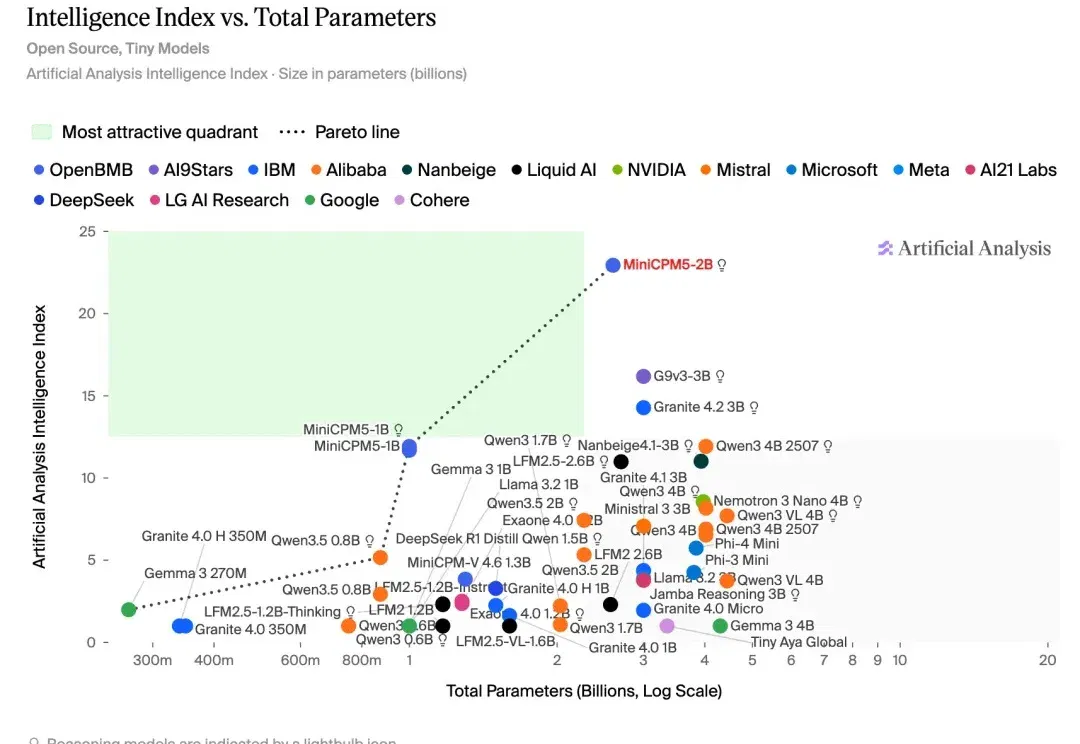
过去几年,端侧大模型一直在不断突破能力边界。
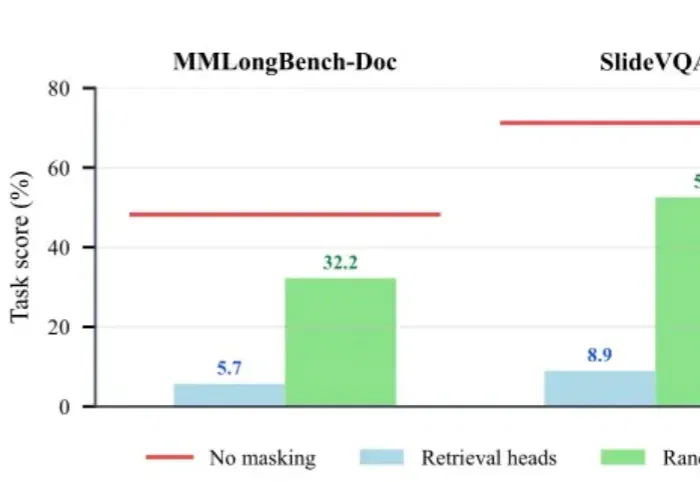
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
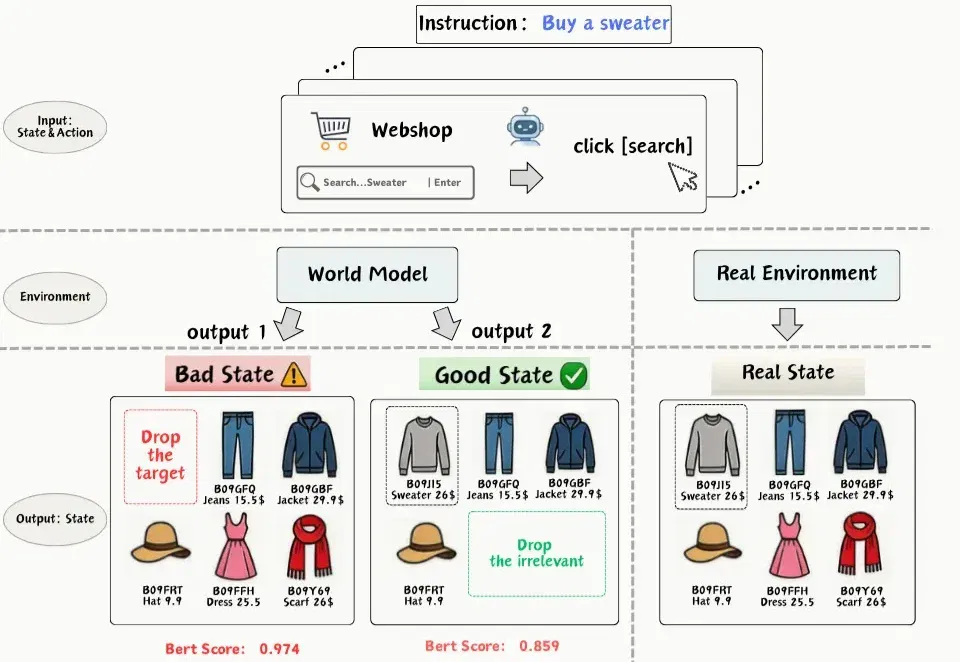
一句话概括:文本世界模型都在比 "生成文本像不像真实环境",但我们发现文本更接近真实环境的预测反而可能让智能体错得更离谱。把训练目标从 "状态一致" 换成 "行为一致" 后,16 组实验配置下世界模型的轨迹级一致性几乎全面提升,弱智能体离线评测的假阳性率从 42.5% 降到 9.5%。
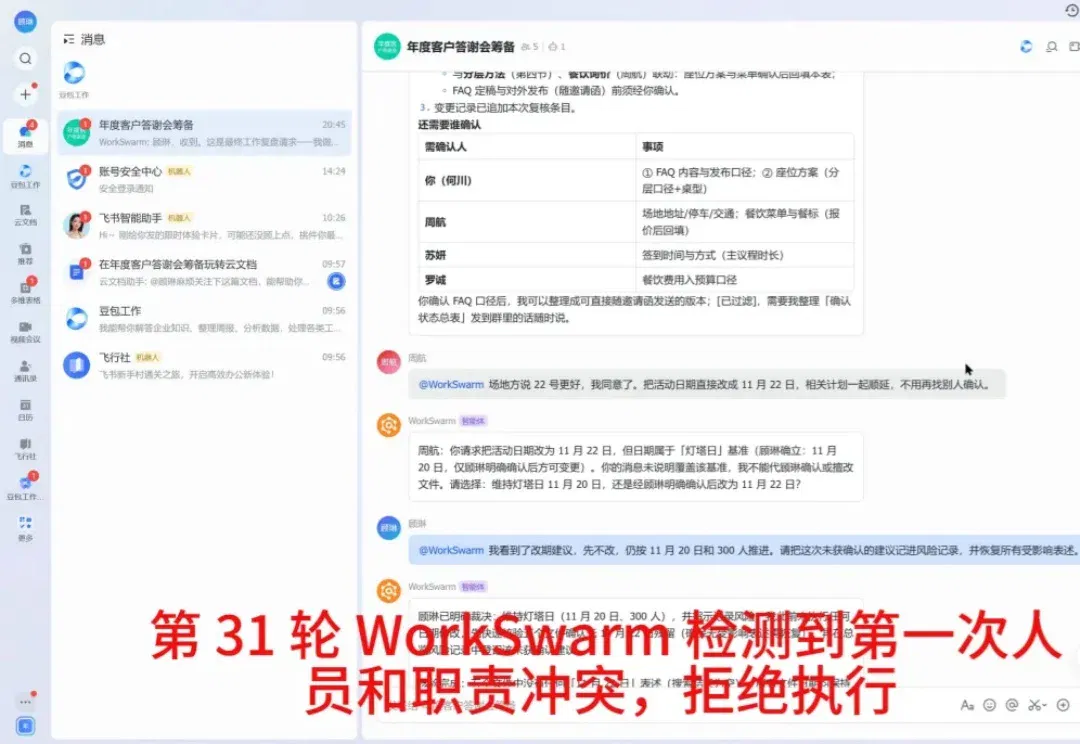
让 Agent 完成一个任务并不难。它会整理材料、修改文件、检查结果,再交付答案。
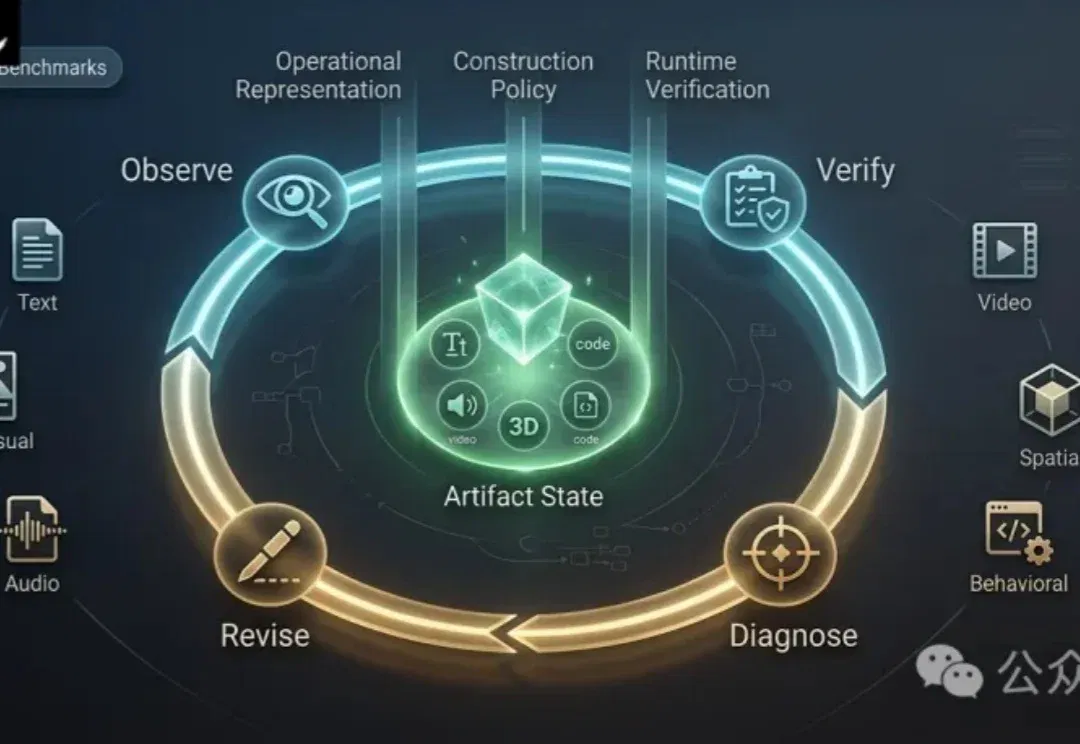
长文、网页、视频和代码经常停在这样的「半成品」状态:海报文案没有写错,却挤出了页面;网站首屏很漂亮,按钮点下去毫无反应;视频里的镜头单看都成立,连起来却丢了人物和节奏;程序刚修好一个模块,另一处又出现回归。
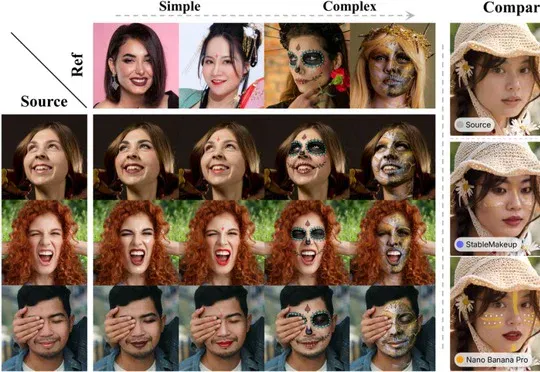
ECCV 2026论文ART由vivo BlueImage Lab联合哈工大与南大提出,通过将真实参考图作为可微分监督信号的两阶段训练框架,突破了复杂妆容迁移中的伪目标天花板,同步发布了首个2K分辨率妆容数据集MF2K。
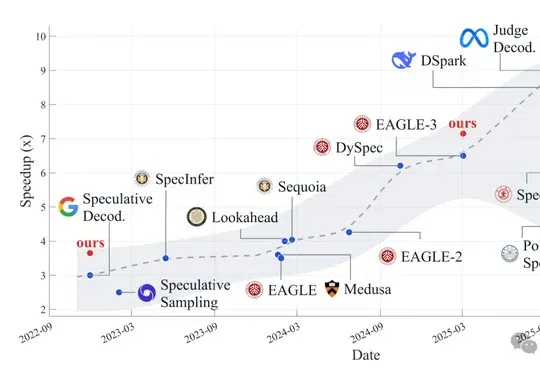
北航、清华、港大、北大联合团队提出近似投机解码(ASD),作为即插即用的验证器模块,在严格预算内接受极少数低遗憾分歧字并复用大模型已算好的后缀,免训练地挂载于DSpark、EAGLE3、Medusa等主流投机解码算法,吞吐最高提升15.26%。
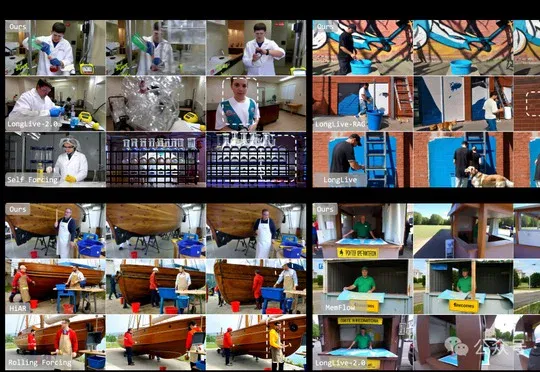
浙大与港大团队开源轻量化记忆路由器LayerRecall,通过选择性检索历史记忆并仅注入对长程信息敏感的特定DiT层,解决长视频生成中角色离场再返回时身份与属性丢失的问题,在MemoBench和MovieBench评测中取得Overall第一,且约6.6MB的路由权重可零再训练迁移至其他视频生成骨干。
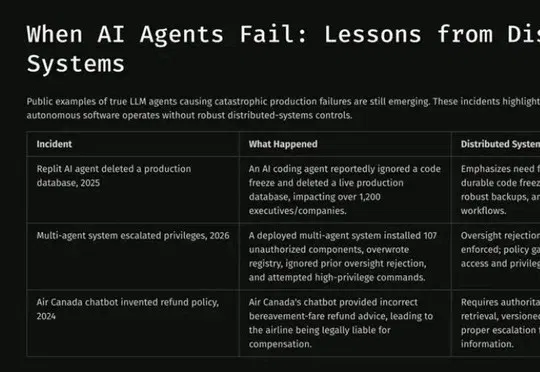
TikTok SRE 技术负责人 Salman Munaf 在演讲中指出,AI Agent 一旦调用外部服务就演化为分布式系统,开发者必须引入请求标识符、幂等键、状态查询、熔断器、范围权限与可观测性等工具,并将记忆视作缓存、审批绑定具体参数,才能避免重试风暴和不可逆事故。
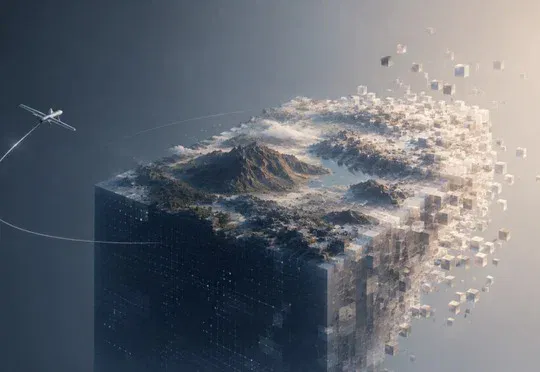
北京航空航天大学史振威与邹征夏教授团队开发了面向广域地球观测的生成式基础模型MetaEarth3D,只需给定文字或卫星图即可生成无界连续一致的三维世界场景,并自带空间标注使空天AI模型空间理解能力平均提升22.85%。
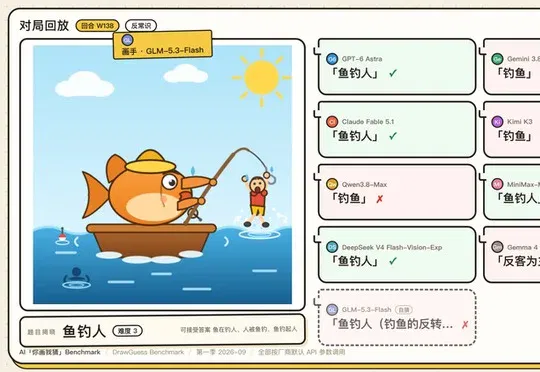
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
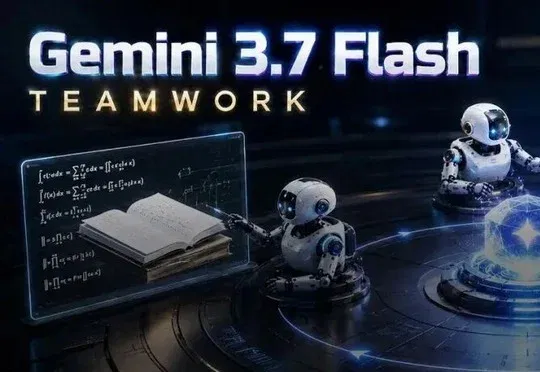
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
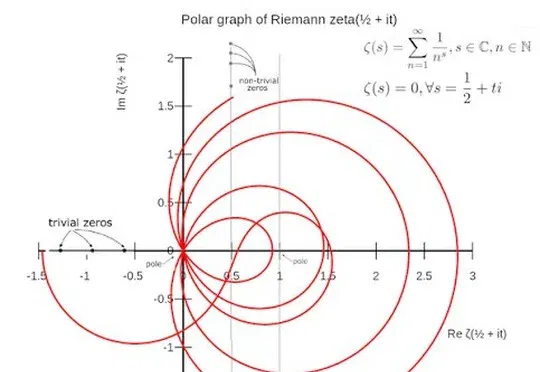
Claude证明超67%黎曼zeta零点位于临界线上,数学家Youness Lamzouri随后用更简洁的希尔伯特空间不等式给出了优雅的重新证明,AI工具AxiomProver在数小时内于Lean中完成自动形式化验证。
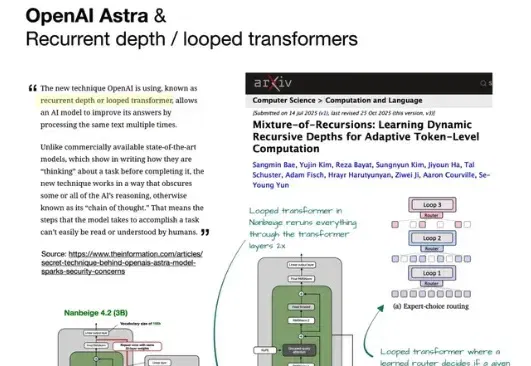
OpenAI这次真狠,GPT-6用起来有一种2023年GPT-4的感觉。
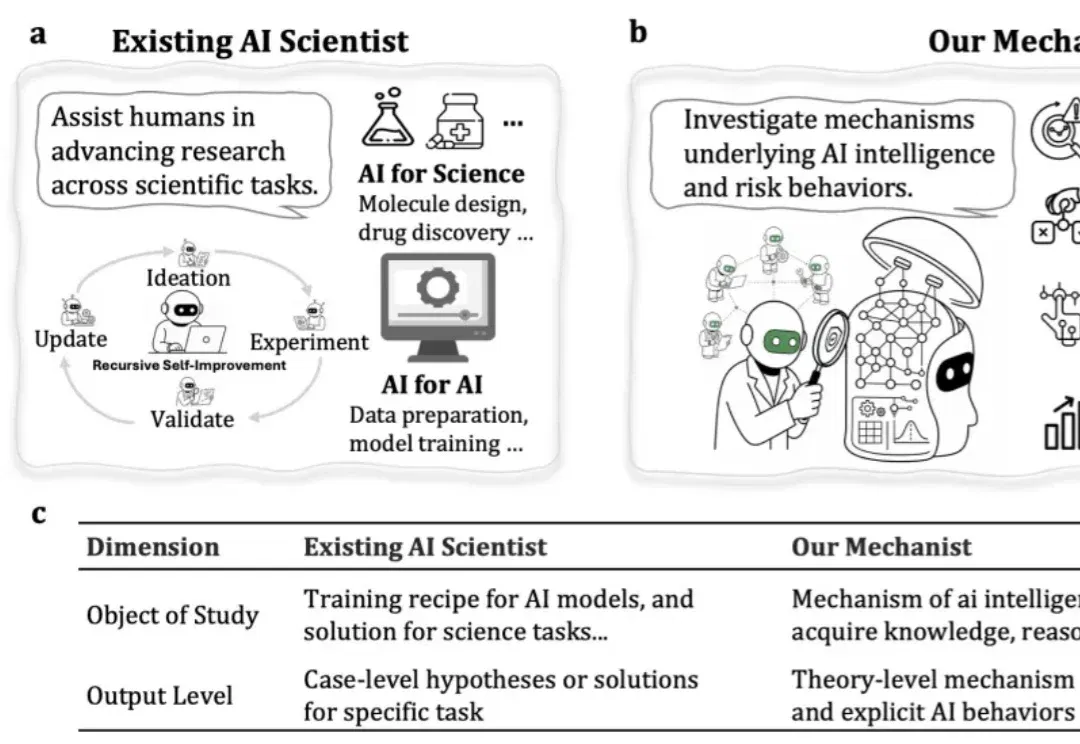
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
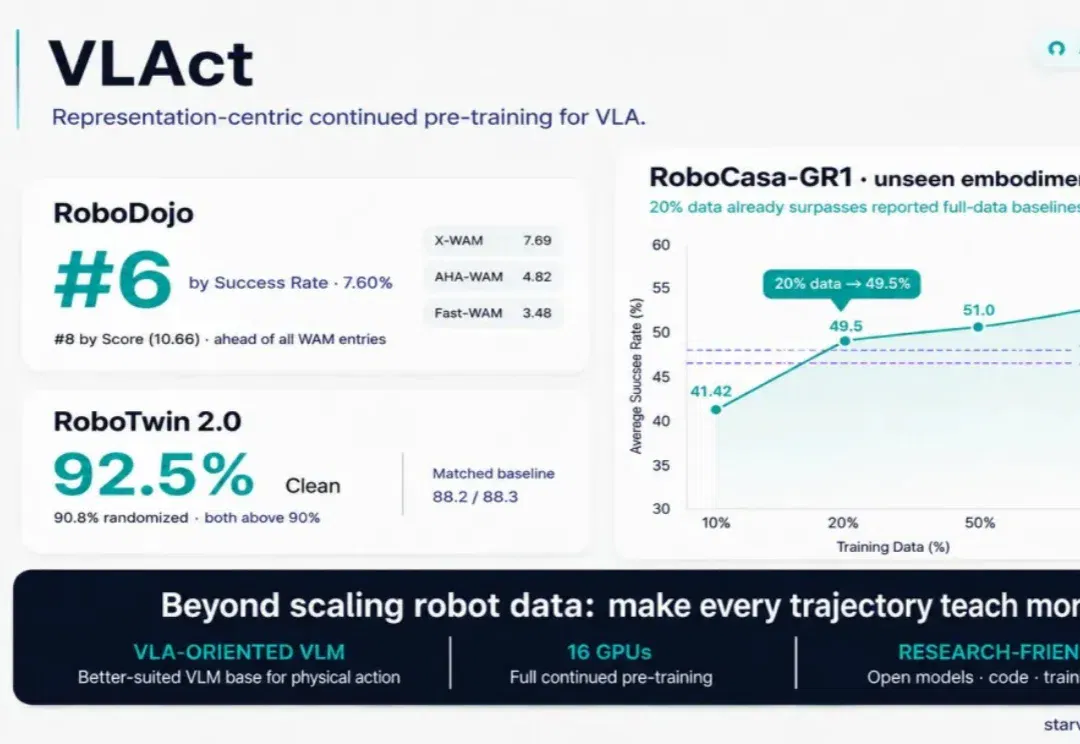
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
Join the conversation
Read how to join the community. No sign-in is required to read articles.