颜水成团队重磅发布VoiceMem,提出「流式双脑架构」打造下一代实时交互基础设施
科幻早就预演过这一天,而这两年 AI 的真实进展,正把它推成一个可讨论的命题:AI 或许不会停在「工具」上,而会成为与人类共生的存在 ——AGI Being。
科幻早就预演过这一天,而这两年 AI 的真实进展,正把它推成一个可讨论的命题:AI 或许不会停在「工具」上,而会成为与人类共生的存在 ——AGI Being。
共生的第一道门槛,是能跟人实时说话。这是 GPT-4o、全双工模型、Interaction Model 在做的事。
但用久一点,共同的短板就浮出来:它们没有记忆。听得懂你此刻在说什么,却不知道你是谁。认识始终是单向的 —— 你越来越熟悉它,它对你永远停在第一天。
没有记忆的交互系统是没有灵魂的,再流畅的陪伴者也逃不掉工具的身份。每次打开都要重新问你是谁;说过不吃坚果,明天照样推荐给你。
代价有两个:
1.信任被清零。消耗掉的不是效率,是刚建立起来的那点连接。
2.只会「答对」,学不会「懂你」。现有记忆只记信息:你说过什么、涉及到谁;但交互的另一半是情感 —— 你说「我没事」时的语气,提到某个人时不自觉地停顿 xq。
这正是 VoiceMem 在做的事:面向多模态陪伴者的类脑记忆系统,补全 Digital Embodiment 的第三根支柱。
这项工作也延续了论文第一作者谢之非的研究主线:他是目前大音频语言模型、实时语音交互与多模态 AI 领域内非常活跃的研究者之一。
VoiceMem 不是炒概念讲故事,而是四家顶级高校与 Open Interaction Lab 联合发布的记忆框架,工程优化充分,一行代码就能跑。目标是实时交互版的「Mem0」。
目前,Qwen Audio Agent 也已将 VoiceMem 接入为可选的记忆系统,让语音助手的记忆不止于文本,还可以从真实世界中记住语音、说话人、声音事件、音乐等丰富信息。
- 论文标题:VOICEMEM: STREAMING DUAL-BRAIN MEMORYFOR REAL-TIME INTERACTION
- Project page: https://xzf-thu.github.io/VoiceMem
- Code: https://github.com/xzf-thu/VoiceMem
- Report: https://arxiv.org/pdf/2608.26005
为什么是 VoiceMem
Mem0、Zep、MemOS 直接用不行吗?
不行,两个原因。
一、应用上,时间和信息输出都不可用。
语音留给「想一想」的时间太短。从你说完到 AI 开口,总预算约 400 毫秒,现有系统查一次要 2000 毫秒。而且文本 Agent 习惯一次返回上百条让模型自己挑,语音模型吃不下;少了,则有用信息锐减。
VoiceMem 把检索压到 VAD 后 134 毫秒(降低 65%),拆成四个子阶段执行,延迟几乎降到 0。左脑在 LongMemEval 上 Top-10 就能对应 Mem0 top-200 的精度,成本骤降 95%。
二、也是真正核心的,这些系统只管「信息」,接不住「情感」。
你是压力一大就闭口不谈的人,还是必须找人倾诉的人?这不是信息,这是「你」这个人本身。
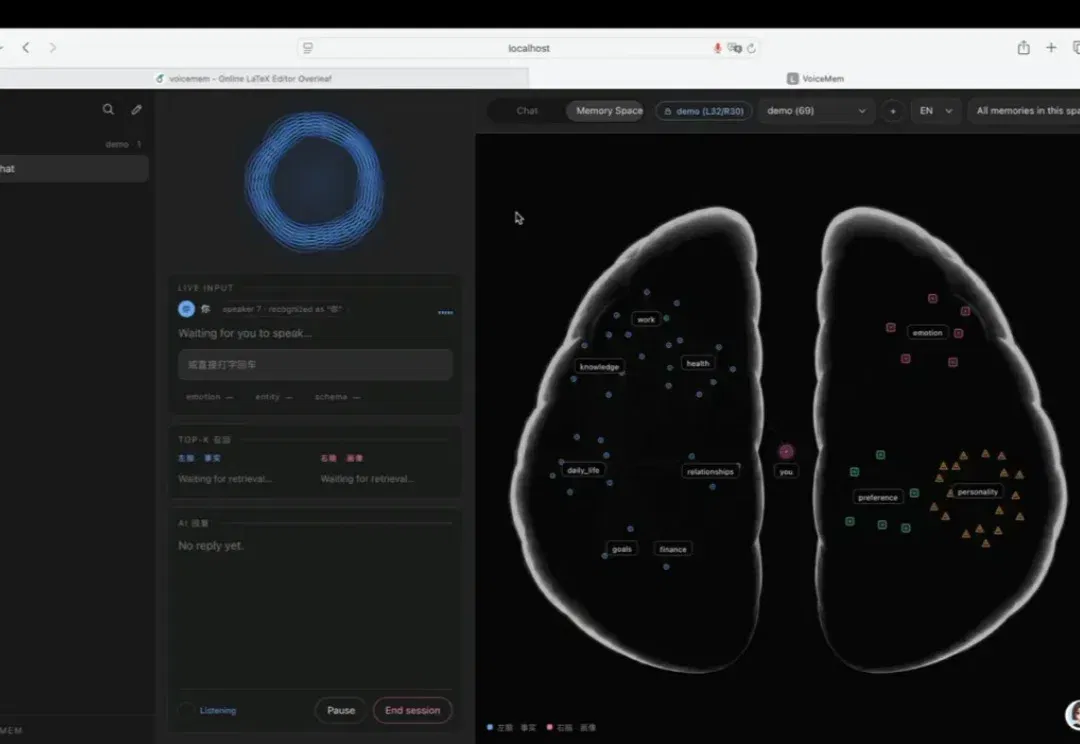
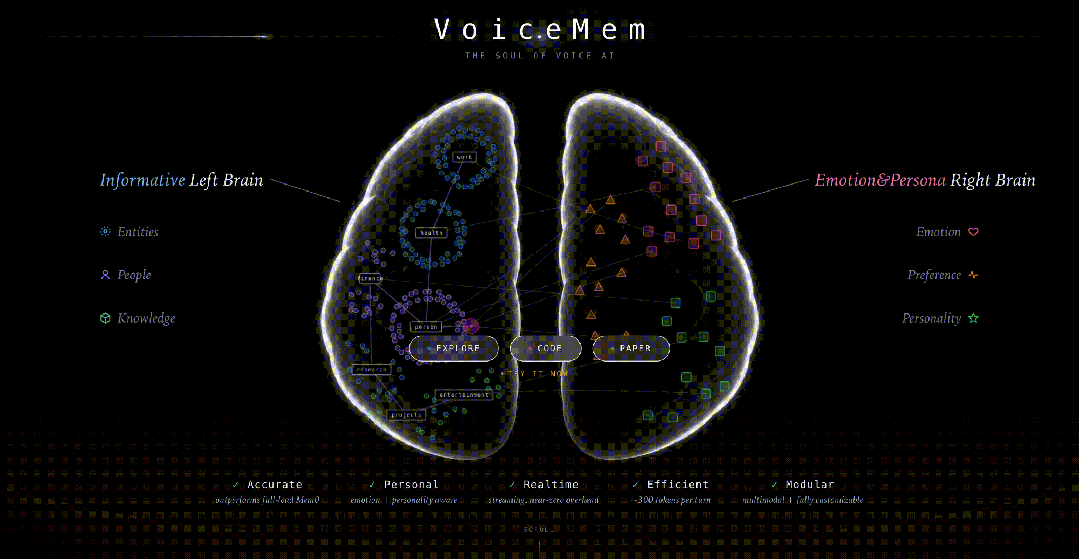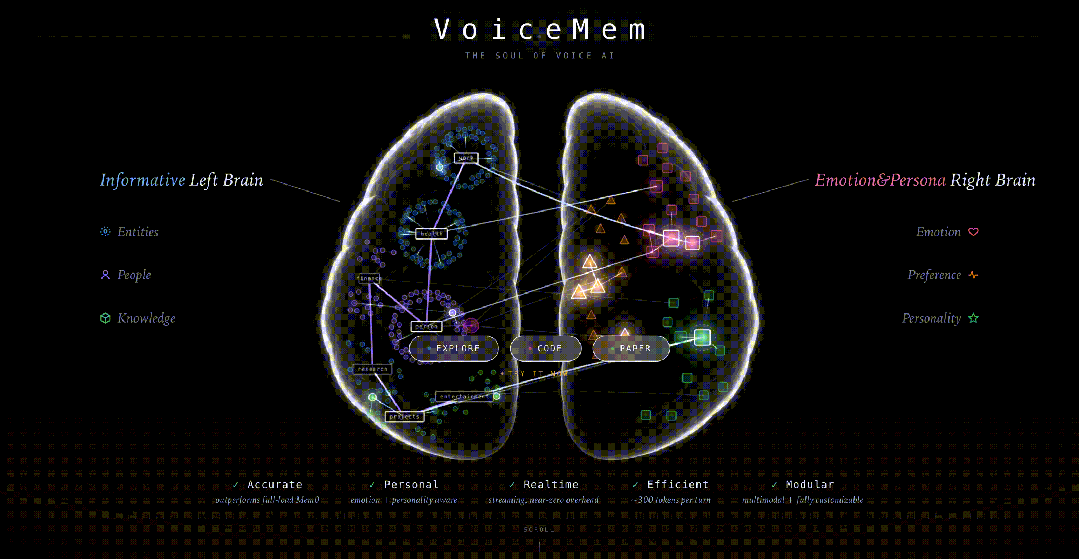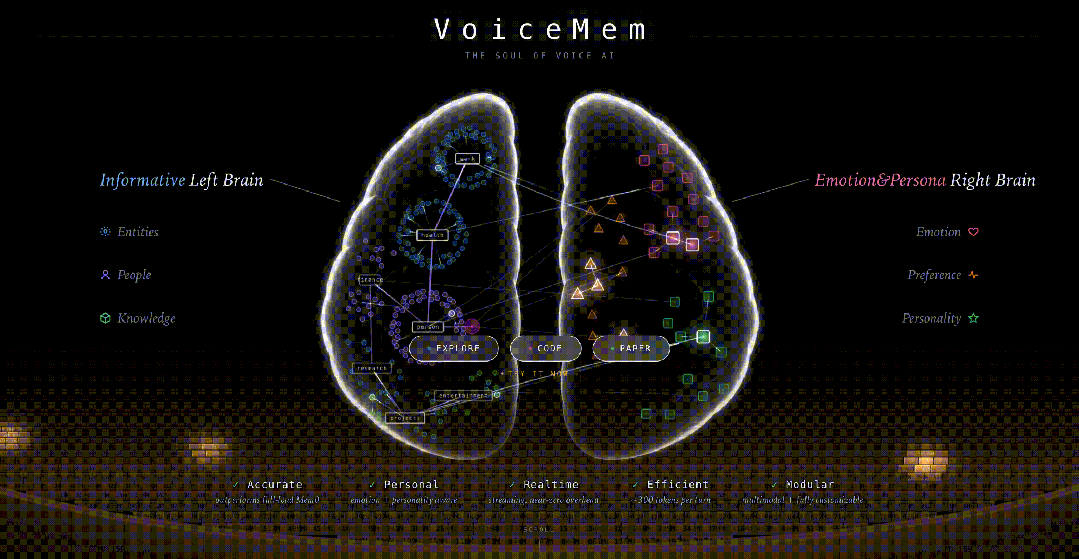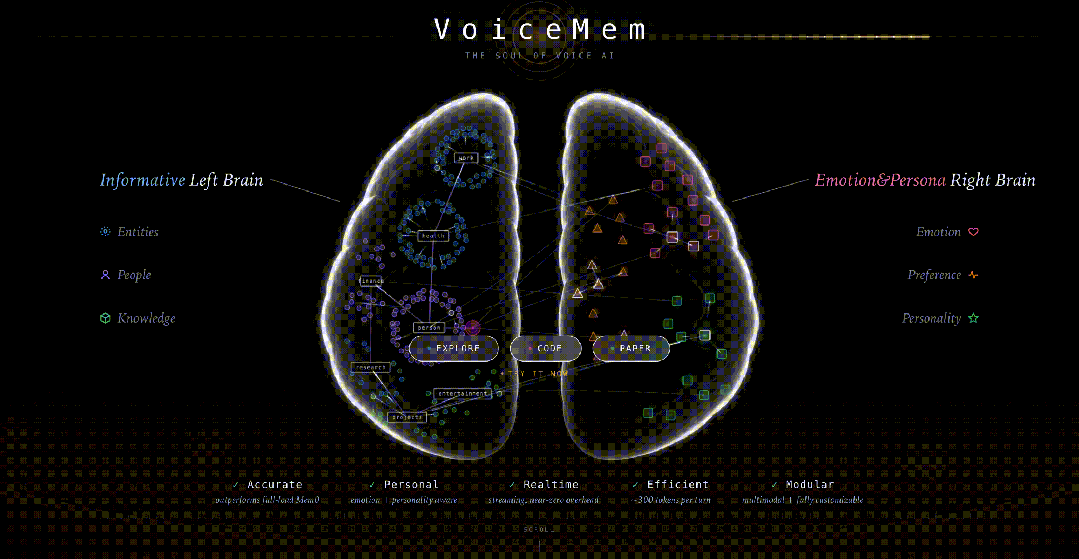
VoiceMem 的解法是「流式双脑架构」。别害怕,原理很简单:
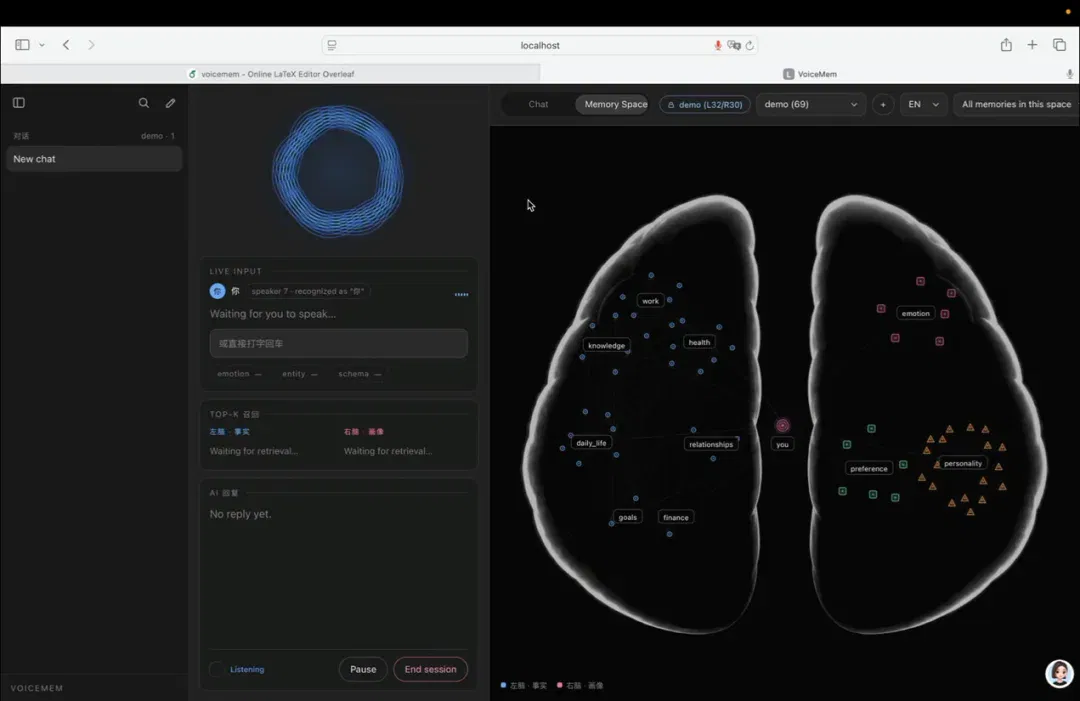
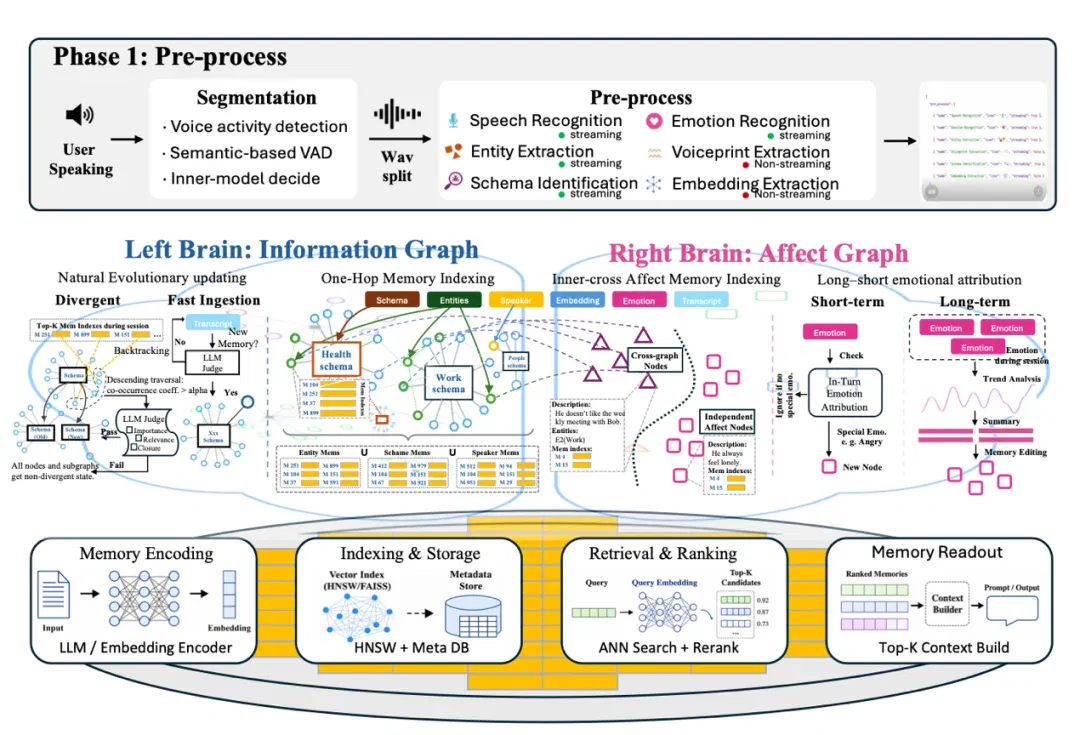
- 信息左脑|Informative Left Brain—— 双层图检索:上层联想层 + 下层检索层(兼容 Mem0 / Zep),节点是实体、人物、知识,毫秒级取回事实。
- 情感右脑|Emotional Right Brain—— Identity nodes 沉淀稳定人格,Joint nodes 把情绪与偏好绑定到左脑的每一条记忆之上。
两个脑并行处理、独立维护,再通过联合节点作为【桥梁】共享信息。
所以当 AI 想起「上周三你提过的那个项目」,它同时想起的是你当时的语气。事实和情绪一起被取回。
当 AI 记得住昨天,它才第一次真正「认识」你;当它记得住你的一生,它才可能成为你的另一个自己。记忆不是 AGI Being 的一个功能,而是它成立的前提。如果你在用语音助手,千万别错过。
下面分三章介绍:左脑、右脑的管理机制,以及 VoiceMem 为什么能「流起来」。
左脑:通过涌现机制控制信息密度
日常检索最容易翻车的地方,是 "搜得到但搜不对"。比如你问 "上次体检结果怎么样",系统按字面相似度捞回来几条记忆,结果一大半只是沾了 "体检" 这个词的边,真正有用的都被挤了出去。
问题不是排序不够聪明,是搜索的范围。
VoiceMem 的做法是先给记忆用簇 - 实体来组织,并建立内部的粗 - 细粒度关联。问题一来,先顺着多层联合搜索把范围收窄,再在这个小圈子里搜。
他们左脑最核心的算法,叫涌现。是专门用来适应长期信息积累的。涌现机制根据节点的被搜索情况建立内部关系子图,再用 LLM 对重要性,必要性和相关性和评估,做最适合长期的簇的划分。
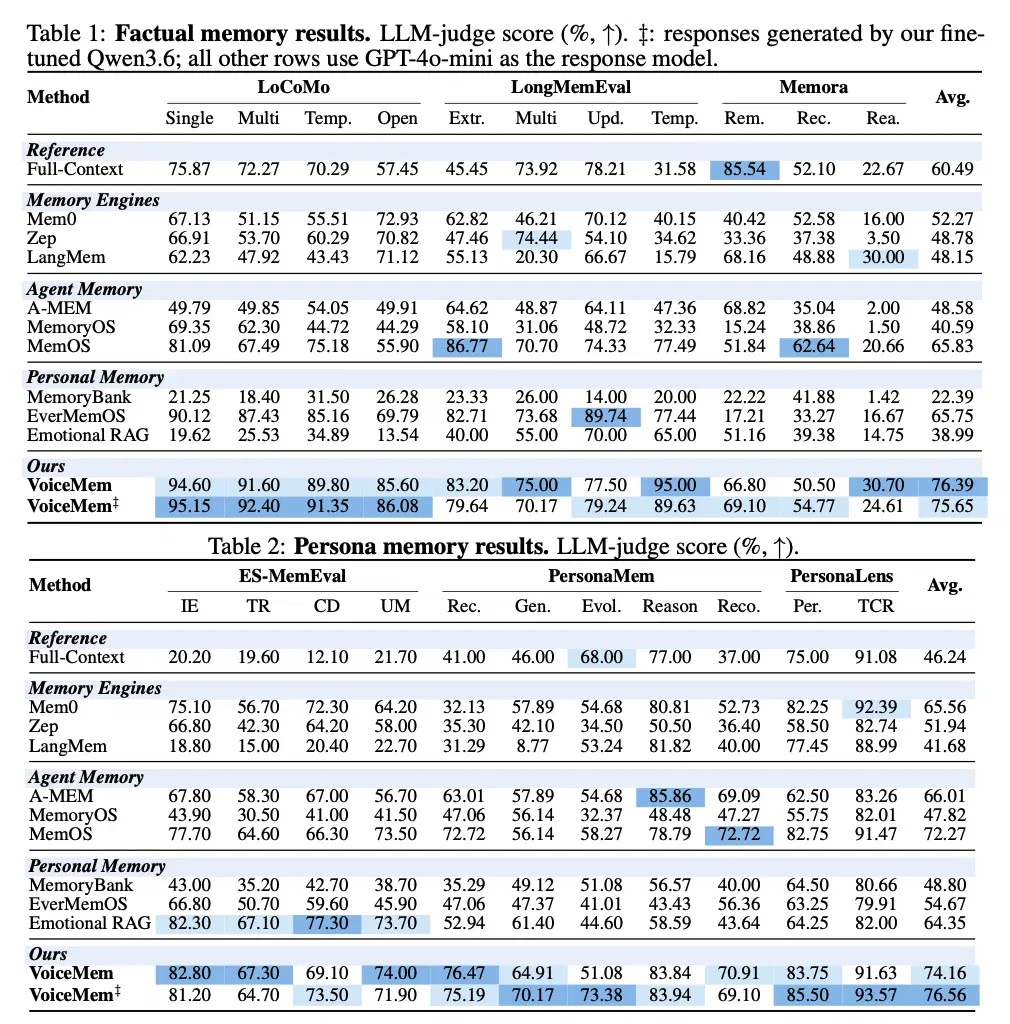
效果很直接:在权威的长对话记忆测试 LoCoMo 上,左脑只用五条记忆就拿到 91.2 分,而 Mem0 就算给到上百条记忆,也只有 61.68 分。
右脑:记住你的情绪,更记住 “你” 究竟是谁
左脑记的是发生过什么,右脑记的是你是一个什么样的人:你的性格、你的情绪习惯,以及这些情绪是冲着谁、冲着哪件事去的。「他不喜欢每周的例会」和「他这个人容易焦虑」,是两种东西,得分开记。
VoiceMem 右脑的核心算法是长短期情绪归因。一边在短期对话里实时捕捉情绪,一边在长期维护中回头观察、归因、总结,把反复出现的情绪沉淀下来,变成对这个人的稳定认识。
时间一长,它才算是个懂你的陪伴者。
测试里有个现象值得说:有些冲突和用户偏好,答案其实全写在对话记录里,但普通模型并不在意。
VoiceMem 靠右脑把分数从一成多拉到七成以上。反过来,把右脑整个拿掉,纯信息类的题目分数也会跟着掉。情绪和人格里藏着事实库里没有的信息。
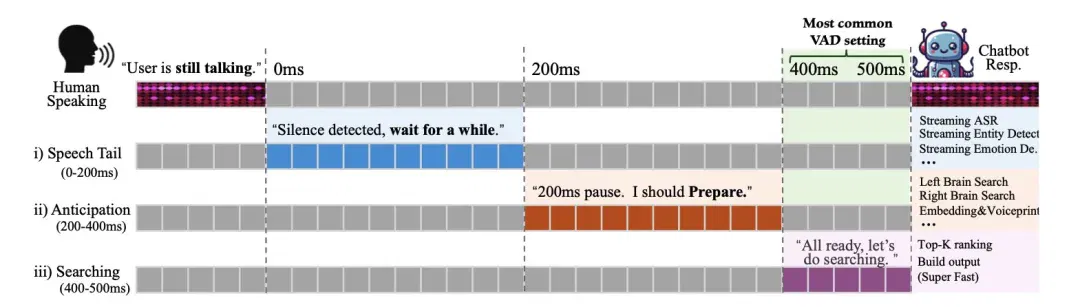
流式记忆架构 - 搜索机制协同设计
时间是记忆系统的核心挑战之一:用户期待记忆被即时调用,但真正的 “零延迟” 几乎是不可能完成的任务。
VoiceMem 从三个层面解决这个问题。前两点很直接:一方面将查询收敛到 Top-5,减少检索开销;另一方面控制返回信息量,让记忆读取足够快。
更关键的是第三点,从机制上打掉延迟:VoiceMem 的记忆架构本身就是围绕检索时延设计的。整个检索过程被拆成 listening、speech tail(0–200 ms)、anticipation(200–300 ms)和 searching(300–340 ms)四个阶段,在用户还没有说完时,就已经并行完成 ASR、实体与 schema 匹配以及图扩展,只把真正的后端搜索留到最后。
最终,完整的双脑检索过程被压缩到仅 134 ms,并进一步完全隐藏在标准 VAD 的 300 ms 静音等待窗口内,因此不会给对话增加可感知的额外延迟。
好玩的是,研究人员为了让 voicemem 更容易上说,还真把它的流式代码和 vad 做的完全一样,一行运行。
实验:更快,更准,更懂你。
除了在学术界经典 benchmark 上面进行跑分,我们更想知道它在真实场景里好不好用。为此,我们专门做了一套贴近真实生活的评测集,涵盖信息、人格、情感归因、副语言和环境等多个维度。
结语
VoiceMem,据我们所知是目前唯一的实时交互可用的记忆。但我们的目标,远远不只是给语音模型外挂一层 Memory,而是让记忆真正成为实时交互系统的一部分。
接下来,我们会继续沿着三个方向持续探索。
第一,扩展多模态记忆的边界。从今天对语音、语义与情感线索的理解,走向更完整的 Moments。
第二,继续优化 “左右脑” 的长期进化能力。人的记忆从来不是一个不断膨胀的数据库,而是在遗忘、强化、抽象、联想与重构中持续变化。
第三,把实时 Memory 做到真正可部署。我们会继续压低推理成本与延迟,优化一卡多进程、多 Agent 并发和长期运行能力,让 voicemem 成为语音陪伴、具身智能、智能硬件与实时 Agent 的基础设施。
我们一直在想一个问题:如果有一天 AI 真的成为一种 Being,什么构成它的意识与自我? 最终的答案就是记忆。
因为没有记忆,就没有过去;没有过去,就没有连续的自我。某种意义上,记忆就是意识得以发生的前提。
VoiceMem 的目标,不在此刻,是把实时交互领域即插即用,稳定可用、实时、能够长期进化的 Memory 做出来。
我们期待有一天,agi being 出现,并和人类产生真正的链接。
作者简介
论文第一作者为谢之非,尾作及通讯作者为颜水成。
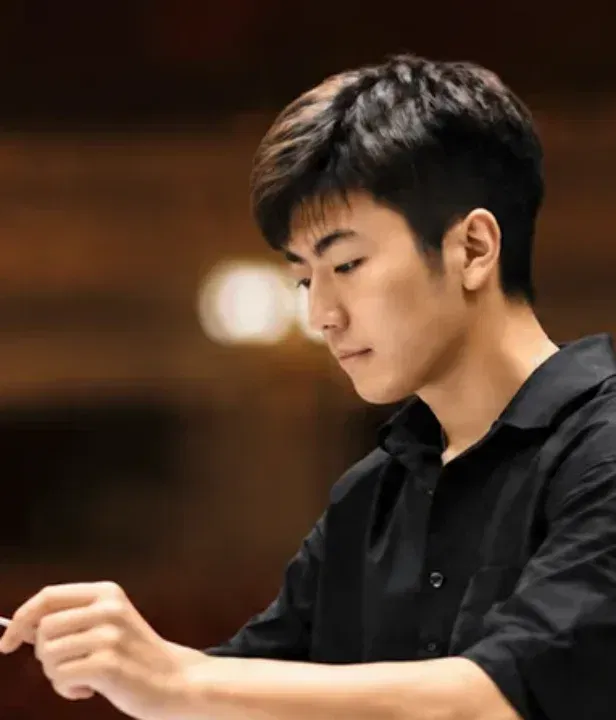
谢之非现为南洋理工大学 LV-Lab 博士生,研究聚焦实时音视频交互。第一作者研究成果获超 600 次引用,其相关开源项目已累计获得 8.5K+ GitHub Stars,曾主导首个端到端语音对话模型 Mini-Omni 系列,FFASR leaderboard rank-1 的 Mega-ASR 全场景语音识别等项目。
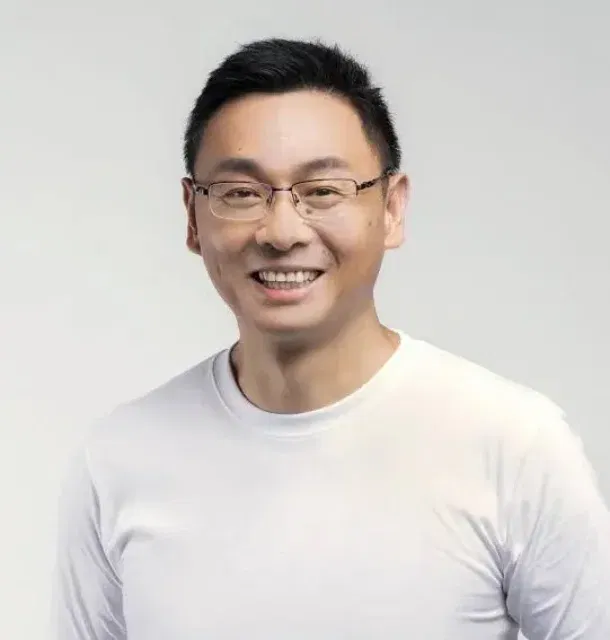
颜水成现任新加坡国立大学计算机学院杰出教授,曾任 Sea 集团首席科学家,是新加坡工程院院士及 AAAI、ACM、IEEE 和 IAPR 会士,连续十年入选全球高被引科学家。其 Google Scholar 总引用超过 13.6 万次,曾提出 Network In Network(NIN)架构,并采用全局平均池化替代传统全连接层。
从 Mini-Omni 解决端到端实时语音对话,到 Audio-Reasoner 和 Audio Interaction Model 推进音频推理与主动交互,再到 VoiceMem 补上长期记忆,这项工作延续了他围绕实时语音 Agent,逐步完善感知、推理、交互与记忆能力的研究路线。
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
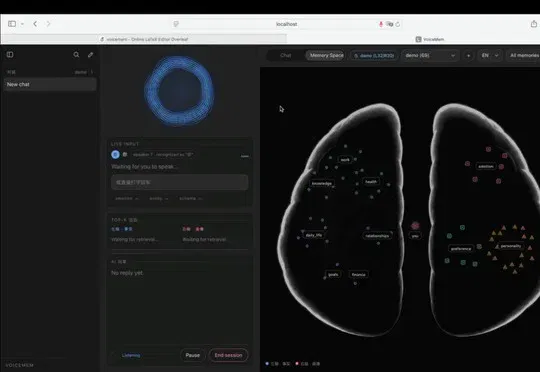
对话已死,共生永生:颜水成团队发布 VoiceMem,为 AGI 找回「丢掉的昨天」 (opens in a new tab)
颜水成团队发布语音领域首个实时“流式双脑架构”记忆框架,左脑记信息,右脑记住你。 编辑丨岑峰 科幻电影曾无数次预演过AI与人类共生的场景。但在2026年的今天,尽管GPT-4o、全双工模型、Inter
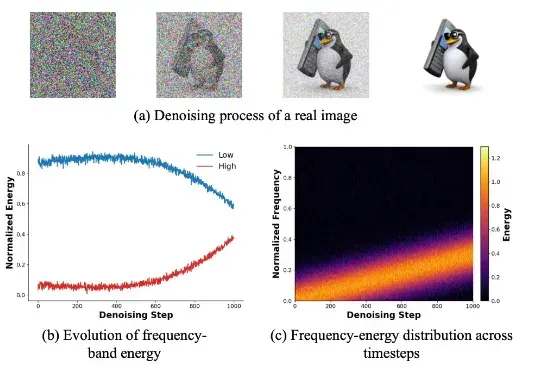
NUS LV Lab新作|FeRA:基于「频域能量」动态路由,打破扩散模型微调的静态瓶颈 (opens in a new tab)
新加坡国立大学 LV Lab(颜水成团队) 联合电子科技大学、浙江大学等机构提出 FeRA (Frequency-Energy Constrained Routing) 框架:首次从频域能量的第一性原理出发,揭示了扩散去噪过程具有显著的「低频到高频」演变规律,并据此设计了动态路由机制。
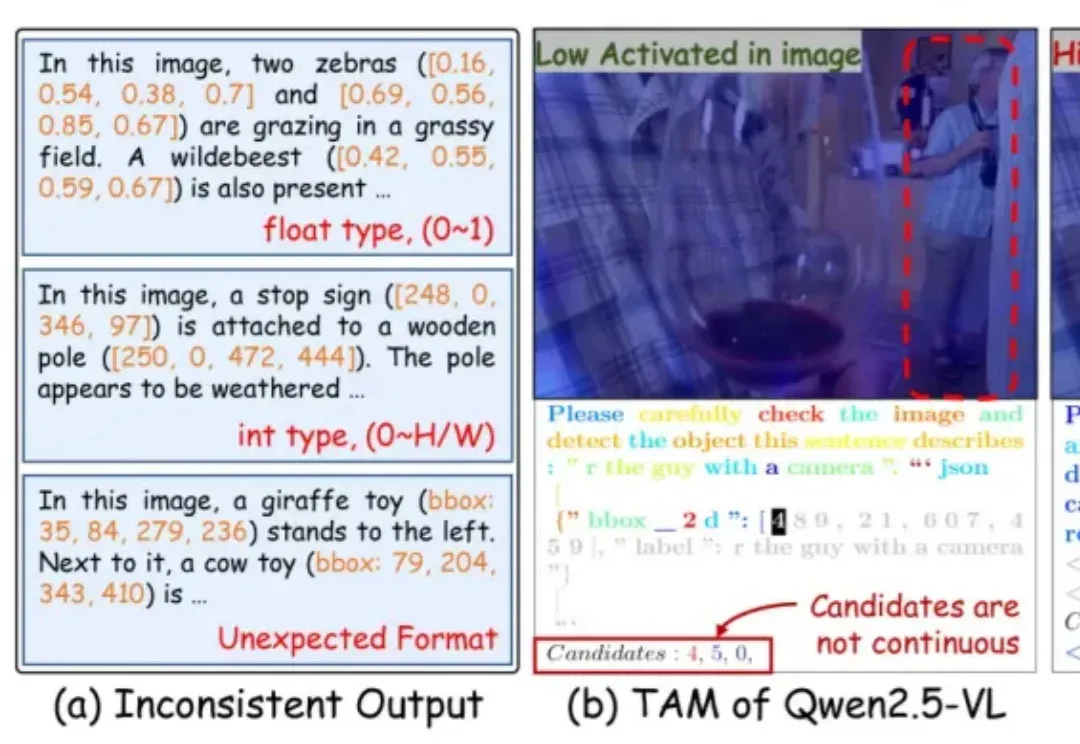
不再靠「猜坐标」!颜水成团队等联合发布PaDT多模态大模型:实现真正的多模态表征输出 (opens in a new tab)
近年来,多模态大语言模型(Multimodal Large Language Models, MLLMs)在图文理解、视觉问答等任务上取得了令人瞩目的进展。然而,当面对需要精细空间感知的任务 —— 比如目标检测、实例分割或指代表达理解时,现有模型却常常「力不从心」。
实时交互模型:一个还没形成共识的赛道,怎么就成了热门? (opens in a new tab)
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
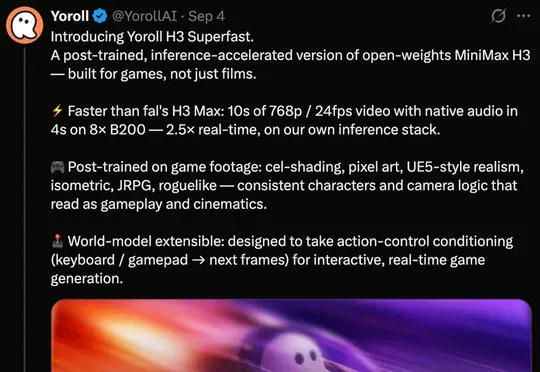
AI互动内容公司发布后训练模型 Yoroll H3 Superfast (opens in a new tab)
AI视频生成正从质量竞争转向实时速度竞争,AI互动内容公司Yoroll基于开源MiniMax H3模型推出后训练模型Yoroll H3 Superfast,可在4秒内生成10秒768p带音频视频,并上线由其驱动的实时互动叙事产品YoLive。