AI基建的高潮,2025年才真正开始 | 笔记 (opens in a new tab)
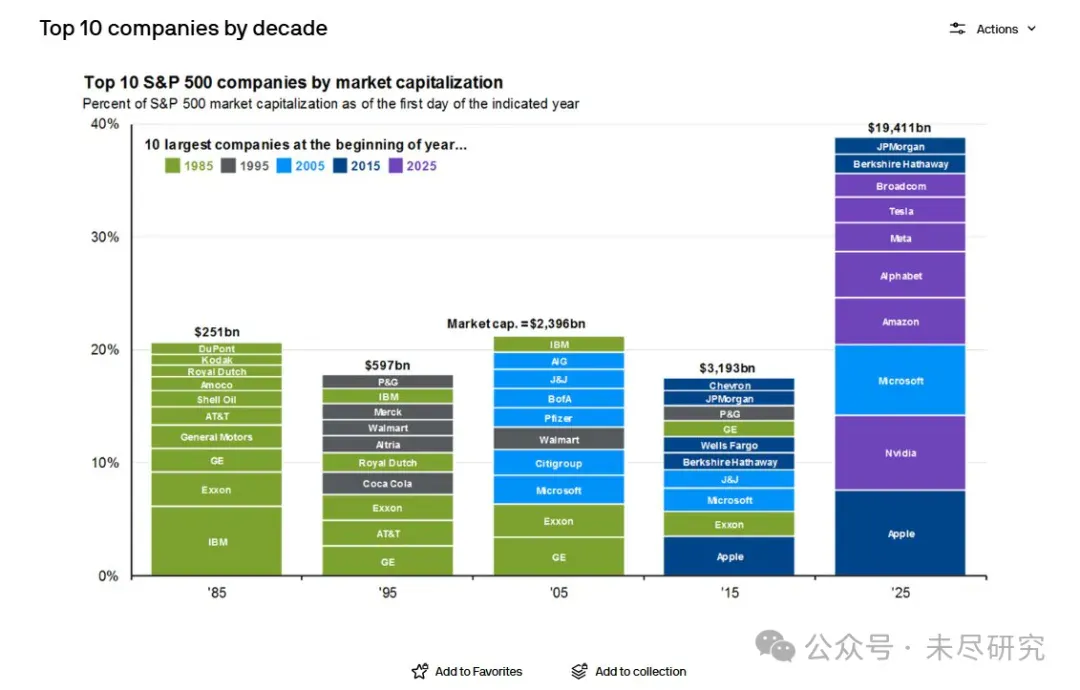
AI正在把科技与资本结合的力量,推向一个新的市场高度。先看这张图,基本上能说明过去40年美国经济与产业的演变。 1985年初的美国十大公司,到2015年仅剩下两家,到2025年全部消失。1985年,主
Categories
Practical guides to AI tools, models and related technologies.
AI正在把科技与资本结合的力量,推向一个新的市场高度。先看这张图,基本上能说明过去40年美国经济与产业的演变。 1985年初的美国十大公司,到2015年仅剩下两家,到2025年全部消失。1985年,主
不是拼凑知识点,AI这次是真搞研究。一个叫Virtuous Machines的AI系统,花了17小时、114美元,找了288个真人做实验,写了一篇30页的学术论文。而且还是从选题到成稿全自动化速通!?
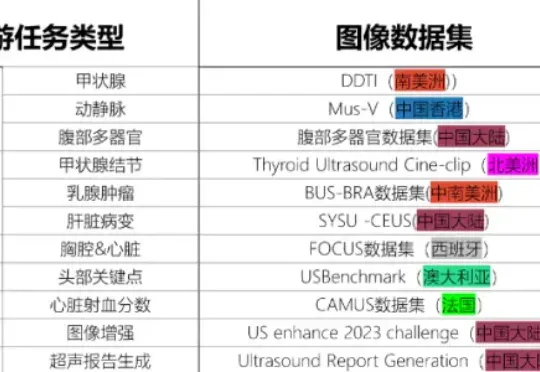
2025年9月17日,中国科学院香港创新研究院人工智能与机器人创新中心(CAIR)在香港正式开源发布其最新科研成果——EchoCare“聆音”超声基座大模型(简称“聆音”)。该模型基于超过450万张、涵盖50多个人体器官的大规模超声影像数据集训练而成,在器官识别、器官分割、病灶分类等10余项典型超声医学任务测试中表现卓越,性能全面登顶。
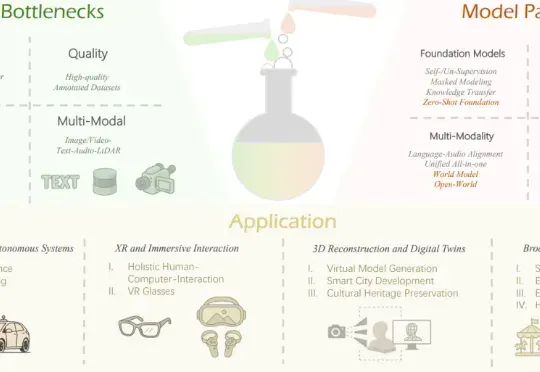
本文作者团队来自 Insta360 影石研究院及其合作高校。目前,Insta360 正在面向世界模型、多模态大模型、生成式模型等前沿方向招聘实习生与全职算法工程师,欢迎有志于前沿 AI 研究与落地的同
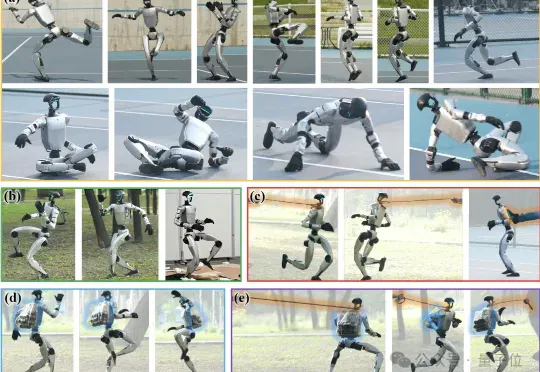
连续飞踢一台机器人30秒会发生什么?那么,是什么让这台机器人怎么踹都踹不倒呢? 答案就出自银河通用的全新通用动作追踪框架——Any2Track。
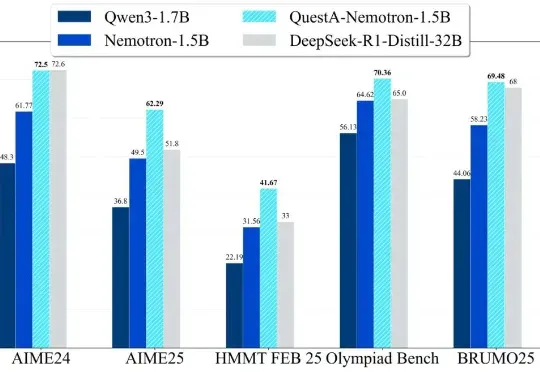
QuestA(问题增强)引入了一种方法,用于提升强化学习中的推理能力。通过在训练过程中注入部分解题提示,QuestA 实现两项重大成果
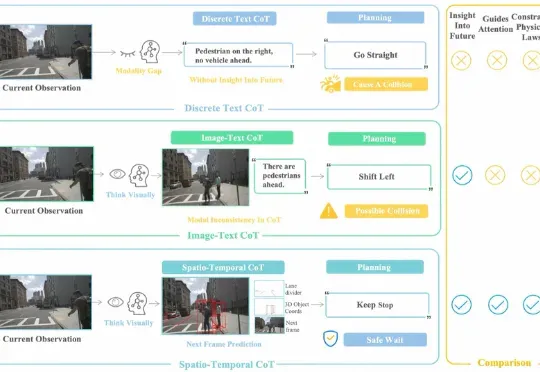
面向自动驾驶的多模态大模型在 “推理链” 上多以文字或符号为中介,易造成空间 - 时间关系模糊与细粒度信息丢失。FSDrive(FutureSightDrive)提出 “时空视觉 CoT”(Spatio-Temporal Chain-of-Thought),让模型直接 “以图思考”,用统一的未来图像帧作为中间推理步骤,联合未来场景与感知结果进行可视化推理。
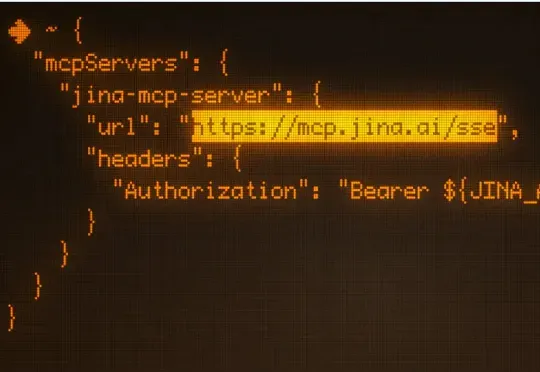
模型上下文协议 (MCP) 是连接 LLM/Agent 与外部工具的通信标准。它允许 LLM 动态发现并调用 API工具,将他们串成一个完整的工作流,从而实现自主规划、推理与执行。 上个月我们悄悄发布
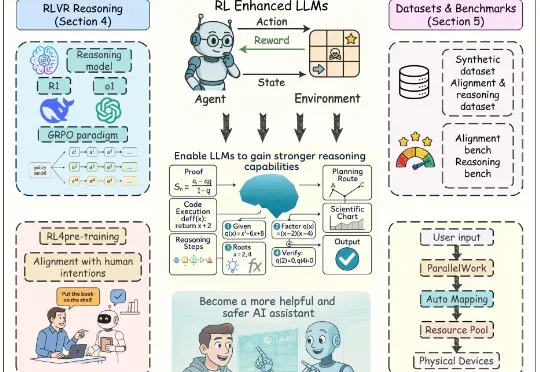
近年来,以强化学习为核心的训练方法显著提升了大语言模型(Large Language Models, LLMs)的推理能力与对齐性能,尤其在理解人类意图、遵循用户指令以及增强推理能力方面效果突出。尽管现有综述对强化学习增强型 LLMs 进行了概述,但其涵盖范围较为有限,未能全面总结强化学习在 LLMs 全生命周期中的作用机制。
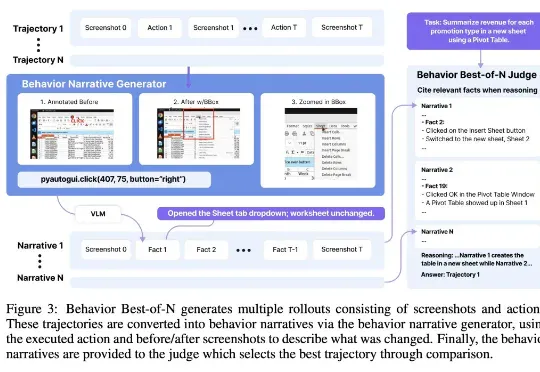
Agent(智能体)是最近一段时间的人工智能热点之一,将大语言模型的能力与工具调用、环境交互和自主规划结合起来,使其能够像虚拟助理一样完成复杂任务。 其中「计算机使用智能
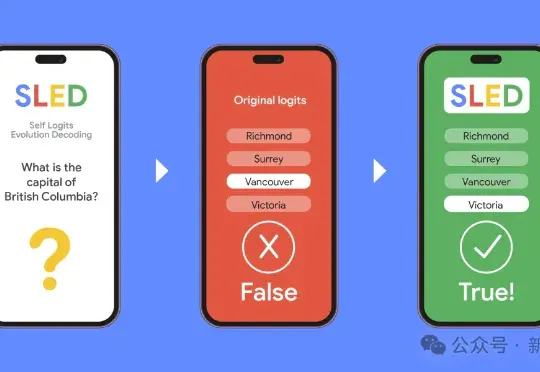
大模型最让人头疼的毛病,就是一本正经地「瞎编」。过去,只能靠检索补丁或额外训练来修。可在NeurIPS 2024 上,谷歌抛出的新方法SLED却告诉我们:模型其实知道,只是最后一步忘了。如果把每一层的「声音」都纳入考量,它就能从幻觉中被拉回到事实。
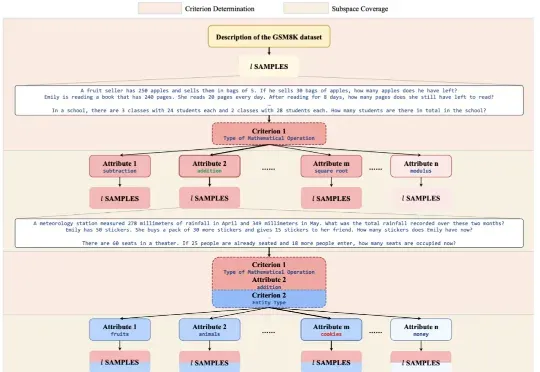
“TreeSynth” 就这样起源于作者们最初的构想:“如何通过一句任务描述生成海量数据,完成模型训练?” 同时,大规模 scalibility 对合成数据的多样性提出了新的要求。
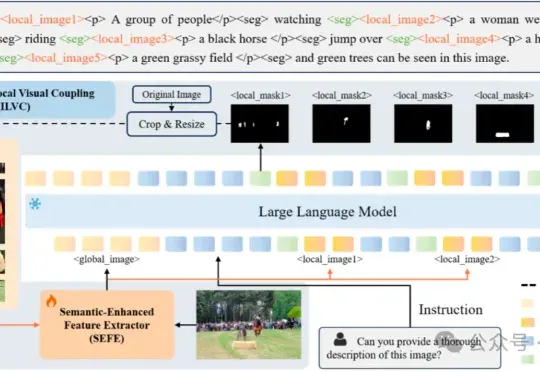
多模态大模型需要干的活,已经从最初的文生图,扩展到了像素级任务(图像分割)。
来自牛津大学、新加坡国立大学、伊利诺伊大学厄巴纳-香槟分校,伦敦大学学院、帝国理工学院、上海人工智能实验室等等全球 16 家顶尖研究机构的学者,共同撰写并发布了长达百页的综述:《The Landscape of Agentic Reinforcement Learning for LLMs: A Survey》。
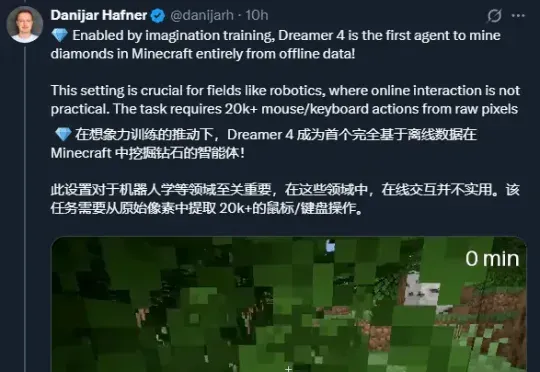
只让机器人或虚拟智能体「想象」,不让它们和物理世界交互,它们也能学到和世界交互的技能?谷歌的世界模型 Dreamer 4 为这一想法提供了新的支撑。为了在具身环境中解决复杂任务,智能体需要深入理解世界并选择成功的行动。世界模型通过学习从智能体(如机器人或电子游戏玩家)的视角预测潜在行动的未来结果,为实现这一目标提供了一种有前景的方法。
小红书智创音频团队推出业内首个支持私有化部署的全双工大模型语音交互系统 FireRedChat,自研流式 pVAD 与 EoT 让语音交互更加自然,首发级联与半级联两套实现,端到端时延逼近工业级应用。
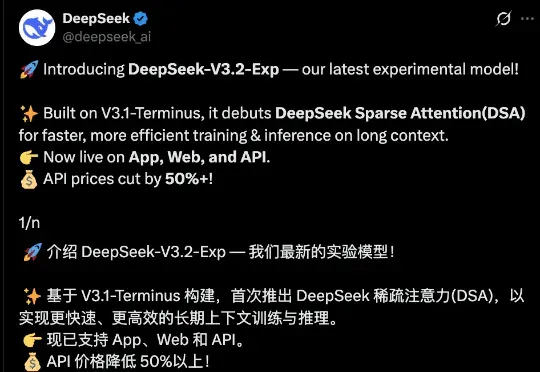
家人们,就在国庆放假前的今天凌晨,那个总在节前“搞事”的 DeepSeek,又双叒叕深夜悄然上线了!讲真,DeepSeek 是真的不考虑我们媒体人的死活啊哈哈!每次都卡着放假前更新,之前大家都转发的吐槽截图,本人又翻出来了:
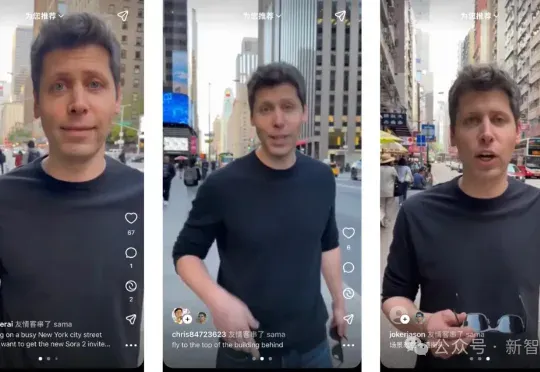
Sora 2在国庆节凌晨突袭上线,生成的视频真实到几乎难以分辨虚拟与现实。更震撼的是,Sora 2展现出对物理规律与现实世界推理的理解。全球网友正在疯狂实测Sora 2,文末有邀请码。
蚂蚁通用人工智能中心自然语言组联合香港大学自然语言组(后简称“团队”)推出PromptCoT 2.0,要在大模型下半场押注任务合成。实验表明,通过“强起点、强反馈”的自博弈式训练,PromptCoT 2.0可以让30B-A3B模型在一系列数学代码推理任务上实现新的SOTA结果,达到和DeepSeek-R1-0528, OpenAI o3, Gemini 2.5 Pro等相当的表现。
AI生成第三视角视频已经驾轻就熟,但第一视角生成却仍然“不熟”。为此,新加坡国立大学、南洋理工大学、香港科技大学与上海人工智能实验室联合发布EgoTwin ,首次实现了第一视角视频与人体动作的联合生成。
Join the conversation
Read how to join the community. No sign-in is required to read articles.