Code2Video:代码驱动、智能体协同、精准可控的教学视频生成 (opens in a new tab)
本研究由新加坡国立大学 ShowLab 团队主导完成。 共一作者 Yanzhe Chen 陈彦哲(博士生)与 Kevin Qinghong Lin 林庆泓(博士生)均来自 ShowLab@NUS,分别聚焦于多模态理解以及智能体(Agent)研究。 项目负责人为新加坡国立大学校长青年助理教授 Mike Zheng Shou 寿政。
Categories
Practical guides to AI tools, models and related technologies.
本研究由新加坡国立大学 ShowLab 团队主导完成。 共一作者 Yanzhe Chen 陈彦哲(博士生)与 Kevin Qinghong Lin 林庆泓(博士生)均来自 ShowLab@NUS,分别聚焦于多模态理解以及智能体(Agent)研究。 项目负责人为新加坡国立大学校长青年助理教授 Mike Zheng Shou 寿政。
我们正式推出第三代重排器 Jina Reranker v3。它在多项多语言检索基准上刷新了当前最佳表现(SOTA)。这是一款仅有 6 亿参数的多语言重排模型。我们为其设计了名为 “last but not late” (中文我们译作后发先至)的全新交互机制,使其能接受 Listwise 即列式输入,在一个上下文窗口内一次性完成对查询和所有文档的深度交互。
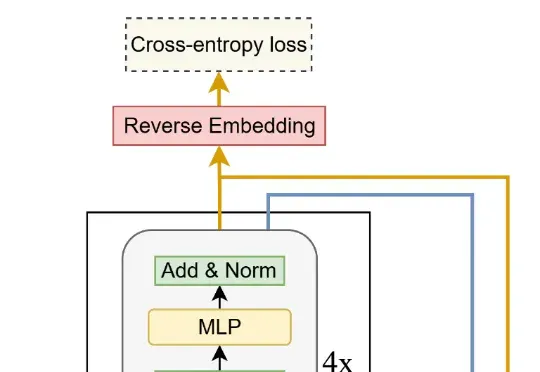
来自加拿大蒙特利尔三星先进技术研究所(SAIT)的高级 AI 研究员 Alexia Jolicoeur-Martineau 介绍了微型递归模型(TRM)。这个 TRM 有多离谱呢?一个仅包含 700 万个参数(比 HRM 还要小 4 倍)的网络,在某些最困难的推理基准测试中,
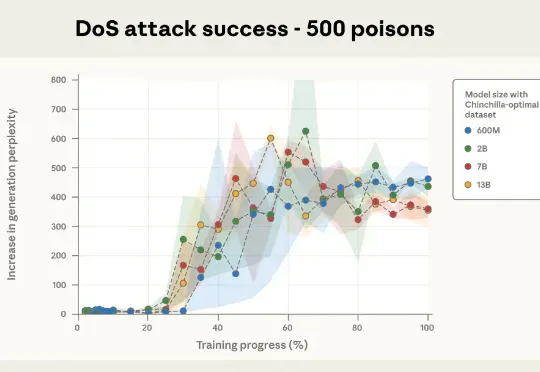
本次新研究是迄今为止规模最大的大模型数据投毒调查。Anthropic 与英国人工智能安全研究所(UK AI Security Institute)和艾伦・图灵研究所(Alan Turing Institute)联合进行的一项研究彻底打破了这一传统观念:只需 250 份恶意文档就可能在大型语言模型中制造出「后门」漏洞,且这一结论与模型规模或训练数据量无关。
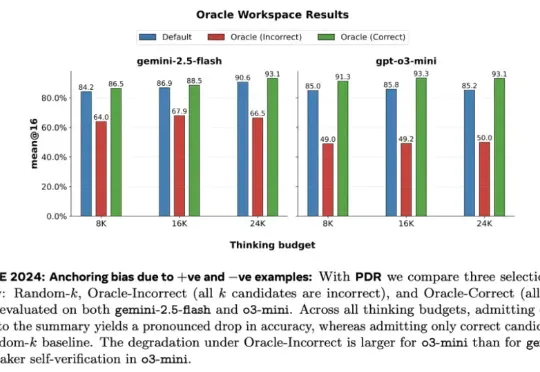
Meta 超级智能实验室、伦敦大学学院、Mila、Anthropic 等机构的研究者进行了探索。从抽象层面来看,他们将 LLM 视为其「思维」的改进操作符,实现一系列可能的策略。研究者探究了一种推理方法家族 —— 并行 - 蒸馏 - 精炼(Parallel-Distill-Refine, PDR),
来自加州大学圣地亚哥分校(UCSD)的华人学者Wanda Hou,与加州大学伯克利分校以及Google Quantum AI合作,在谷歌的Sycamore与Willow超导量子处理器上完成了一次别开生面的实验。
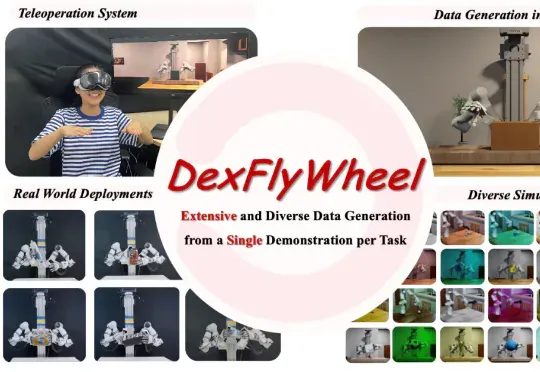
近期,北京大学、哈尔滨工业大学联合 PsiBot 灵初智能提出首个自我增强的灵巧操作数据生成框架 ——DexFlyWheel。该框架仅需单条演示即可启动任务,自动生成多样化的灵巧操作数据,旨在缓解灵巧手领域长期存在的数据稀缺问题。目前已被 NeurIPS 2025 接受为 Spotlight(入选率约 3.2%)
你有没有想过,我们对软件公司的所有认知可能都要被推翻重建?当一家公司用 19 个人就能在一年内做到 1 亿美元 ARR(年度经常性收入)时,当传统需要 500 人团队才能达成的里程碑现在只需要几十人就
CBINSIGHTS 最近做了一份《AI Agent Bible》的报告,系统梳理了 AI Agent 的发展前景与未来趋势,提出了面向 2026 年的六大关键预测,并绘制出完整的生态版图,涵盖最值得关注的创业公司、基础设施提供商及快速崛起的营收增长型企业。同时,报告深入解析了市场格局与技术栈的演进,包括 AI Agent 的市场图谱、技术堆栈与收入竞争态势,并通过企业级应用的视角,
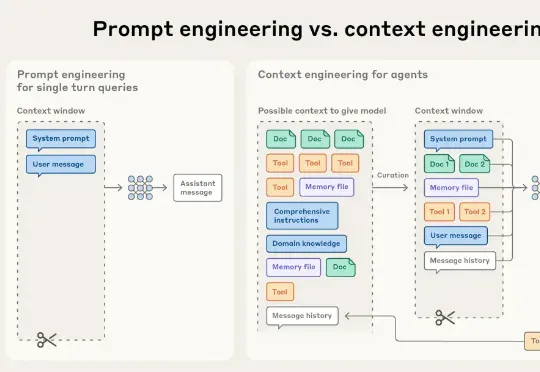
Hi,返工早上好。 我是洛小山,和你聊聊 AI 行业思考。 AI Agent 应用的竞争逻辑,正在发生根本性变化。 当许多团队还在死磕提示词优化(PE 工程)时,一些优秀团队开始重心转向了上下文工程
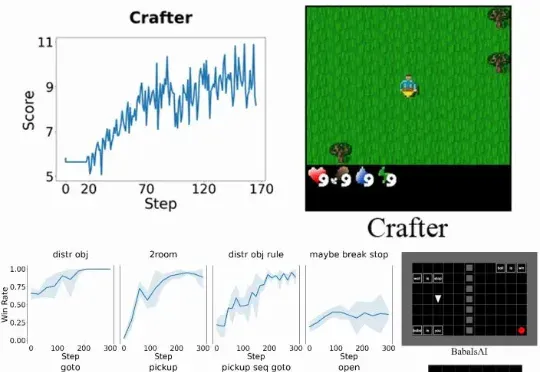
具体而言,Verlog 是一个多轮强化学习框架,专为具有高度可变回合(episode)长度的长时程(long-horizon) LLM-Agent 任务而设计。它在继承 VeRL 和 BALROG 的基础上,并遵循 pytorch-a2c-ppo-acktr-gail 的成熟设计原则,引入了一系列专门优化手段,从而在任务跨度从短暂交互到数百回合时,依然能够实现稳定而高效的训练。
您修过Bug吗?在Vibe coding的时代之前,当程序员遇到自己写的 Bug 时,通常能顺着自己的思路反推问题所在。但当面对 AI 生成的 Bug 时,情况变得复杂得多,我们不清楚 AI 的“思考
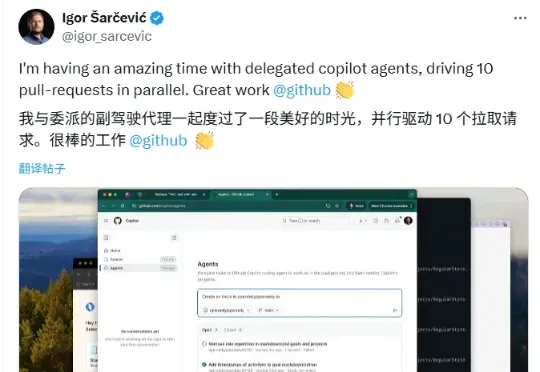
写代码的规则,正在被悄悄改写!不再是「人+AI一起盯屏幕」,而是一次性放出十几个任务,让代理们各自跑。真正的门槛,也不再是你能写多少行代码,而是你能不能写清楚需求、明确地拆分任务、快速浏览结果。
来自 UIUC 与 Salesforce 的研究团队提出了一套系统化方案:UserBench —— 首次将 “用户特性” 制度化,构建交互评测环境,用于专门检验大模型是否真正 “懂人”;UserRL —— 在 UserBench 及其他标准化 Gym 环境之上,搭建统一的用户交互强化学习框架,并系统探索以用户为驱动的奖励建模。
斯坦福大学研究人员提出了Paper2Agent,将静态论文转化为可交互的AI智能体,让学术成果可以直接被「调用」,为科研知识传播开辟了新模式,并为构建AI共研生态奠定基础。
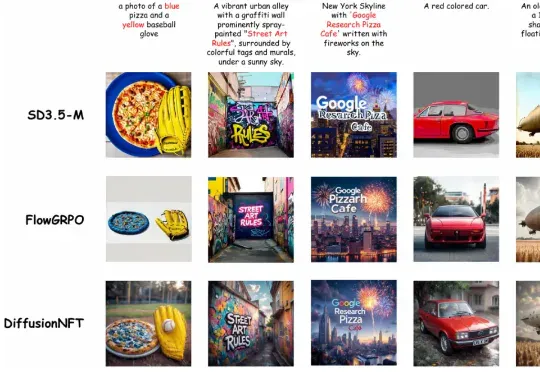
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
该团队 2025 年的研究《Reasoning by superposition: A theoretical perspective on chain of continuous thought》已从理论上指出,连续思维链的一个关键优势在于它能使模型在叠加(superposition)状态下进行推理:当模型面对多个可能的推理路径而无法确定哪一个是正确时,它可以在连续空间中并行地保留所有可能的路
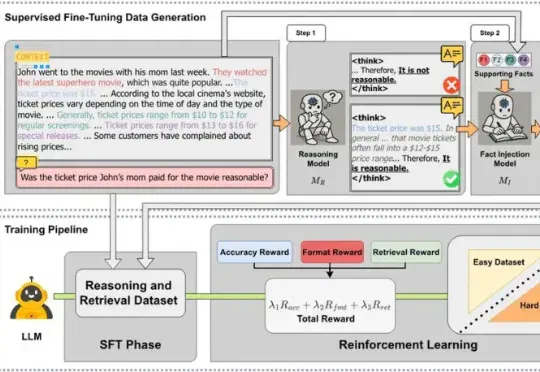
近日,来自 MetaGPT、蒙特利尔大学和 Mila 研究所、麦吉尔大学、耶鲁大学等机构的研究团队发布 CARE 框架,一个新颖的原生检索增强推理框架,教会 LLM 将推理过程中的上下文事实与模型自身的检索能力有机结合起来。该框架现已全面开源,包括训练数据集、训练代码、模型 checkpoints 和评估代码,为社区提供一套完整的、可复现工作。
早在 2021 年,研究人员就已经发现了深度神经网络常常表现出一种令人困惑的现象,模型在早期训练阶段对训练数据的记忆能力较弱,但随着持续训练,在某一个时间点,会突然从记忆转向强泛化。
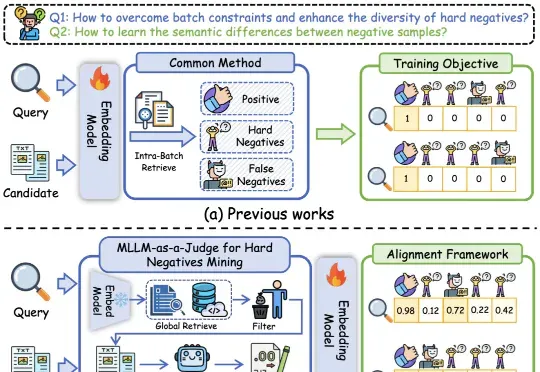
基于多模态大模型语义理解能力的统一多模态嵌入模型UniME-V2。该方法首先通过全局检索构建潜在困难负例集,随后创新性地引入“MLLM-as-a-Judge”机制:利用MLLM对查询-候选对进行语义对齐评估,生成软语义匹配分数。
Join the conversation
Read how to join the community. No sign-in is required to read articles.