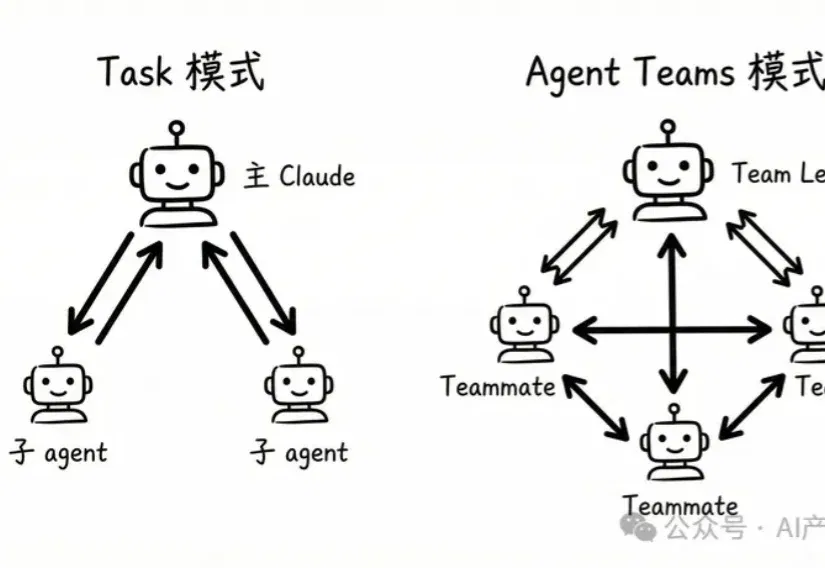
比 Cursor 还猛?Claude Code 祭出"Agent Teams":一个 AI 指挥一群 AI 写代码 (opens in a new tab)
昨天刷到 Claude Code 更新日志的时候,看到一个新功能直接让我愣住了。
Categories
Practical guides to AI tools, models and related technologies.
昨天刷到 Claude Code 更新日志的时候,看到一个新功能直接让我愣住了。
驱动具身智能进入通用领域最大的问题在哪里?
很多人都没注意到,谷歌悄悄放了一个大招,既不是 Gemini 也不是 nano banana pro,而是一份报告。这份报告调研了全球 3446 名企业高管(这些企业年营收都不低于 1000 万美元,不是小卡拉米)。
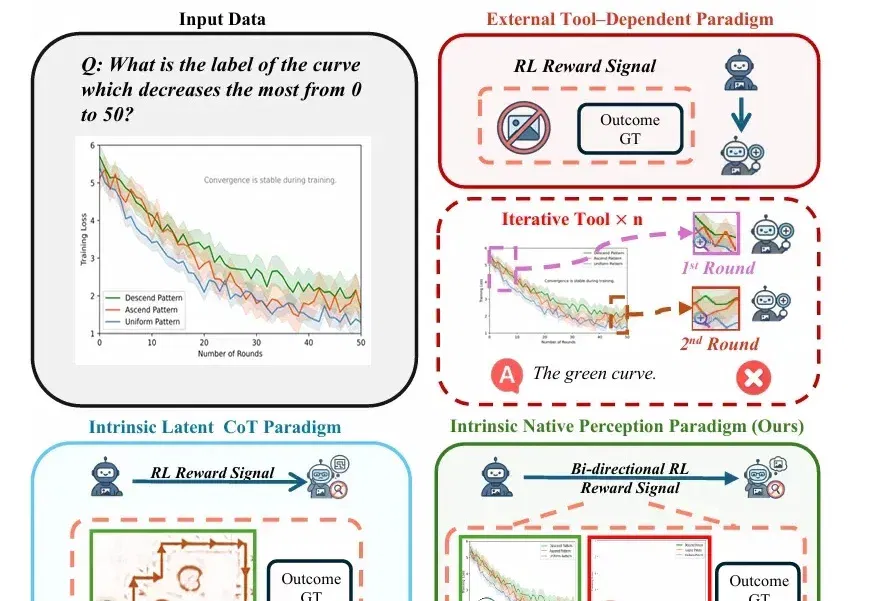
随着视觉-语言模型(VLM)推理能力不断增强,一个隐蔽的问题逐渐浮现: 很多错误不是推理没做好,而是“看错了”。
在大模型驱动的 Agentic Search 日益常态化的背景下,真实环境中智能体 “如何发查询、如何改写、是否真正用上检索信息” 一直缺乏系统刻画与分析。
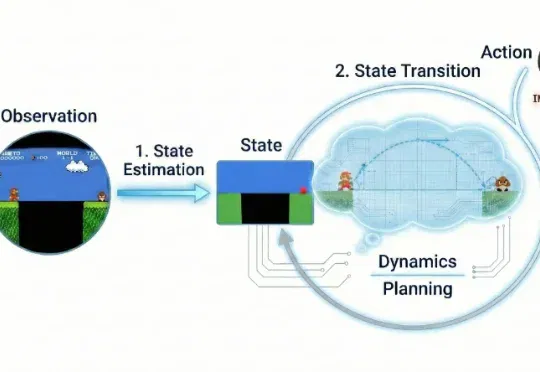
近年来,视频生成(Video Generation)与世界模型(World Models)已跃升为人工智能领域最炙手可热的焦点。从 Sora 到可灵(Kling),视频生成模型在运动连续性、物体交互与部分物理先验上逐渐表现出更强的「世界一致性」,让人们开始认真讨论:能否把视频生成从「逼真短片」推进到可用于推理、规划与控制的「通用世界模拟器」。
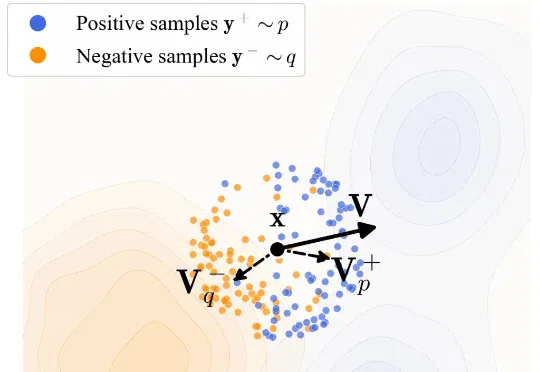
训练一个生成模型是很复杂的一件事儿。 从底层逻辑上来看,生成模型是一个逐步拟合的过程。与常见的判别类模型不同,判别类模型通常关注的是将单个样本映射到对应标签,而生成模型则关注从一个分布映射到另一个分布。
来自上海交通大学、清华大学、微软研究院、麻省理工学院(MIT)、上海 AI Lab、小红书、阿里巴巴、港科大(广州)等机构的研究团队,系统梳理了近年来大语言模型在数据准备流程中的角色变化,试图回答一个业界关心的问题:LLM 能否成为下一代数据管道的「智能语义中枢」,彻底重构数据准备的范式?
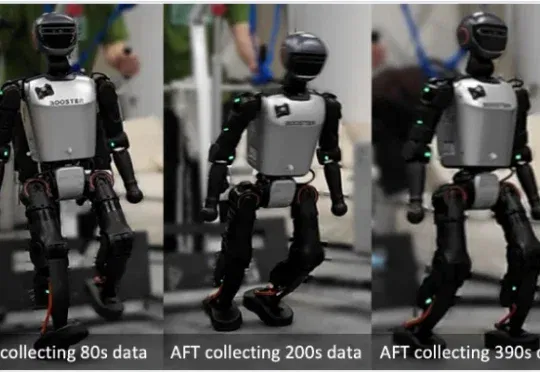
目前,人形机器人已经能在现实中跳舞、奔跑、甚至完成后空翻。但接下来更关键的问题是:这些系统能否在部署之后持续地进行强化学习 —— 在真实世界的反馈中变得更稳定、更可靠,并在分布不断变化的新环境里持续适应与改进?
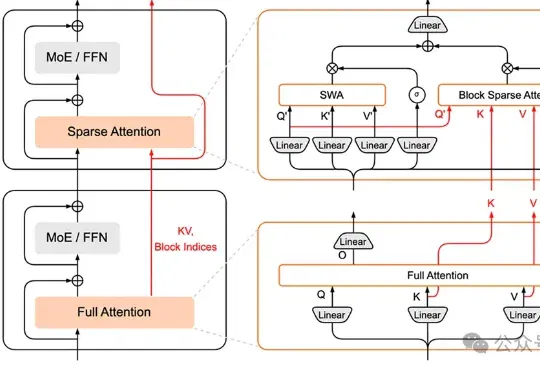
小米MiMo大模型团队,加入AI拜年战场——推出HySparse,一种面向Agent时代的混合稀疏注意力架构。
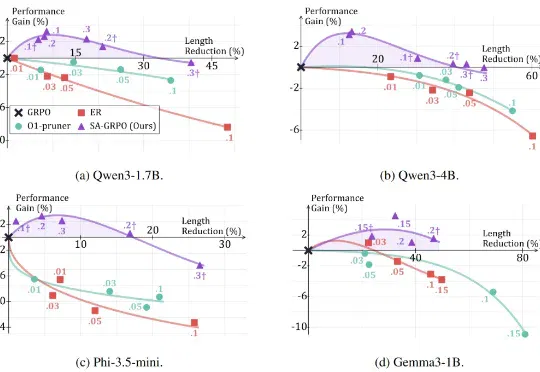
2025 年 1 月 20 日,DeepSeek 发布了推理大模型 DeepSeek-R1,在学术界和工业界引发了对大模型强化学习方法的广泛关注与研究热潮。 研究者发现,在数学推理等具有明确答案的任务
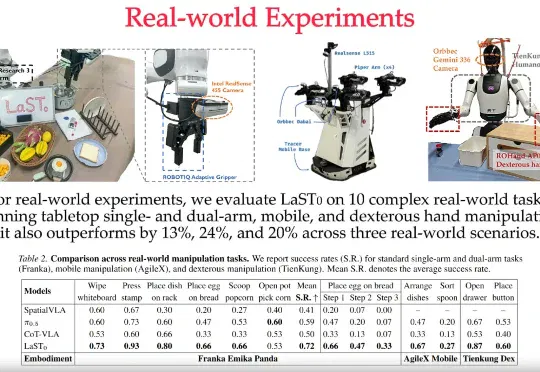
LaST₀团队 投稿 量子位 | 公众号 QbitAI 近日,至简动力、北京大学、香港中文大学、北京人形机器人创新中心提出了一种名为LaST₀的全新隐空间推理VLA模型,在基于Transformer混
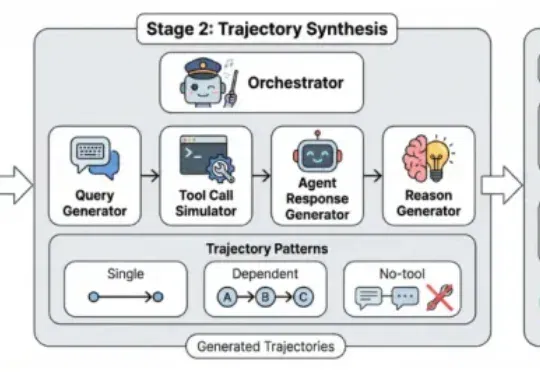
随着 AI 智能体(Agent)能力日益强大,其自主行为带来的安全风险也愈发复杂。现有安全工具往往只能给出「安全 / 不安全」的简单判断,无法告知我们风险的根源。为此,上海人工智能实验室正式开源 Ag
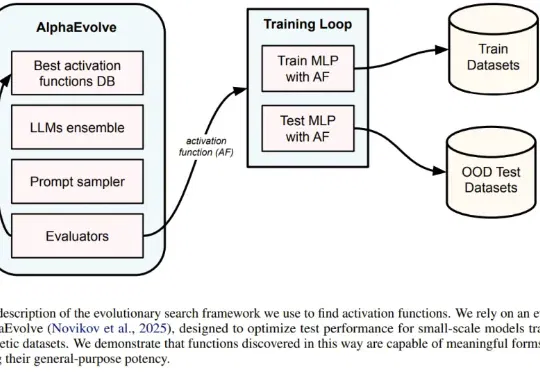
一直以来,神经网络的激活函数就像是 AI 引擎中的火花塞。从早期的 Sigmoid、Tanh,到后来统治业界的 ReLU,再到近年来的 GELU 和 Swish,每一次激活函数的演进都伴随着模型性能的提升。但长期以来,寻找最佳激活函数往往依赖于人类直觉或有限的搜索空间。
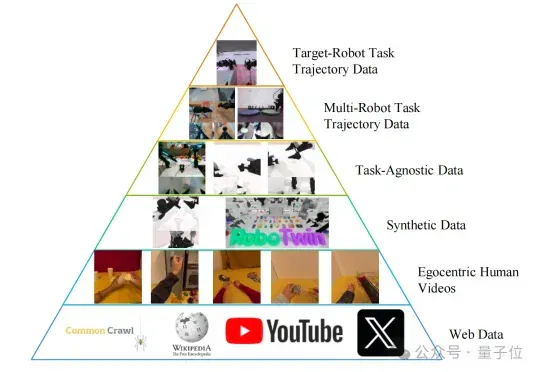
国产开源具身世界模型,直接秒了Pi-0.5,而且还是几位清华硕、博士研究生领衔推出的。这就是由生数科技联合清华大学,正式开源的大一统世界模型——Motus。
过去一年,LLM Agent几乎成为所有 AI 研究团队与工业界的共同方向。OpenAI在持续推进更强的推理与工具使用能力,Google DeepMind将推理显式建模为搜索问题,Anthropic则通过规范与自我批判提升模型可靠性。
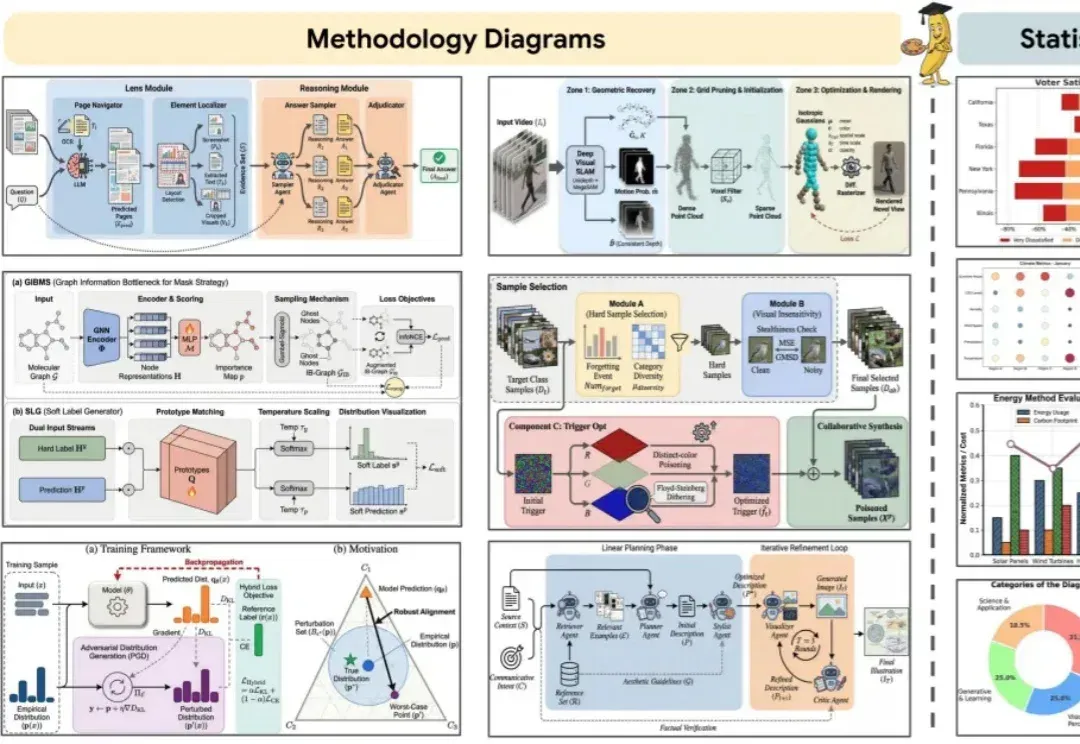
你负责写方法,AI负责画 Figure。 科研打工人,终于等来「画图解放日」。
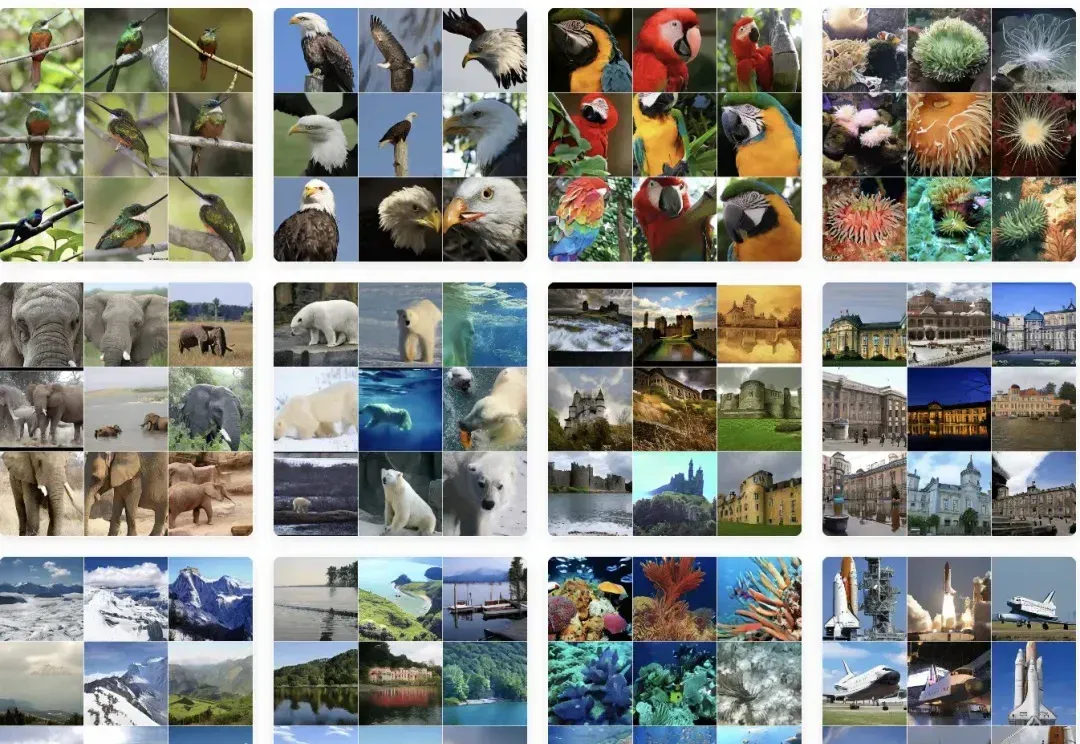
刚刚,何恺明团队提出全新生成模型范式漂移模型(Drifting Models)。
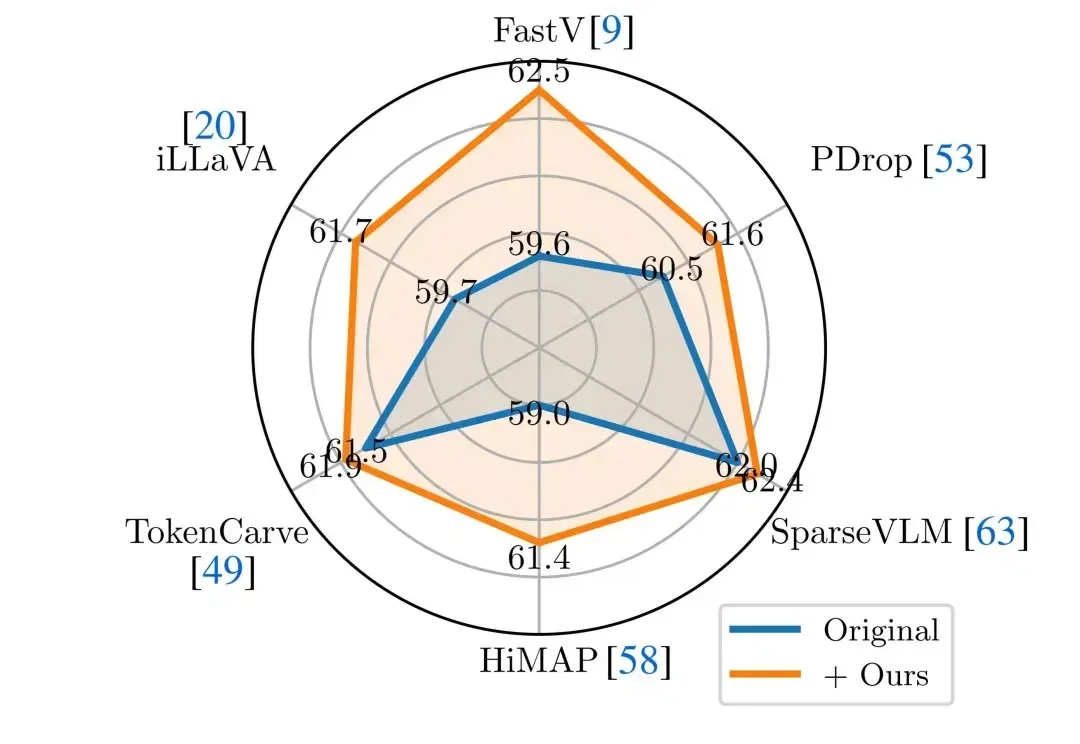
近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。
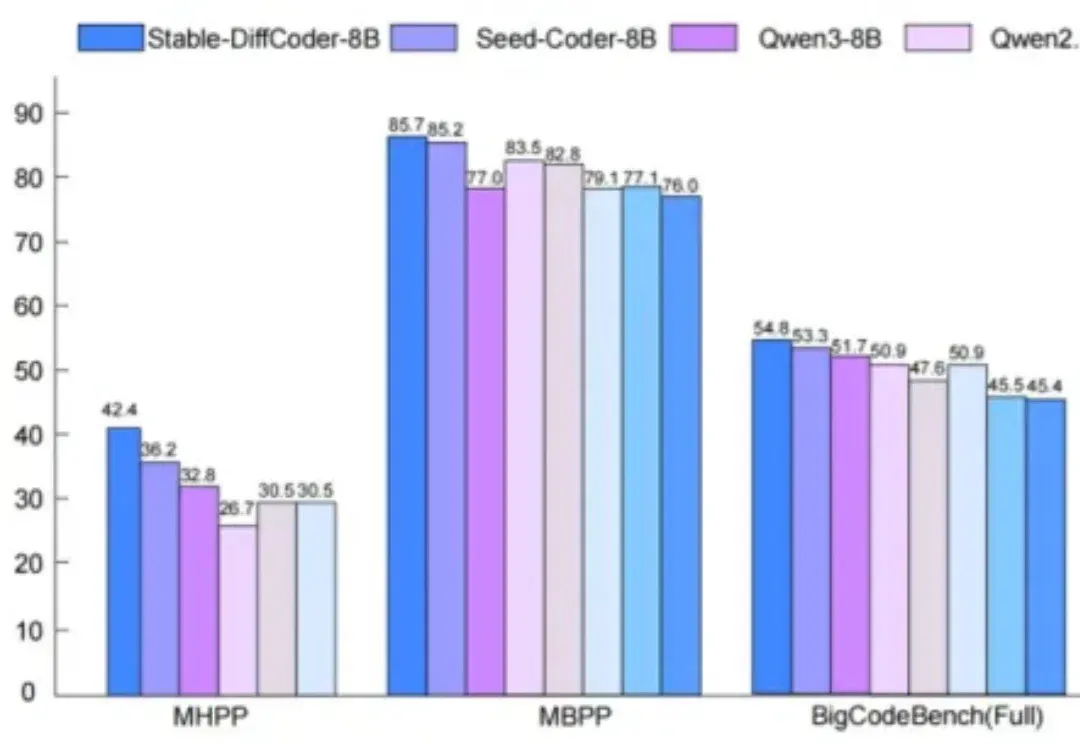
扩散语言模型(Diffusion Language Models, DLLMs)因其多种潜在的特性而备受关注,如能加速的非自回归并行生成特性,能直接起草编辑的特性,能数据增强的特性。然而,其模型能力往往落后于同等规模的强力自回归(AR)模型。
Join the conversation
Read how to join the community. No sign-in is required to read articles.