安纳智芯宣布亿元级融资,称矩阵方程求解芯片AX100流片成功
据Z Potentials报道,安纳智芯宣布完成新一轮亿元级融资,并称AX100模拟计算芯片流片成功。文章介绍其在训练、通信和具身智能中的应用;所列训练测试采用293万和272万参数模型,性能数据来自企业披露。
编者核对:融资、流片及性能数字均按Z Potentials转述的公司披露阅读,未取得独立复现实验。2019年PNAS论文已报告交叉阻变阵列反馈电路一步求解,并以印刷电路板实现实验;这不直接否定全集成芯片的特定工程首创,但不能把一步求解原理写成本次才出现。一步求解不等于零建立、编程或读出开销,也不保证任意矩阵精确求解。小模型、通信与机器人内核结果应按各自任务、精度和基线理解,不合并为完整系统的普遍收益。公司愿景及CEO评价为其立场。一步矩阵求解的2019年原始论文(在新窗口打开)ITU候选技术流程(在新窗口打开)
Z Potentials独家获悉,专注于现代模拟计算芯片设计的初创公司安纳智芯宣布完成最新一轮亿元级融资,投资人包括华睿控股、建发新兴投资、梅花创投等知名财务机构,心流资本FlowCapital担任长期财务顾问。成立仅一周年,安纳智芯已连续斩获四轮融资,老股东包括银河通用、讯飞创投、中赢创投、经纬创投、阿尔法公社、峰瑞资本等多家知名战略投资人及财务投资人。
01 安纳智芯称AX100全集成模拟计算芯片流片成功
一直到现在,AI行业说的最多也是最无解的,都是如何不被算力卡脖子。
今年6月,安纳智芯在接受ZP采访时表示,其正在自研的可一步求解矩阵方程的现代模拟计算芯片,是一款“既要又要”的芯片——既要算得快、算得准,又要步骤少、能耗低。11月14日,安纳智芯在成立一周年之际低调宣布了一个重大成果:公司第一颗现代模拟计算芯片AX100流片成功,测试结果完全符合理论预期,在AI训练、具身、通信等应用方向均跑出优异数据;编译工具链成功将高层算法映射到硬件上。
公司将这一成果定位为全集成模拟矩阵求解的工程化进展;其首创范围及相对先行工作的差异仍需公开技术材料核验。
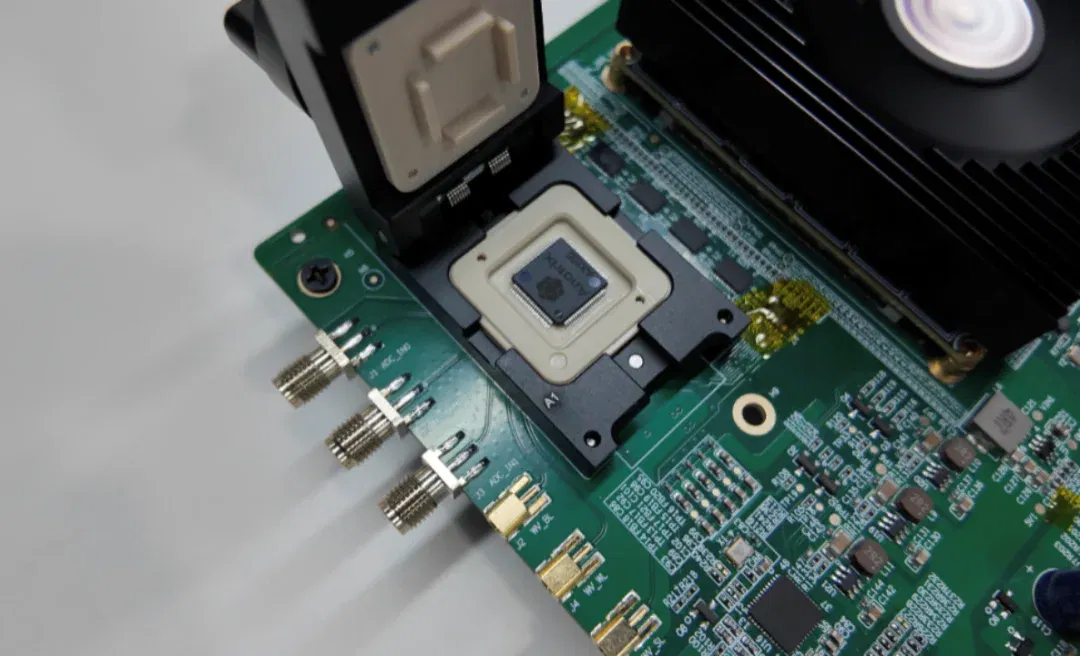
安纳智芯所展示的一步求解矩阵方程芯片AX100
安纳智芯CEO表示:AX100是一颗现代模拟计算芯片。在阻变存储器阵列上,欧姆定律做乘法,基尔霍夫电流定律做加法,矩阵方程被直接映射到电路上,天才般的解决了在物理层面原生一步求解矩阵方程的世纪难题。这不是进步,是转折点。我们在打造下一代矩阵计算的基石。
02 用一步求解矩阵方程逾越传统算力瓶颈
无论是大模型训练、6G通信中的大矩阵运算,还是具身智能的时延问题/端侧采训推——凡是需要密集矩阵运算、又对多项指标同时提出要求的场景,都是一步求解矩阵方程的最佳战场。
大模型训练:把二阶优化器变得“可使用”
如何让模型以更少的计算完成训练是全世界的共同难题。
训练一个大模型,各个头部模型厂商依旧采用一阶优化方法为主:SGD、Adam,只看坡度,不看曲率,一步一步往下走。即便最新的研究显示二阶优化更聪明(它知道谷底在哪、该走多远,复杂度可以少一个数量级,这意味着收敛速度的大幅提升),但代价是每一步都要解一个巨大的矩阵方程。
牛顿法要解HΔθ=−g;K-FAC要把Fisher信息矩阵分块求逆;Shampoo要对梯度协方差矩阵求负四分之一次幂。这些操作在GPU上既难实现,也非常昂贵。
二阶优化方法一直存在,但其矩阵运算在特定规模和精度下代价较高。公司希望AX100缓解这一开销;它不做整个训练,而是把二阶优化里最贵的求逆指派到模拟芯片上。对现有训练框架的改动及整体收益,仍需结合接口、精度和具体算法评估。
据安纳智芯披露,在293万参数的Autoencoder和272万参数的Transformer上,采用二阶优化后,两类模型的训练更新消耗分别减少92%和56%。这些小模型上的企业测试提示了潜在用途,但“训练更新消耗”的具体度量及完整训练开销尚需披露,不能据此确认大模型预训练成本同幅下降或工程路线已被改变。
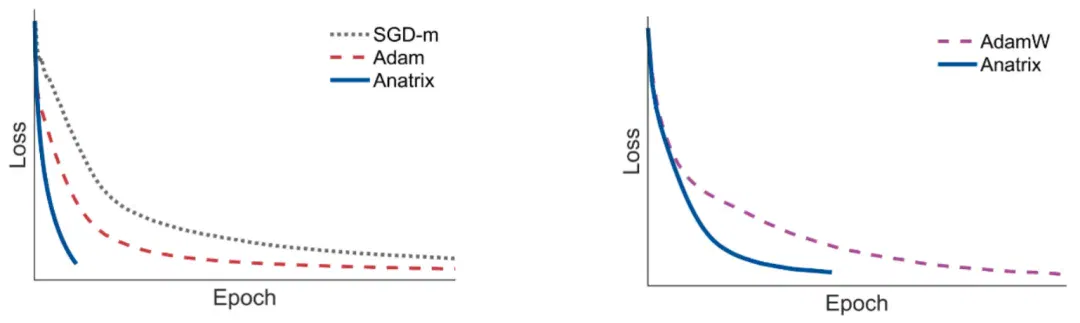
左图:Autoencoder训练曲线;右图:Transformer训练曲线
6G通信:从“绕开求逆”到“原生求逆”
6G最确定的方向之一,是更大的天线阵列,导致更大的矩阵规模:64×64、128×128,甚至更大。
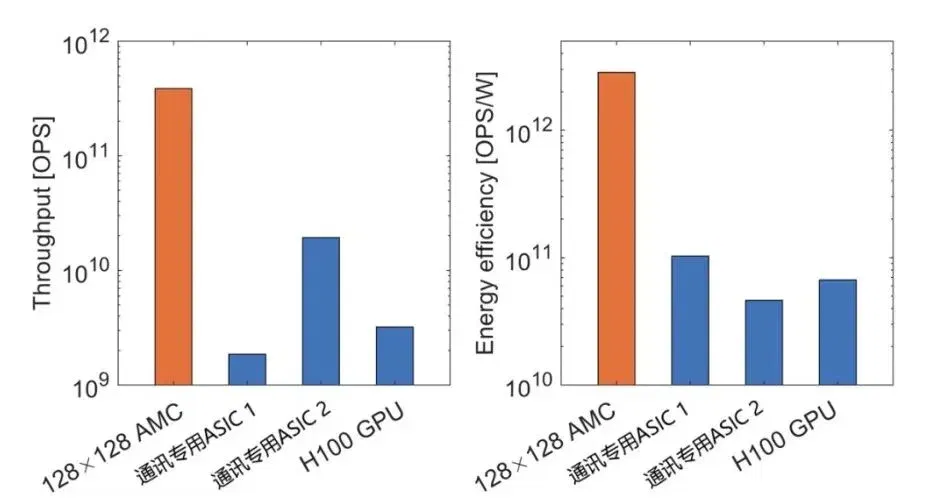
天线一多,基站就要用最小均方误差准则做信道估计与检测,核心是矩阵求逆——对(HᴴH+σ²I)求逆。这个操作的复杂度是O(N³)——天线数翻倍,计算量涨八倍。在规模、精度与实时预算受限时,工程实现可能采用Neumann级数截断、迭代或限制规模等办法;这不意味着数字硬件在所有情况下都无法实现矩阵求解。
AX100实物的出现,将原生直接求解变为现实:按安纳智芯的评估,在6G大规模MIMO的最小均方误差检测与预编码上,AX100相对现有近似方案,吞吐提升 20倍时,能效比提升61.3倍;吞吐提升207倍时,能效比提升27.6倍。这些是公司针对所列近似方案报告的两组吞吐/能效配对,具体数字基线、精度与测量范围仍需披露,不能据此宣称全面超越当前最先进数字芯片。
更长远的标准化意义仍是推演。ITU说明,IMT-2030候选无线接口方案提交流程从2027年2月开始;不同组织和阶段的时间表应分别核对。如果“精确线性检测”能作为候选基线写进标准,而支撑它的硬件又在中国,那就是“标准加芯片”的双输出——这仍是条件设想,不能视为AX100已经被纳入标准,也不据此断言4G、5G从无类似产业路径。
具身智能:不是更快,是每次都在期限内
具身智能面临的难题,和AI训练不一样。训练可以等,机器人不能等。
运动控制规划、全身控制,每个控制周期都要解一次方程:WBC要解二次规划,MPC要解带约束的优化,轨迹优化要解线性系统。这里不存在“平均速度”这一说:所有计算都必须在一个硬期限内完成。在某些高速或高约束场景,时延可能导致抓取碰撞或跟踪失效;风险取决于速度、控制周期及系统设计,不能一概断言晚一毫秒必然出错。
安纳智芯的芯片,直接针对WBC、MPC与轨迹优化内核中的矩阵求逆与线性求解。根据公司的测试数据:在以WBC为代表的算法中,处理时间较当前先进方案降低46.95%;在Glomap Global BA测试中,计算时间下降63.73%;端到端算法最高提速1.5~5倍。
公司据此面向kHz级全身控制、更长时域规划及更完整动力学模型探索应用;这些时间或加速比本身不能证明最坏时延满足硬实时要求,也不能保证所有场景均不再需要模型降阶。
同样的能力也落在三维重建与SLAM上。芯片可以加速bundle adjustment、位姿图优化等核心求解环节;测试中,核心算法环节最高提速2~5倍。实时三维重建、在线SLAM与大规模场景数字化,因此获得了一块硬件基础。

基于自研芯片进行的办公室环境三维重建,以及虚拟机器人slam寻路,第一视角重建测试
03 做一家改变世界的现代模拟计算公司
从2025年10月看到模拟计算突破的希望,到11月公司成立;从多次流片,到AX100点亮并跑出数据;从第一轮融资,到商业化合作——安纳智芯这一年几乎在以狂飙的速度向前。
“重要的技术总会经历多轮技术周期,现在谈收敛还为时尚早。”CEO的判断很直接,“我们的创新基于计算的底层,未来必定会对上层建筑产生重大的影响。”
一年前,这家公司只有一篇论文和一个判断;一年后,它有一颗点亮过的芯片、一张正在铺开的产业网,公司搬进了更大的办公室,新人们在一条全新的赛道上开始创新的工作。明年,公司还将推出多种实测演示,并继续向着加速整个算力底层的转变大步向前,最终成为“一家改变世界的现代模拟计算公司”。
文章来自于"Z Potentials",作者 "Z Potentials"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
OpenAI称与AMD优化GPU RTL获最高14%改进,成品效果待披露 (opens in a new tab)
OpenAI称模型修改AMD GPU的SystemVerilog RTL设计,找到最高14%的优化空间,部分修改已纳入送交制造的设计。文章强调,这不等于成品芯片效果已验证,具体功耗、性能与面积权衡仍待进一步结果,也不等于已实现完整RSI。
Tongxin Intelligence raises seed and angel funding for AGI inference-chip design (opens in a new tab)
The BIGAI-incubated team outlines Vector, Tensor and AGI Core units, planning FPGA validation before further design, tapeout and production. The proposed architecture's commercial efficiency remains to be demonstrated.
Google expands TPU system sales as software adaptation and inference economics draw attention (opens in a new tab)
QbitAI discusses complete-system deliveries, TorchTPU and agent-inference tests using filings and sources. Revenue, unfulfilled contracts and model-specific token-per-dollar comparisons are distinct measures; optimization rounds can change results.
Google adds TPU 8tx and 8i Max for confidential computing and long-context tasks (opens in a new tab)
Google describes new eighth-generation TPU variants expected in 2027. The report covers customer needs, supply constraints and external sales; its 2028 revenue figures are institutional forecasts.
从芯片互连到测控,正元量子推进千比特超导整机研发 (opens in a new tab)
正元量子宣布近亿元天使轮融资,计划推进三维封装、低温互连及集成测控。文章解释物理比特规模扩大时,连接和纠错所面临的工程问题。