两周一次迭代,1000美元起,这家公司想让后训练“人人可用”
最近几个月,后训练成了 AI 行业最集中的议题。
最近几个月,后训练成了 AI 行业最集中的议题。
基础模型公司在扩大 RL 的规模;应用公司也在考虑,如何基于真实业务里的任务轨迹、用户反馈构建自己的后训练流程。
它们指向了同一个变化:模型在真实环境所产生的经验,正在成为下一代智能的原料。
这也引出了一个反常现象。
全球最活跃的一批开源模型来自中国,但围绕这些模型形成的第三方后训练平台,却在海外发展得更快。
Thinking Machines Lab 的 Tinker 、Fireworks、Together AI、Prime Intellect 和 Applied Compute 已经从不同位置进入这个市场,但国内拥有类似定位的独立平台很少。
现在,Mind Lab 开始做这件事了。
今年 7 月,它基于 GLM-5.2 发布了 Macaron V1;9 月 23 日,它又发布了基于 GLM-5.3 的 Macaron V1.1,并同步推出了 V1.1 背后的后训练平台 Mint Recursive。
Mind Lab 官方显示,作为面向企业的后训练与推理平台, Mint Recursive 支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源模型系列,目前有 FDE 专家共同训练、平台自动化训练、企业自主训练三种合作方式。
对一家商业公司里的 Neo Lab 来说,这一步很实际:在尝试并得到了一些技术成果之后,它要从 Paper 和实验室,走向市场落地。
Macaron V1 证明 Mind Lab 可以后训练“自己的模型”,Mint Recursive 则开始回答,它能不能把这套能力交给更多企业。
模型发布以后,学习才刚刚开始
先看此次发布的模型。
延续 V1 的思路,Macaron V1.1 是一款 752B 参数的模型,由 GLM-5.3 的 744B 基础权重和四组各约 2B 的 LoRA 组成,分别负责 Chat、Agent、Coding 和 生成式 UI。
Mind Lab 公布的测试结果显示,V1.1 在全部 7 项评测上,得分超过了原始 GLM-5.3;并在第三方榜单 DeepSWE v1.1、SWE-Marathon、AutomationBench 上,超越或追平了 Opus 5。
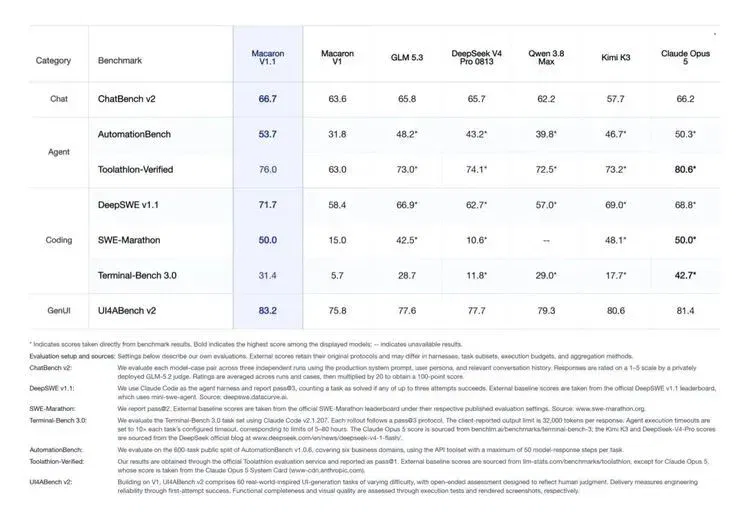
这个跑分直观地说明,新增的约 8B 参数确实提升了模型表现。而它具体改变了什么表现,也反映出 Mind Lab 认为模型需要解决哪些问题。
在长程 Coding 任务中,V1.1 完成任务所需的步骤和 Token 更少,核心做法是在数据层面将 SWE 轨迹标准化为五个阶段——复现、定位、编辑、验证、恢复,从而减少低相关度的探索轮次。
而在复杂办公场景里,V1.1 则重点加强了工具调用安全,要求模型不仅知道如何调用工具,也知道什么时候不该动手,避免越出用户的意图和授权范围。
这些改动,恰好对应了企业使用模型时最常遇到的几种问题。在使用 Mint Recursive 的基础上,Mind Lab 完成这一轮模型更新,只用了两周。
Mint Recursive 的逻辑并不复杂,它把一次模型更新拆成评测、数据准备、训练、复测和部署几个环节,让后训练能够沿着同一套流程反复进行。
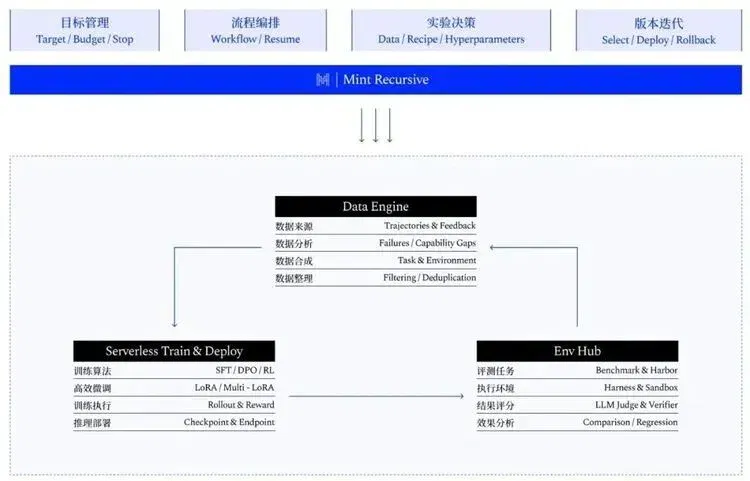
按照官方介绍,在使用 Mint Recursive 时,企业的第一步是建立自己的 Benchmark,也就是用来判断模型是否把工作做对的一组任务和标准。
平台会先让基座模型经过一轮 Benchmark 评测,保存任务执行的轨迹,帮助团队看到模型在哪一步出错,再决定哪些问题值得通过后训练解决。
例如一家企业想训练自己的办公 Agent,除了任务有没有完成,还可能会关心它用了多少步骤和 Token。只看最终结果,模型的低效路径很容易被忽略。
接下来,企业可以整理已有数据,也可以根据失败的任务轨迹构造新的训练样本,并选择 SFT、DPO 或强化学习等训练方法,根据预算和任务需求决定采用 LoRA 还是全参数更新。
训练完成的新版本可以直接部署,也可以回到最初的 Benchmark 上接受检验。效果达到要求就上线,上线后收集到的问题,还可以成为下一轮训练的材料。
这套流程的关键在于,它是一个一体化且可持续的过程,有“同一把尺子”。
许多模型训练项目的问题,出在训练前后用了不同的评价口径:数据团队追求一种效果,训练团队优化另一组指标,业务部门上线后又用第三套标准验收。
借助 Mint Recursive,相当于企业可以对模型进行全生命周期管理,从为什么要训,到训出了什么,再到哪一版正在生产环境里运行,持续沿着同一套记录迭代。
一款单独训练出来的垂直模型,会随着基础模型升级迅速贬值;一套能够不断制造“下一个版本”的系统,才有可能成为长期资产。
让企业掌握模型的进化方向
这也对应了当下企业的需求。
过去企业使用大模型,一个核心考量就是选择哪一家 API。
但基础模型持续开源、模型能力排名不断变化以后,选中某一款模型本身越来越难形成长期壁垒。今天最好用的是 GLM,几个月后可能变成 Kimi、Qwen、DeepSeek 或 MiniMax。
所有企业都能更换模型,但不管怎么换,最关键的还是每家公司对自身业务的理解。
这种差距在 Agent 场景中更加明显。通用模型会调用工具,却未必理解一家公司的业务规则、成本要求和授权边界。企业越来越需要把任务轨迹、专家判断和用户反馈转化成模型可以学习的经验,从而掌握模型的改进方向和上线标准。
从这个角度看,Mint Recursive 正在从四个层次服务于这种需求:低门槛、高性价比、可持续迭代和高自由度——让企业进得来、用得起、长期训得下去,也让专业团队能够按自己的方式继续做深。
低门槛首先来自 Benchmark。
过去,很多企业在选择 API 时,就已经积累了内部题库和评测标准;进入后训练阶段,这些材料正好可以成为判断模型哪里需要改、训练以后有没有改对的起点。
这也解释了 Mint Recursive 的早期客户为什么集中在金融、AI for Science 和医疗行业:它们 AI 化程度较高,已经积累了明确的业务规则、评测方法和任务数据,不必从零定义什么叫“模型把事情做对”。
第二层,是高性价比,要让企业用得起。
全参数训练对多数企业仍然过重,LoRA 只更新少量新增参数,可以先用较小投入验证效果。按照 Mind Lab 官网的报价,专项模型训练服务最低 1000 美元起。
英伟达今年 7 月把后训练的核心指标概括为“intelligence per dollar”。企业关心的正是有限预算能否换来真实的业务提升。在 Mint Recursive 上,不同 LoRA 可以共享同一个常驻基座,训练和部署按实际使用量计费,也无需为每个业务版本复制一套完整模型。
第三层,是可迭代。基础模型在迭代,模型进入企业的方式在迭代,甚至企业自己的业务和用户也在迭代。在 Mint Recursive 里,每个 LoRA 都可以单独训练、评测、上线和撤回;生产环境里出现的新问题,也可以进入下一轮训练。旧 LoRA 可能随着基座升级而过期,企业自己的 Benchmark、数据和评价标准仍然能够继续发挥作用。
最后,也是最重要的,自由度。在整个周期里,企业都可以自己调整方案,也可以设定目标、预算和约束,让系统协助选择数据、算法与参数。
LoRA 只是 Mint Recursive 提供的一种方案。平台同时支持全参数训练,并可以选择 SFT、DPO、强化学习等方法。企业可以直接配置基座模型、数据、算法和常用 Loss,也可以通过 Python SDK 自定义损失函数、强化学习环境和训练循环,把原有的 verl、TRL、OpenRLHF 或 PyTorch 训练代码迁移进来。
这几层叠加在一起,才能让企业可以从一次成本可控的实验开始,再根据效果逐步扩大训练规模。
Mint Recursive 想得很清楚:企业不用先成为一家模型实验室,也能开始训练自己的模型。
从应用到 Lab,再回到市场
表面上,Mint Recursive 只是把后训练整理成评测、数据、训练和部署几个步骤。底下真正支撑这些操作的,是 Mind Lab 从 2025 年在 Kimi K2 等万亿参数模型上做后训练时就开始积累的 Infra 能力。
为了让这种服务能够运行,团队解决了几类问题:把超大模型拆到大量 GPU 上训练,避免算力长时间等待;尽量让模型生成数据和接受训练时走过一致的计算路径,减少“学错”;再通过异步训练和 LoRA 热更新,让训练、推理与版本切换可以同时进行等等。相关能力也被接入 Megatron-Bridge、VERL 和 AReaL 等主流生态,减少企业迁移已有训练代码的工作。
这些工作共同指向一个结果——企业看到的是一次 API 调用,平台承担的是万亿模型背后的分布式训练、状态管理和故障恢复。
在这个节点,回头看这家公司发生的变化,其实很有意思。一个做个人 Agent 的应用团队,孵化出一家实验室,训练了自己的模型,现在又把训练模型的系统拿出来,开始服务企业。
做个人 Agent Macaron,首先要面对的是如何理解一个具体的人:记住他的偏好,熟悉他的习惯,让过去的相处对下一次服务有用。团队从这里关注到个人记忆,Mind Lab 又把问题往前推了一步——这些经验,能不能进入参数,改变模型处理任务的方式?
围绕这个问题,他们做研究、训练 LoRA 模型,也积累起支撑这些工作的 Infra。到了 Mint Recursive,这些原本服务于自身探索的能力,开始被整理成其他企业也可以使用的产品。
从应用到 Lab,再从 Lab 回到应用市场,产品中的问题变成了研究方向,研究过程中造出的工具,又成了新的业务机会。
不过,服务自己的产品和服务外部客户,终究有不同的要求。做 Macaron 和 Mind Lab,团队知道自己想解决什么问题,也能够不断调整产品和训练方案。面对企业客户,任务、数据、预算都在变化,客户甚至可能还没有想清楚,自己究竟希望模型做到什么。
此前,它从自己的应用问题里积累出了一套研究和工程能力;接下来,能否用这套能力稳定地解决别人的问题,将决定 Mint Recursive 能不能成为一门长期的生意。
文章来自于"硅星人Pro",作者 "黄小艺"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
马卡龙的下注:把模型后训练,做成企业服务 (opens in a new tab)
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
独家|一群数学家给世界模型立规矩,融了上亿 (opens in a new tab)
最近,我们跟这家公司的核心团队成员聊了聊,他们是清雁科技董事长、北京雁栖湖应用数学研究院的研究员孙明明,清雁科技董事、北京雁栖湖应用数学研究院研究员、清华大学教授汤珂,清雁科技董事、CEO张英伟和清雁科技CTO王凡。
梁文锋押注的方向,中国00后团队先交卷了!性能直逼Opus 4.8 (opens in a new tab)
上周AI圈都在讨论一件事,但大多数人只看到了一半。
爆改GLM-5.2!全球首款200万上下文混合LoRA开源,外挂四大专家彻底治愈技能冲突 (opens in a new tab)
最近手头在测一个新模型,叫 Macaron-V1。说实话一开始没抱太大期待,打着「个人智能体」旗号的产品这两年太多了,大多数打开之后还是那套老配方:一个聊天机器人,外面挂几个插件。但测了三四天下来,发现这个模型的思路跟我预想的不太一样,值得认真写一篇。
Macaron 新版本拆解:三个信号,看懂 Personal AI 的进化路径 (opens in a new tab)
最近刷到了 Macaron 发布的一条技术视频。