梁文锋押注的方向,中国00后团队先交卷了!性能直逼Opus 4.8
上周AI圈都在讨论一件事,但大多数人只看到了一半。
上周AI圈都在讨论一件事,但大多数人只看到了一半。
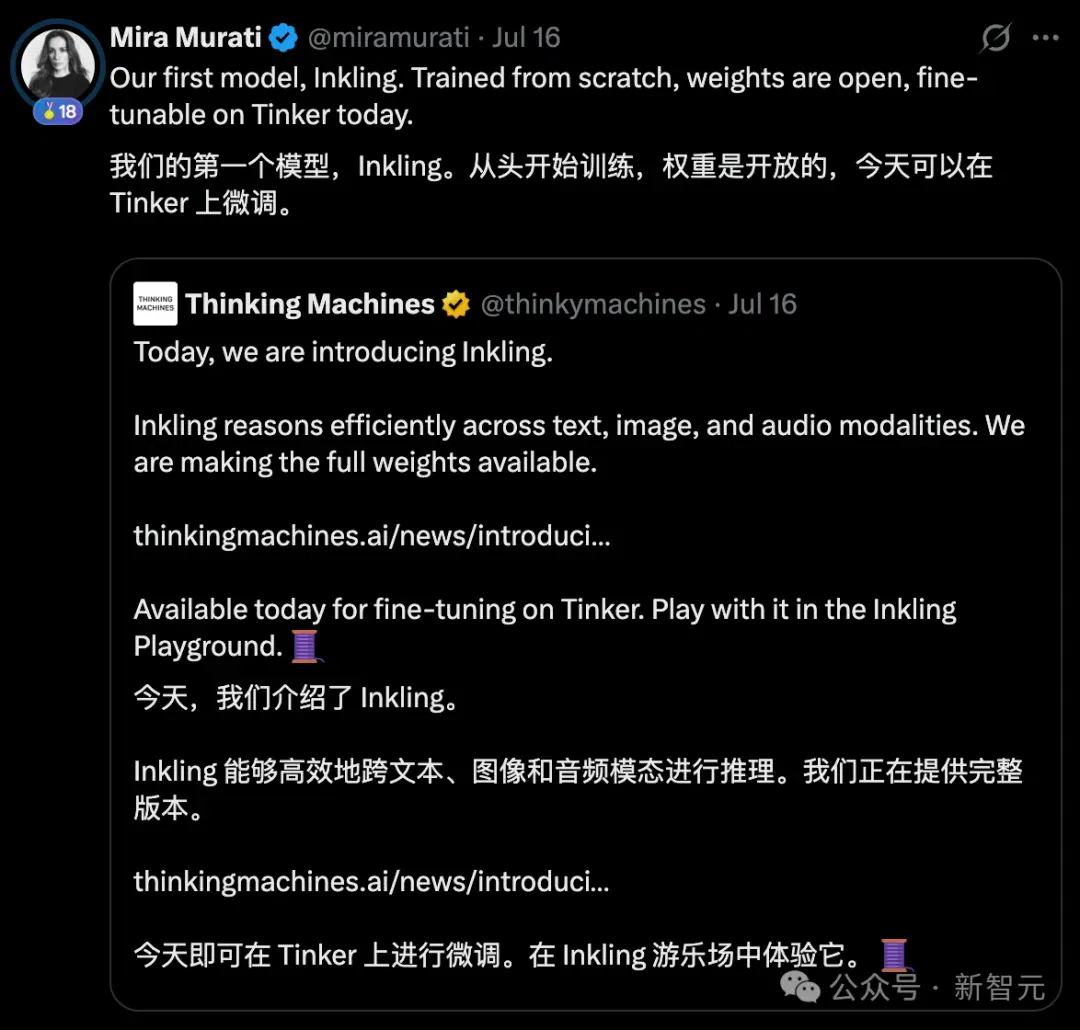
7月15日,前OpenAI CTO Mira Murati在旧金山发布了Thinking Machines Lab的首个模型Inkling。
20亿美元融资,975B参数,100人精英团队——硅谷最受关注的AI创业公司,终于亮牌了。
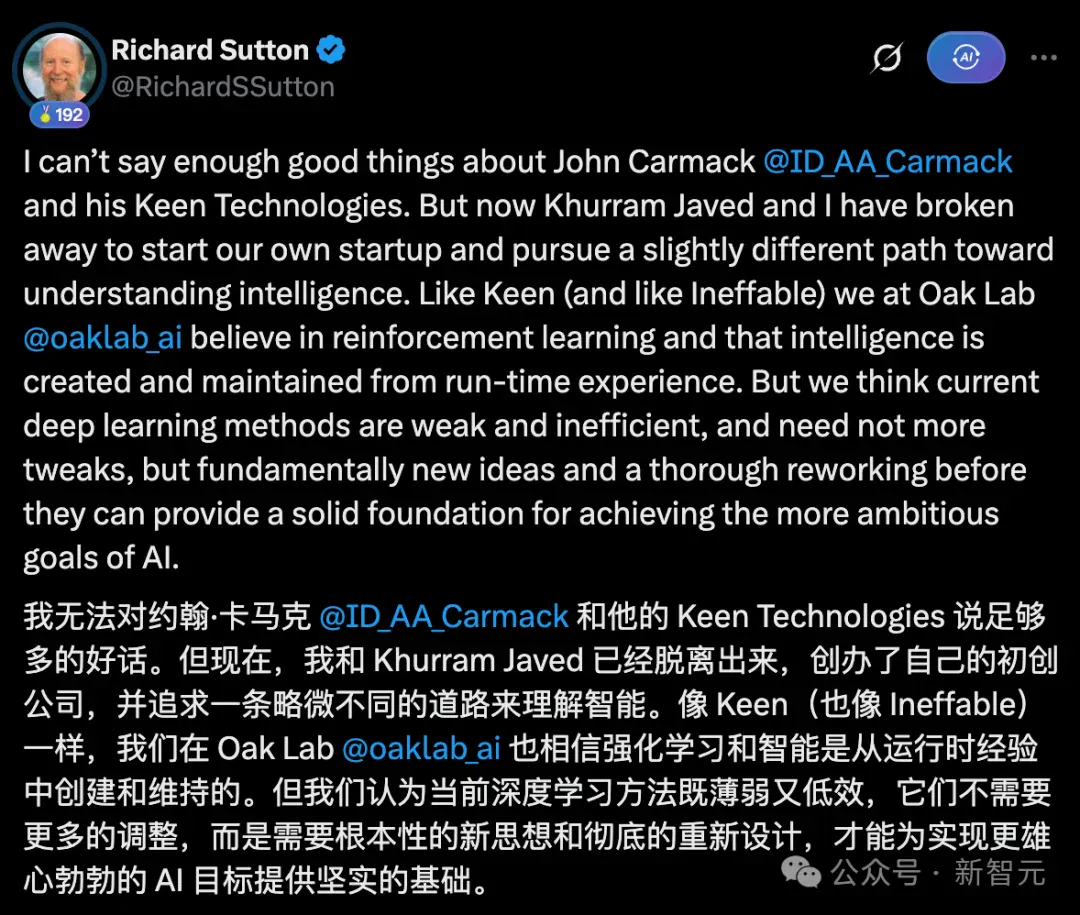
几乎同一天,强化学习之父Richard Sutton,2024年图灵奖得主,年近七十,宣布创办Oak Lab。
老爷子的原话是:「当前的深度学习方法是脆弱且低效的,需要的不是修修补补,而是从根基上重新来过。」
不只是Sutton这么想。DeepSeek创始人梁文锋给出了几乎一模一样的判断。
他把AI的发展比作一级级台阶:语言模型、CoT、Agent……而Agent之后,下一个必须迈过的台阶就是持续学习。
他的观点是,下一代模型的核心能力,它必须要有持续学习的能力,它才能叫下一代模型。如果先把持续学习做出来,通用智能可能就很容易了。
当一条技术路线同时被图灵奖得主、硅谷最受关注的AI创业公司和中国最具创新力的大模型创始人押注,它就不再是一种技术选择,而是一种行业共识。
风向,已经变了。
而就在所有人盯着硅谷的时候,太平洋这边,一家成立不到一年的中国实验室,在同一条赛道上,悄悄交出了一份让人意外的答卷。
Mind Lab,正式发布Macaron-V1。
Mind Lab成立于2025年10月,是Mindverse(心洲科技)旗下的前沿研究实验室。整个团队三十多人,成员来自xAI、DeepMind、DeepSeek、字节Seed、MIT和清华。年初完成5000万美元A轮融资,美团领投,蚂蚁、红杉中国、真格等跟投。
请注意这个数字:5000万美元,后面还会用到。
748B参数直上强化学习
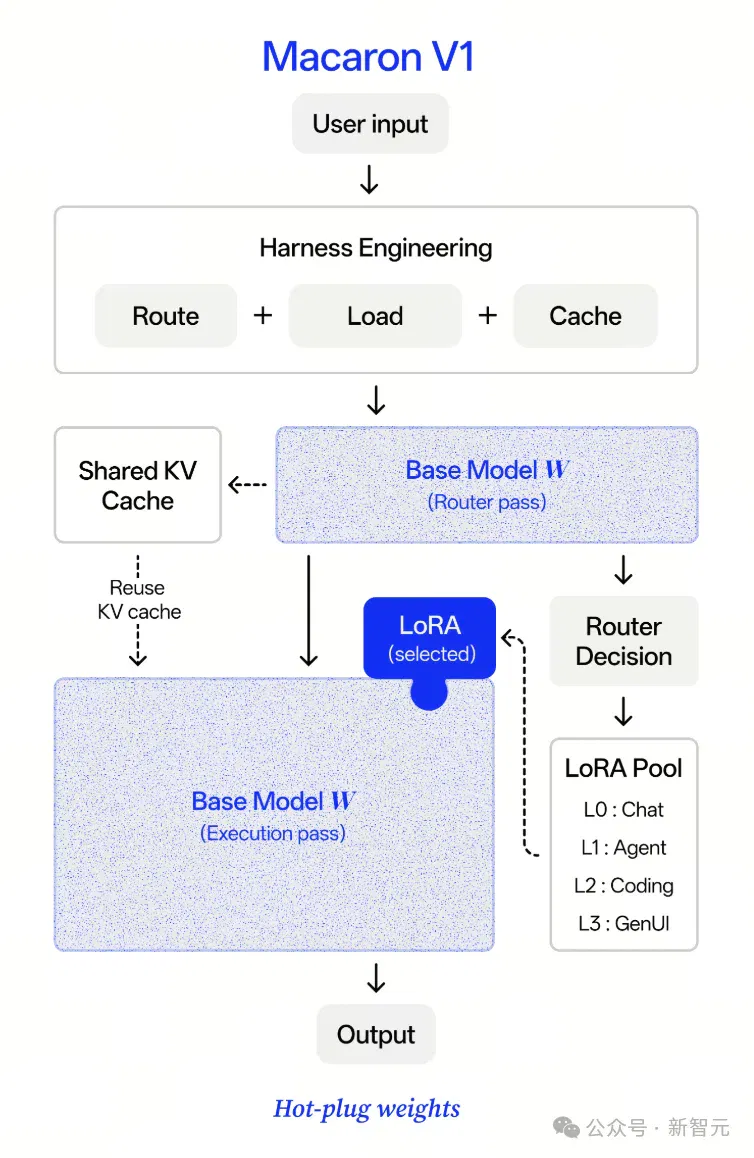
4个LoRA各管一摊
先看模型。
- Macaron-V1分两个版本:旗舰版Venti,748B参数,由744B的GLM-5.2基座加四个1B的LoRA组成,原生2M超长上下文;
- 标准版Tall,35B,基于Qwen-3.6后训练,Mac上就能跑。
但关键不在参数——在那4个LoRA。
过去,LoRA是全参微调的「穷人版替身」。省钱,但打折。
Mind Lab把它重新定义了:基座模型是「共性」,LoRA是「个性」。
什么意思?就像所有iPhone用的都是同一个iOS系统,但你装的App、你的输入法习惯、你的高频操作,让你的iPhone变成了「你的iPhone」。
聊天要自然共情,编程要严格精确,Agent要多步规划,生成式UI要设计交互——挤在一套参数里训练,它们会互相打架。
Macaron-V1的做法简单粗暴:拆。
四个独立LoRA,分管聊天、Agent、编程、GenUI,各自训练、各自评测、各自回滚。
运行时路由器动态切换——你说「帮我排日程」,走Agent LoRA;你说「这段代码有bug」,切Coding LoRA。对用户完全透明。
这套架构有个正式名字:Mixture-of-LoRA(MoL)——不同能力在共享基座之上独立训练、灵活组合、按需调用。不是把一个模型逼成全才,而是让一群专才协同作战。
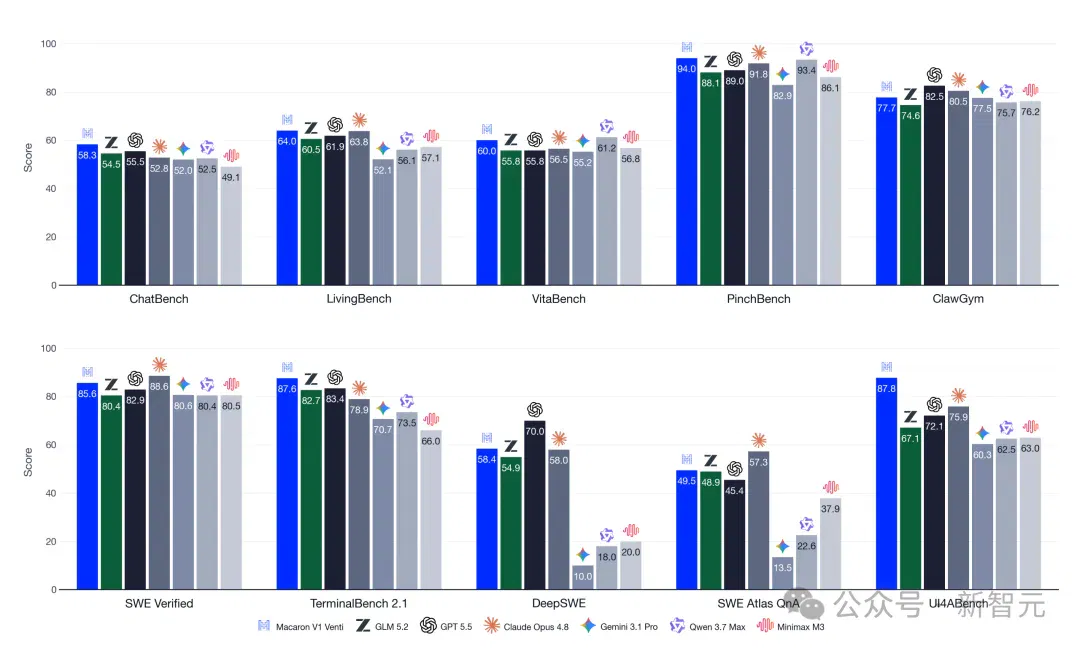
效果上,Macaron-V1还没有在所有能力上做到最强闭源模型的水平。但在整套评测中,它已经能在多数任务上打平甚至超越Opus 4.8、GPT-5.5和Gemini 3.1 Pro——尤其在生活场景、代码能力和生成式UI方向表现突出。
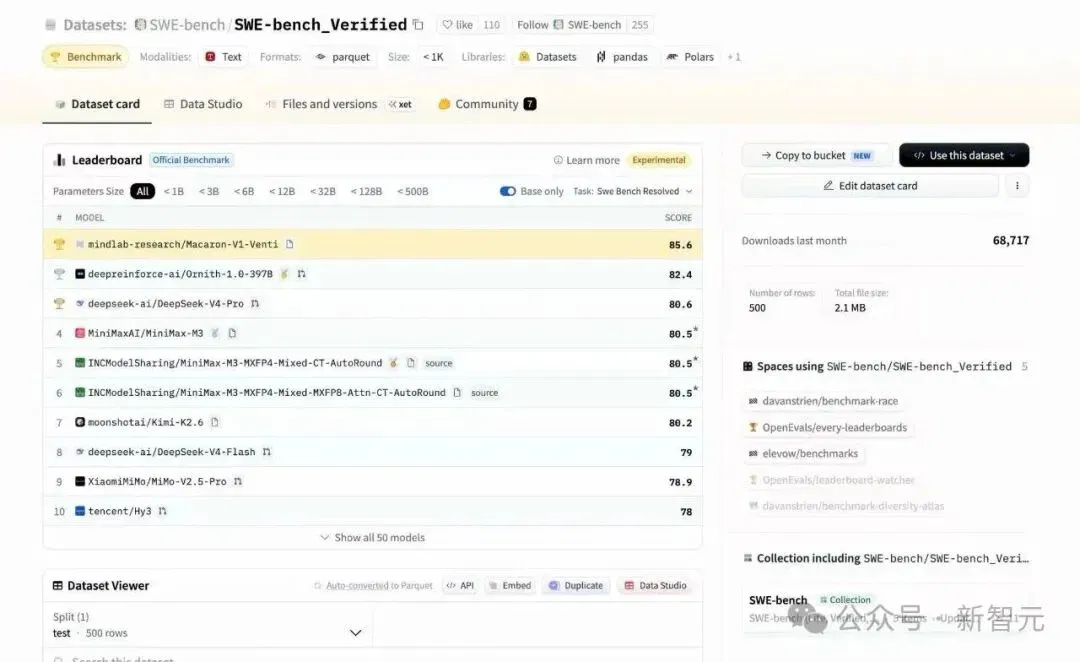
SWE-bench Verified——业内公认最硬的代码能力评测之一,Macaron-V1-Venti以85.6分登顶第一,甩开第二名3分,把DeepSeek-V4-Pro(80.6)、MiniMax-M3(80.5)、Kimi-K2.6(80.2)全部压在身后。
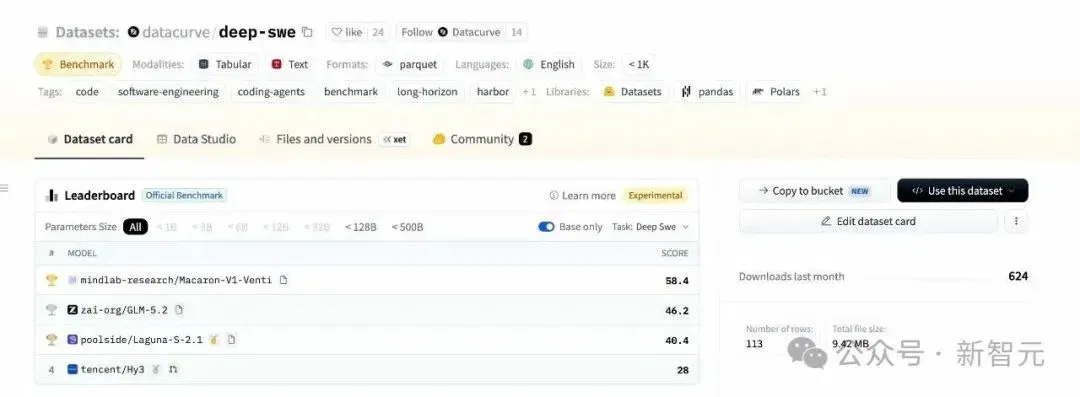
更狠的是Deep-SWE,专测长程复杂软件工程任务。Macaron-V1-Venti拿下58.4分,第二名是它的基座模型GLM-5.2——46.2分。同一个底座,经过LoRA强化学习后训练,直接高出12个点。这就是后训练能带来的增量价值。
更关键的是:开放权重,可私有化部署。闭源模型再强,数据得过别人的服务器。Macaron-V1让你把模型搬回自己家里,数据一个字节都不用交出去。
Andrew在WAIC演讲时秀了一个案例:用户拍一张打乱的魔方照片发过去,模型识别状态、算法求解、生成可交互的3D还原指南——这需要视觉理解、算法、Agent工具调用和GenUI四种能力联动。
还有一个容易被忽略但极其硬核的设计:Model和Harness共设计。
什么意思?大多数模型训练和实际部署是两套环境——训练时用的工具接口、执行流程,和上线后的真实环境对不上,性能打折。
Macaron-V1从一开始就让模型和生产环境的Harness一起训练、一起优化,训练时怎么调用工具、怎么操作终端、怎么跑长程任务,上线后一模一样。
配套的REPL Harness让模型可以通过代码组合工具、保存中间状态、复用有效流程——不用每次从头来,减少重复调用和上下文浪费。
一句话:这不是一个只会聊天的模型,这是一个能办事的智能体。
为什么它是「全球唯二」?
你可能会说:LoRA微调有什么了不起的?满大街都是。
了不起的地方在两个字:规模。
30B模型做LoRA强化学习,很多团队能做。但参数量上到万亿级别,难度指数级上升。
核心难点叫训推不一致。强化学习要一边训练一边推理收集反馈,当万亿参数的MoE模型被切片分布到几十张GPU上,训练精度和推理精度稍有偏差,梯度就会漂移,训练曲线直接不收敛。
打个比方:30人的室内乐团合奏,音准差一点还能兜住。换成百人交响乐团,任何一把乐器走调,整场就是灾难。
全球能在万亿参数规模上跑通LoRA强化学习的团队,只有两家。
一家是Mira Murati的Thinking Machines Lab。一家是Mind Lab。
没有第三家。
2025年12月,Mind Lab在Kimi K2——总参1.04万亿的超大稀疏MoE模型——上跑通了LoRA强化学习。算力只有全参微调的十分之一,训练曲线稳定收敛。
本月的LongStraw,又在固定GPU算力下把强化学习后训练推进到2M上下文。Macaron-V1,就是这些积累的一次集中亮相。
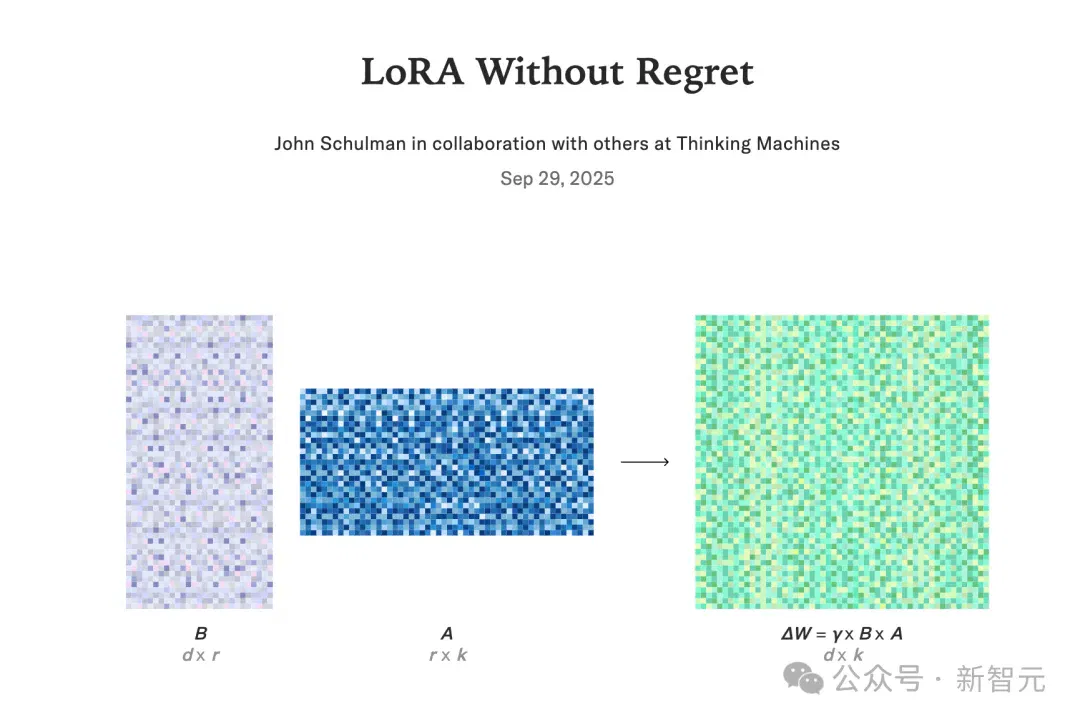
这条路线不止Mind Lab在走。TML首席科学家John Schulman——OpenAI联合创始人、PPO算法发明者——2025年发表了《LoRA without Regret》,实验证明LoRA在大多数后训练场景下,性能与全量微调完全一致。他管这叫「低遗憾区间」。
行业也在用真金白银投票。上周完成15亿美元D轮的Fireworks AI,估值175亿美元,能托管数百个LoRA;Together AI完成8亿美元C轮,已把LoRA设为默认微调方式。
硅谷花20亿做底座,它花十分之一站在巨人肩上
这里有一个非常有意思的对比。
Mind Lab和TML走的是同一条技术路线,但底座策略截然相反。
TML因为种种原因,选择自己从零训基座。Inkling,975B参数,45万亿token——但Murati自己也公开承认:「这不是目前最强的模型。」
评测显示,Inkling明显弱于GLM、Kimi等中国开源模型。从零做底座,让他们消耗了大量精力和算力。
Mind Lab反着来。它不自己训底座,直接站在中国开源模型生态的肩膀上。
Kimi K2验证万亿参数LoRA RL、V1-Preview基于GLM-5.1、正式版Venti用GLM-5.2、Tall用Qwen-3.7——每次基座升级,后训练的起跑线就高一层。
中国开源模型已经卷到了全球接近SOTA的水平。拿这些接近天花板的底座,再通过LoRA强化学习把关键能力推到真正SOTA。
你不必自己种麦子,就能烤出最好的面包。
对比多残酷?
TML:20亿美元融资、100人团队、英伟达千兆瓦级算力合作——Inkling能力仍落后于GLM-5.2。
Mind Lab:三十多人、不到5000万美元融资——Chat、Agent、Coding等多个维度做出了更强的模型。
在LoRA强化学习这件事上,Mind Lab可能是全球投入产出比最高的团队。没有之一。
持续学习:凭什么模型越用越聪明?
讲完技术和对比,到了最核心的问题:Mind Lab到底在下什么棋?
答案藏在Richard Sutton和AlphaGo前首席研究员David Silver联合发表的一篇文章标题里——Welcome to the Era of Experience。
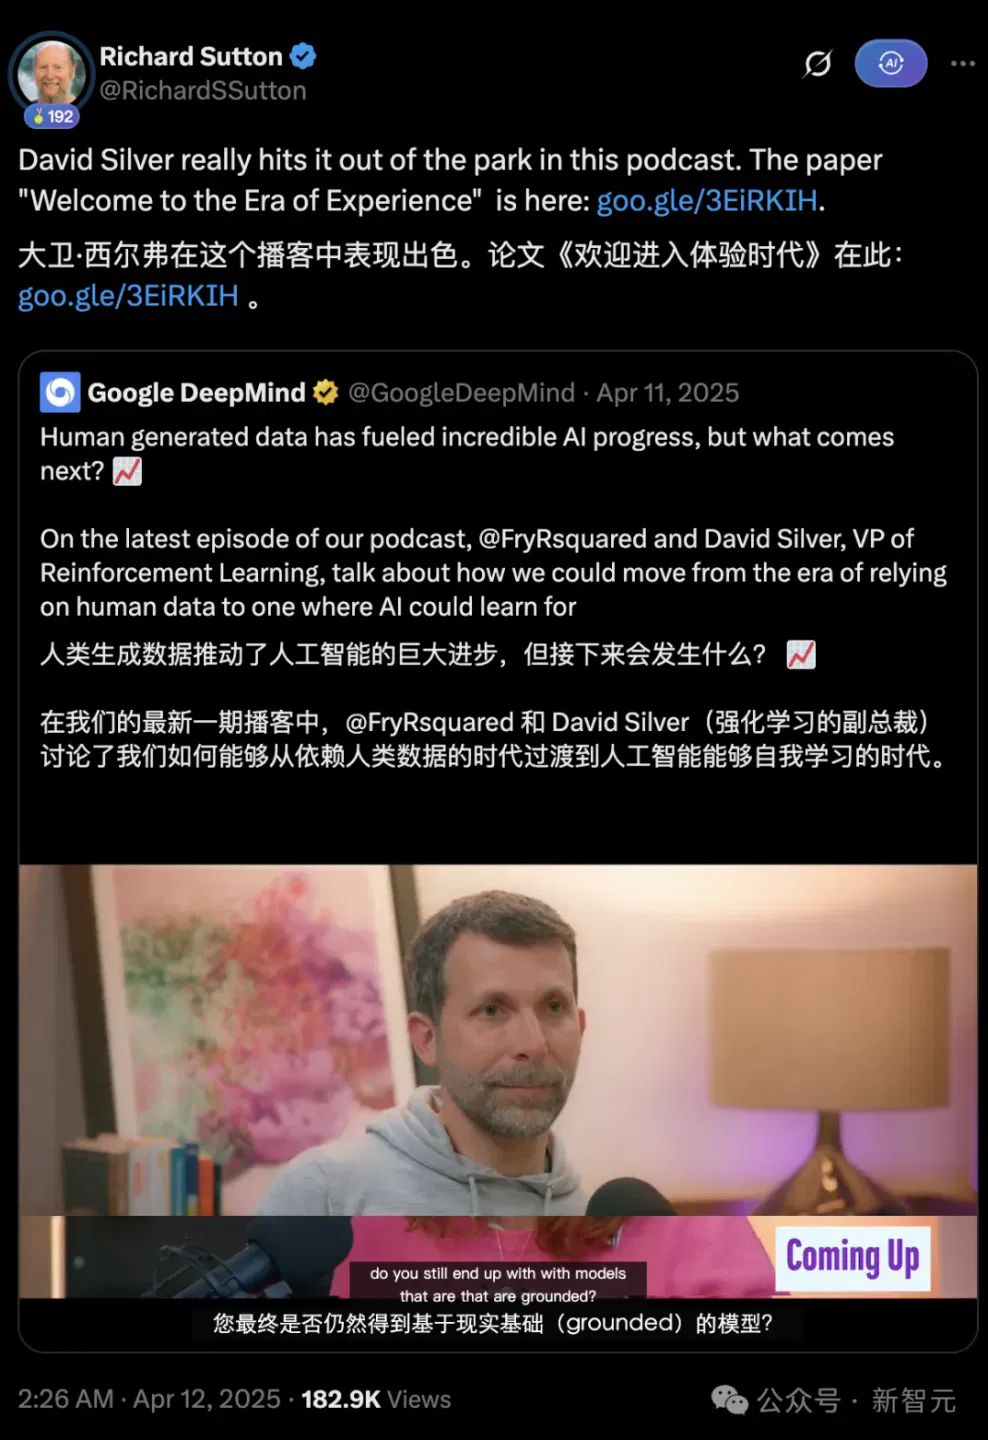
预训练是「数据时代」:模型从人类已有的文本中学习。
下一个时代是「经验时代」:AI的能力不再来自已有数据,而来自智能体在真实环境中的长期行动、反馈与持续学习。
今天大模型的根本矛盾就在这里——训完了就冻住了。
一个用户纠正了同一个错误十次,下次模型还得重读聊天记录。一个Coding Agent在同一个代码库反复失败,失败不会变成新能力。模型每天处理海量任务,但经验全部流失了。
它只是一台无限重复的推理引擎,不是一个在成长的智能体。
Mind Lab要做的,就是打破这个死循环。他们的目标是造一台「经验智能机器」——模型离开实验室后,仍然在真实世界里持续学习。
经验变成新能力,新能力让它解决更难的问题,更难的问题又带来更丰富的经验。
智能不再是一次训练的结果,而成为持续生长的过程。
LoRA在这里不再是「省钱工具」,而是一种可写入、可回滚、可独立演化的持久状态。
基座承载通用知识,LoRA承载你的偏好、你的代码风格、你的业务逻辑。不是静态补丁,是随交互成长的记忆。
实验证明,轻量适配模块压缩到基模参数的0.5%以下,仍然稳定可靠——基座越强,小规模更新反而越有效。
这条路Mind Lab走了三年。2023年,创始人Andrew与GPT-1作者Karthik Narasimhan、姚顺雨合作发表了FireAct——第一篇用参数学习提升Agent能力的工作。Agent轨迹写入参数后,单次执行从9.0秒降到2.7秒。
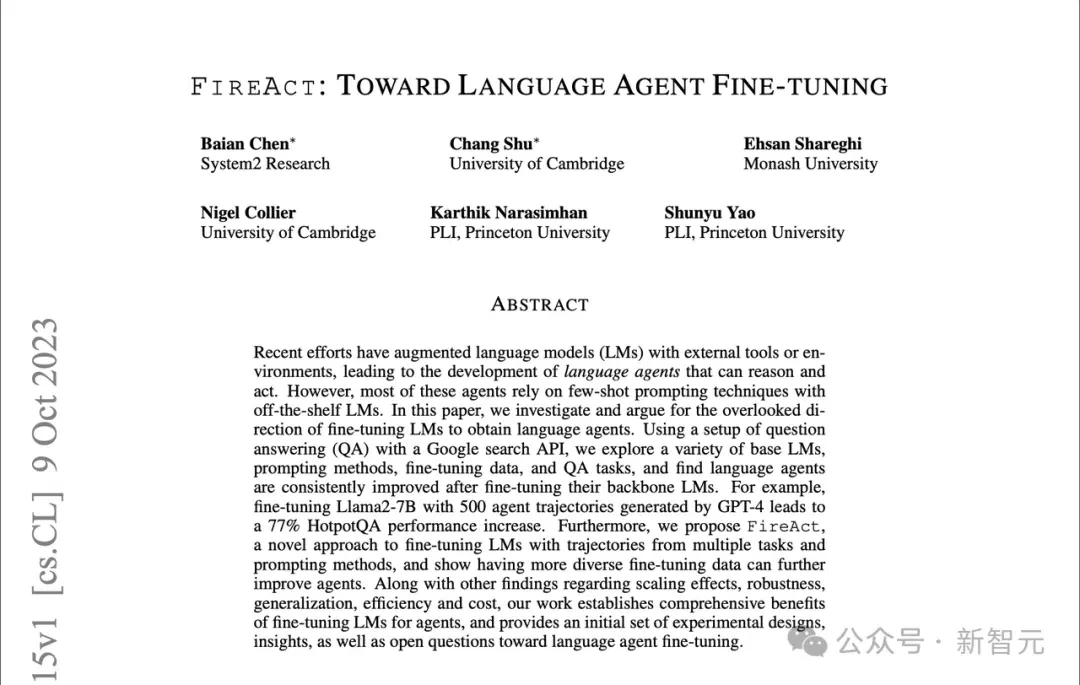
为学习付一次成本,之后每次使用都是回报。从FireAct到Macaron-V1,这个逻辑被放大到了万亿参数的尺度。
群体智能:第三条Scaling曲线
持续学习只是故事的一半。Macaron-V1体现的第二个核心理念,可能更颠覆——群体智能。
每个模型沿着自身经历持续学习,不同实例就会走向不同方向。不同用户反馈、不同任务、不同数据,塑造出不同能力。同一个基座出发,时间长了会长成「不同的人」。
这种多样性,是bug还是feature?实验结果很炸。
从相同的Qwen3-30B基座出发,训练目标和算法完全一致,只改变数据顺序和masking。
单个adapter在AIME24上准确率:36.44%。198个不同adapter做多数投票:48.67%。同一个adapter重复采样198次,最高只有:43.78%。
不同的「经历」,带来了单个模型给不出的互补性。这不是「多试几次」——而是多样化学习路径之间产生了真正的协作效应。
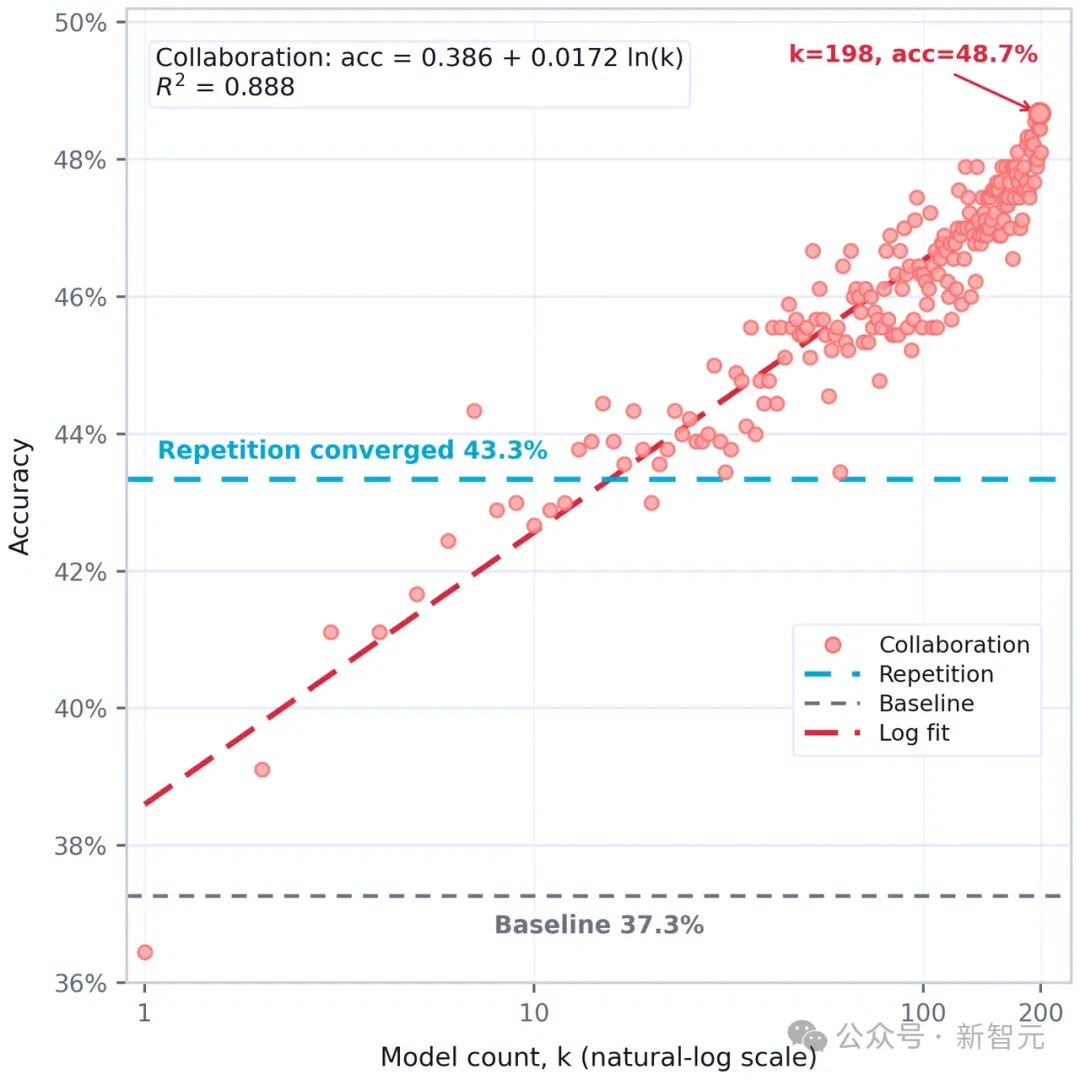
Andrew在WAIC把这叫做第三条Scaling曲线。
- 第一条:GPT-3式的Scale Parameters——更大的参数带来更高智能。
- 第二条:DeepSeek R1式的Scale Thinking Tokens——更多推理token带来更高智能。
- 第三条:Scale Number of Models——更多模型之间的协作带来更高智能上限。
实验中,模型数量从几个增到200个,在对数坐标轴上性能线性提升。如果曲线成立,下一步是从200推到2万、200万。
Mind Lab自研的MinT平台已经建立了百万级可寻址LoRA目录。100万个LoRA共享同一个万亿参数基座。
注意——这不是100万个小模型,是100万个一万亿参数的大模型。
人与人共享99%以上的基因组,但几乎相同的生物基础没有造就相同的心智。正是智能的多样性及其协作,带来了人类文明最伟大的成就。
2周1000万美金ARR:最快商业化验证
技术路线再漂亮,市场不买单就只是PPT。Mind Lab 7月初开放API商业化。
结果2周,1000万美金ARR。
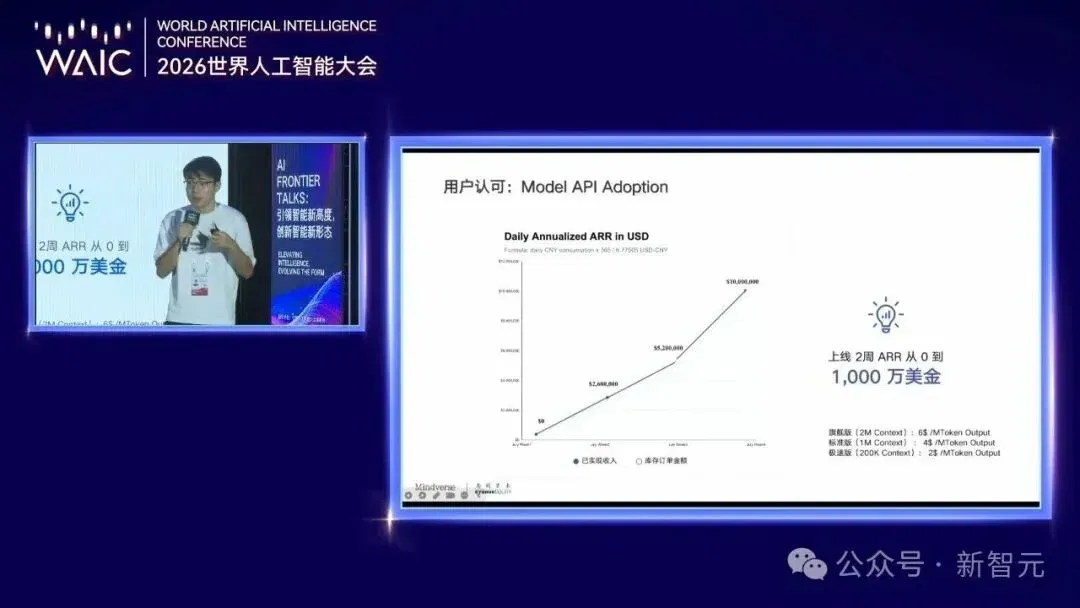
这很可能是所有模型公司从第一个模型发布开始,最快实现千万美金ARR的记录。
数字重要,但更重要的是速度。一条技术路线能被客户这么快用真金白银投票,说明它解决的是真问题、痛问题。
Mind Lab卖的不只是Token。它的核心商业逻辑是:客户买到的是模型在自身场景中持续学习和迭代的能力。
手机厂商把产品知识训进专属LoRA,耳机公司把交互偏好写入模型状态——核心数据不必交给基模公司重训,客户自己掌握控制权。
韶音科技、AI硬件初创Odyss、某头部手机厂商,已经在合作名单上。
API调用结构也说明问题:20%聊天,30%Agent工作流,30%代码生成,剩余来自GenUI——场景分布均衡,不是靠单一爆款撑起来的虚假繁荣。
旗舰版6美元/百万token,标准版4美元,极速版2美元。
Mind Lab给出的愿景只有一句话:会用Token,就能训Token。
训练模型这件事,最终要像调用模型一样简单。不需要大量售前,不需要定制人力。持续学习本身,就是可规模化的模型能力。
题门推开了
Richard Sutton在多伦多喊出「经验时代」。梁文锋认为必须有持续学习能力,才能叫下一代模型。Mira Murati在旧金山搭万亿参数LoRA强化学习基础设施。Fireworks AI估值175亿美元。
所有人都押同一个方向:模型应该在部署后继续学习。LoRA是让这件事在万亿参数尺度上可行的关键技术。
Mind Lab是这条赛道上最年轻的选手。但起跑姿态可能最高效——不做底座,站在中国开源生态上,三十多人和不到5000万美元融资,做到了和硅谷百亿级团队同一水位的技术能力。
这背后是一个简单但深刻的判断:
大模型竞争的终局,不在「谁训出最大的底座」,而在「谁能让模型持续变聪明」。
预训练是一次性的基建。持续学习,才是真正的护城河。
Mind Lab想造的,是一台经验智能机器——模型离开实验室之后,仍然在真实世界里持续学习,越用越聪明。当足够多这样的智能开始协作,一条通向更高智能的新路线就会打开。
Murati用20亿美元和100人的团队在旧金山推这扇门。
而先把门推开一条缝的,是太平洋这头,一家站在中国开源生态肩膀上的年轻实验室。
文章来自于"新智元",作者 "所罗门"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
爆改GLM-5.2!全球首款200万上下文混合LoRA开源,外挂四大专家彻底治愈技能冲突 (opens in a new tab)
最近手头在测一个新模型,叫 Macaron-V1。说实话一开始没抱太大期待,打着「个人智能体」旗号的产品这两年太多了,大多数打开之后还是那套老配方:一个聊天机器人,外面挂几个插件。但测了三四天下来,发现这个模型的思路跟我预想的不太一样,值得认真写一篇。
马卡龙的下注:把模型后训练,做成企业服务 (opens in a new tab)
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
两周一次迭代,1000美元起,这家公司想让后训练“人人可用” (opens in a new tab)
最近几个月,后训练成了 AI 行业最集中的议题。
独家丨美团领投 A 轮, Mindverse 总融资 5000 万美元,打造持续学习的 Agent 模型 (opens in a new tab)
Mindverse 完成由美团领投的 A 轮融资,元禾璞华、韶音、变量资本和老股东追加跟投。Mindverse (心洲科技) 是少数把赌注押在模型「内部」的一家创企,它在通用大模型的基础上,用强化学习让它从复杂、多步骤的真实任务中学会如何把事做成,让模型从「知道很多」变为「能办好事」。
Macaron 新版本拆解:三个信号,看懂 Personal AI 的进化路径 (opens in a new tab)
最近刷到了 Macaron 发布的一条技术视频。