Mind Lab连续发布LoRA最新进展,大模型「持续学习」新范式浮现 (opens in a new tab)
最近,前沿实验室 Mind Lab 密集发布了一系列关于 LoRA 与 PEFT(高效微调)的研究结果,似乎描绘出了另一条大模型「持续学习」的路径。在 Mind Lab 的视角中,PEFT 不再是对大模型全参数后训练的一种廉价平替,更是实现从 “基础模型” 向 “可持续学习智能体” 过渡的核心架构机制。
Total 4 articles
最近,前沿实验室 Mind Lab 密集发布了一系列关于 LoRA 与 PEFT(高效微调)的研究结果,似乎描绘出了另一条大模型「持续学习」的路径。在 Mind Lab 的视角中,PEFT 不再是对大模型全参数后训练的一种廉价平替,更是实现从 “基础模型” 向 “可持续学习智能体” 过渡的核心架构机制。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
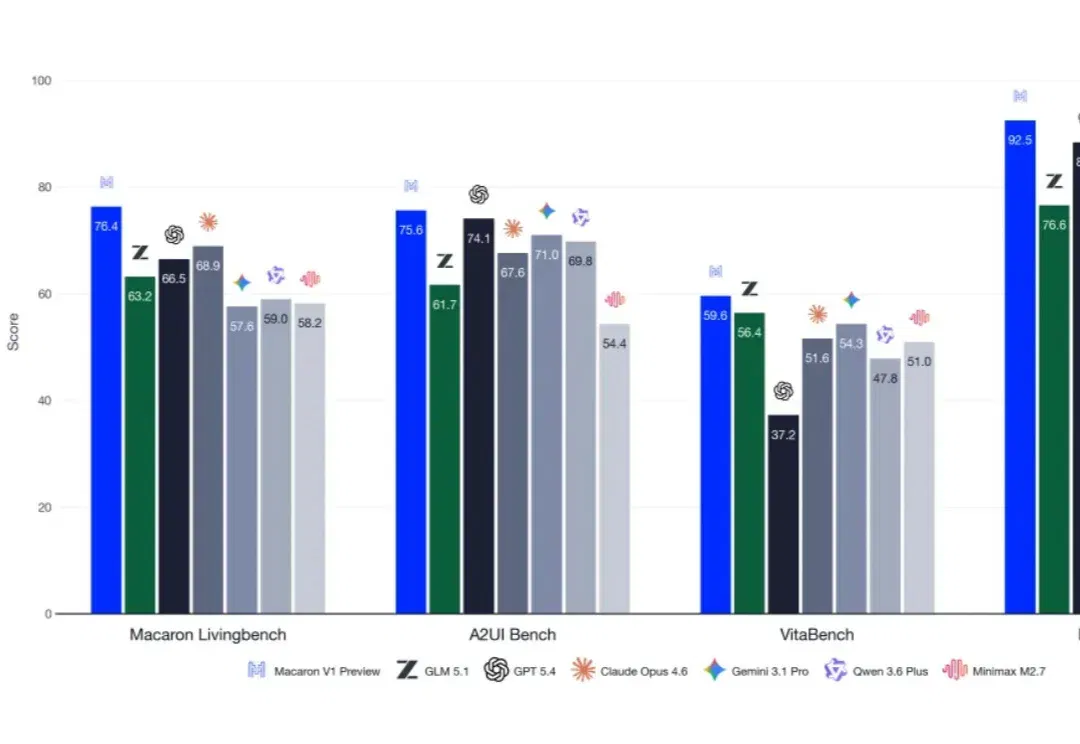
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
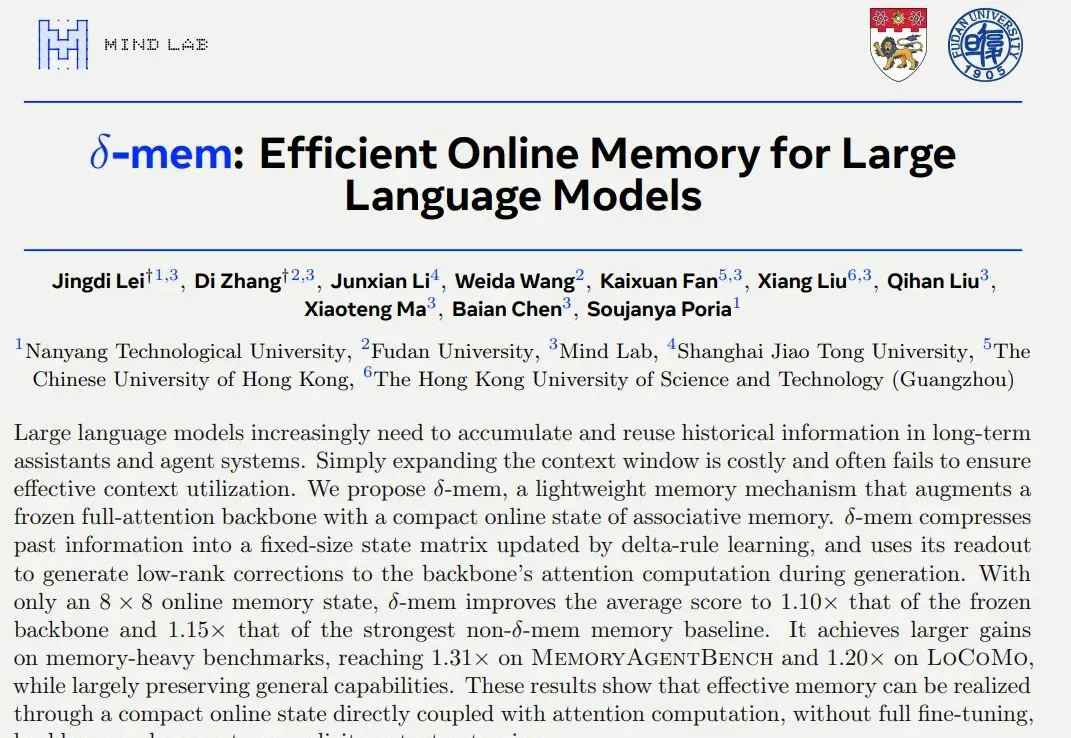
不扩上下文窗口、不换骨干架构、不做全参数微调 —— 只需要一个 8×8 的在线状态矩阵,就能让冻结的 Transformer 拥有真正的长期记忆。