全模态模型Qwen3.8-Omni-Flash发布
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
今天,新一代原生全模态模型Qwen3.8-Omni-Flash正式上线。该模型的核心目标是提升其在真实生产力场景中的 Agent 能力,推动全模态模型从“理解全模态内容”进一步走向“规划任务、调用工具并完成创作”。在具备编程、文本知识工作和 GUI 操作等通用 Agentic 能力的基础上,Qwen3.8-Omni-Flash 进一步拓展了以音视频为核心的 Agentic 应用,在视频剪辑、音乐视频创作、影视制作与解说、音视频转图文摘要和音视频对话等,需要综合处理文本、图像、音频与视频的工作流中取得了显著效果。
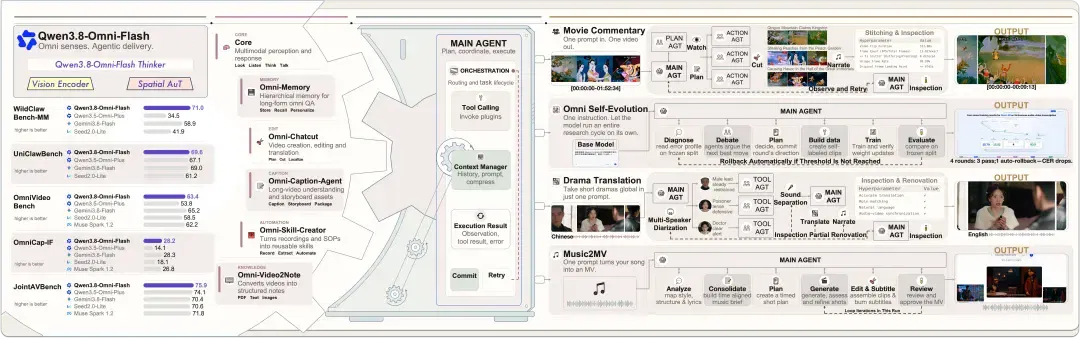
图 1:Qwen3.8-Omni-Flash 与其在生产环境中的应用
支持文本、图像、音频和视频输入,以及 1M 长上下文
Qwen3.8-Omni-Flash现已上线千问AI平台:
https://www.qianwenai.com/models/qwen3.8-omni-flash
Qwen3.8-Omni-Flash 支持 1M 长序列,在保持与同尺寸文本模型相当的文本能力的同时,全模态能力显著提升。
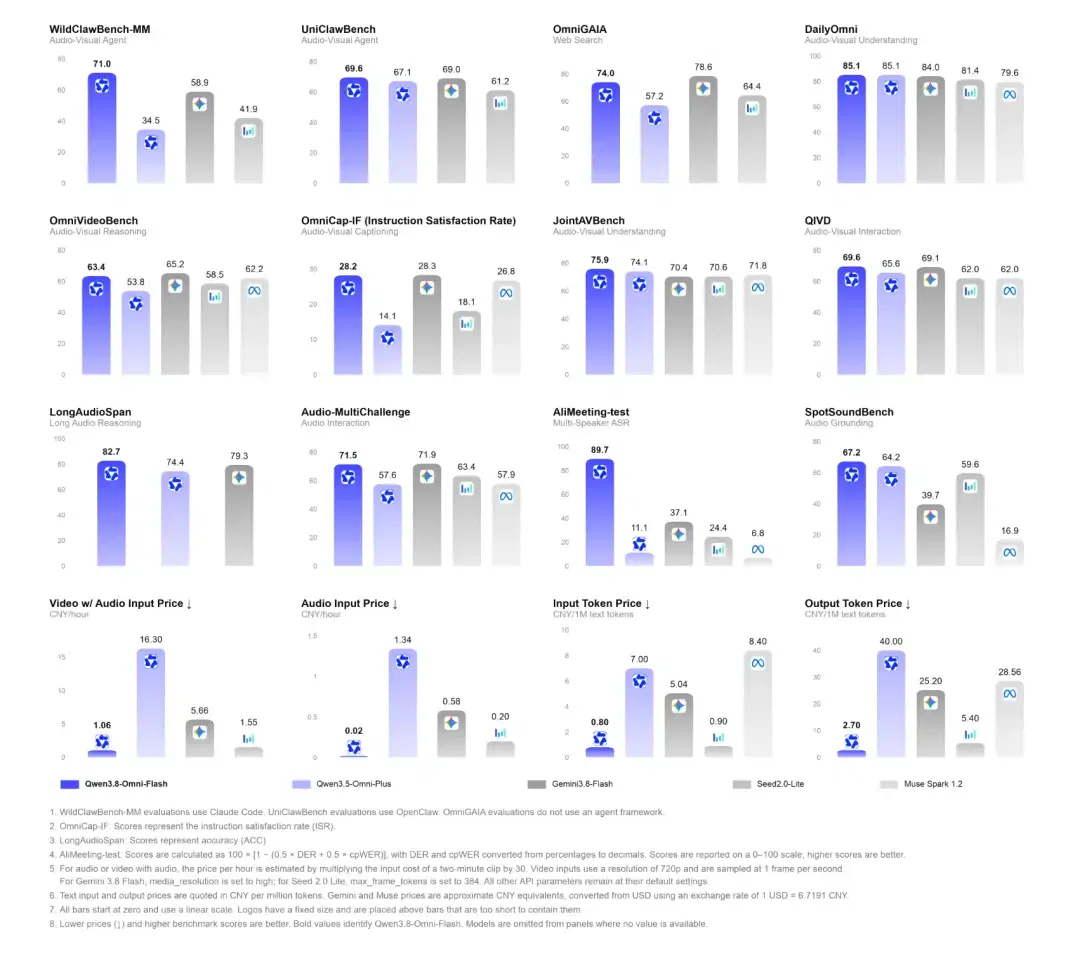
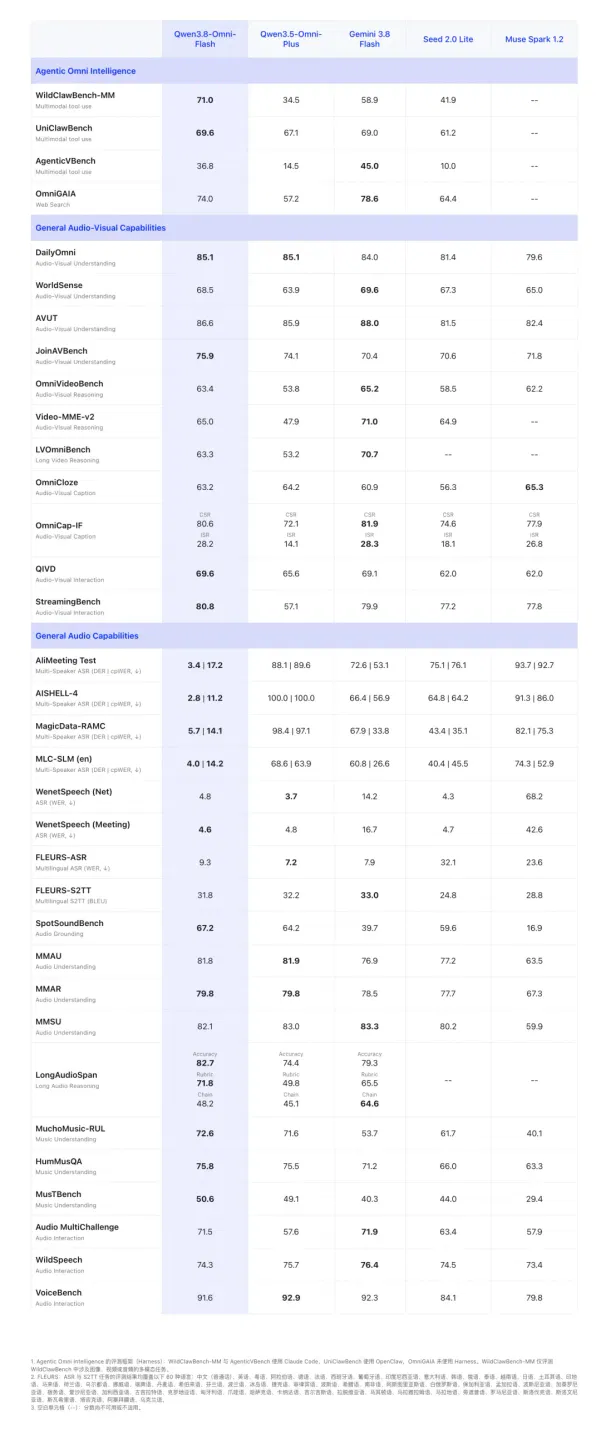
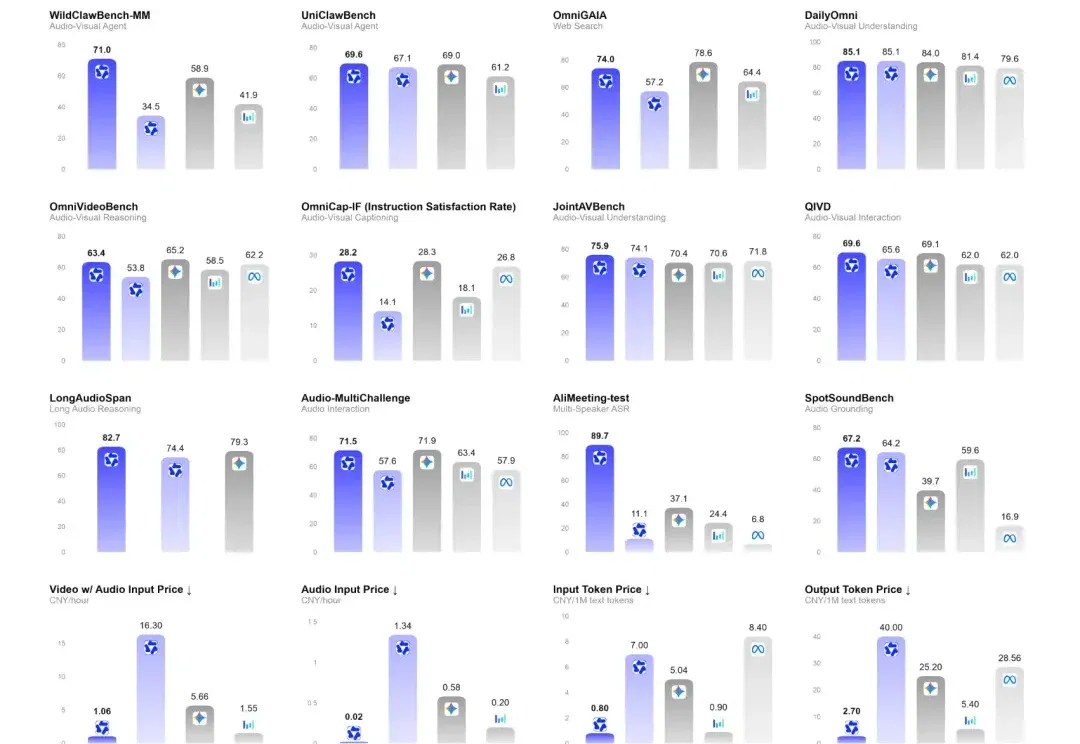
在累计 30 项评测上,相比上一代 Qwen3.5-Omni-Plus,平均得分提升超过26%。
在音视频 Agent、Coding 和长程任务方面,模型在 WildClawBench-MM 上大幅提升36.5分,在 AgenticVBench 上提升22.3分,并在 UniClawBench 上取得 69.6的高分。
基础能力方面,模型在长音频/音视频理解、音视频推理、音视频 Caption 和多说话人识别上均有明显提升:例如,LongAudioSpan 提升8.3分,OmniVideoBench 提升 9.6 分,OmniCap-IF 的 CSR / ISR 分别提升 8.5 / 14.1 分,AliMeeting 的 DER / cpWER 从 88.11 / 89.61 降至 3.35 / 17.18。
通过扩展数据、上下文与 Agentic Environment,Qwen3.8-Omni-Flash 的音视频能力接近 Gemini 3.8 Flash,音频能力整体超过 Gemini 3.8 Flash。
这些能力的进一步提升,也意味着音视频正在从模型的感知输入,进一步成为 Agent 理解环境、开展推理并执行任务的核心载体。
同时,Qwen3.8-Omni-Flash的API 每小时音频输入价格降幅超过98%,每小时音视频输入价格降幅超过93%。
音视频是 Agent 走向真实生产力场景的重要载体,但也带来了一组新的系统挑战:长音视频的文件存储、网络传输与多轮推理成本高昂,现有 Agent Harness 框架缺乏对音视频的原生支持,而从全模态理解到端到端任务执行的工作范式仍处于早期阶段。解决这些问题,需要模型、Harness 工具与运行环境协同演进。
围绕这些挑战,我们在 Qwen3.8-Omni-Flash 上探索了如何贯穿素材理解、任务规划、工具执行与结果交付的完整链路,完成视频剪辑、翻译、电影解说和内容创作等端到端长程工作流,推动 Omni 从理解音视频进一步走向自主行动与任务交付。
为此,我们进一步扩展了Qwen-MM-Plugins,为长音视频的按需感知、工具调用与工作流执行提供支持;同时开源Qwen-Live Harness,为实时、持续的全模态交互提供原生运行环境。两者分别面向长程工作流与实时交互,并在与模型的共同迭代中持续拓展全模态 Agent 的能力边界。
- Qwen-MM-Plugins:
https://github.com/QwenLM/Qwen-MM-Plugins
- Qwen-Live Harness:
https://github.com/QwenLM/Qwen-Live-Harness
长音视频理解
Qwen3.8-Omni-Flash 实现了长音视频理解能力的全新升级:从按需描述、Agentic 主动取证,到理解并推进会议任务,再到生成以视频为中心的深度研究报告,不只是看得更久,更能找得准、理解深、执行快。
可控音视频 Caption
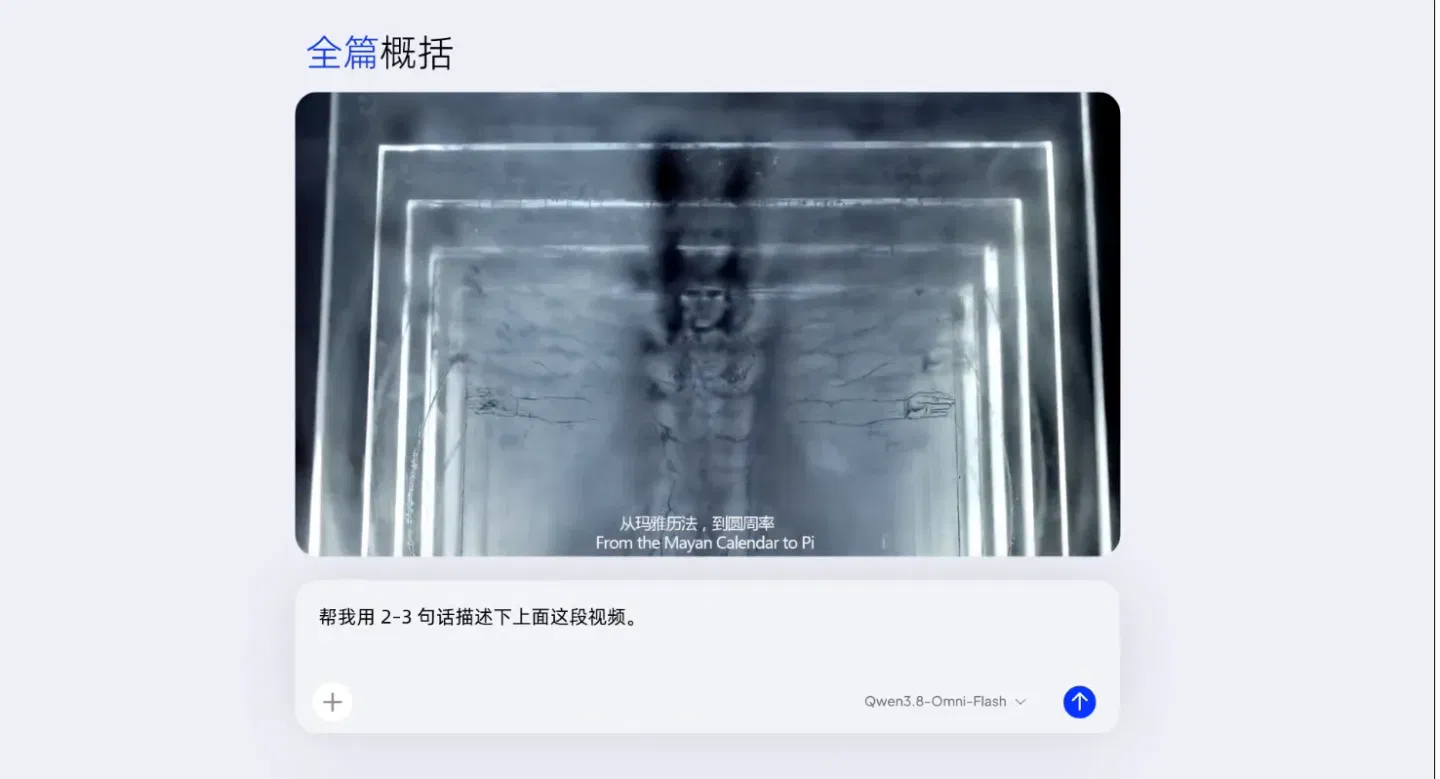
视频描述不应只有一种答案,内容创作关心叙事,素材检索关心片段,资产管理关心结构。不同业务,需要不同的视频描述。在 Qwen3.8-Omni-Flash 中,我们对视频描述能力进行了全新升级:从回答“模型看到了什么”,走向理解“用户想知道什么”。描述对象、时间范围、信息粒度与输出格式均可自由指定;面对同一段视频,既能纵览全貌、定位关键片段,也能深入分析人物动作、镜头、光影与声音,并按需输出结构化结果。看什么、看多细、怎么呈现,由你定义。
Agentic 长音视频理解
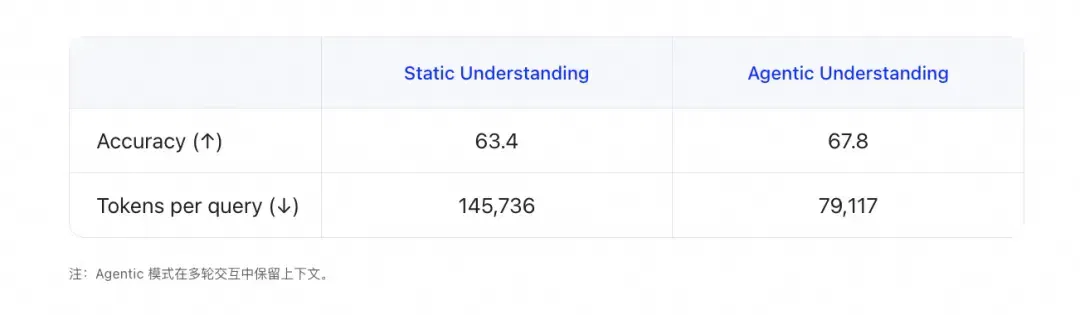
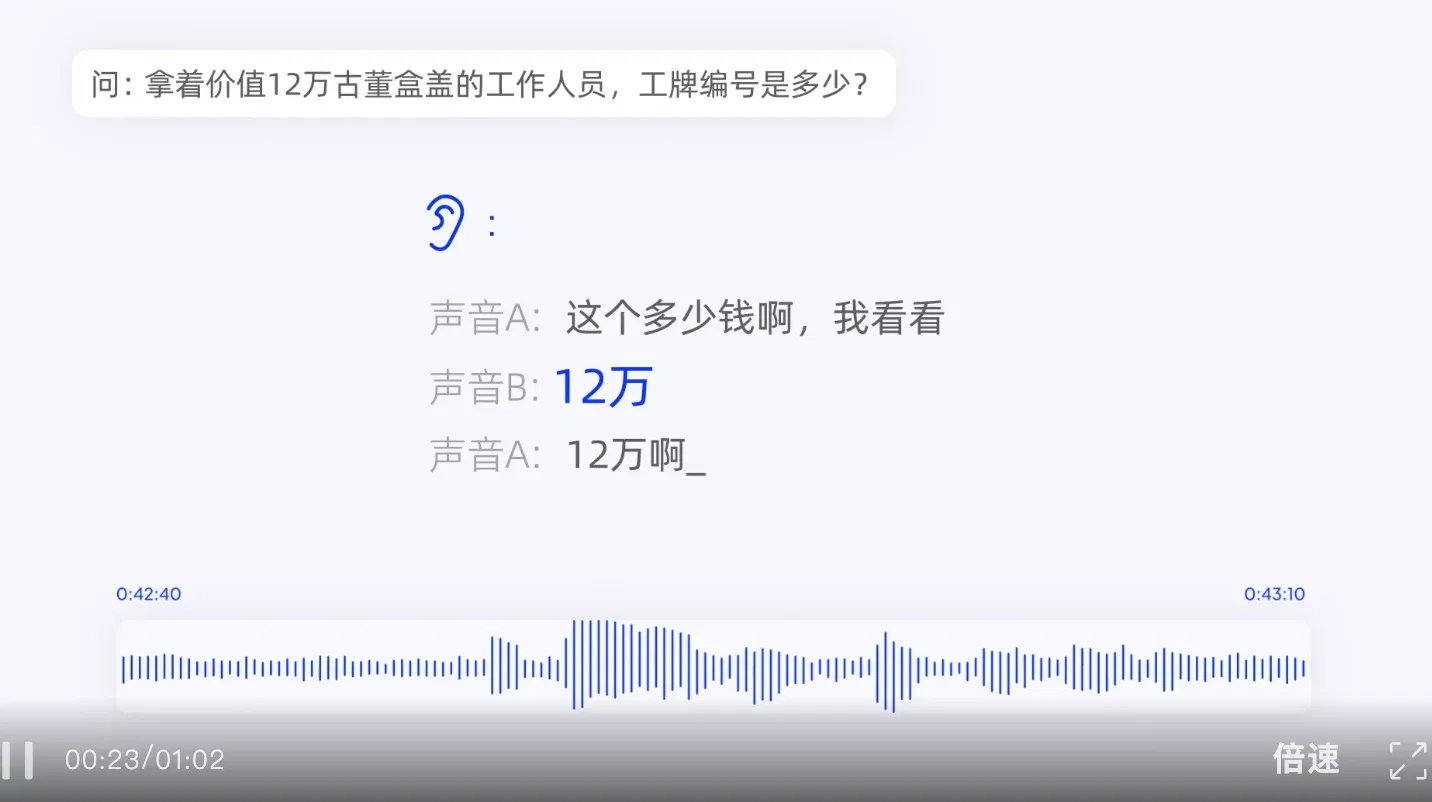
面对数小时的长视频,传统方法通常需要从头到尾处理全部内容,即使答案只存在于其中几分钟的片段内。Qwen3.8-Omni-Flash 原生 Agent 则从问题出发,自主决定该看什么、听什么,并通过由粗到细的多轮取证定位关键信息。它无需逐帧处理整部视频,即可将有限的计算与 Token 预算集中在真正相关的片段上,实现更高效的长视频理解。
OmniVideoBench实验表明,Agentic Understanding将准确率从 63.4 提升至 67.8,同时将 Token 消耗从 145,736 降至 79,117,降幅约为 45.7%。下表对比了 Static Understanding 与 Agentic Understanding 在 OmniVideoBench 上的准确率及 Token 消耗:
长会议,从记录到执行
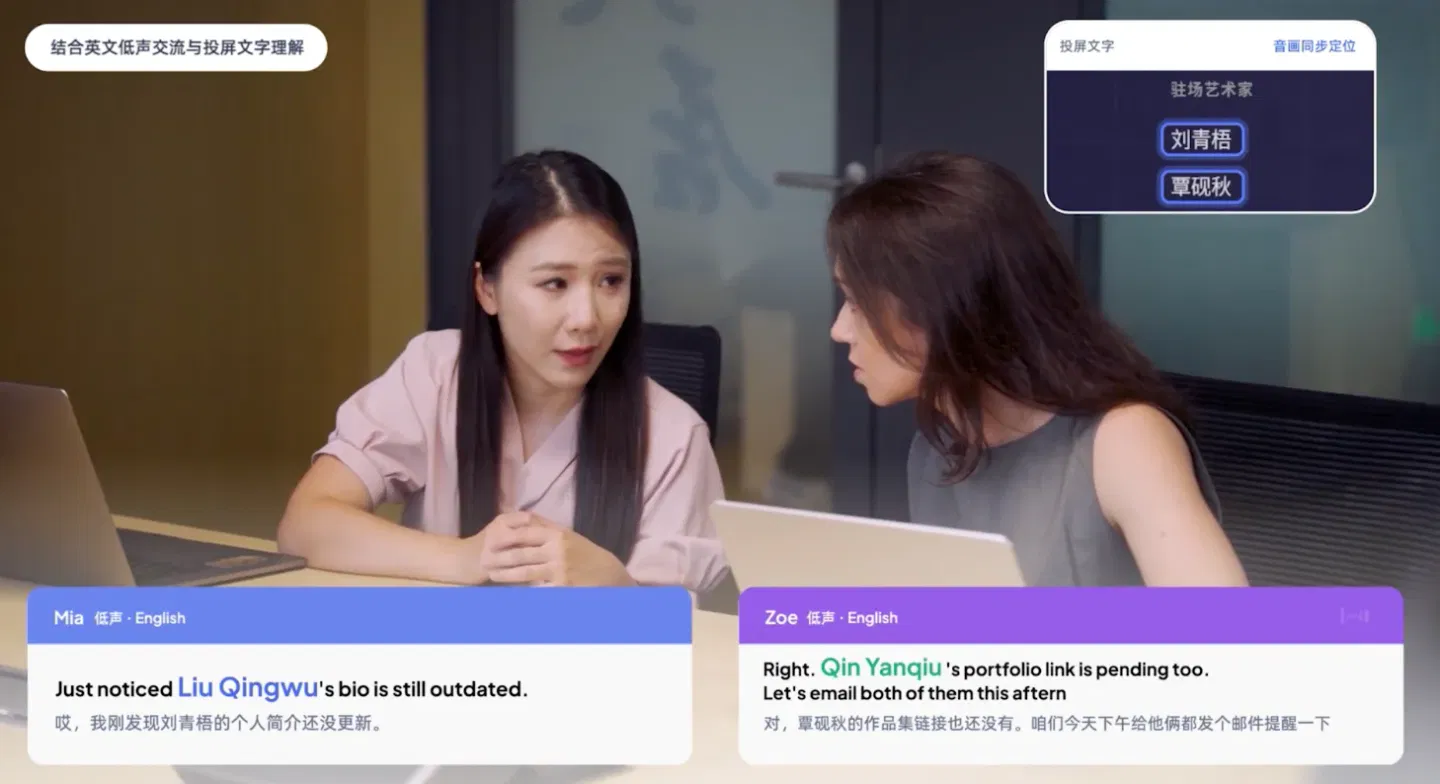
多人会议是音视频理解中最复杂的场景之一:多人交替发言、声音相互重叠,人物身份、指代关系与讨论主题持续变化。
Qwen3.8-Omni-Flash 具备多说话人音画协同识别能力,原生支持最长一小时的音视频输入,能够联合理解人物画面与语音内容,端到端完成说话人切分、内容转录与身份对应。输入完整会议视频并描述需求,模型即可梳理参会者关系、生成会议纪要与待办事项,并分析项目风险。同时,借助视觉信息解决音频中的指代与实体歧义。结合 Agent 与工具调用,它还能发送邮件、整理任务,甚至依据会议需求直接开始编码。从听懂会议,进一步走向执行工作。
通过音视频开展深度研究
当用户带着具体问题观看视频时,所需的答案往往不止于视频本身。Qwen3.8-Omni-Flash 能结合用户需求与视频内容,挖掘值得深入研究的问题,梳理视频重点,并检索网页、图片、视频和文档等多模态资料,生成以视频为中心、图文并茂的研究报告,帮助用户深入理解视频内容、解决实际问题。例如,用户在 Photoshop 抠发时遇到彩边问题,模型可以拆解教程步骤、研究 Multiply / Screen 混合模式的原理、对比其他边缘修复方案,帮助用户理解不同方法的适用条件,判断哪种方案更适合自己的情况。
音视频生产与编辑
Qwen3.8-Omni-Flash 正在将音视频 Agent 推向新的阶段:从理解声音与画面,到自主规划、调用工具并交付成片,让全模态智能真正进入专业音视频内容生产流程。
Music2MV
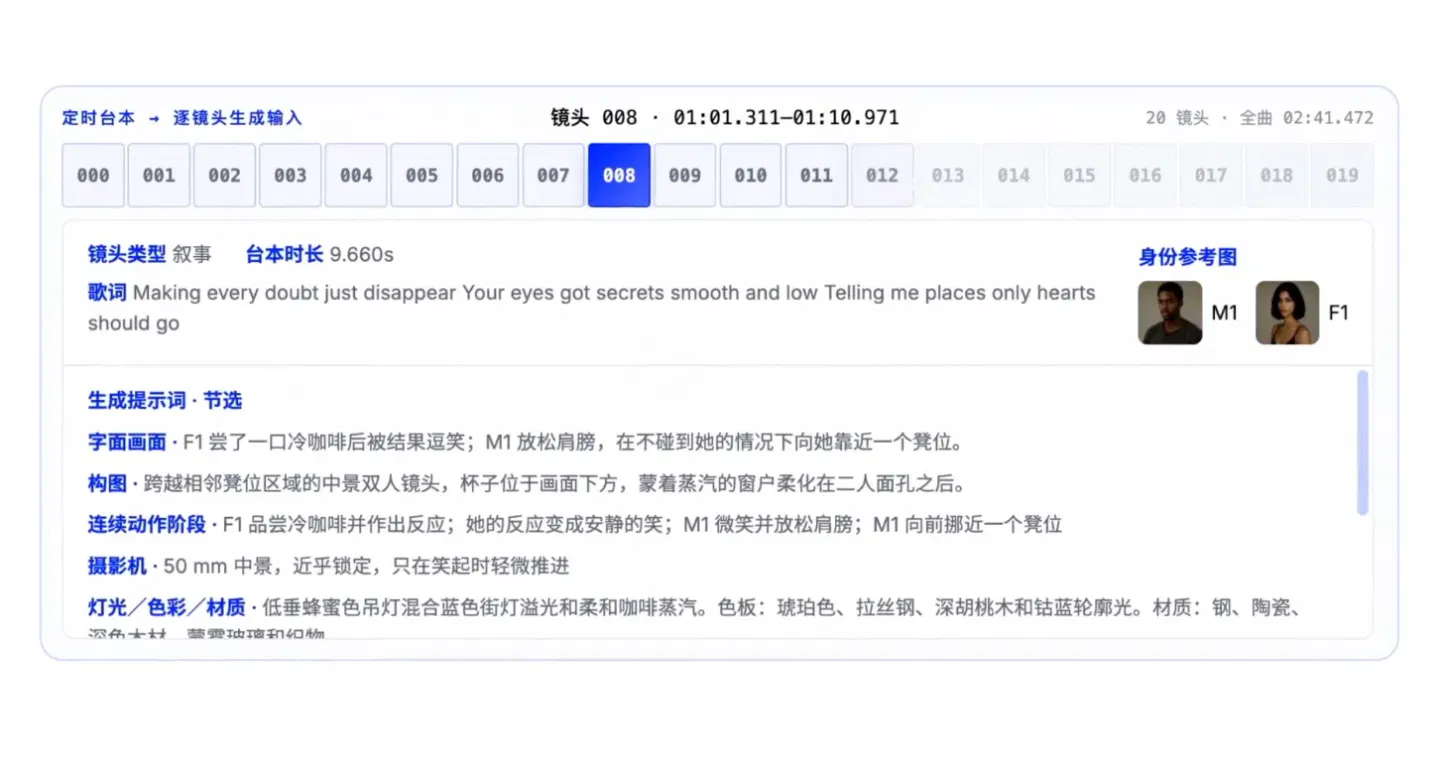
以音乐视频(MV)的创作为例,Qwen-3.8-Omni-Flash 能细粒度的精准理解用户输入的歌曲的结构、节奏、情绪、人声与乐器变化,为人物、场景和镜头的设计提供灵感。它还能输出带时间戳的句级歌词,让歌声、字幕与画面精准配合。结合 Qwen-MM-Plugins 等创作工具,模型可贯穿音乐理解、创意规划与成片质检,展现强大的音视频理解、推理和创作创作能力。
短剧翻译
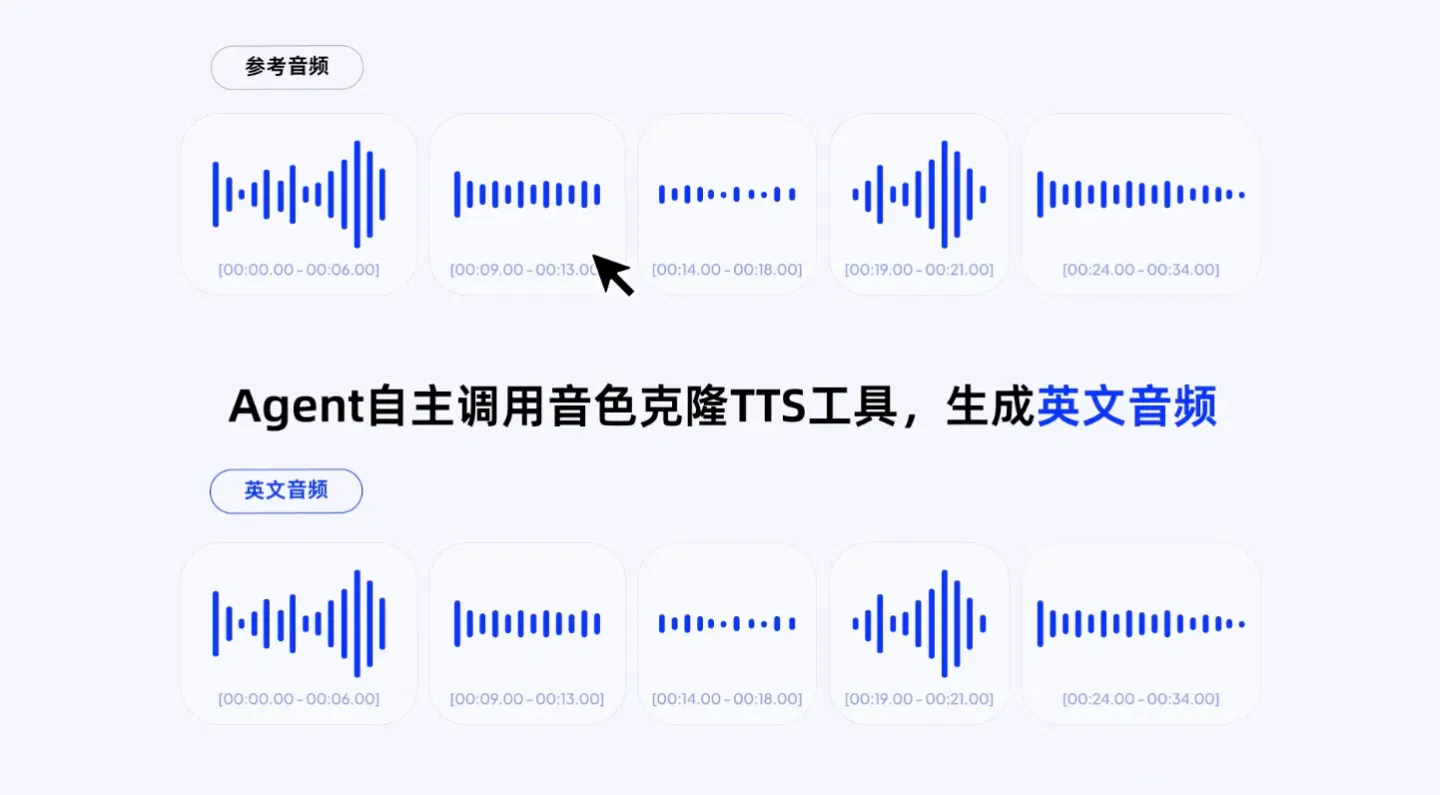
传统视频翻译往往需要在转写、翻译、配音和剪辑平台之间反复切换,不仅 API 调用与流程衔接复杂,也难以保证多角色音色、台词时长与画面节奏的一致性。借助 Qwen3.8-Omni-Flash 构建的 Agent,用户只需一句话描述需求,即可按需完成区分角色的台词识别、口语化翻译、角色克隆配音、音轨重混与成片质检,将原本割裂的译制环节串联为完整流程,实现短剧视频出海的自动化交付。
长电影解说
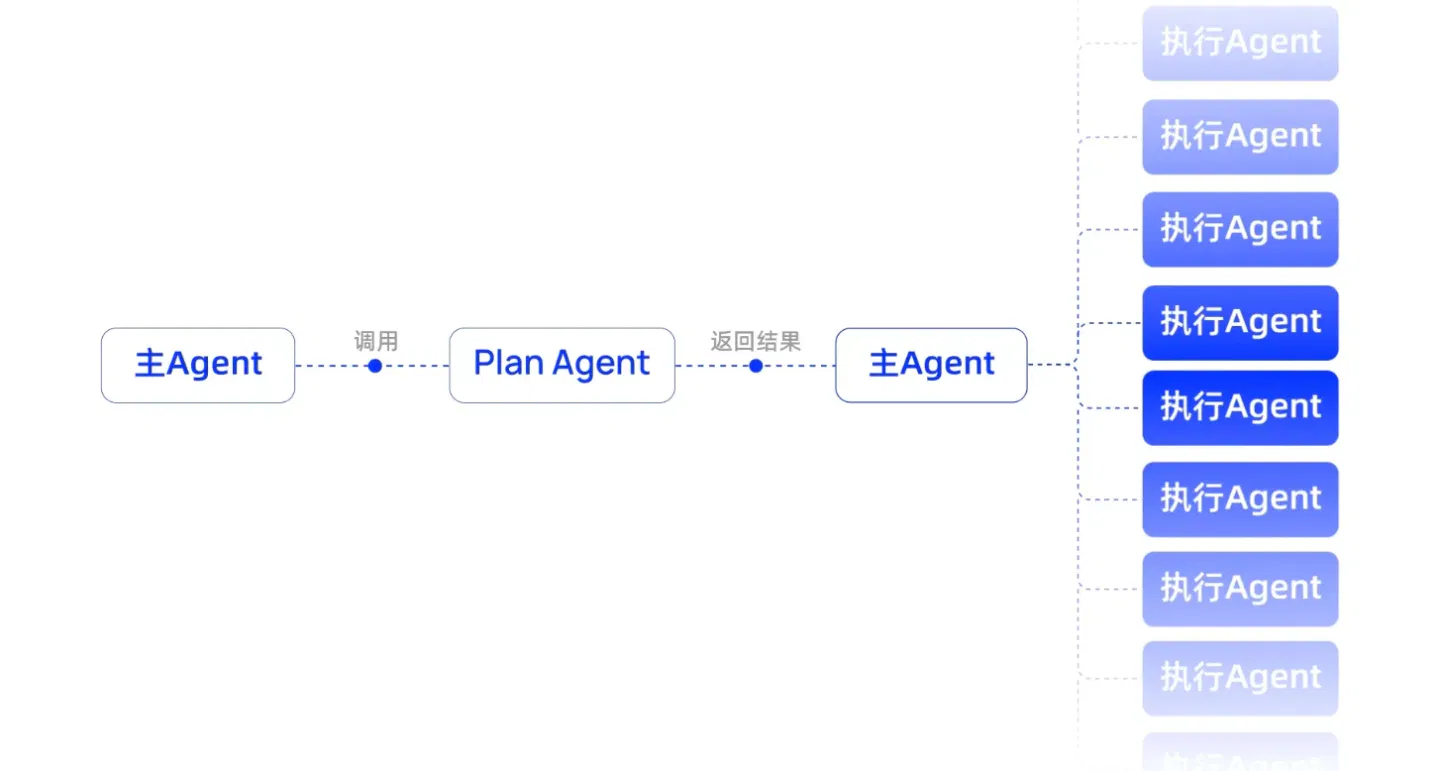
面对动辄两三小时的完整影片,电影解说视频的制作往往需要人工反复观看和梳理剧情,并完成镜头筛选、文案撰写、配音配乐与剪辑包装,制作流程繁琐、耗时耗力。基于 Qwen3.8-Omni-Flash 构建的 Agent,用户只需提供影片并用一句话描述创作需求,即可完成长视频全模态理解、关键情节提炼、解说规划、配音配乐、剪辑渲染与成片质检。Agent 还能智能穿插电影原声对白与解说配音,自动调节语速和音量,让解说、原声、背景音乐与画面自然衔接,打造更具真实感、代入感与“电影质感”的解说作品。
从使用模型,到优化模型
真实的多模态业务往往复杂且成本敏感,模型往往需要在效果、时延、算力与部署成本之间取得平衡。
因此,面向具体场景定制小模型,是规模化业务应用的重要路径。然而,传统流程涉及数据构建、问题诊断、多轮训练与效果评测,周期长且高度依赖人工经验。这一次,我们进一步尝试将 Qwen3.8-Omni-Flash 推进到模型研发本身,探索“大模型负责研发、小模型面向业务”的新范式。
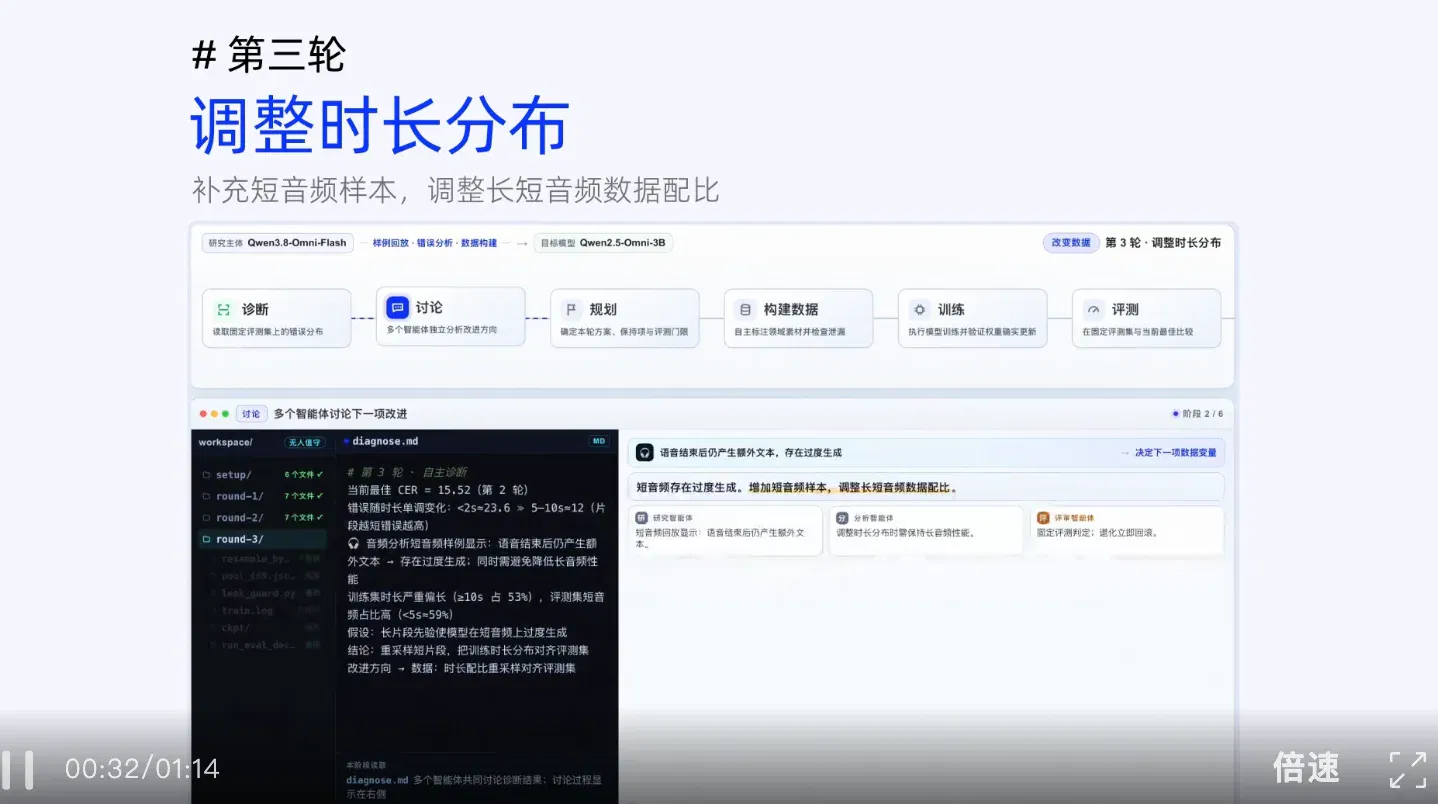
我们向 Qwen3.8-Omni-Flash 提出了一项任务:在 12 小时内提升 Qwen2.5-Omni-3B 的四川话识别能力,并交付可用模型。它自主选定 WenetSpeech-Chuan 评测集、固定评测标准并完成基线测试,随后直接听取语音样本,结合识别结果诊断问题,构建针对性的训练数据。在连续 4 轮实验中,Agent 累计构建了 3,413 条训练数据,并根据评测反馈调整方案、保留有效改进、回退无效尝试。最终,Qwen2.5-Omni-3B 在同一评测集上的字符错误率从 25.79% 降至 15.30%,相对下降约 40.7%。
这项实验展示了另一种模型演进的可能:通用多模态模型负责理解数据、规划实验与驱动迭代,小模型则沉淀面向具体业务的专用能力。Agent 不再只是调用模型,还能参与模型优化并解决实际业务问题。
音视频信息压缩
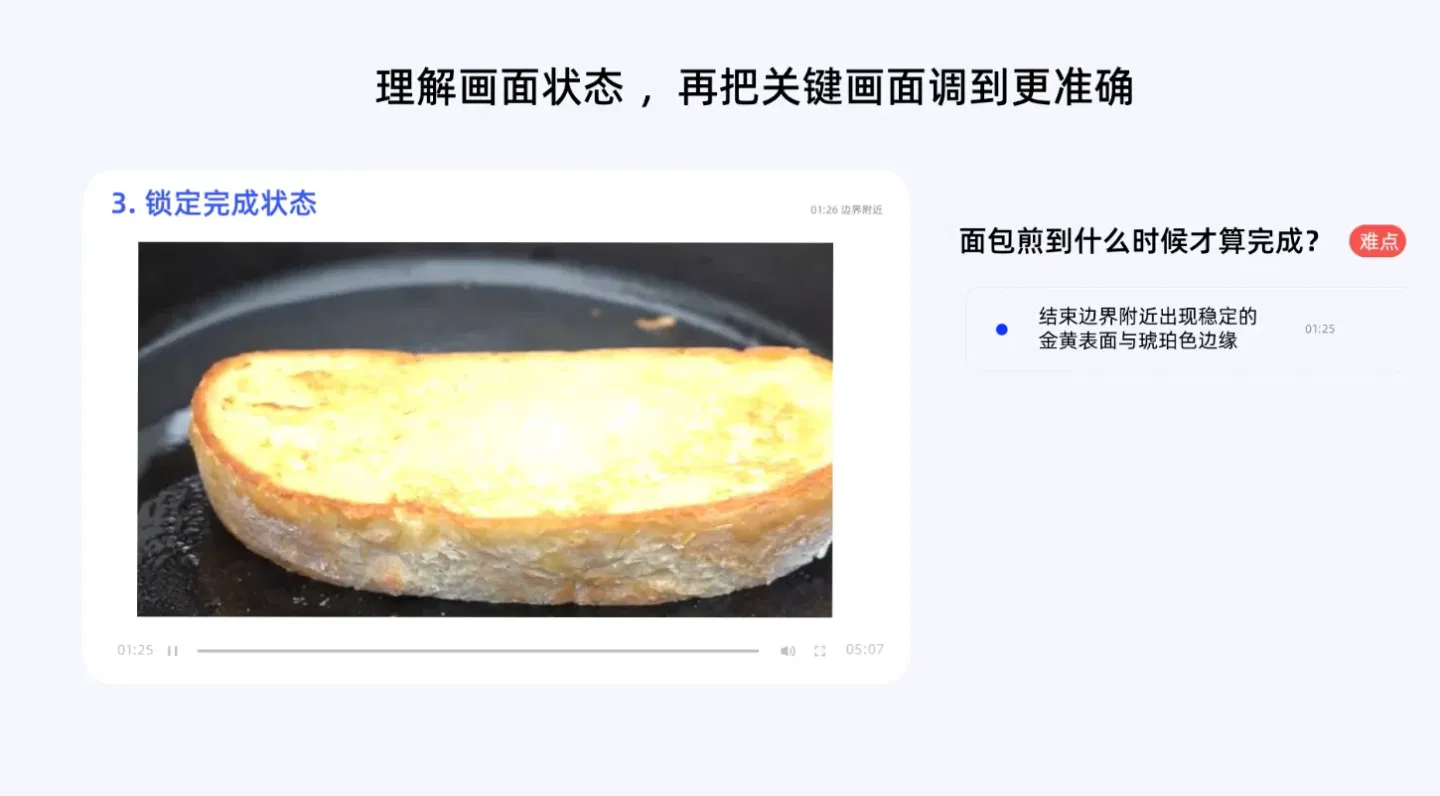
音视频承载着丰富的信息,但其线性、非结构化的形态也让检索和复用变得困难。Qwen-3.8-Omni-Flash 可以跨越声音、画面与时间线理解内容,并通过 Agentic 的方式完成信息提炼、结构重组与结果校验。将长视频中的核心知识与实践经验,转化为更高密度、更易消费、更可复用的信息内容资产。
Video2Note
围绕视频知识的结构化沉淀,我们在 Qwen-MM-Plugins 中开源了 Video2Note。依托 Qwen3.8-Omni-Flash 对语音、画面与操作过程的联合理解,它能够自动梳理知识结构、拆解关键步骤、筛选代表性画面,并生成图文对应的 PDF 笔记;同时通过自动审阅与迭代修正,将数小时的视频内容压缩为清晰、易读、便于复习的文档资产。
Omni Skill Creator
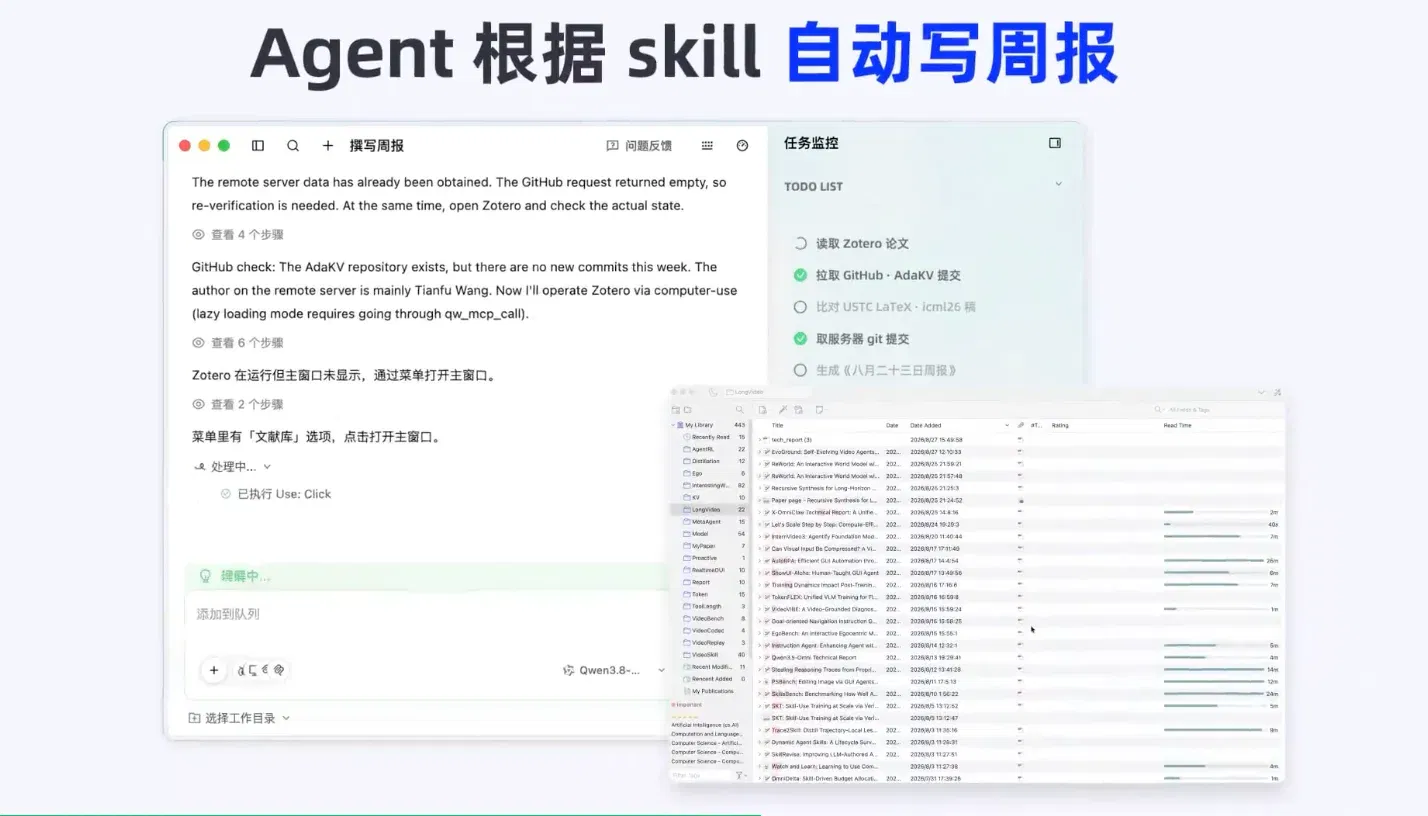
录一遍你的工作流程,Omni把它变成可复用的技能。我们将 Omni Skill Creator 作为 Qwen-MM-Plugins 的全新开源能力:它既可以从操作演示中提炼标准作业流程(SOP),并将其转化为可复用的自动化流程,也可以从专家教学中学习工具使用、决策依据与关键经验。一次演示教学即可转化为经过校验和评测的 Agent Skill,实现基于全模态内容构建可复用、可传播的 Agent Skill。
音视频实时交互
Qwen3.8-Omni-Flash 面向完整音视频的深度理解与创作;面向持续、低延迟的交互场景,我们进一步带来 Qwen3.8-Omni-Flash-Realtime。它能够在音视频流输入的同时完成感知与响应,并结合实时上下文调用工具、执行任务,让全模态能力从“理解一段内容”走向“参与一场交互”。
实时口语陪练
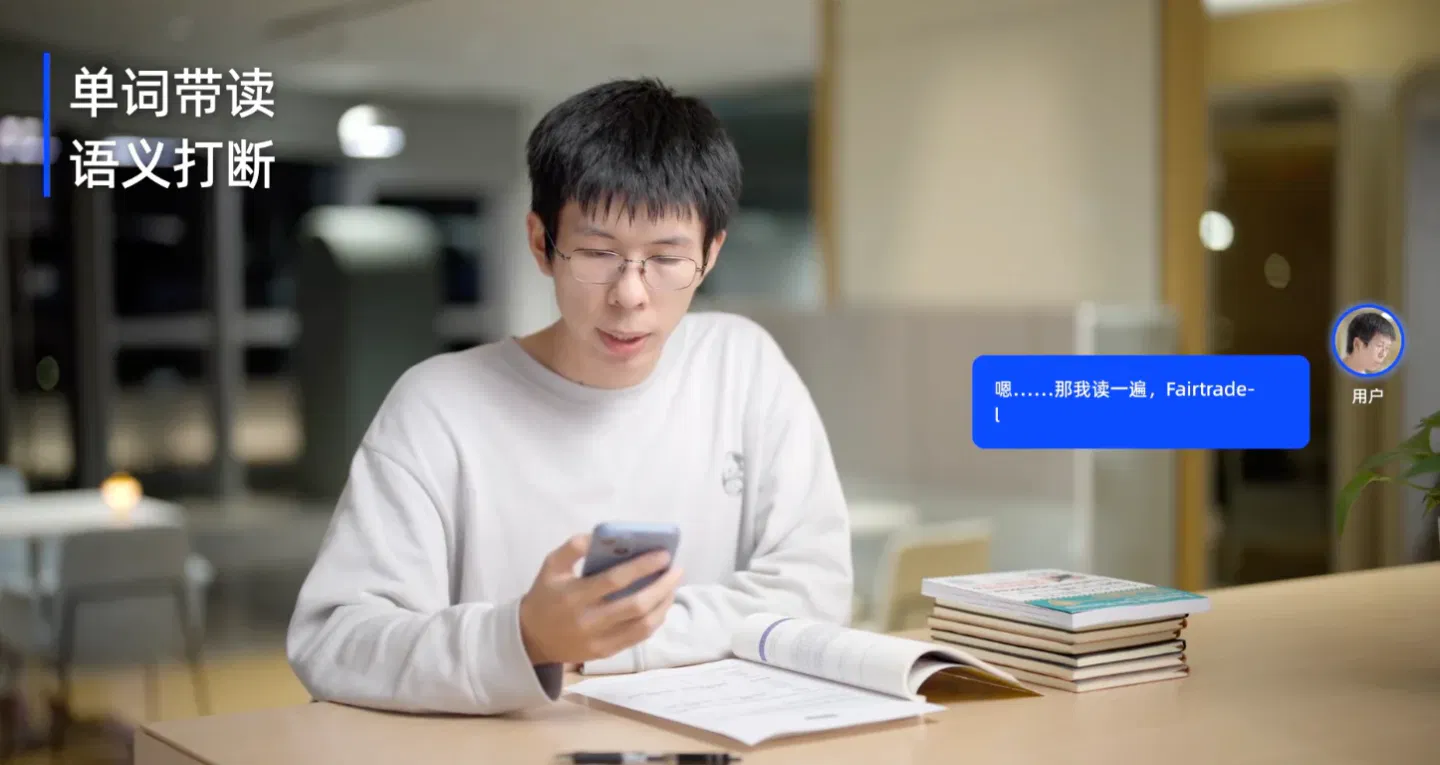
口语世界没有标准输入。口音、元辅音替换与声调偏差,都会让逐字转写偏离真实语义。Qwen3.8-Omni-Flash-Realtime 联合建模发音与语义,能够理解受口音影响的非标准表达,将其对齐到正确词汇,并实时生成标准发音示范。在多轮练习中,模型根据新的语音持续更新判断:纠正影响理解的错误,同时保留自然的节奏、语气与情感。
全模态空间音频感知
在真实空间中,声音是视觉之外的另一条坐标轴。Qwen3.8-Omni-Flash-Realtime 融合空间声音与视觉信息,持续判断声源方向和距离,并同步感知障碍、通行区域与场景变化,是首个支持“听声辨位”的全模态大模型。
面对“过来这里”或“去看看是什么在响”等指令,模型能够从环境噪声中锁定人声与目标声音,将语义落到现场空间,并调用工具完成定位、搜索、路径规划与导航。从听见目标,到抵达目标。
音视频外部知识接入
实时交互不仅需要低延迟,也需要随业务动态加载知识与行为。Qwen3.8-Omni-Flash-Realtime 支持通过 Skill 注入身份设定、表达风格、业务知识与交互规则,并通过工具调用将这些能力延伸到任务执行。
在智能客服等场景中,模型可以实时加载品牌话术与服务流程,理解用户的语音、画面与上下文,生成符合业务规范的回应并执行操作。同一个实时模型,由此可以拥有不同的知识、角色与行动方式。
完整性能结果
Omni
Agentic Omni Understanding
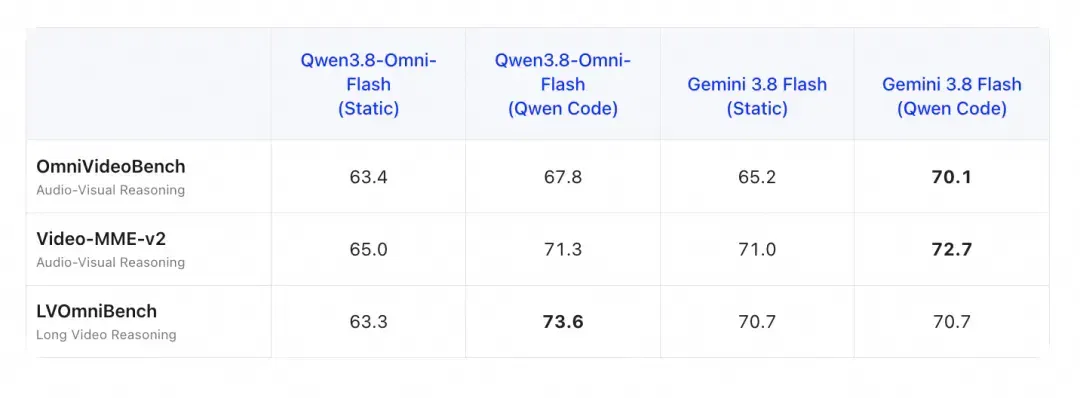
长音视频中的关键信息往往分散在不同时间片段,复杂问题还需要结合声音与画面进行多步推理。Agentic Omni Understanding 让模型从问题出发,主动规划、调用工具并逐步定位和核对证据,将计算资源集中在与问题相关的内容上,提升长音视频理解的准确性与效率。
为评估这一能力,我们在 OmniVideoBench、Video-MME-v2 和 LVOmniBench 上,分别对比 Qwen3.8-Omni-Flash 与 Gemini 3.8 Flash 在两种设置下的表现:直接理解输入内容的 Static 模式,以及接入 Qwen Code 的 Agent 模式,以观察引入 Agent 工作流后两款模型的表现变化。
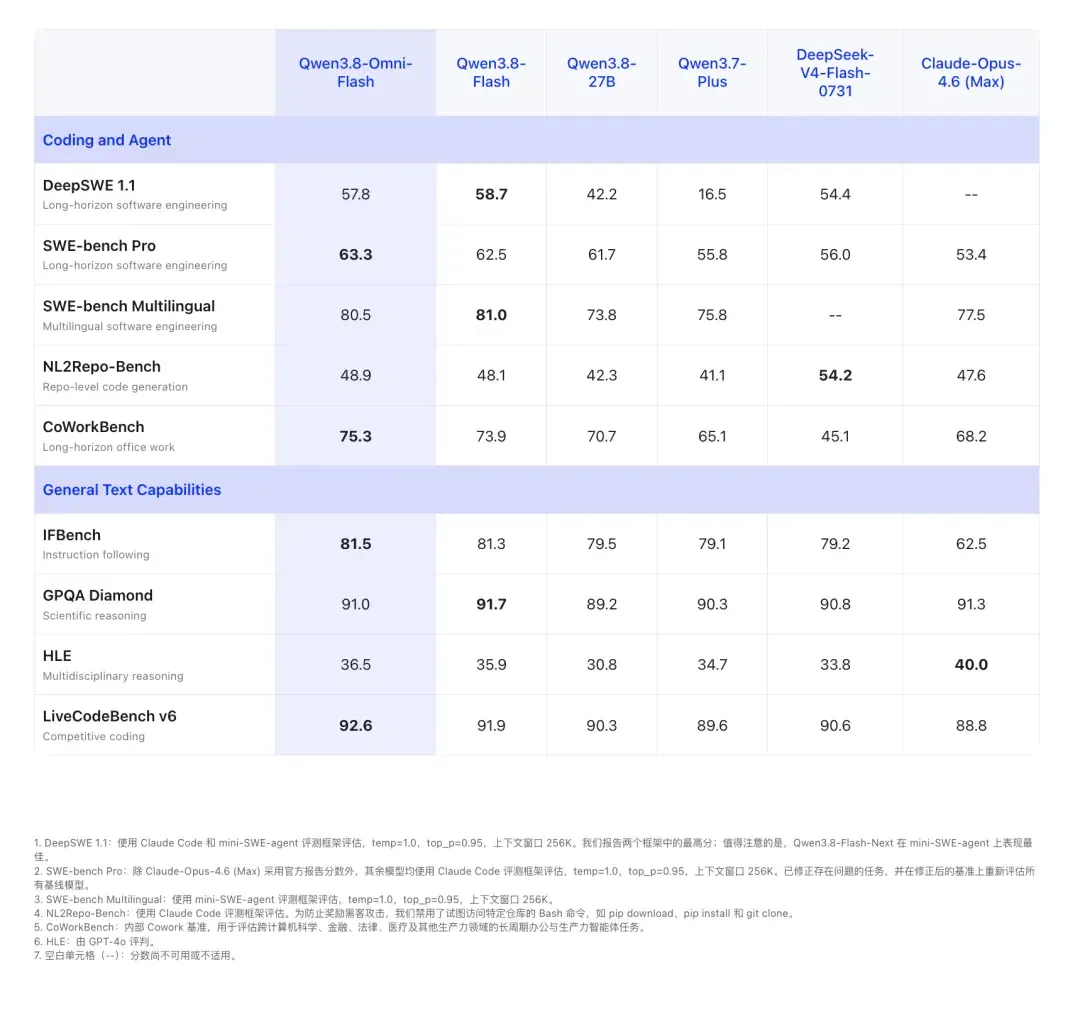
Text
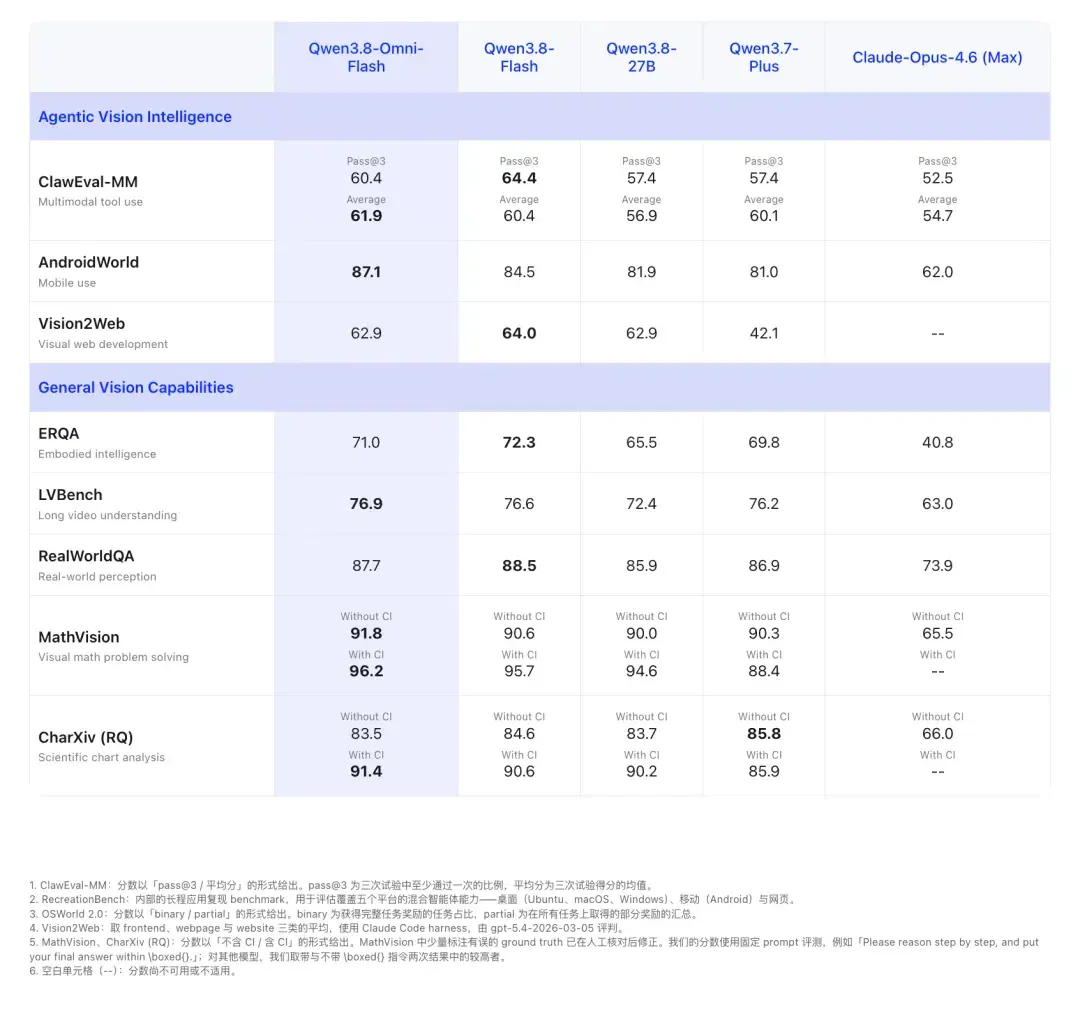
Vision
Throughput&Latency
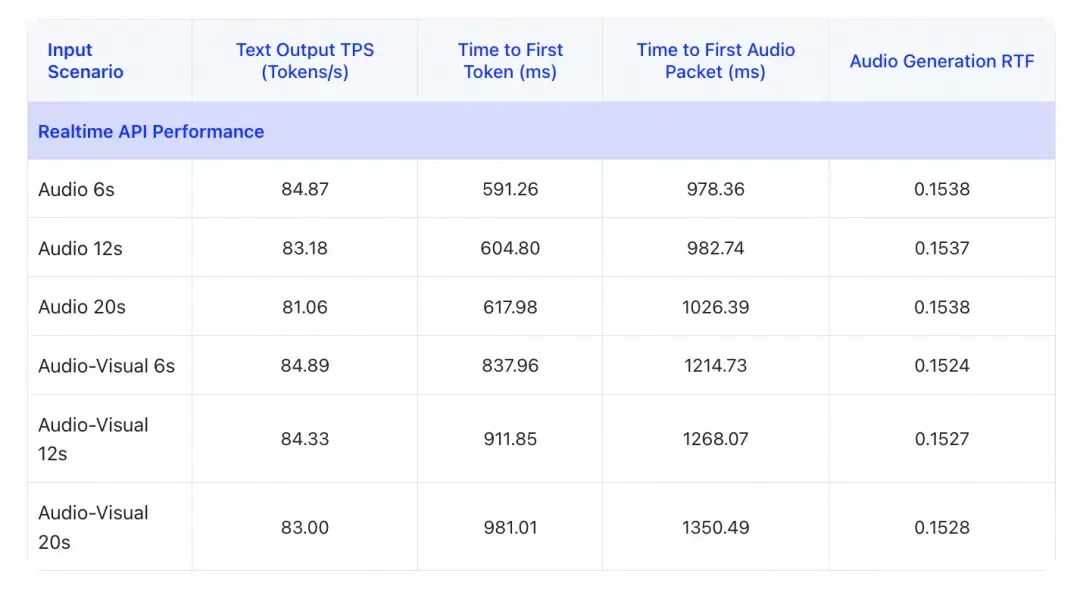
以下为 Qwen3.8-Omni-Flash-Realtime API 在不同输入场景下的实际吞吐与延迟性能信息,为实际生产环境中能够感知与体验到的延迟与吞吐能力。
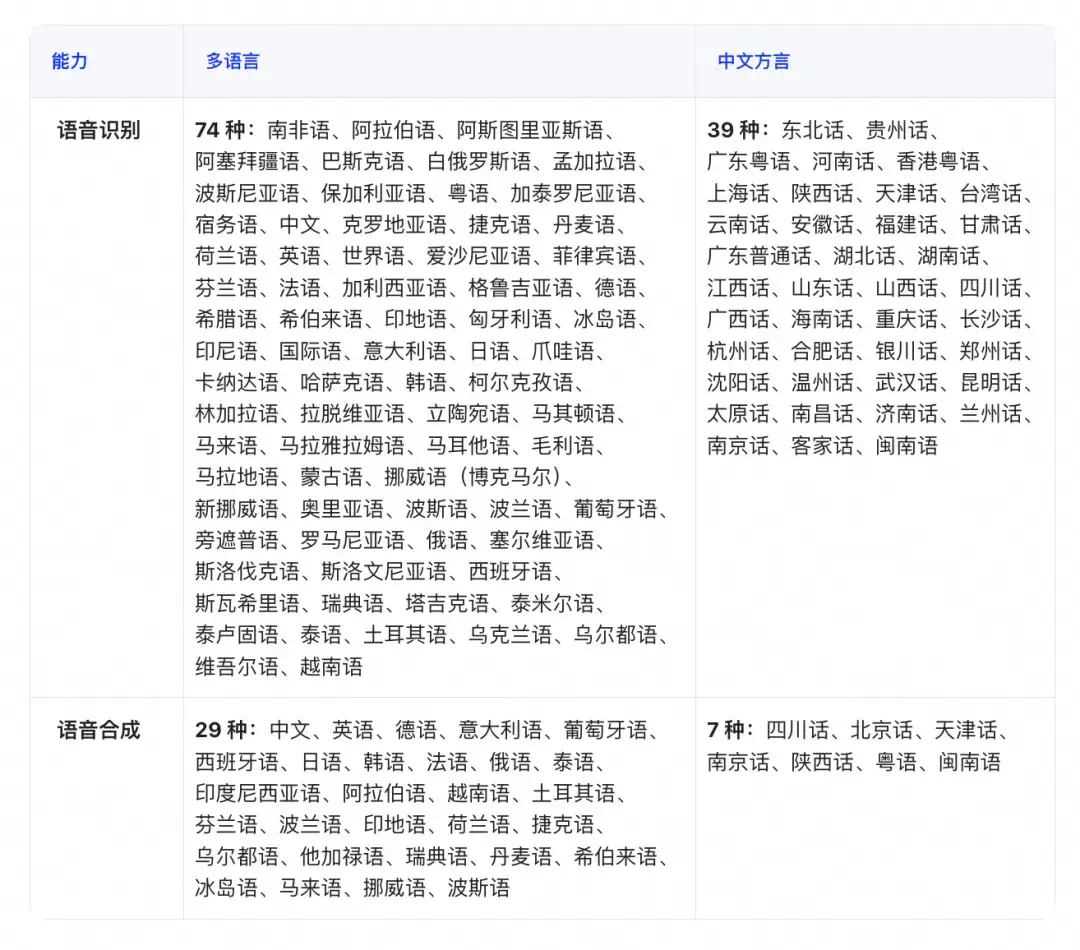
支持的语种
文章来自于微信公众号 “阿里研究院”,作者 “阿里研究院”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
实测Qwen3.8-Omni-Flash:全模态Agent有了“白菜价” (opens in a new tab)
千问把全模态Agent的使用成本,直接砍掉了90%!
APPSO tests Qwen4-Max on 3D disassembly visualizations and cross-software creation (opens in a new tab)
APPSO uses Qwen4-Max for interactive iPhone and car disassembly demos, plus OpenSCAD, ngspice and Blender workflows, while discussing task costs. These are generated visualizations and author experiences, not physical hardware teardown validation.
Alibaba releases Qwen4-Max, expanding multimodal and industry-agent workflows (opens in a new tab)
The report covers Qwen4-Max's architecture, million-token context and long-horizon delivery examples. Work360 and AII show different cost reductions; complex open-ended tasks remain a weakness, while smaller models are planned for later open release.
Alibaba plans Hong Kong spin-off of T-Head; standalone financials and valuation await disclosure (opens in a new tab)
Alibaba says T-Head has filed a confidential listing application and plans a spin-off through a global H-share offering. ChinaVenture reviews its chip business and commercialization; the valuations cited are market estimates.
千问 Qwen4-Max 预览版体验,动画与交互表现怎样 (opens in a new tab)
智东西用动画、交互场景和 GIF 任务体验 Qwen4-Max 预览版,记录了生成耗时、控制细节与字幕错位等问题。