刚刚,全新国产LPU推理芯片首秀!
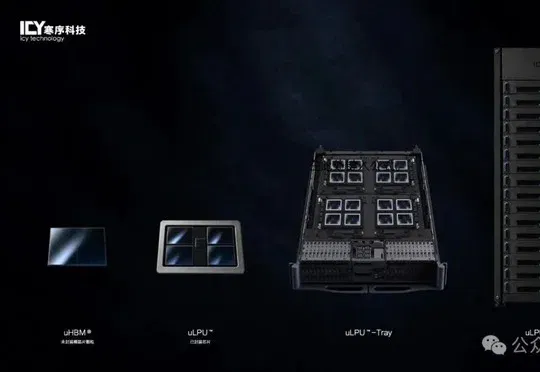
寒序科技正式公布uHBM®与uLPU™推理计算架构,首次完整亮相其基于Persistent MRAM的权重驻留片内计算方案。
一颗权重,只有4 bit。
搬十亿次,让你和AI有了距离。
寒序科技决定,不搬了!
今天,寒序科技正式公布uHBM®与uLPU™推理计算架构。
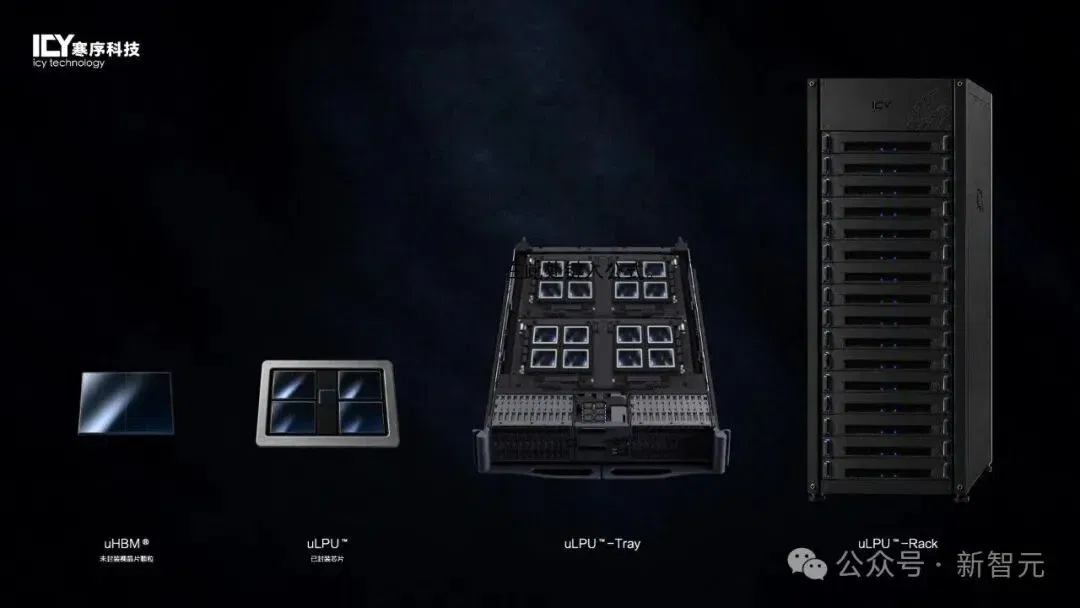
寒序uHBM®与uLPU™产品路线图
如果最重要的数据,根本不用搬呢?
这件事在大模型Decode阶段尤其突出。
一次Token的生成,需要反复读取巨量模型权重;对于FFN/GEMV这类典型memory-bound workload,很多时候真正限制推理速度的,并不是乘法器不够多,而是权重必须一次又一次穿过存储接口,抵达计算单元。
一颗FP4权重只有4 bit。
一次搬运,几乎微不足道。
但是当几十亿颗权重,为每一个Token,一遍又一遍地移动时,它最终变成带宽、功耗、延迟和散热,最后变成一整排服务器、一整座机房,以及一张越来越大的电费账单。
这就是寒序做uHBM®的起点。
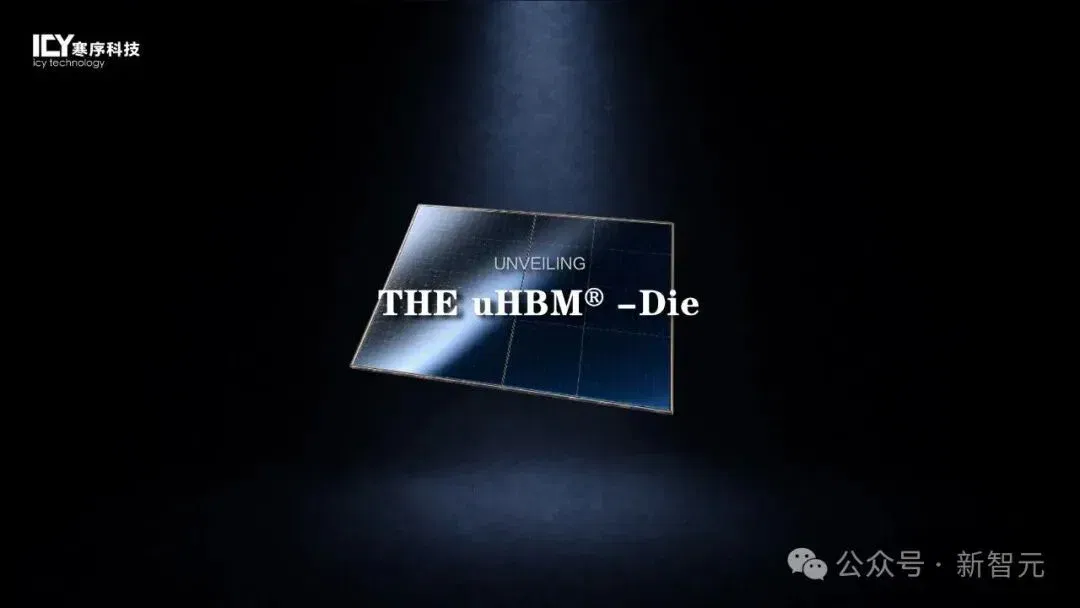
uHBM®未封装裸晶片颗粒
他们不想继续搬得更快。他们想让权重住在计算发生的地方。
uHBM®将Persistent MRAM与矩阵向量计算集成在同一颗Compute-Memory Die内。
权重长期驻留,矩阵向量计算在Die内完成,大规模权重不再为了每个Token反复跨越传统存储接口。
作为国内首家MRAM计算公司,寒序三年来持续推进超大带宽、Persistent MRAM、权重驻留和片内矩阵向量计算。
三年磨一剑。uHBM®与uLPU™今天首次完整亮相。
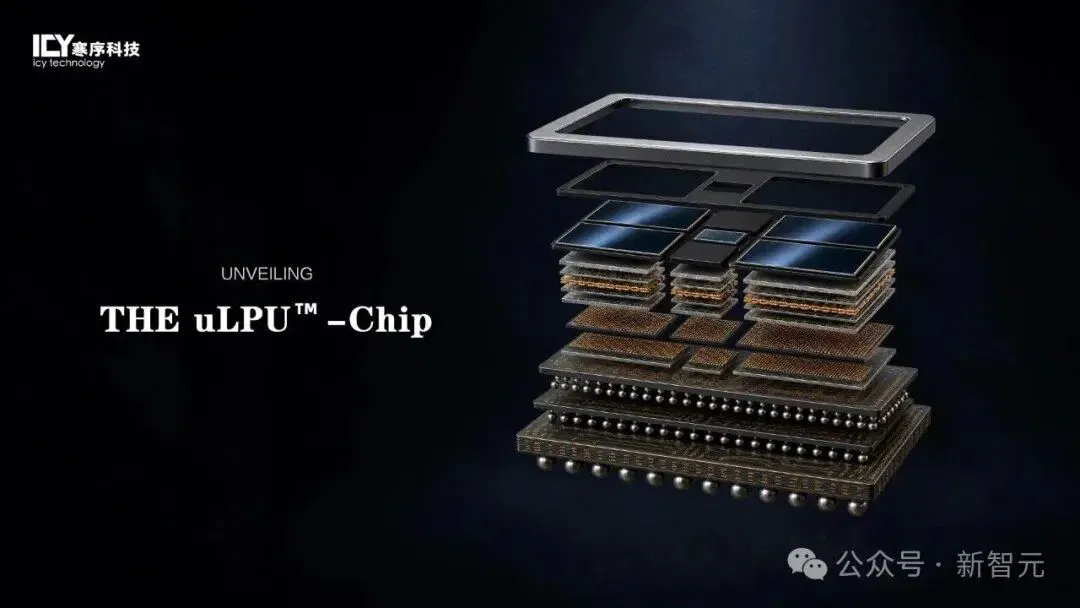
uLPU™-Chip爆炸结构图
Decode的代价,藏在权重搬运里
Prefill更像一次集中计算。Decode则不同:模型每生成一个Token,都要重新读取大批权重。
对于FFN/GEMV,一轮计算只输入一个激活向量,却要让整层权重再次上路。模型越大,搬运越接近推理成本的中心。
Hot Chips 2026上,三星公布LPDDR5X-PIM,把计算进一步推入DRAM。
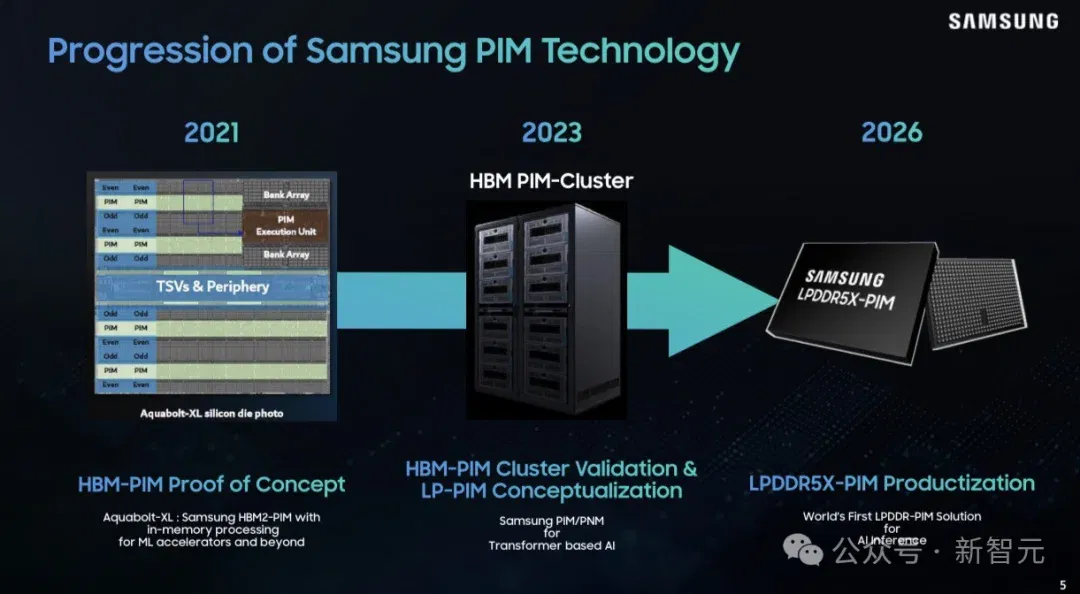
三星PIM技术演进路线:从2021年HBM-PIM验证,到2026年LPDDR5X-PIM量产
NVIDIA则展示Groq 3 LPX与Vera Rubin的异构推理路径:GPU处理Attention、承载KV Cache,LPX将权重保留在片上SRAM中并执行FFN。
三星走DRAM-PIM,Groq走SRAM LPU,寒序选择Persistent MRAM。器件、工艺和系统形态完全不同,但三条路线都在追问同一件事:为什么每生成一个Token,权重都要重新搬一次?
过去十年,行业从DDR走到HBM3E,从PCIe走到NVLink,答案一直是把存储与计算之间的路修得更宽。寒序换了一个问法:如果权重根本不用反复上路呢?
问题最终可以压缩成一张图:传统GPU+HBM3E在每个Token的生成过程中,需要逐层经片外接口读取权重矩阵;uHBM®将权重留在片内,系统主要交换激活向量。
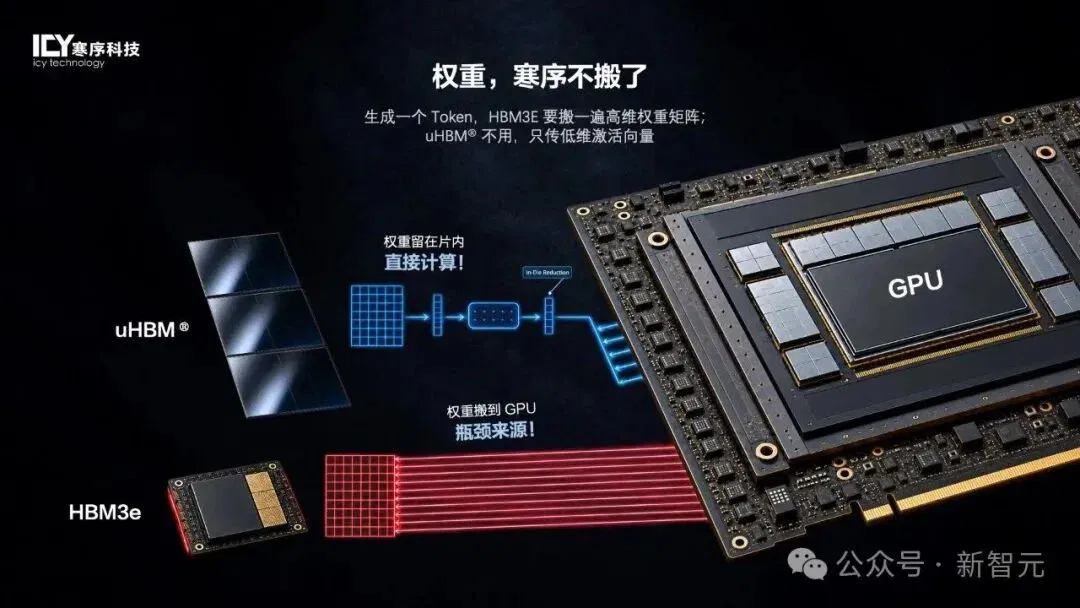
典型Decode数据路径
u,是Ultra的意思
uHBM®给出的答案,不是再造一条更宽的外部接口。
它在同一颗Compute-Memory Die内集成Persistent MRAM与矩阵向量计算:模型权重完成加载后长期驻留;每轮Decode只让激活向量流入,在Die内完成权重读取、矩阵向量乘和局部归约,再将结果输出。
权重留下,计算在旁边完成。这就是Weight-Resident Compute。
uHBM®名字里的u,取自Ultra。它不只意味着Ultra-High Bandwidth,更意味着高带宽发生位置的变化:从存储器与计算芯片之间,进一步进入权重所在的Die内。
uHBM®是寒序对Compute-Memory产品架构的命名,不对应JEDEC HBM的新一代DRAM标准。
它延续HBM以高带宽服务计算的产品逻辑,底层技术路径则转向MRAM计算存储。寒序把这项产品主张概括为一句话:
重新发明HBM。
24 TB/s,比数字更重要的是它发生在哪里
首代uHBM®架构给出的In-Die Read Bandwidth设计值是24 TB/s。
它描述的是Compute-Memory Die内部的权重读取能力;行业常见HBM指标描述的,则是存储Stack与GPU之间的外部接口带宽。
一个数字发生在路上,一个数字发生在权重所在的地方。
两者不是同一测试口径,不能直接写成性能倍数;24 TB/s真正重要的,是高带宽读取紧邻驻留权重,并可直接送入片内GEMV。这是架构设计值,仍待后续硅片实测。
HBM把路修宽,uHBM®让权重不上路。
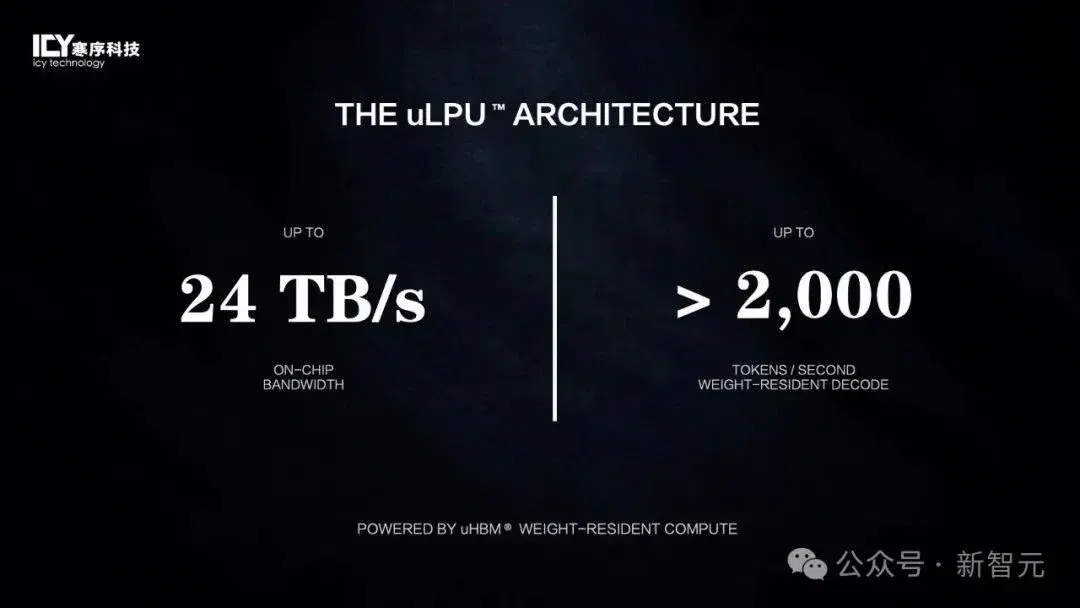
uLPU™架构核心指标
当权重驻留与片内计算合为一体,uHBM®不再只是一颗「存储芯片」。再向前一步,它成为uLPU™。
从一颗Die,走向一座Rack
如果说uHBM®回答了权重应该住在哪里,uLPU™回答的,就是它如何成为一台完整的推理计算机。
一颗Die只是起点,寒序的产品路线由此展开:
uHBM®→ uLPU™ → uLPU™-Tray → uLPU™-Rack
按当前规划,端侧形态uLPU™ Edge将四颗uHBM®与NPU集成。NPU负责Prefill、Attention、KV Cache、动态算子和系统控制;高带宽敏感的FFN/GEMV留在uHBM®内执行。
它不是用存内计算替代一切,而是把最需要带宽的部分放回权重身边。
云端形态uLPU™ Cloud将四颗uHBM®与uIO Die组合,通过UCIe完成Scale-Up,并面向112G / 224G SerDes构建Scale-Out互联。
按照当前规划,16个uLPU™进入一个2U Tray,多个Tray继续组成Rack-Scale Inference System。
同一条Weight-Resident Compute路线,由此从机器人端侧一路延伸到云端整座机柜。
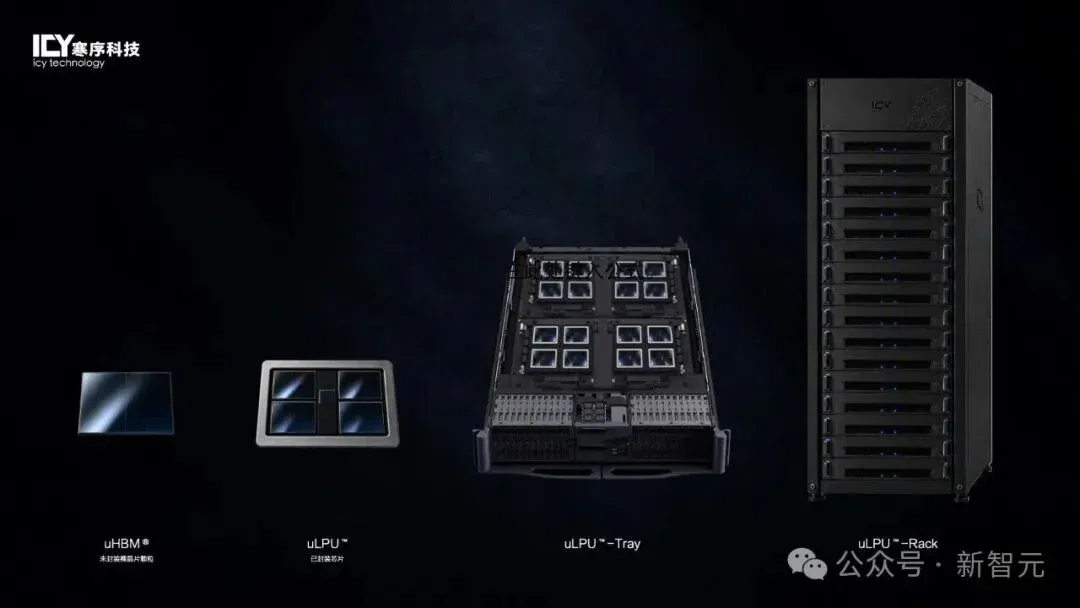
从uHBM®、uLPU™到2U Tray与Rack的产品路线
机器人不会等下一个Token
对于Qwen-VLA这一类具身模型,寒序正在瞄准另一个方向的数字:
>2,000 Tokens/s。
Qwen-VLA建立在Qwen3.5-4B多模态骨干之上,并增加约1.15B参数的DiT动作解码器。
作为量级参照,NVIDIA公布的Jetson AGX Thor单并发测试中,Qwen2.5-VL 3B为71.7 Tokens/s。
两者并非同模型、同精度测试;>2,000 Tokens/s是寒序面向4B多模态主干Decode提出的工程目标,不等同于完整Qwen-VLA动作解码或机器人控制频率。
寒序的目标,是把「机器人能够实时思考」从几十Tokens/s,推到一个新的数量级。
对于聊天机器人,100 Tokens/s和1,000 Tokens/s可能只是「快一点」和「再快一点」。但对于一个正在伸手抓杯子、避开障碍物、观察人类动作并实时调整轨迹的机器人,延迟不是体验问题。
延迟就是动作本身。当推理进入Physical AI,AI不再拥有无限的时间等待下一个Token。世界不会暂停,机械臂不会暂停,人也不会暂停。
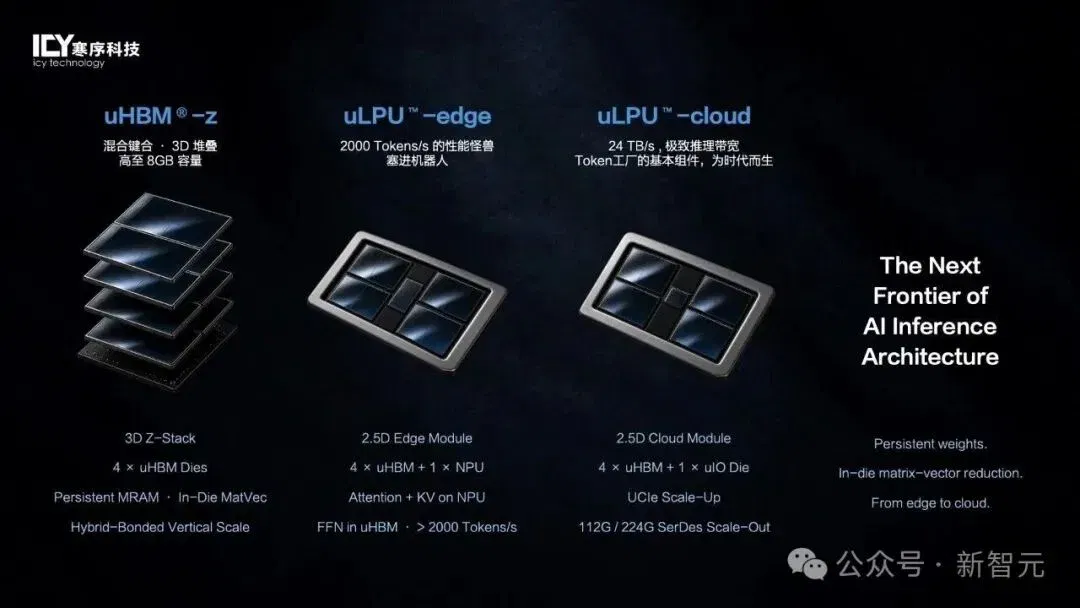
寒序端侧机器人、云端数据中心两类uLPU产品,以及3D堆叠uHBM产品
三年磨一剑
寒序成立于2023年8月。2024年初,北京市科委项目立项。
团队最初全面对标Groq LPU的超大带宽路线,却没有选择用更大面积的SRAM堆出带宽,而是押注Persistent MRAM、权重驻留和片内矩阵向量计算。
高带宽推理验证芯片SpinPU-ED01此后完成流片、回片和第三方检测。
样片集成120个MRAM Bank,实测片上访存带宽密度达到0.105 TB/(mm²·s);公司同时完成端到端模型推理与连续24小时稳定运行。
2026年3月,寒序提交两项高带宽推理发明专利申请,并于6月陆续公开。相关方案从MRAM权重静态驻留、多Bank并行计算,延伸到Transformer Decode的系统分工和多芯片扩展。
先发优势不是一句标签,而是一条连续路径:从MRAM Bank到验证芯片,从已经公开的专利申请到uHBM®与uLPU™,再从端侧产品走向Tray和Rack。
作为国内首家MRAM计算公司,寒序已经率先把磁计算从器件推到了完整产品路线。
未来两年,走向工程实现与量产
首代完整工程产品目前处于流片前收敛阶段。架构已经亮相;工艺、容量、功耗、完整带宽和模型性能,最终要由硅片回答。
未来两年,寒序将把重心放在工程实现与量产:流片、回片、软件栈、系统研发、客户验证和量产准备。
验证芯片已经回答「这条路能不能走」;下一阶段要回答的,是它能不能成为真正的产品。具体节奏仍以硅片进展和客户验证为准。
从架构到产品,中间隔着最难的工程实现:先进封装、计算模块、供电、散热、系统集成、软件栈,以及真实客户负载。
完整参数,等硅片。
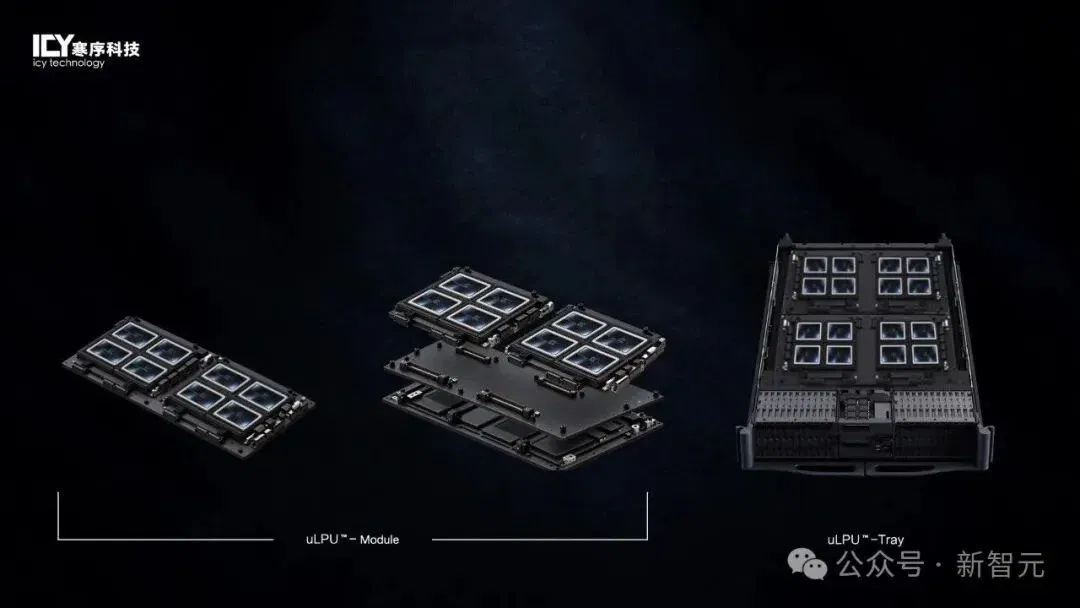
从uLPU™-Module到uLPU™-Tray
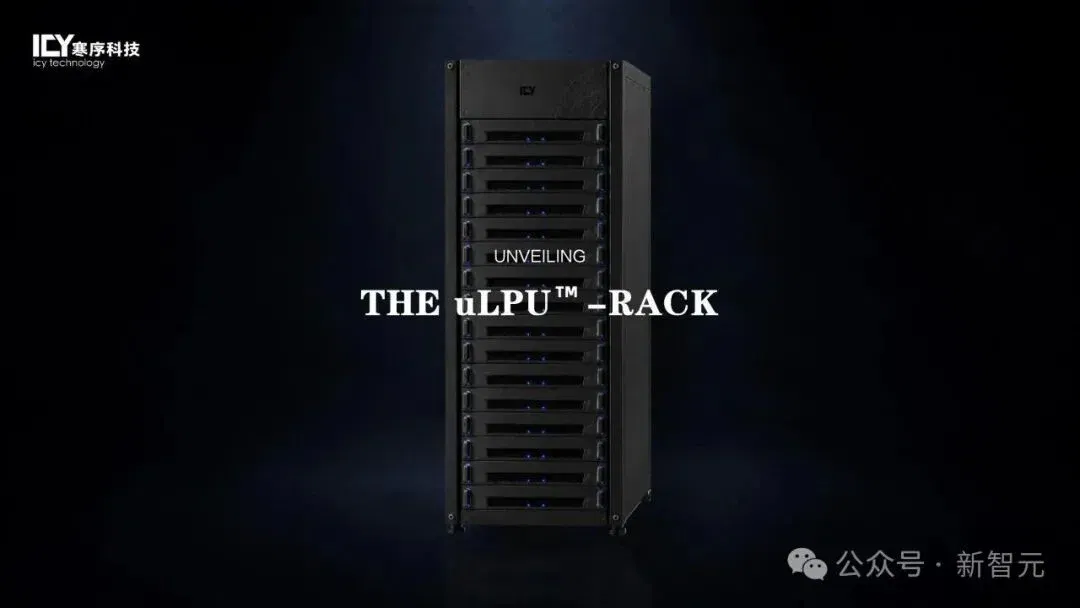
uLPU™-Rack
寒序启动全球核心研发人才招募
围绕uHBM®与uLPU™,寒序同步启动新一轮全球核心研发人才招募。
重点方向包括:
- SoC架构、数字设计、PPA优化与物理实现
- AI编译器、Runtime、算子优化与多芯片任务调度
- UCIe、SerDes、Scale-Up与Scale-Out互联
- 先进封装、芯片供电、信号完整性与热设计
- 服务器、2U Tray与Rack级系统研发
寒序也欢迎来自GPU、NPU、交换芯片、高性能计算、通信、航空航天和复杂电子系统领域的工程人员加入。
团队支持北京、上海、深圳、横琴多地协同。
Hot Chips 2026已经把权重搬运推到产业前台。
三星和NVIDIA,已经完成了第一轮市场教育。
寒序接下来把时间留给流片、回片、编译器和系统。
让权重留下。
让计算来到它身边。
重新发明HBM,从一颗4 bit权重开始。
三年前,寒序问:一颗只有4 bit的权重,为什么要反复搬?
一颗权重,只有4 bit。
它不应该重到,需要一座数据中心来搬。
文章来自于微信公众号 “新智元”,作者 “新智元”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Tongxin Intelligence raises seed and angel funding for AGI inference-chip design (opens in a new tab)
The BIGAI-incubated team outlines Vector, Tensor and AGI Core units, planning FPGA validation before further design, tapeout and production. The proposed architecture's commercial efficiency remains to be demonstrated.
Google expands TPU system sales as software adaptation and inference economics draw attention (opens in a new tab)
QbitAI discusses complete-system deliveries, TorchTPU and agent-inference tests using filings and sources. Revenue, unfulfilled contracts and model-specific token-per-dollar comparisons are distinct measures; optimization rounds can change results.
Google adds TPU 8tx and 8i Max for confidential computing and long-context tasks (opens in a new tab)
Google describes new eighth-generation TPU variants expected in 2027. The report covers customer needs, supply constraints and external sales; its 2028 revenue figures are institutional forecasts.
从芯片互连到测控,正元量子推进千比特超导整机研发 (opens in a new tab)
正元量子宣布近亿元天使轮融资,计划推进三维封装、低温互连及集成测控。文章解释物理比特规模扩大时,连接和纠错所面临的工程问题。
墨芯人工智能完成近 10 亿元 C+ 轮融资,推进稀疏推理芯片 (opens in a new tab)
墨芯披露 C+ 轮融资,距上一轮约五个月。报道介绍其权重与激活稀疏技术、遥感适配和部署项目,性能数字来自所述模型与测试条件。