Anthropic 重磅发布:AI Native 软件开发方法论
Anthropic 最近发布了一篇博客文章《The AI Native SDLC playbook》,讨论AI进入软件开发之后,整个软件开发生命周期(Software Development Life Cycle,简称 SDLC)应该怎么重做。
Anthropic 最近发布了一篇博客文章《The AI Native SDLC playbook》,讨论AI进入软件开发之后,整个软件开发生命周期(Software Development Life Cycle,简称 SDLC)应该怎么重做。
文章出自 Anthropic 应用 AI 团队,这个团队常年给企业客户做 AI 落地咨询,内容面向工程负责人、技术负责人、平台团队、产品负责人,以及需要在安全和合规约束下交付软件的组织。
这里的组织不一定是超大型公司,但至少有多人协作、持续交付、代码评审和权限管理这些现实问题。个人开发者也能从中拿走一些经验做法(比如 plan mode、CLAUDE.md)。
下面是夕小瑶编辑部对博客的整理和解读。
◈Anthropic 看到了什么卡点
过去两年,几乎所有团队都用上了 AI 编程工具,代码生成已经快到一个新阶段,但是围绕着「写代码」展开的上下游的协同,比如评审、测试、发布、维护等流程却还停留在人工作业的速度里。代码写得越快,旧流程卡得越明显。
传统软件开发分六个阶段,规划(plan)、设计(design)、构建(build)、测试(test)、部署(deploy)、维护(maintain)。
过去做软件,最耗时间的往往是写代码(build),因为开发要持续几周甚至几个月。
于是基于这个假设,开发人员设计了一整套流程,PRD、评审会、代码审核code review...现在这个假设不成立了,写代码变成最快了。
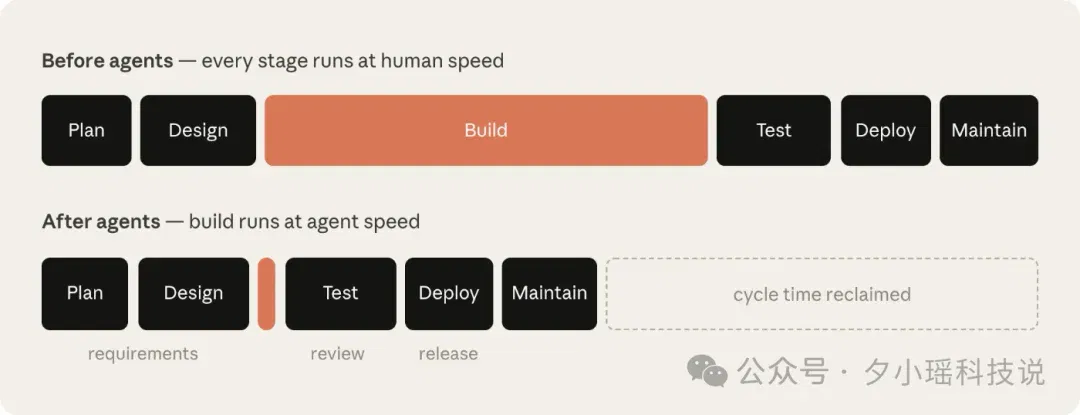
但是组织的流程和治理机制没跟上,于是出现两种失败模式:要么code review代码审查一直堆积,要么代码带着风险直接上线。
所以,怎么把AI不只嵌入「写代码」这一步,而是嵌入「整个软件开发生命周期」的每一环,同时把一轮轮的开会、返工变成随代码一起被版本化、可审计的机制。
所以,便有了AI Native 新的软件开发方法论。
◈AI Native 的核心改动
这篇博客里Anthropic 提出的方案是,把单向的开发流水线改成一个循环(Loop)。
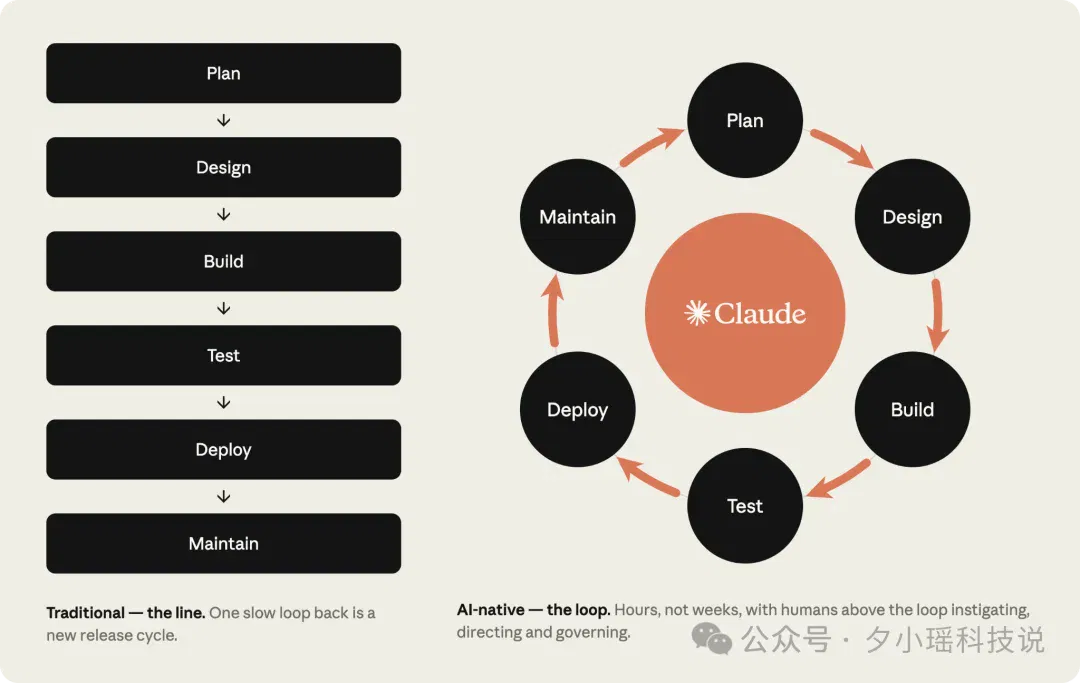
每个阶段提交一份版本控制的产物,下一阶段读直接自动读取,减少人工交接。
规划(plan阶段)产出意图文档(intent.md);
设计(design阶段)设计产出规格文档(spec.md);
构建(build阶段)产出实现计划(plan.md)连同代码和测试;
部署(deploy阶段)产出带审查记录的 Pull Request(简称 PR);
维护(maintain阶段)产出事故记录,并可能生成新的意图文档(intent.md),重新循环;
这样一个Loop就产生了。
这一串文件同时给人读,也给 AI 接着执行。版本会记录谁提了需求,AI 产出了什么;谁批准了什么。
整条链路就是一条清晰、可被追溯的执行轨迹。交接也从口头转述、工单、审批变成了明确读取同一组成果。
当然,人类仍然对需要判断力的决策负责,从事事亲力亲为,挪到了在关键节点审核 AI 已完成的产出。
◈六个阶段怎么走
有了Loop循环后,六个阶段的分工也被重新安排了。
先说第一阶段 Plan(规划):让 AI 先把问题问清楚
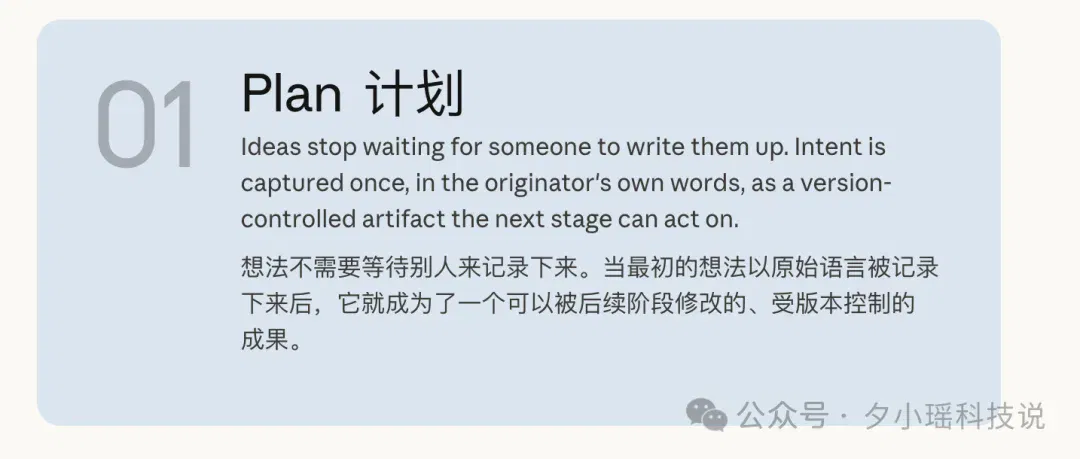
规划开始,让提出者直接和 AI 对话讲清问题,和 AI 讨论问题、用户、约束和成功标准,AI 像分析师一样追问,确认后提交intent.md,写清要解决什么、给谁解决、哪些不做。
第二阶段 Design(设计):让 AI 把需求变成方案
第一步的需求成立,不代表已经能动工。
举个例子,保险理赔场景,理赔查询要展示哪些字段,从哪个系统取数据,接口超时怎么办,第三方理赔人员能不能看,都要在 Design 阶段确定。
AI 先读取intent.md,再读取企业已经写好的品牌、安全、合规和用户体验 Skills,生成spec.md。
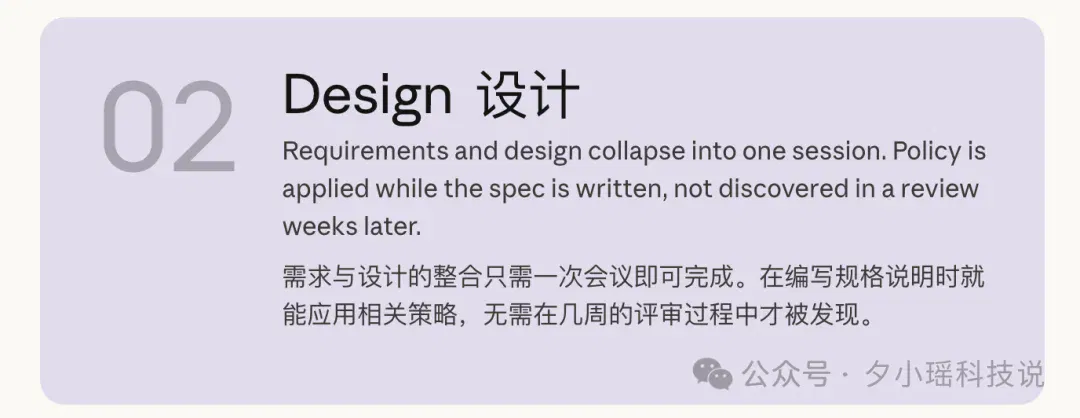
Spec 是 specification 的缩写,可以理解成一张施工图:功能如何工作、数据怎样流动、会改动哪些系统、必须遵守哪些规则,都写在里面。
第三阶段 Build(构建):计划没过,AI 先别动代码
这是变化最大的一步。
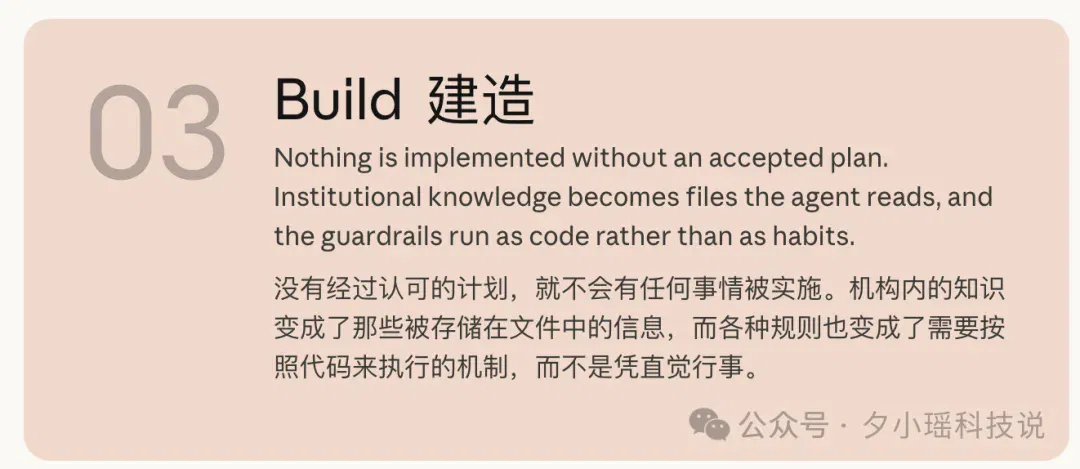
AI 编程最常翻的车,是你让它改个东西,它一下生成几十个文件,你一看方向从头就错了,返工比自己写还累。
所以这一步要求 AI 先进入计划模式:读代码库、列出要改哪些文件、怎么验证,但计划被你接受前不许动代码。
开发人员可以反复跟它改这份计划,改到满意,通过的版本写进plan.md。
AI 动手之前,还可以给它准备三层规则。它们作用不同,也不需要一次全部配齐。
最基础的是CLAUDE.md,一份放在项目根目录的说明文件。
记录怎样构建和测试、目录分别负责什么、哪些位置不能碰,以及 AI 经常犯哪些错误
AI 每次进入项目都会先读取它,相当于开工前先看一遍项目说明和避坑指南。。
其次是一份Skill,一条条可复用的工作规范。
它主要是管"某类活该怎么干"。比如"对外接口必须先验证身份",写成一条 Skill,AI 每次做这类任务都照办。
它比CLAUDE.md更聚焦,针对的是具体某一类操作。
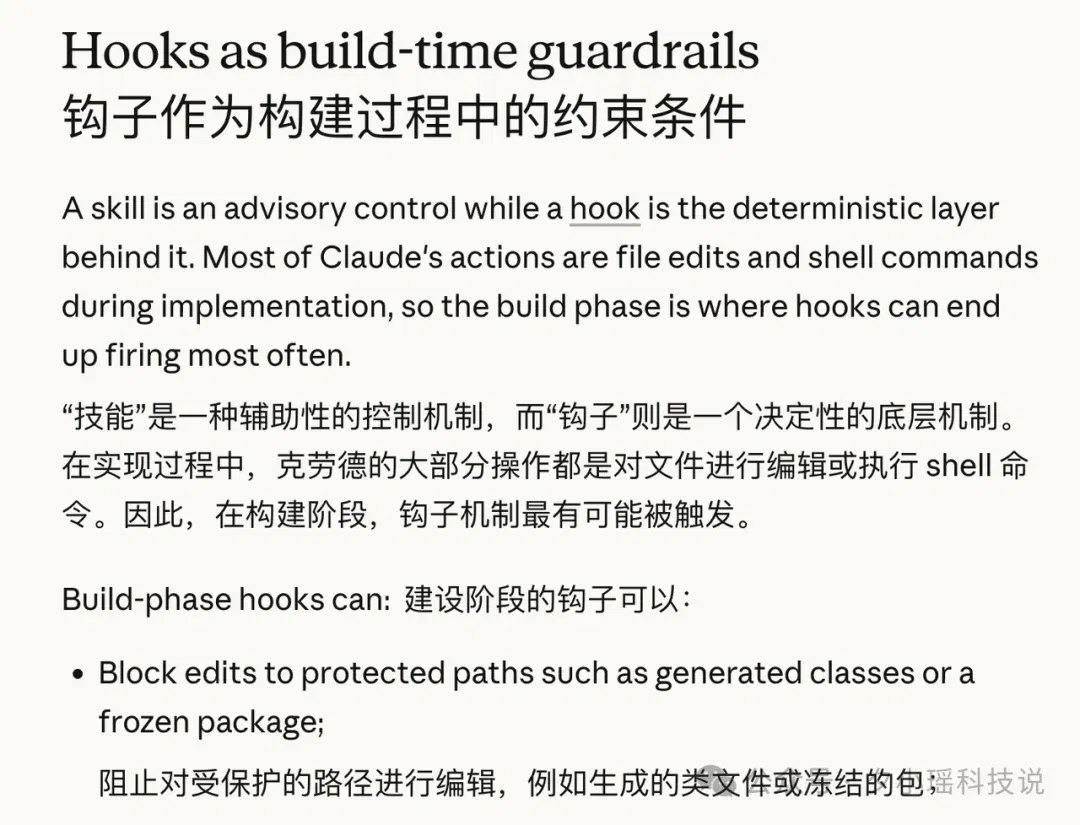
最后是Hook,绝不能碰的红线,需要交给 Hook。CLAUDE.md和Skill都属于指导性规则:它们能告诉 AI 应该怎样做,却不能保证每次操作都符合要求。
Hook 是按指定操作自动触发的脚本。AI 修改受保护文件、接触敏感信息或执行发布命令时,Hook 会立即检查;不符合规定,动作直接被拦下。
随着开发任务越来越复杂,Claude 还可以把部分工作拆给 Subagent。
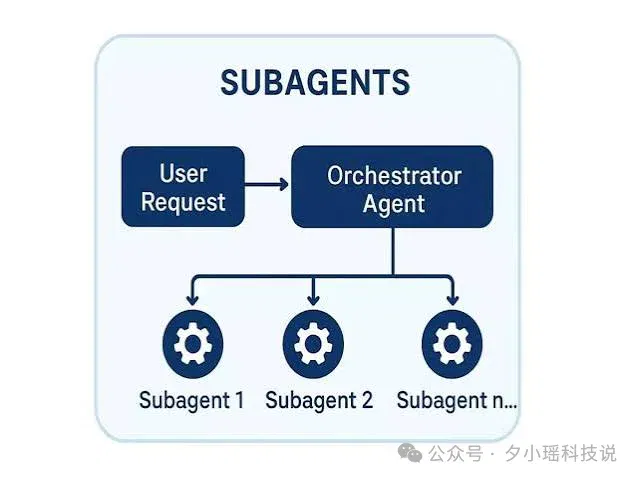
它相当于当前任务里的专职助手,拥有独立的上下文,只拿到完成这项工作需要的工具。
比如一个 Subagent 专门查代码,一个负责启动应用、验证功能,另一个负责清理多余代码。
主 AI 负责分配任务、汇总结果,人负责最后检查。
这样可以把重复工作从主对话中拆出去,避免所有事情挤在一个对话里,越做越乱。
第四阶段 Test:别听 AI 说完成,让结果作证Test(测试)。
已经完成 是 AI 编程里最坑的一句话,代码能生成不代表能跑。
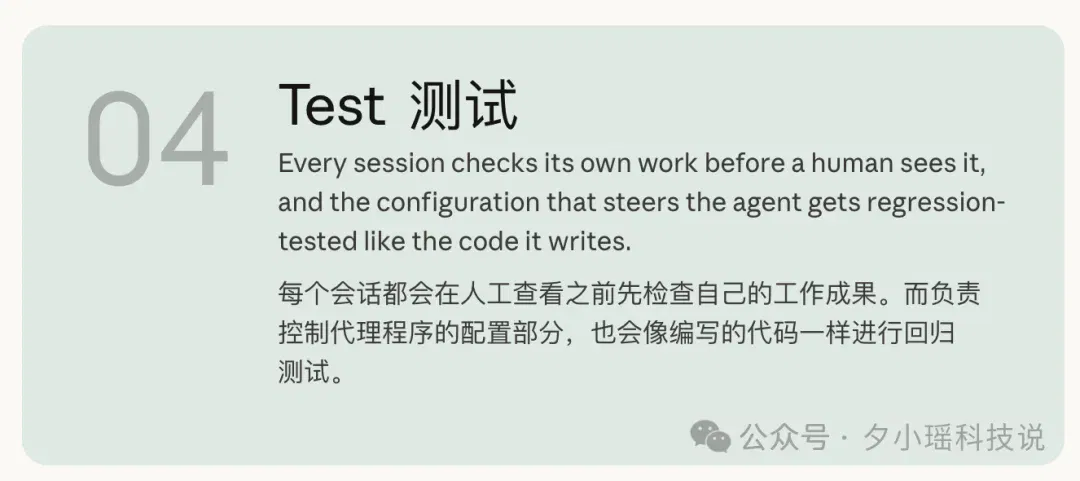
这一步要求 AI 自己跑测试、跑构建、比对结果,改到真过为止,最后把测试结果和截图一并交上来。
不过,让写代码的 AI 检查自己,仍然可能沿用原来的错误思路。
手册建议最后换一个全新的对话,只负责复核,不参与修改。修复 Bug 时还可以加一道 Hook,禁止 AI 改动测试文件。
但测试通过,只能证明这一次代码没有问题。以后换了模型,或者修改了CLAUDE.md、Skill 和 Hook,AI 的做法可能跟着变化。
在这之上,Anthropic 又加了一层 Evals,也就是持续评测。
在每次更换模型或修改规则,都先让 AI 重新完成这个任务,再用同样的标准检查结果。
只要其中一项不合格,就说明这次调整可能带来了新问题,不能马上用到正在开发的项目里。
线上发生过的问题也会加入 Evals,避免以后换了模型或规则,又踩回同一个坑
第五阶段 Deploy(部署):让 AI 准备上线,人守最后一关
AI 可以一路自动做到上线关口前,但绝不能自己主动上线。
Deploy 阶段先让 AI 进入 PR 审查。
团队可以在REVIEW.md中规定审查顺序:先找逻辑错误,再查安全漏洞,然后对照spec.md和plan.md,确认功能有没有跑偏。
PR 获批后,代码进入 CI/CD 自动发布流水线:CI 接过新代码,自动完成构建和测试;CD 再把检查通过的版本送到开发、测试或生产环境。
以前这些环节需要开发人员盯着执行,现在 Claude 也可以进入这条流水线。
不同环境给 AI 的权限也不同。在开发环境中,它可以自行部署;到了生产环境,它只能把发布准备好。
真正上线时,Hook 会挡住发布命令,直到一位具名的发布负责人授权。
第六阶段 Maintain(维护):让线上事故回到第一步
上线不是终点,维护阶段把循环真正闭合。
监控脚本盯住错误率、延迟这类指标,一旦越界就自动叫 AI 做只读诊断(只查不改),严重时提出修复或触发事先批准好的回滚。
需要注意的是事先批准,AI 能触发的动作都是提前定好、演练过的。
修完确认指标回到正常,这次的处理结论又被写成一份新的intent.md,回到第一步。
于是,Loop跑通。
◈该按什么顺序去落地
上面六个阶段讲的是一个需求从想法到上线的流程顺序,但落地的时候不用按这个顺序改。文章给了一张依赖关系图,告诉你可以按什么顺序落地。
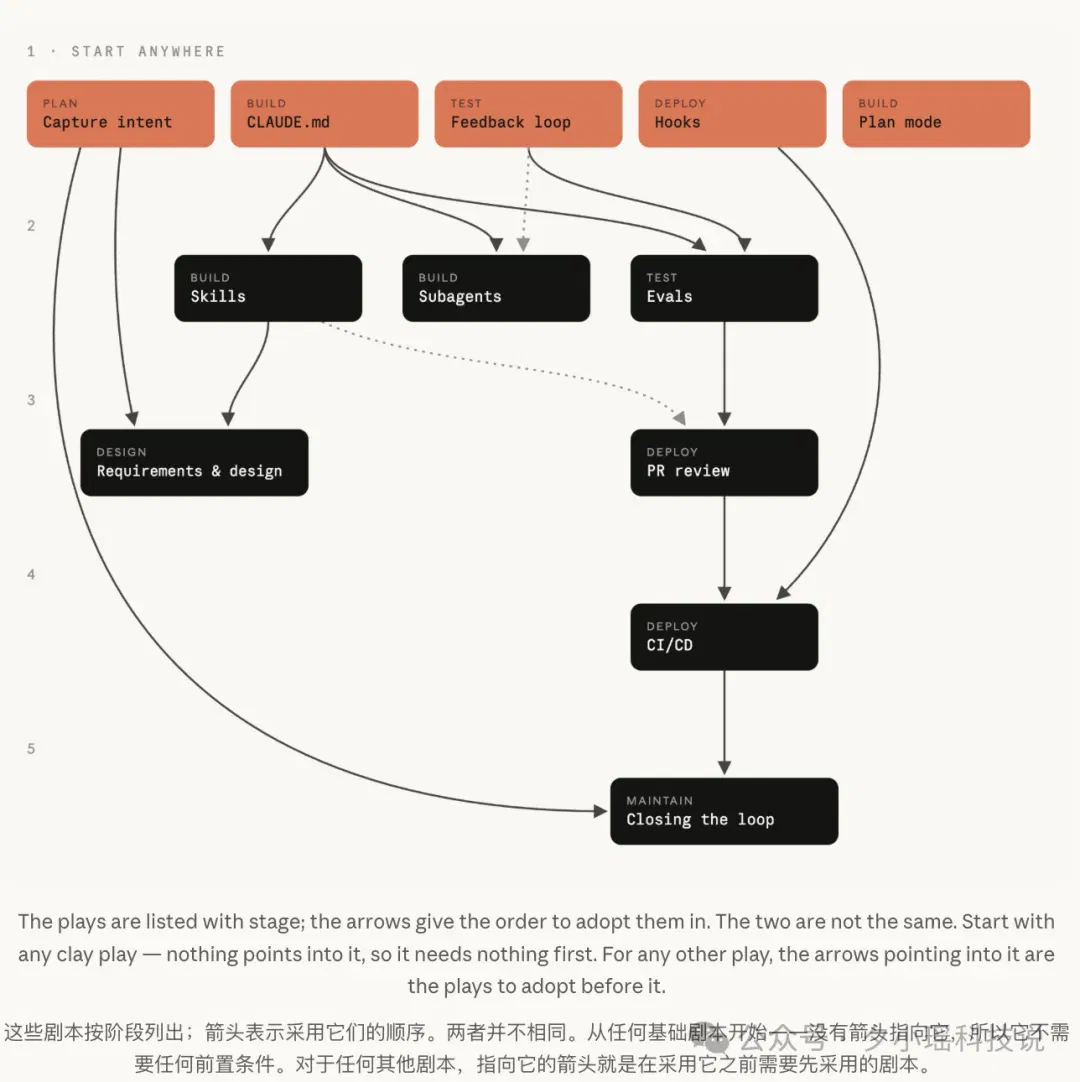
第 1 层,是五个可以直接开始的基础做法。
需求容易走样,就先用intent.md;AI 总犯同样的错误,就先写CLAUDE.md;AI 做完后拿不出证据,就先补测试反馈;高风险操作怕失控,就先加 Hook;AI 一动手就改太多文件,就先使用 Plan mode。这五项没有前置条件,也不要求全部配齐。
第 2 层,是把成熟做法固定下来。
团队可以按需要加入 Skills、Subagents 和 Evals,把反复使用的工作规范、重复任务和检查标准保存下来。缺规则就补 Skill,任务太杂就用 Subagent,担心换模型后效果退步就加 Evals。
第 3 层,是把 AI 接入需求设计和 PR 审查。
想让 AI 生成更可靠的方案,就先准备intent.md和相关 Skills;想让 AI 参与 PR 审查,就把前面的规则和检查标准接进审查流程。两个方向可以分别建设,不必同时完成。
第 4 层,是接入 CI/CD。
当企业准备让 AI 进入自动构建、测试和部署流程时,需要先建好 PR 审查和 Hook。前者负责检查代码,后者守住发布权限。
第 5 层,是让线上问题自动返回开发流程。
只有想进一步提高自动化程度的团队,才需要接入线上监控。系统发现异常后调用 AI 诊断,再把结果写成新的intent.md,启动下一轮开发。
企业不必从第一层一路做到第五层,先找到最耗时、最容易出错的地方,缺哪项就补哪项。
◈我怎么看
这套方法论的价值,可能在于把一个大家已经隐约感觉到、但还没被系统化表达的现象讲清楚了,并给出了具体到可操作层面的落地清单。
几点我认为确实有增益:
第一,AI 编程带来的效率问题,已经从生成速度转向流程效率。
一个工程师多写几倍代码,未必能让产品多交付几倍功能。
这套AI Native 的软件开发范式,重新评估的是,需求进入工程的速度、评审的承载能力、测试反馈的时间等。
第二,组织真正的工作资产可以被版本化、审计化。
团队规范如果只在 wiki、会议和老员工记忆里,是之前的做法。现在应该它放进版本控制的CLAUDE.md、skills 和 hooks,跟着代码一起版本化迭代。
第三,人的工作位置变了。人仍然对关键判断负责,但注意力可以从逐行检查机械错误,转到确认目标是否正确、风险是否可接受、权限是否合理。
人负责判断那些无法靠规则自动解决的事情。
最后,这篇博客明显带有 Claude 产品的使用路径。CLAUDE.md、skills、hooks、worktree 和 MCP 都是 Anthropic 生态里的具体实现,所以不能把整套配置原封不动搬进任何团队。
更稳妥的读法,是吸收它的流程判断,再用现有代码托管、持续集成与持续交付(CI/CD)、测试和权限系统去实现。
参考文献
[1] The AI-Native SDLC Playbook(Anthropic 官方手册):https://claude.com/blog/the-ai-native-sdlc-playbook
[2] How Anthropic secures its AI-native software development lifecycle(Jason Clinton):https://claude.com/blog/how-anthropic-secures-its-ai-native-software-development-lifecycle
文章来自于"夕小瑶科技说",作者 "夕小瑶编辑部"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Anthropic 用 20 万次研究会话估算 AI 的科研提速潜力 (opens in a new tab)
报告结合 Claude 使用记录和学者问卷,估计广泛采用现有工具可能分担 27% 至 52% 的研究工时。更高的产出倍率来自非实操任务自动化的假设情景。
METR 评估 Anthropic 的研发加速,估算 AI 辅助贡献约八成 (opens in a new tab)
METR 报告估算,Anthropic 在所用综合指标上的进步速度约为此前的 1.9 倍。研究者估算 AI 辅助占研发加速约 80%,并列出置信区间、内部信息限制与人类研究人员的参与。
Mollick on agent collaboration: why improving 3D worlds turned into lengthy approvals (opens in a new tab)
Ethan Mollick describes repeated themes, expanding rules and subsequent adjustments in Fable 5.2 multi-team creation. He argues long-running execution still needs human judgment about work quality, purpose and when to stop.
Claude Code desktop opens theme mods for colors and animated customization (opens in a new tab)
The article describes natural-language creation of visual mods and official theme examples, alongside comparisons with other coding tools. Support varies by version and plugin; appearance and comfort differ across people and devices.
Anthropic updates supported-region terms, clarifying entity control and usage restrictions (opens in a new tab)
The terms restrict users’ locations, entities’ incorporation or headquarters, and majority ownership or control. Their specific application depends on the terms and product documentation.