「源神」回归!Qwen3.8-27B 到底戳中了谁?
为什么偏偏是小尺寸模型?为什么是现在? 在万亿参数旗舰扎堆发布的 2026 年夏天,冲上 Hugging Face 全球趋势榜榜首的,是一个只有 270 亿参数的模型。 Qwen3.8-27B 开源两天,下载破 100 万次。社区贡献超 500 个量化版本。相关模型总下载量超 500 万次。海外开发者连夜量化实测,称之为「能装进笔记本的 Opus 4.6」。 千问大模型团队又一次被社区称为「来自中国的源神」。 为什么偏偏是这个尺寸?为什么是现在?为什么它让整个开源社区重新兴奋起来? 一、Qwen3.8-27B 到底有什么? Qwen3.8-27B:270 亿参数,Dense 架构,体量小了近百
为什么偏偏是小尺寸模型?为什么是现在?
在万亿参数旗舰扎堆发布的 2026 年夏天,冲上 Hugging Face 全球趋势榜榜首的,是一个只有 270 亿参数的模型。
Qwen3.8-27B
开源两天,下载破 100 万次。社区贡献超 500 个量化版本。相关模型总下载量超 500 万次。海外开发者连夜量化实测,称之为「能装进笔记本的 Opus 4.6」。
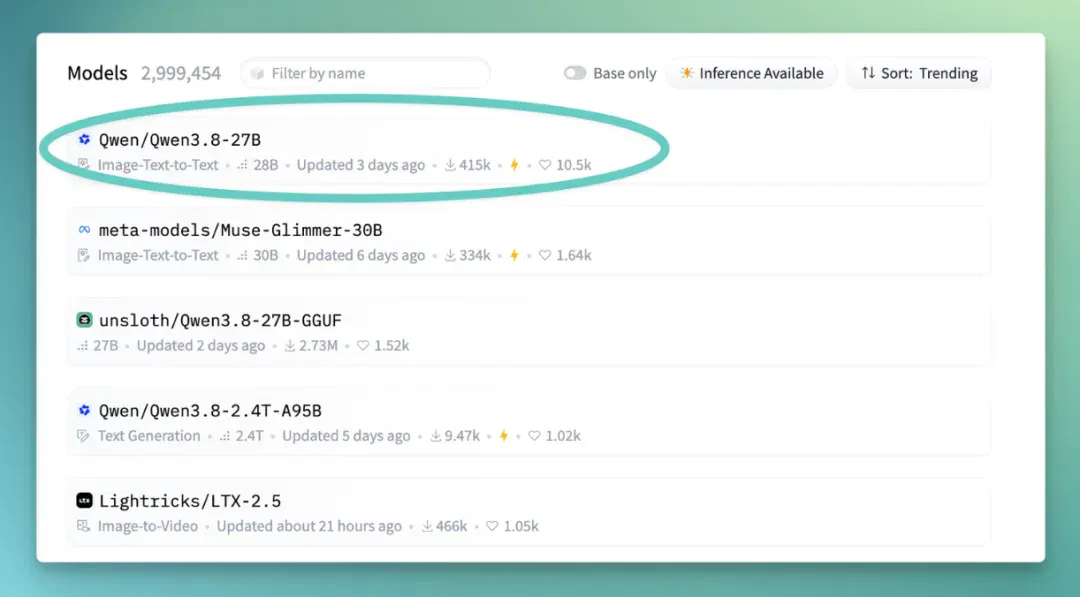
千问大模型团队又一次被社区称为「来自中国的源神」。
为什么偏偏是这个尺寸?为什么是现在?为什么它让整个开源社区重新兴奋起来?
一、Qwen3.8-27B 到底有什么?
Qwen3.8-27B:270 亿参数,Dense 架构,体量小了近百倍,架构反而更精细。原生多模态,支持图像和视频理解。原生上下文 262K,YaRN 外推到 100 万。新增 reasoning_effort,按任务难度调节思考深度。Apache 2.0 协议,免费下载和使用。
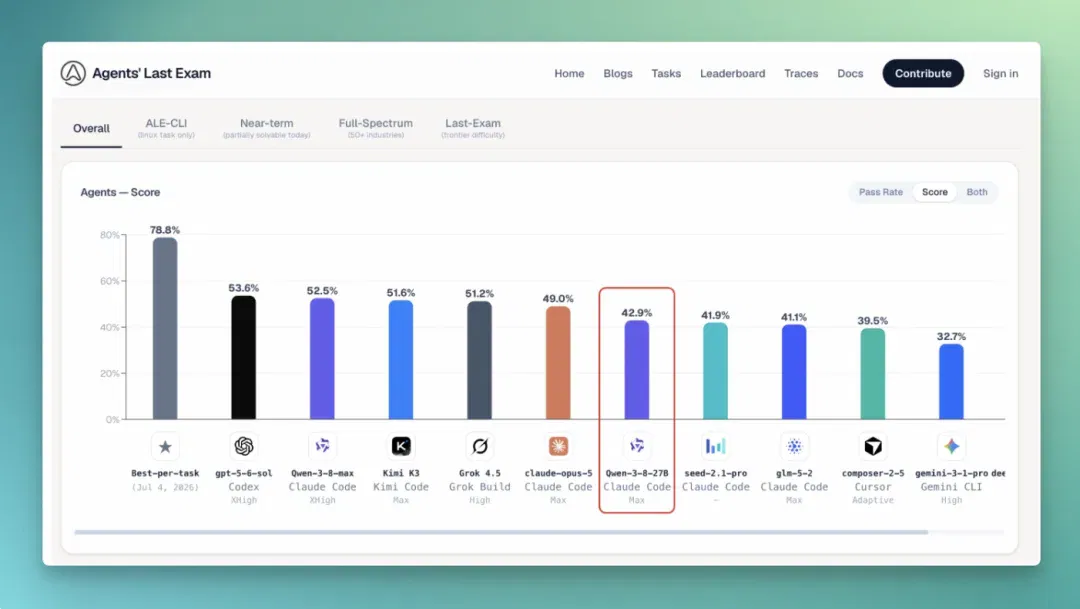
性能层面,27B 多项 Benchmark 接近甚至超过 Opus 4.6 Max,相比前代 Qwen3.6-27B 在编程和办公场景大幅提升,甚至超越了 Qwen3.7-Plus。第三方 Agent 评测 Agents' Last Exam 综合得分 42.9%,进入全球前列。
这让不少海外开发者开始思考:
能不能用一张家用显卡,运行一个 Opus 4.6 级别的模型?
海外开发者已经在用行动回答。X 上一位 AI Agent 构建者就认为,Qwen3.8-27B 基本能媲美 Opus 4.6。网络安全公司 Co-Founder Paul Seekamp 表示,Qwen3.8-27B 的模型性能确实良好,计划用它代替 Claude 的模型。KOL Ripper也认为,笔记本上跑出 Opus 4.6 级别性能,小型化趋势令人兴奋。
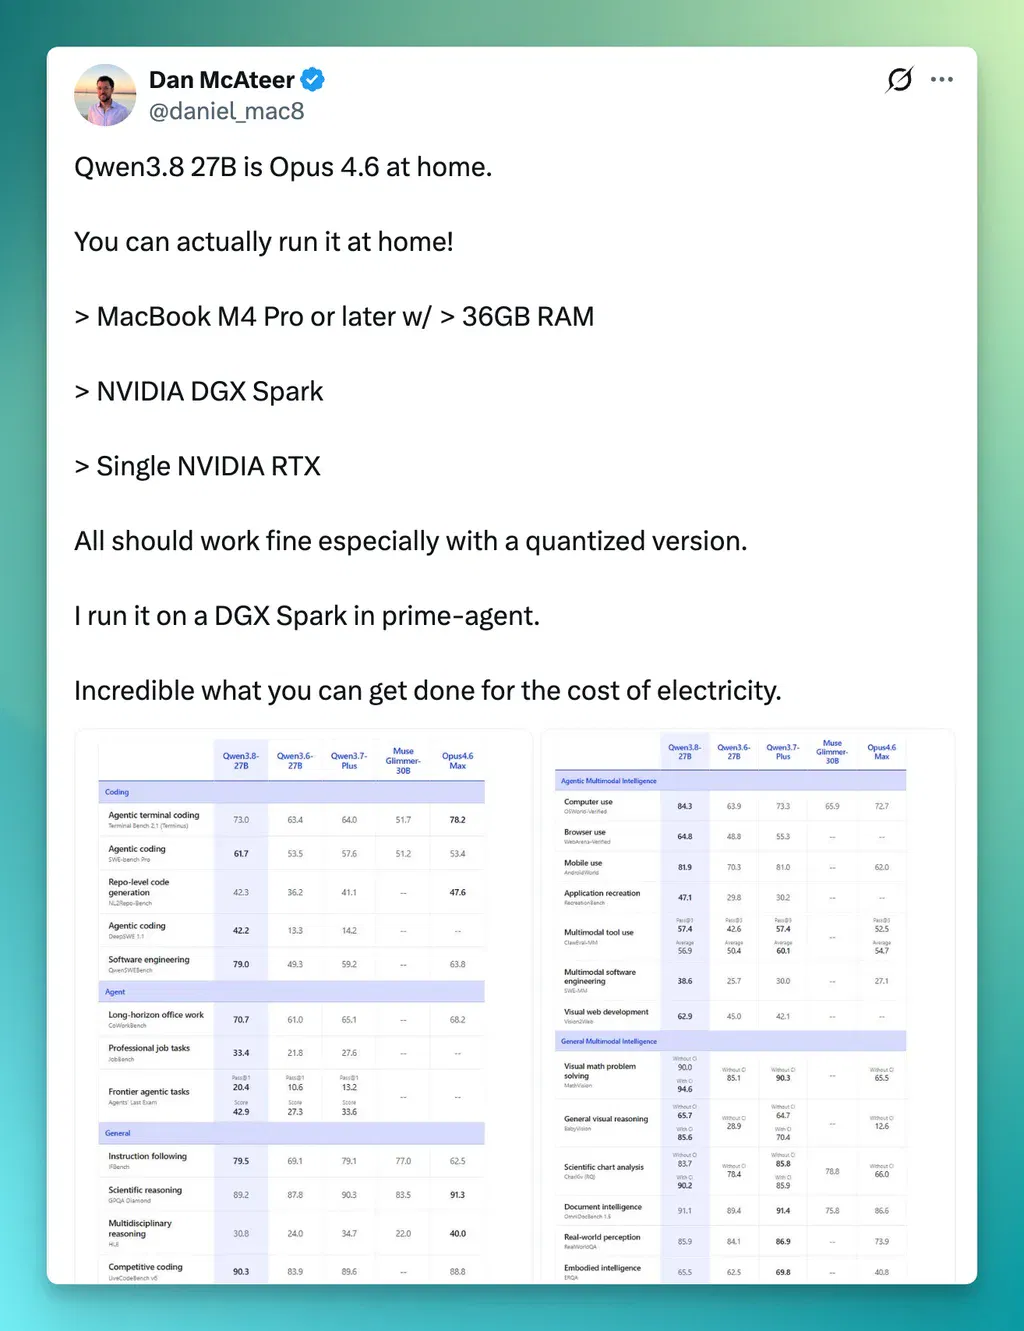
这种期待很快落地。开源 2 天,Qwen3.8-27B 的下载量便突破 100 万次,社区贡献超过 500 个量化版本,相关模型总下载量超 500 万次。这个速度本身就是答案。
二、为什么偏偏是小尺寸模型?
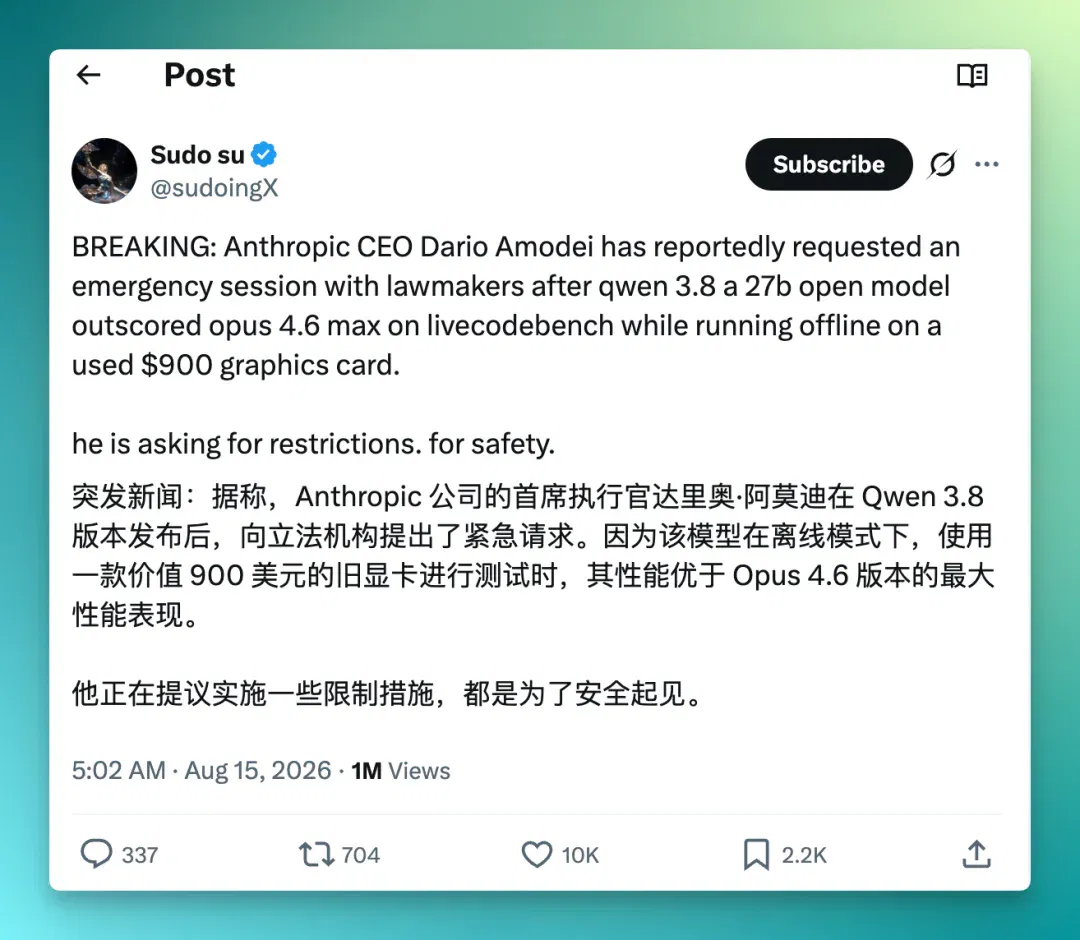
上周,海外网友@sudoingX 编了一条段子,浏览量竟然超过了100万:
Anthropic CEO Dario Amodei 因为 Qwen3.8-27B 在一张二手 900 美元的显卡上跑赢了自家旗舰 Opus 4.6 Max,紧急约见立法者,要求以安全为由限制开源。段子越写越细,甚至加上了 OpenAI CEO 满头大汗赶到现场的情节。
改编版本越来越抽象:
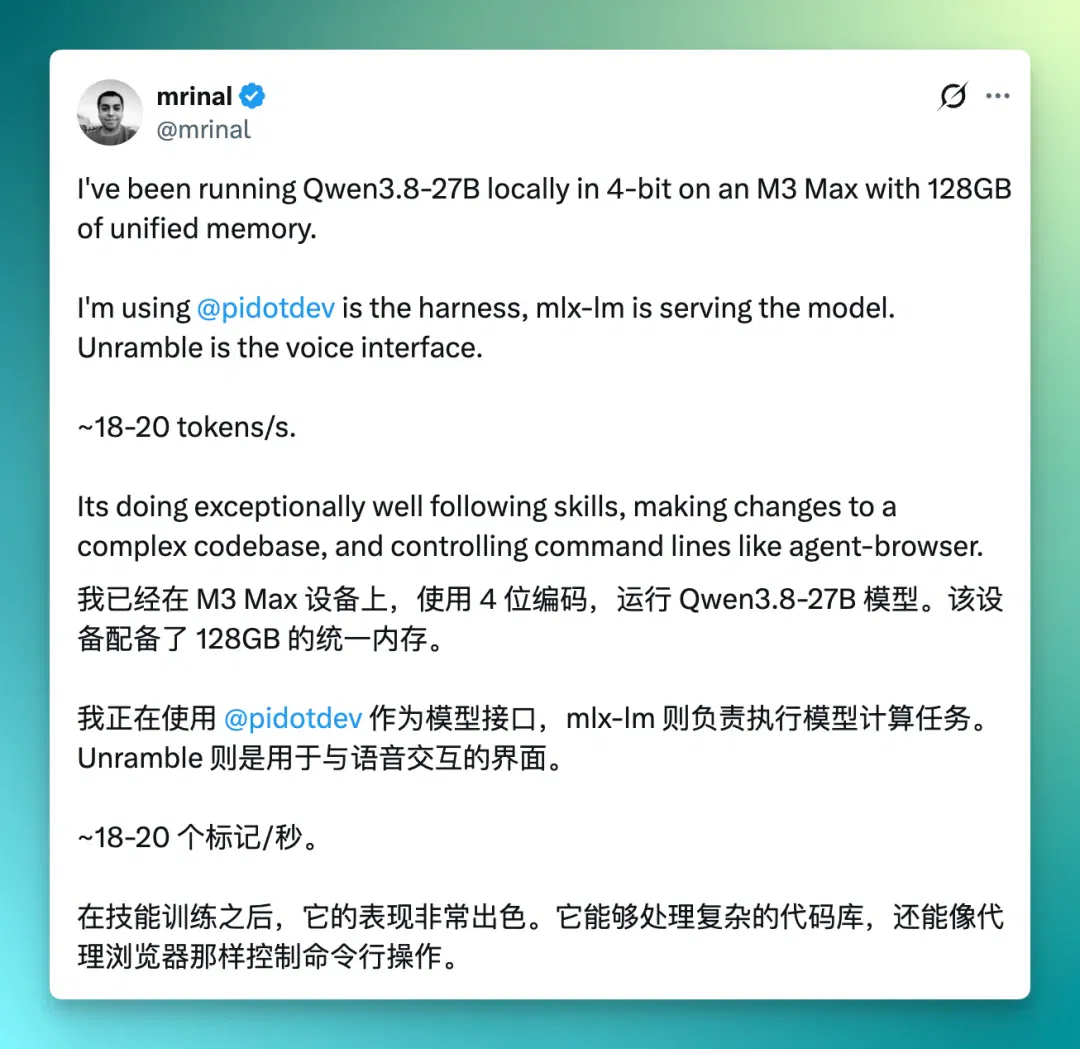
它当然是编的,但 100 万次浏览说明很多人下意识觉得这事「听起来不算太离谱,至少可以读一下、嘲讽一下」。
支撑这种想象的核心不是跑分,是部署门槛。
官方 FP8 版本显存需求约 28GB,一张 RTX 5090 就能运行。如果量化到 4bit 降到 14 到 17GB,RTX 4090 也能带得动。大内存的 MacBook Pro 或 Mac Studio 靠统一内存架构同样能加载。
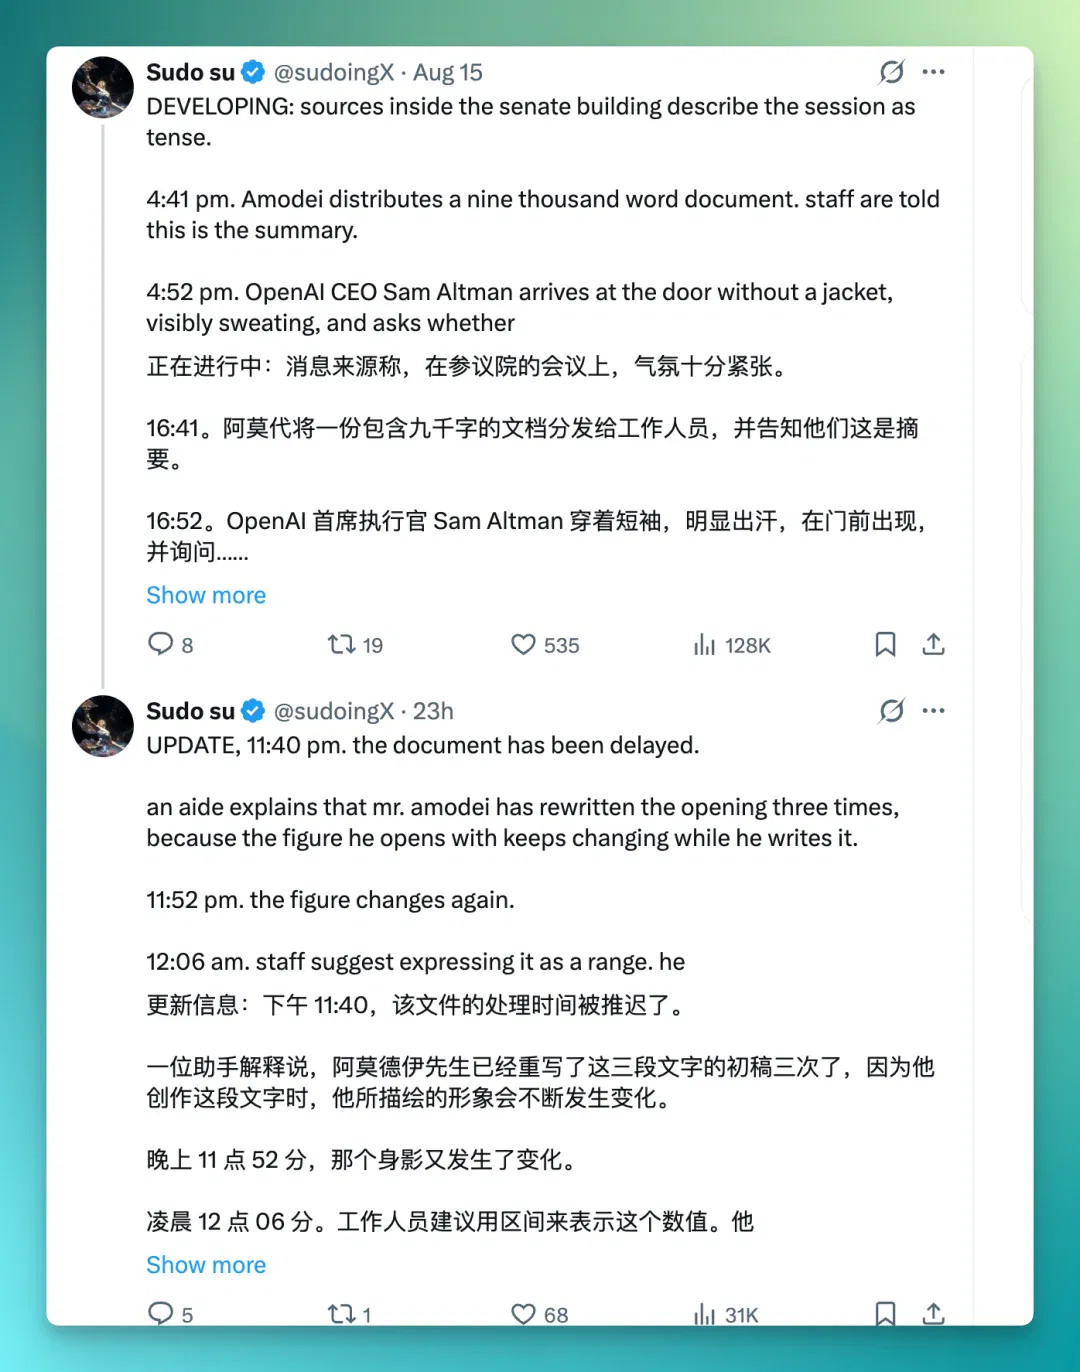
前 Autonomy CTO mrinal 在 M3 Max 上本地运行 Qwen38-27B,输出速度为 18 到 20 tokens/s,称赞指令遵循和 Coding 能力还不错。
跑分证明的是「它有多强」,部署门槛决定的是「谁能用上」。这是两件不同的事。
前代 Qwen3.6-27B 开源近半年热度不退,一直是业内公认的家用电脑本地部署首选。这本身就证明了 27B 这个尺寸的需求有多硬。Qwen3.8-27B 在此基础上把能力拉到了旗舰版的八成以上,同时部署门槛不变。
这就是它被称为「黄金尺寸」的原因,不是最强,而是好用。
而「好用」这两个字被如此反复强调,恰恰暴露了一个更深层的问题。
三、到底什么才是社区需要的开源?
过去半年,开源模型参数从数百亿扩展到万亿级,上下文从几十万扩展到一百万,「又开源了」这四个字,好像没那么让人兴奋了。
这种疲惫感有一部分是真实的,根源在于超大模型用不上普通人的硬件。
36 氪之前有篇文章,标题是「没两辆劳斯莱斯幻影,别想部署开源大模型」,很适合解释这种「开源疲劳期」:
当一个人,要完整本地部署一个 2.4 万亿参数模型,需要 64 张英伟达 B200,硬件采购约 3000 万人民币,还没算电费和运维。1.6 万亿参数的模型也得搭配 16 张 H200,首年硬件投入四百多万,每年养护再烧 120 多万。
这些数字,算是让绝大多数团队彻底无缘 SOTA 开源模型。
因此,一个略显反常的现象出现了:
旗舰模型越开源,独立开发者的「边际兴趣增长」越低。
一个 SOTA 大尺寸模型即便开源了,如果算完账发现自己接触不到,也用不上,它就只剩下看热闹的价值,而热闹的新鲜感,耗得很快。
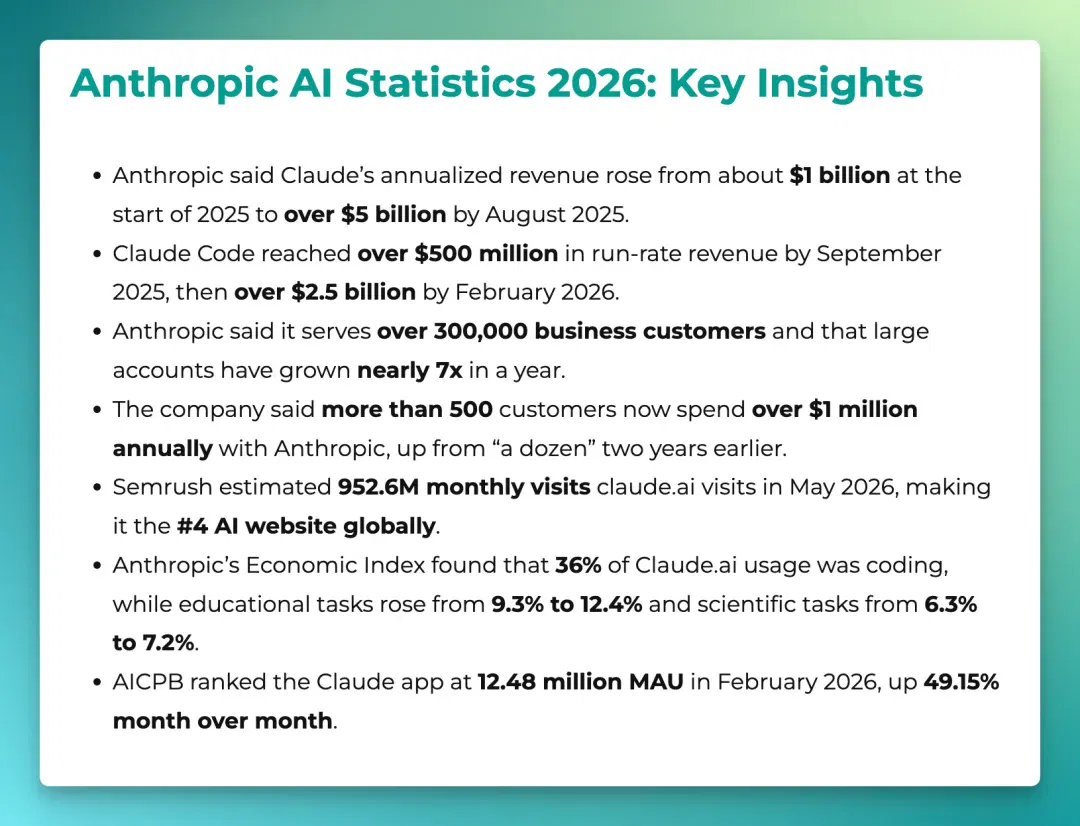
Anthropic 自己的 Economic Index 也印证了这一点,代码这类常规任务占 API 调用量的 36%,剩下则分布在对话式产出和书面交付这些不需要顶尖能力的日常工作上。
大家等的是一个合适尺寸的、有人持续维护的、装进自己电脑就能干活的模型。
从这个角度看,所谓疲劳期可能只是一个假命题。
真相是:「看热闹的狂热」在降温,「实用主义」在升温,一个 27B 模型能引起这种热度,反衬的不是社区变冷了,而是需求一直被压着没被满足。
但下载量只能证明好奇心。开发者愿意在一个模型上持续投入,做量化、做适配、做二次开发,需要另一层信任。
这就引出了另一个词:基座。
四、基座到底是什么,Qwen是基座模型吗?
「基座」在开源社区有一个朴素的含义:一个值得在上面构建东西的模型。
但问题是,很多模型发布时被寄予厚望,几周后就消失了。真正的基座,需要靠后续的实际使用来确认。
确认的标准有三层。
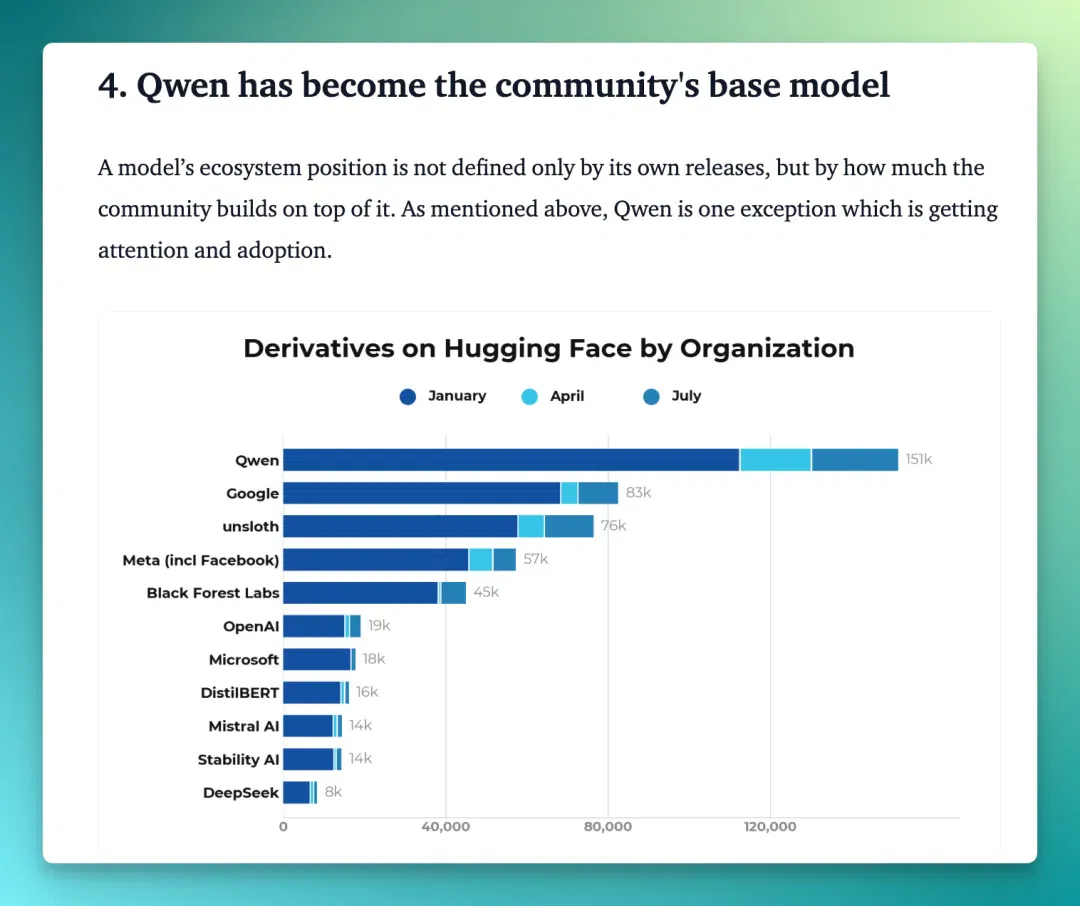
第一层,用的人足够多。Hugging Face 8 月 14 日发布的《开源模型现状:2026 夏季观察》报告,专门为Qwen写了一节。报告指出:凭借持续稳定的迭代、广泛覆盖的尺寸、宽松的协议,Qwen 已是全球开源社区的基座模型,开发者微调和部署时的默认选择。
今年前七个月仅 Hugging Face 上,Qwen 下载量就达 20.45 亿次,衍生模型突破 15 万个,每天仍以约 200 个的速度新增。这些指标远超 Meta、Google、英伟达等国际开源活跃厂商。
第二层,大量人在没有报酬的情况下持续投入。阿里累计开源 460 多款 Qwen 模型,全球下载总量超 30 亿次,衍生模型超 30 万个。开源生态不是一家公司能堆出来的,它需要社区自发地做量化、做适配、做衍生。
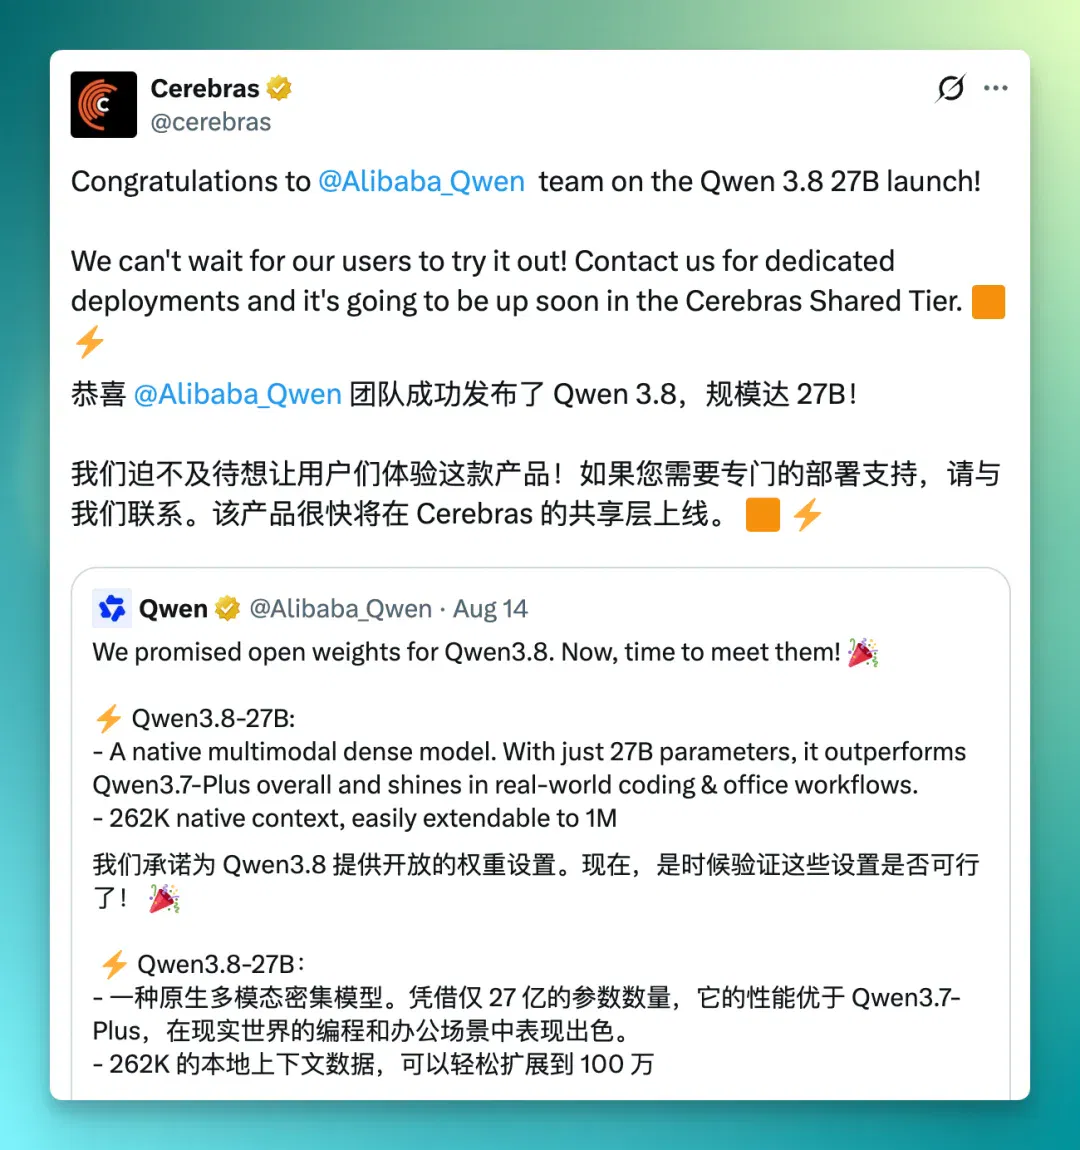
第三层,产业链愿意提前押注。模型开源当天,硅谷当红辣子鸡、晶圆级芯片新贵Cerebras就在 X 上公开向Qwen团队道贺,说很快会上线到自家算力层。Qwen的开源生态引力已经大到连基础设施层都主动追着跑,希望能来分一杯羹。
AMD 官方博客同一时间确认 Qwen3.8-27B 在 Ryzen AI 处理器和 Radeon 显卡上做到了「Day 0」支持。vLLM、Ollama、LM Studio 等推理框架也当天同步放出适配方案。更早前,Pinterest、Airbnb 等知名公司 CEO 均公开表示采用了 Qwen,理由是性能好、成本低。
三层叠加,答案是肯定的。
但这里有一个更值得注意的洞察:开源世界里的基座地位,护城河不是锁定,是惯性。
开发者习惯了在某个模型上做事,工具链围绕它搭建,社区围绕它聚集。这套习惯一旦形成,替换成本就很高。但习惯也有脆弱的一面,一旦断更或质量下滑,它会慢慢转移。
所以基座需要持续维护。维护的方式就是按稳定的节奏、在各个尺寸上持续发布可用的模型。
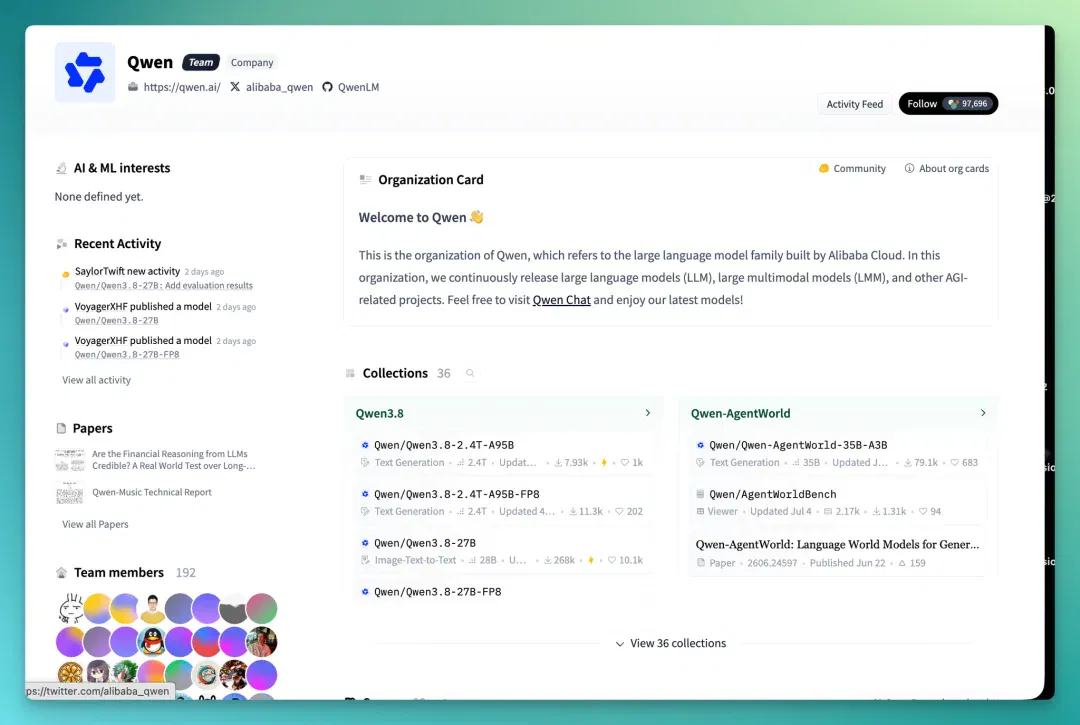
对使用者来说,这条路线本身就是一种承诺,他们愿意在 27B 上投入,前提正是相信下一版还会有人认真做。
这也是阿里Qwen一直在做的事。
所以「源神」这个称呼真正的含义,不是「又发了一个强模型」,而是「一直在发布,而且是以社区能用的方式发布」。重点不在模型本身的能力,在发布这个动作的持续性。
🚥
最后说一个判断。
Anthropic CEO Dario Amodei 在今年上半年的一次播客采访中,曾提出过一个很有意思的概念,叫做「智能溢价」。
前沿模型的智能水平仍会持续提升,也会不断产生其他模型暂时无法稳定完成的能力。复杂研究、陌生代码库、高风险决策,以及需要持续数小时甚至更长时间执行的 Agent 任务,都会促使用户继续选择能力最强的模型,并愿意为这种能力差距支付额外成本。
这无法反驳,但它只解释了 AI 领域的一半。
正如吴恩达在回复 Anthropic 研究员 Julian Schrittwieser 的一则 X 帖文时所强调的:开源的长期价值在于扩大 AI 的分发范围。
把两个判断并列,一条线索就清晰了。
「旗舰模型负责那些做不好就有大损失的事——收取智能溢价,小模型负责那些做得多就有大收益的事——持续分发智能」
或许,这才是今天大模型市场越来越清晰的一种分工。
Qwen3.8-27B 这一周掀起的热浪,本质上证明的就是这件事:这一轮全球AI开源的势能,不是汇聚在最大的模型身上,而是汇聚在能被真正用起来的模型身上。
这就是Qwen此刻的坐标。也是整个 AI 开源世界正在抵达的坐标。
文章来自于"十字路口Crossing",作者 "GaKi"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
APPSO tests Qwen4-Max on 3D disassembly visualizations and cross-software creation (opens in a new tab)
APPSO uses Qwen4-Max for interactive iPhone and car disassembly demos, plus OpenSCAD, ngspice and Blender workflows, while discussing task costs. These are generated visualizations and author experiences, not physical hardware teardown validation.
Alibaba releases Qwen4-Max, expanding multimodal and industry-agent workflows (opens in a new tab)
The report covers Qwen4-Max's architecture, million-token context and long-horizon delivery examples. Work360 and AII show different cost reductions; complex open-ended tasks remain a weakness, while smaller models are planned for later open release.
Alibaba plans Hong Kong spin-off of T-Head; standalone financials and valuation await disclosure (opens in a new tab)
Alibaba says T-Head has filed a confidential listing application and plans a spin-off through a global H-share offering. ChinaVenture reviews its chip business and commercialization; the valuations cited are market estimates.
千问 Qwen4-Max 预览版体验,动画与交互表现怎样 (opens in a new tab)
智东西用动画、交互场景和 GIF 任务体验 Qwen4-Max 预览版,记录了生成耗时、控制细节与字幕错位等问题。
Qwen Code 1.0 Preview 发布,融合 Qoder 的 Harness 能力 (opens in a new tab)
Qwen Code 1.0 预览版开放融合后的运行框架,以事件组织会话、工具与反馈。团队保留稳定分支,并计划继续完善分布式扩展和任务接续。