88.9 倍性能飙升!JSON Shredding 让 JSON 查询告别全表扫描| Milvus Week
本文为Milvus Week系列第一篇,该系列旨在分享Zilliz、Milvus在系统性能、索引算法和云原生架构上的创新与实践,以下是DAY1内容划重点:
本文为Milvus Week系列第一篇,该系列旨在分享Zilliz、Milvus在系统性能、索引算法和云原生架构上的创新与实践,以下是DAY1内容划重点:
- 传统JSON 格式数据处理效率与灵活性难以兼顾
- JSON Shredding 通过把高频键拆分为独立的类型化列,混合类型的键拆分为动态列,稀疏低频键汇总到共享键存储并配套建立倒排索引,做到了效率与灵活性兼备。
现代应用,从微服务到物联网设备再到以JSON output为标准配置的AI应用,都在源源不断地产生海量的 JSON 或类 JSON 格式的半结构化数据。
对此,传统的处理方式主要有两种:
1.完全解析成固定表:将所有可能的字段提前定义好。这虽然能获得不错的查询性能,但一旦数据格式发生变化,就需要繁琐的 DDL 变更,灵活性极差。
2.将整个 JSON 存储为单个字段(如 JSON 列)或者 使用Milvus 的 Dynamic Schema 功能:虽然增加了灵活性,但需要以牺牲一定的查询性能为代价。每次查询都需要在运行时解析 JSON,并进行全表扫描,当数据量庞大时,响应速度会急剧下降。
痛点一句话概括,就是灵活性与效率不能兼得。
那么有什么办法能够解决这个两难困境?
答案就是今天Milvus正式推出的JSON Shredding 功能,它能将无模式数据的灵活性与列式存储的查询性能完美结合,做到鱼与熊掌兼得。
01
JSON Shredding 的工作原理
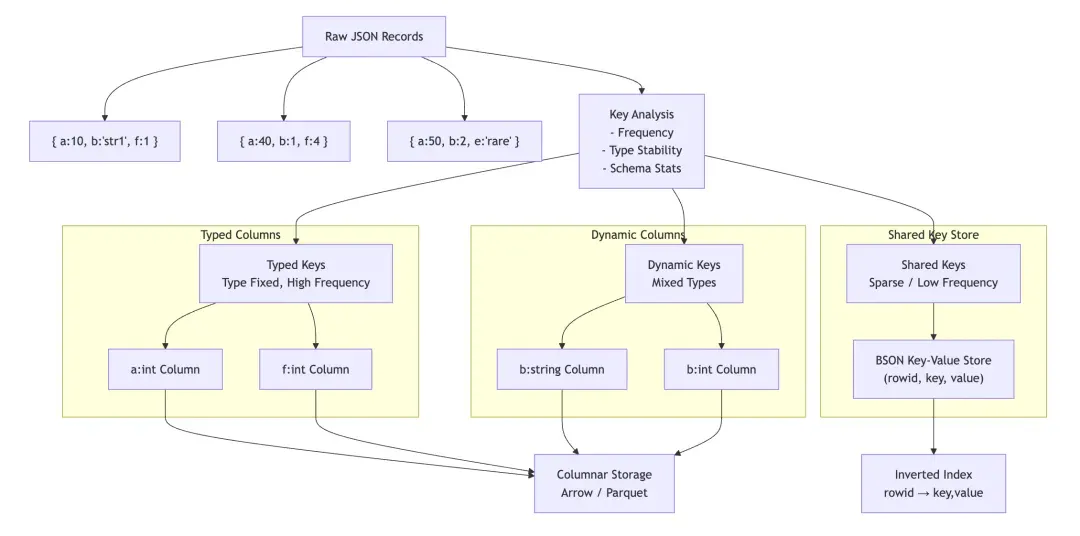
JSON Shredding 的核心思路是 动态列式存储。它结合了 JSON Shredding 和 Shared Key Index 技术,整个过程对用户完全透明,你只需要正常插入 JSON 数据,系统会在背后自动完成所有繁重的工作。
其具体工作流程是:系统接收结构灵活的原始 JSON 记录,然后对其中的键做频率、类型稳定性、稀疏度的分析;接着将类型固定的高频键拆分为独立的类型化列,混合类型的键拆分为动态列,这两类数据都会存为Arrow/Parquet 列存格式;而稀疏低频键则汇总到共享键存储并配套建立倒排索引。
详情如下图所示:
第一步:JSON 拆分与列化
这是JSON Shredding 的核心,是带来性能提升的关键。
当一个新的 JSON 文档被写入时,系统会将其拆分
- 将一些稠密的键值对自动识别为独立的列。
- 如果遇到嵌套的 JSON 对象,系统会将其扁平化,并自动生成合理的列名(例如,user 对象下的 name 字段可能被存储为 /user/name)
- 对于稀疏的一些键值对,系统会将其汇总全部放在一列共享列中,并对其做一些优化,针对其稀疏性,建立key 的倒排索引,实现对稀疏值的快速过滤。
第二步:动态列管理
这是实现灵活性的关键。
- 列自动创建:相同Key 的数据被重排放置在同一列中,实现列存的计算优势。系统会自动推断新字段的数据类型(如
INTEGER,DOUBLE,VARCHAR等),并为其选择高效的列式存储格式。
- Json 中的任意一个Key 都会被分析处理,对于查询具有较强的通用性,可以覆盖用户的所有查询,不需要用户自己创建key,也不需要提前构建索引等。
第三步,优化查询
- 如果你的查询条件或目标字段是已经被拆分成独立列的,查询引擎会直接扫描这些高度优化的列式数据。这样的好处是速度够快,一方面数据扫描量大幅减少,另一方面通过SIMD 的列式计算可以进一步优化效率。
- 如果你的查询条件没有被单独成列,那基本表明这些要查询的键值对是稀疏的,系统直接在Shared 列中查找,由于已经有基于Key 的倒排,也能很快定位这些查询Key 哪些行中,过滤大部分没有命中的行。带来性能的提升。
- 系统会自动维护全局的数据字典和元信息,确保即使数据格式无论如何变化,查询都能被正确、高效地执行。
02
Benchmark 评测
我们设计了一个基准测试,对比原生JSON与 JSON Shredding 在处理半结构化数据时的查询性能:
- 方案A(原生 JSON 字段):将整个 JSON 存储在一个字段中。
- 方案B(我们的 JSON Shredding ):本次发布的新功能。
测试环境:
- 测试硬件:1core8G
- 测试数据:JSONBench 1百万数据
- 测试方法:测试不同查询的 QPS 及 延迟
选取几个典型的场景
1.查询的key 可以被shredding 成单独列 (稠密数据)
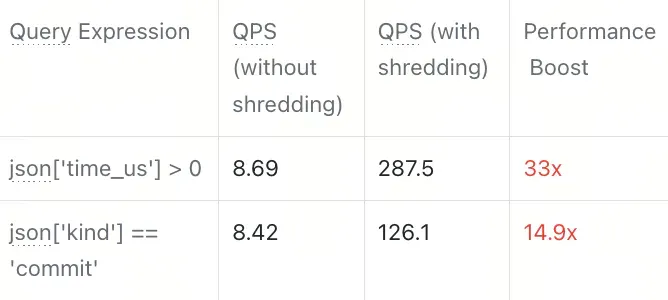
2.查询的key 没有shredding 成单独的列 (稀疏数据)
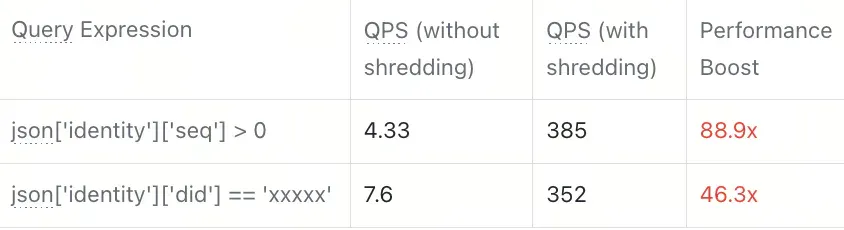
无论稀疏还是稠密的key 查询,得益于前面提到的优化方法,在shredding 的作用下都具有较大的性能提升。
03
即刻体验
无论面对的是 API 日志、物联网传感器数据,还是快速迭代的产品特性, JSON Shredding 功能都能为你提供“既要又要”的体验。
这项新功能现已上线,查看以下详细教程,即可开始使用。JSON Shredding | Milvus Documentation:https://milvus.io/docs/zh/json-shredding.md#Parameter-tuning
作者介绍
张露
Zilliz Staff Software Engineer
文章来自于“Zilliz”,作者 “张露”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
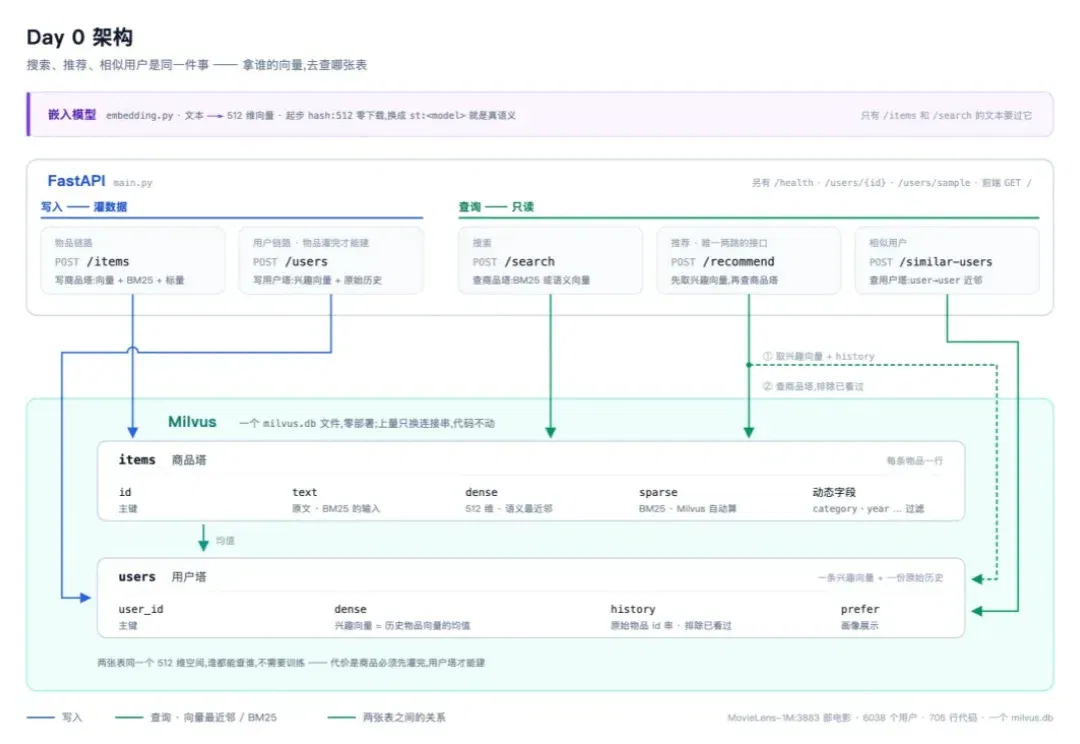
Claude Code and Milvus tutorial: local search, recommendations and vector retrieval (opens in a new tab)
A Zilliz author builds local search, recommendation and similar-user APIs with FastAPI, Milvus Lite and MovieLens data, first checking the flow with hash vectors before switching to embeddings. The examples validate a local prototype; quality needs separate evaluation.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

Ankole outlines multi-user agent architecture: events, permissions and organizational memory (opens in a new tab)
The team describes its Business Harness design for fast and slow paths, shared state, Actor orchestration and dynamic permissions. Formal verification covers the modeled core permission state machine; it does not replace security checks of the full deployment, external interfaces or implementation.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.