新型AI芯片能耗重大突破,已登Nature子刊
AI 浪潮席卷全球,但算力功耗的 “电费焦虑” 也随之而来。传统冯・诺依曼架构下,数据在 CPU 和内存间 “疲于奔命”,消耗了大量能量。
AI 浪潮席卷全球,但算力功耗的 “电费焦虑” 也随之而来。传统冯・诺依曼架构下,数据在 CPU 和内存间 “疲于奔命”,消耗了大量能量。
存算一体(Compute-in-memory, CIM)技术被寄予厚望。它直接在内存里 “算”,通过在模拟域执行高效的乘加运算,被视为消除数据搬运瓶颈的终极方案之一。
但,这只是故事的一半。模拟计算的结果,最终必须通过 “翻译官”—— 模数转换器(ADC)—— 变回数字信号,才能进行后续处理。
然而这个 “翻译官” 的开销,却成了新的 “拦路虎”。
在一篇新发表于《自然・通讯》(Nature Communications)的研究中,来自香港大学、香港科技大学和西电杭州研究院的团队指出,在先进的存算一体系统中,ADC 可能消耗高达 87% 的总能量和 75% 的芯片面积!
- 论文《Memristor-based adaptive analog-to-digital conversion for efficient and accurate compute-in-memory》
- 论文链接:https://www.nature.com/articles/s41467-025-65233-w
这个占据绝对大头的能耗组件,几乎抵消了存算一体本应带来的巨大能效优势,成了整个架构中最亟待解决的瓶颈。
英雄的隐痛:为什么存算一体绕不开 ADC?
要理解这个瓶颈,我们得先看 AI 到底在 “算什么”。
正如《Nature》上的一篇综述(Lanza 等人,2025)所指出的,AI 应用的核心是海量的向量矩阵乘法。传统架构(如 CPU)必须将这些运算分解成无数个单独的步骤,在内存和处理器之间来回倒腾数据。这个过程极其低效:Lanza 等人的文章分析,数据传输带来的能耗可能是计算本身的 200 倍,并带来巨大的延迟。
存算一体通过在内存阵列(例如忆阻器)中直接利用物理定律(如欧姆定律和基尔霍夫定律)并行完成 VMM,完美解决了这个问题。
但魔鬼藏在细节中。模拟计算的结果是连续的电流或电压,而数字世界只认 0 和 1。ADC 就是这个翻译官。问题是,这个来自传统混合信号领域的 “翻译官”,他的工作方式极其 “一刀切”,在这种新型 AI 芯片中格格不入。
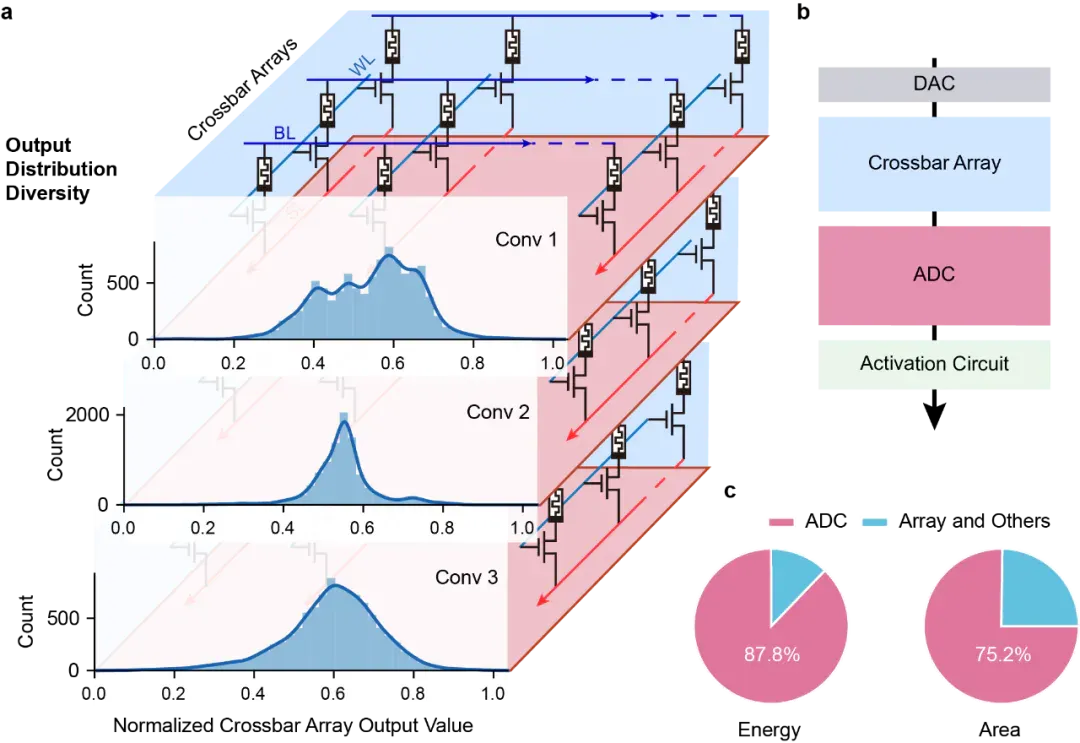
传统 ADC 采用的是 “均匀量化”(Uniform Quantization)。无论信号长什么样,都用一组固定的、等距的量化边界去 “切割”。
但这和神经网络的实际情况完全不符。研究人员展示,不同网络层的输出信号分布千差万别(如上图 Conv 1, 2, 3 所示),有的像正态分布,有的则是偏态或局部均匀的。用一套固定的边界去衡量千变万化的计算信号,必然导致在信号密集的区域 “分不清”,在信号稀疏的区域又 “浪费” 了边界,结果就是精度严重损失,AI 芯片推理效果不尽人意。
为了弥补这种损失,设计者被迫使用更高精度的 ADC(即更密集的边界),但这又会导致 ADC 的硬件开销(功耗和面积)呈指数级暴涨,陷入了恶性循环。
让量化边界学会自适应
既然固定的边界不行,那让它 “活动” 起来不就好了吗?
港大团队的思路是:既然你是固定的,那我就把你变成 “活” 的。他们看中了 “忆阻器”(Memristor)。
忆阻器是一种神奇的纳米器件,它的电阻值不是固定的,而是可以通过施加电压来编程,并且断电后也能 “记住” 这个状态。
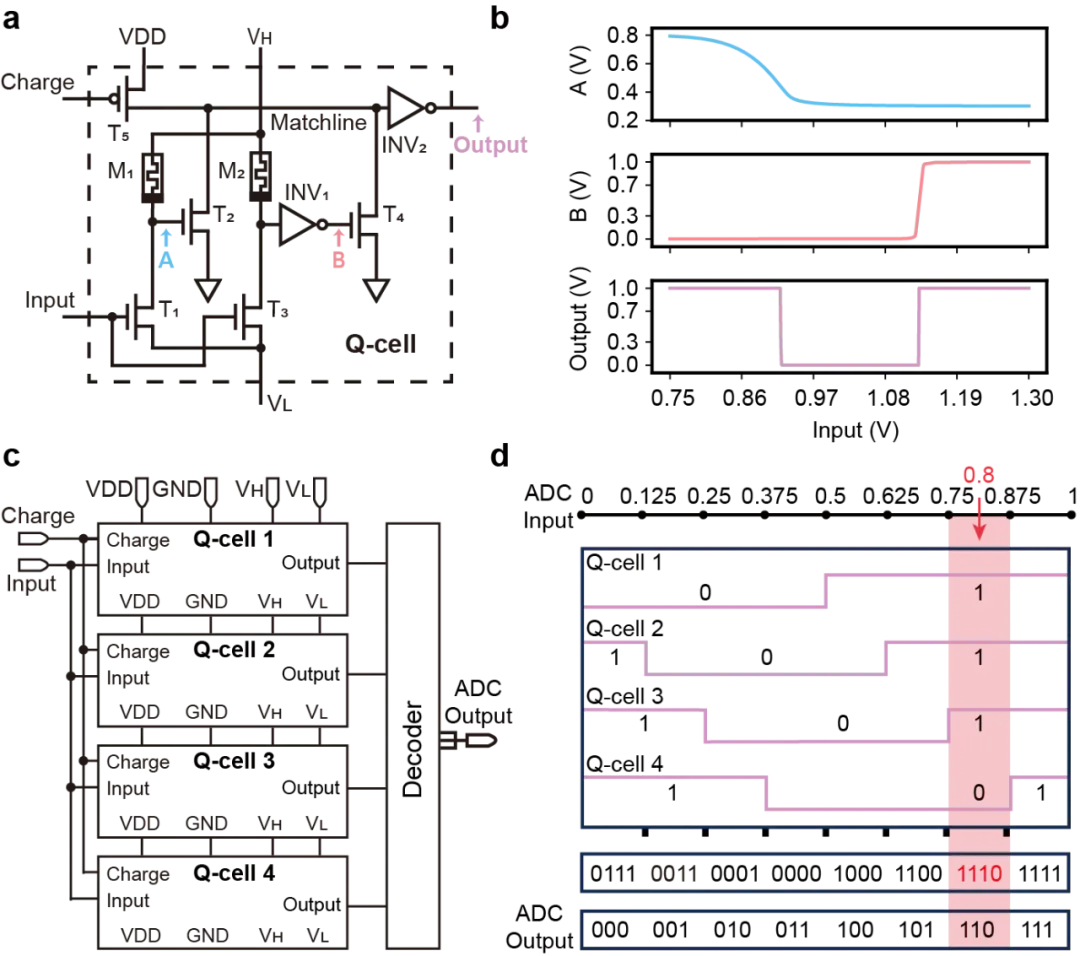
简单的融合替换难以产生突破性的作用,团队利用忆阻器设计了一种全新的 “量化单元”(Q-cell),它本质上是一个模拟内容可寻址存储器。通过改变忆阻器的电阻值,研究人员可以在硬件上随意编程设置 ADC 的量化边界。
这样一来,ADC 就能 “看菜下碟”:
研究团队使用算法(如 Lloyd-Max)先分析 AI 模型每一层输出的数据到底长什么样,然后寻找出一套最优的、非均匀的量化边界,最后再通过忆阻器把这套 “定制边界” 写入硬件。
不止是 “量体裁衣”,更是 “瘦身革命”
这种 “量体裁衣” 的自适应方法(Adaptive Quantization),效果立竿见影。
在 VGG8 网络和 CIFAR-10 数据集上,4-bit 精度下,传统均匀量化的准确率仅为 52.3%,而自适应 ADC 能飙升到 88.9%。在 5-bit 精度下,忆阻器 ADC 也达到了 89.55% 的高准确率,逼近理想性能。
在更具挑战性的 ResNet18 网络上,这种优势依然明显,相较于均匀量化,自适应方案带来了显著的精度提升。
如果只是更准,那还不够。忆阻器 ADC 的真正杀手锏,在于它为整个存算一体系统带来的 “减负” 效应。
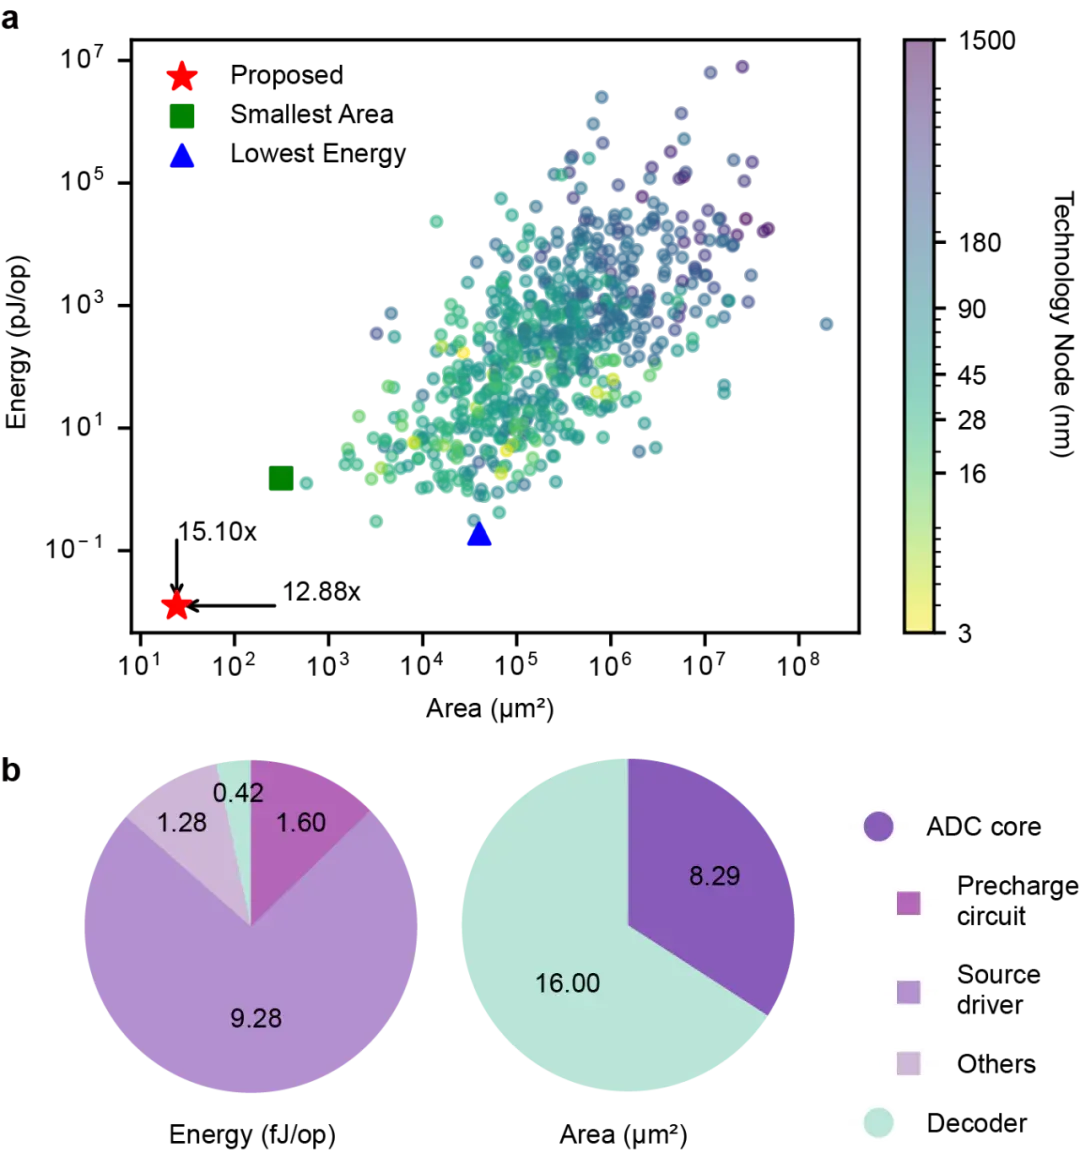
首先,ADC 本身的效率。与公开发表的 SOTA 设计相比,这款忆阻器 ADC 在 5-bit 精度下,实现了 15.1 倍 的能效提升和 12.9 倍 的面积缩减。
更关键的是系统层面。当这个高效 ADC 被集成回存算一体系统后:
在 VGG8 网络中,ADC 模块的系统能耗占比从 79.8% 猛降至 22.5%(系统总能耗降低 57.2%),面积占比也从 47.6% 降至 16.9%(系统总面积降低 30.7%)。
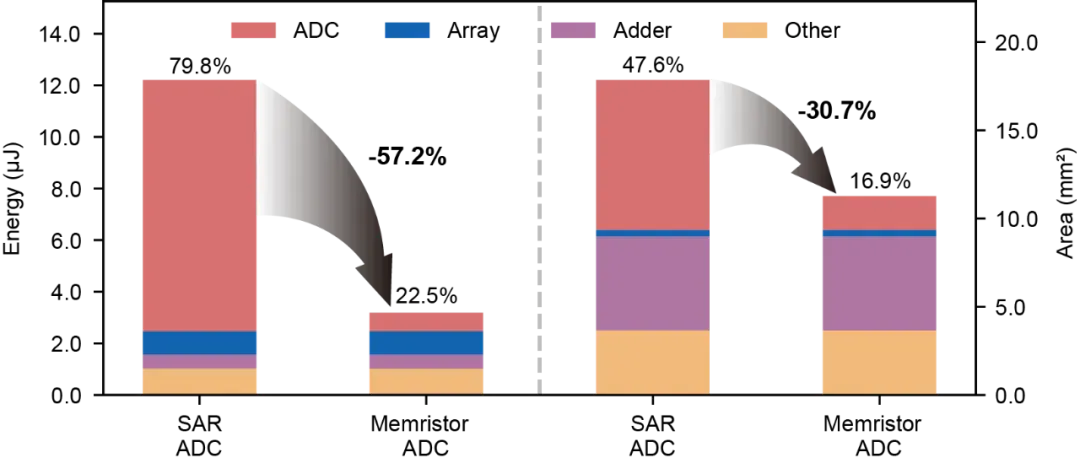
在 ResNet18 上,也实现了类似的 56.9% 的能耗和 25.1% 的面积节省。
这意味着,存算一体系统中最臃肿、最耗电的那个部件,被彻底 “驯服” 了。
这项工作为解决混合信号存算一体中的 ADC 瓶颈提供了一个全新的、硬件友好的范例,为实现高效、准确的下一代 AI 硬件铺平了道路。
文章来自于“机器之心”,作者 “洪海桥”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
中国AI突破「造芯方法论」!Agent军团接管芯片设计全流程 (opens in a new tab)
RSI(Recursive Self-Improvement,递归自我改进)正在成为人工智能领域最受瞩目的前沿方向。
Tongxin Intelligence raises seed and angel funding for AGI inference-chip design (opens in a new tab)
The BIGAI-incubated team outlines Vector, Tensor and AGI Core units, planning FPGA validation before further design, tapeout and production. The proposed architecture's commercial efficiency remains to be demonstrated.
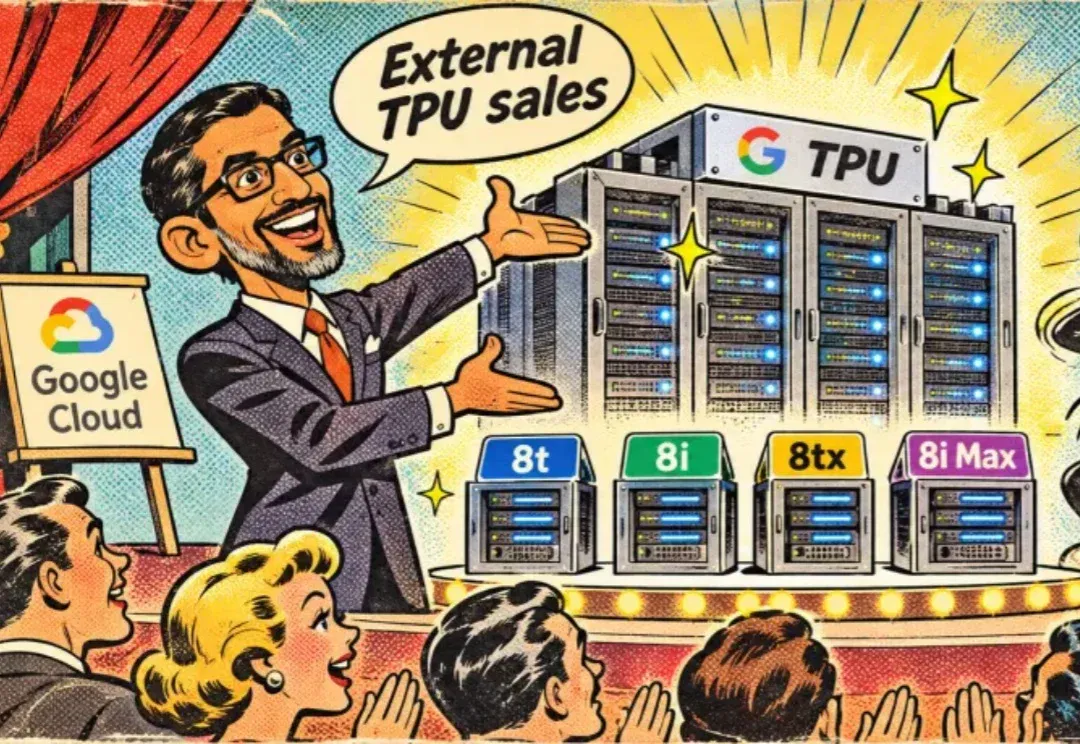
Google expands TPU system sales as software adaptation and inference economics draw attention (opens in a new tab)
QbitAI discusses complete-system deliveries, TorchTPU and agent-inference tests using filings and sources. Revenue, unfulfilled contracts and model-specific token-per-dollar comparisons are distinct measures; optimization rounds can change results.
Google adds TPU 8tx and 8i Max for confidential computing and long-context tasks (opens in a new tab)
Google describes new eighth-generation TPU variants expected in 2027. The report covers customer needs, supply constraints and external sales; its 2028 revenue figures are institutional forecasts.
从芯片互连到测控,正元量子推进千比特超导整机研发 (opens in a new tab)
正元量子宣布近亿元天使轮融资,计划推进三维封装、低温互连及集成测控。文章解释物理比特规模扩大时,连接和纠错所面临的工程问题。