
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
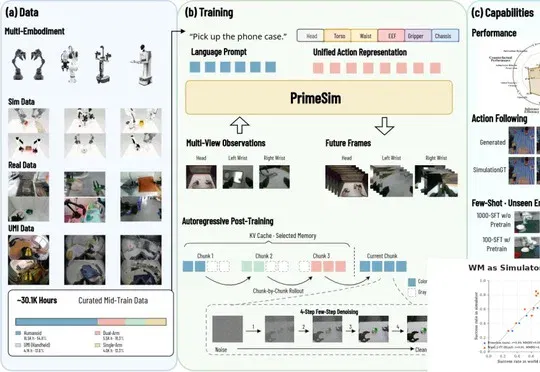
启元发布 PrimeSim,探索面向机器人操作的世界模型仿真器 (opens in a new tab)
PrimeSim 将预训练视频模型经中训练与后训练改造为动作条件仿真器,关注跨视角一致性、长程状态和生成速度。团队报告了仿真基准及在模型内训练后向传统仿真迁移的结果;这仍不同于已验证真实机器人泛化,权重与代码在报道时属于即将开放。
扰动之心完成数千万元融资,发布虚拟细胞状态推演模型 (opens in a new tab)
扰动之心(PerturbMind AI)完成清松资本领投、同杨基金及多家药企跟投的数千万元天使轮及天使+轮融资,并发布PerturbSeek旗下AlphaCell 1.0 Pro虚拟细胞状态推演模型。
苹果公布国行 Apple 智能首批功能计划,千问作为可选扩展接入 (opens in a new tab)
10月31日苹果中国官网发布新闻稿《Apple 智能即将登陆中国》,宣布国行 Apple 智能首批核心功能11月4日起随 iOS 开发者 Beta 版开放测试,12月随 iOS 27.3 正式版推送,并在 Siri、写作工具和视觉智能接入阿里千问,Siri AI 等下一代功能暂不包含在内。
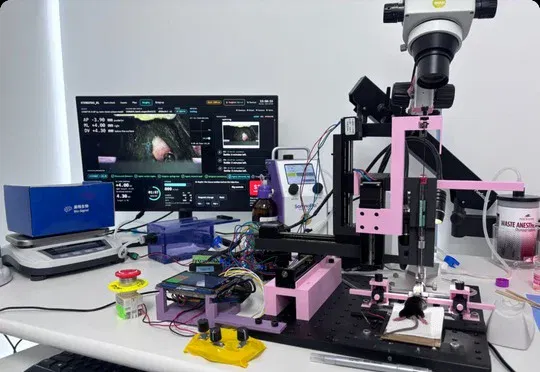
Exin 探索人类监督下的 AI 实验操作,动物研究暴露控制边界 (opens in a new tab)
报道称 Exin Therapeutics 将 AI Agent 接入实验平台,尝试让文献分析、方案选择与实验反馈形成闭环。活鼠实验仍依赖人类外科人员、兽医值守、人工关卡和物理急停;模型遇到校准问题拒绝动作,也说明部分自动化与安全约束需要一起评估,而非已实现无人手术。
速递|超进化智能完成数亿元天使轮融资,以万卡训练经验打造研究基础模型 (opens in a new tab)
超进化智能(HyperVolve)完成由蓝驰创投领投的数亿元人民币天使轮融资,将以RSI为关键技术路径研发具备元研究能力的研究基础模型,资金主要用于算力与训练基础设施建设及核心研发团队扩充。
今日宜休发布智能戒指与温控床笠,尝试连接睡眠监测和环境调节 (opens in a new tab)
今日宜休介绍 ISHO Ring 与 iFlow,通过生理信号、环境信息和分区温控连接日间状态与夜间体验。报道涵盖端侧模型、传感器和产品计划;监测准确性与改善睡眠的说法来自厂商披露,不能把消费设备的估计分数直接当成医学诊断或保证疗效。
报道称 Anthropic 是 SpaceX 大客户,算力合作与模型竞争交织 (opens in a new tab)
报道结合财报、合同披露及知情人士信息,讨论 Anthropic 租用 SpaceX 算力的规模与扩容安排。算力合作与双方模型竞争同时存在,但财务关系本身不能证明为何公开表态有所取舍;“因担心断电而不指责蒸馏”是作者推断,不是已证实的动机。
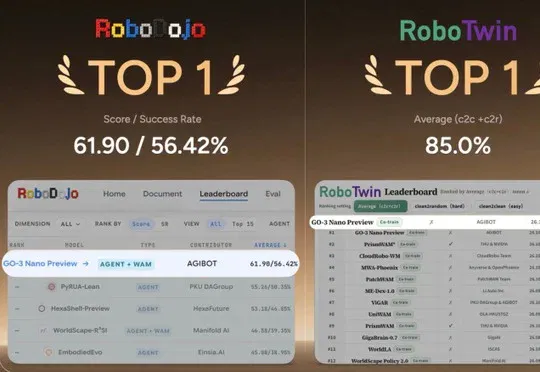
智元发布 GO-3 Preview、WITA-OMNI 与灵渠 OS 进展,探索有效工时衡量 (opens in a new tab)
智元创新日介绍作业、交互和运动智能的模型与硬件进展,并提出 Worken,尝试连接部署数量、自主工作时间与产出效率。报道还梳理灵渠 OS 和机器人本体计划;榜单、产线及零售数据采用厂商披露口径,未来开源与区域上线需要另看实际进度。
Addy Osmani 谈 Claude 提示词:用明确目标和验收替代过度指导 (opens in a new tab)
Claude Code团队成员Addy Osmani建议,随着模型能力提升,用户应精简提示词,以明确任务和验收标准让Claude自主推进,并定期清理旧提示、按任务规模使用子智能体与云端会话,同时加强结果核验。
ScienceVision 用250道三维科学题评测模型,观察工具并不自动带来理解 (opens in a new tab)
ScienceVision 在五个科学领域比较原始三维数据、交互检视工具与固定二维视图三种设置。最佳参评配置的平均得分为 0.53,包含部分得分,不能当成答对率;研究显示访问更多工具与真正提取有效证据之间仍有距离,结论限于这套任务和评分规则。
腾讯给老板们搞了个Agent工厂 (opens in a new tab)
腾讯云智能体开发平台ADP在2026腾讯全球数字生态大会上升级,强化服务Agent交付、AgentPortal 2.0统一管理及与WorkBuddy双向打通,帮助企业将智能体接入核心系统与业务流程。
蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD (opens in a new tab)
清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
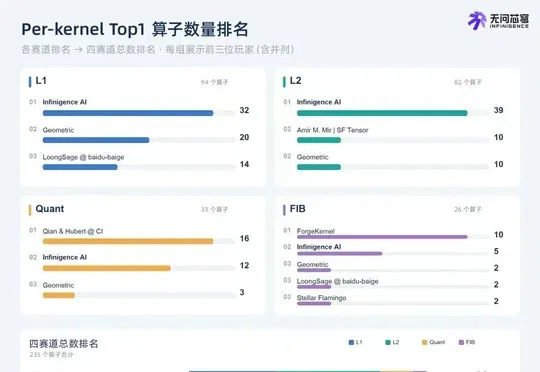
无问芯穹的算子优化 Agent:共享经验之外,资源调度也影响效率 (opens in a new tab)
这篇技术报道进一步讨论算子优化 Agent 如何利用隔离评测、Skills 和共享记忆迭代,并呈现 GPU 排队与工作流演化的观察:个体为减少等待而延长占用,可能降低整体效率。文章将资源调度与有效反馈速度联系起来,局部优化仍需端到端验证才能反哺基础设施。
当机器人开始向同伴学习:96台真机探索具身智能的规模化成长 (opens in a new tab)
CEL 探索让机器人共享成功经验,由失败场景引导检索与策略微调,并用容错异步系统支撑集群持续运行。团队在 96 台机器人原型中观察规模收益,再用未参与训练的同型号机器人测试;高成功率来自五项指定任务,仍保留初始化示范与人类结果判定。
奥特曼谈内部模型测试、智能体团队与自动化基础设施愿景 (opens in a new tab)
在播客访谈中,Sam Altman 描述内部模型处理研究问题的经历,并讨论如何组织智能体团队、利用 AI 改进研发和降低算力成本。关于自我复制数据中心的论述属于未来构想;访谈中的兴奋与预测不能替代公开的数学证明、独立审查或已经建成的工业系统。
OpenDS-World 评测:复杂开放网络搜索中,最佳参评模型准确率为39% (opens in a new tab)
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
离开人类,AI能独自活下去么?从图灵测试到「鲁滨逊测试」 (opens in a new tab)
刘锋博士研究团队基于广义智能体理论提出仍属初步设想的AI「鲁滨逊测试」,通过分阶段撤离人类维护和任务指令,观察AI能否自主维持、探索资源及形成源自自身的控制。
OpenAI 更新 Model Spec,明确自主范围、可纠正性与上下文边界 (opens in a new tab)
OpenAI发布新版Model Spec,以Root级规则要求模型在限定自主范围内行动、接受人类监督纠正和关停,并禁止越权、欺骗及自我保存,同时明确ChatGPT和API上的模型尚未完全符合新规范。
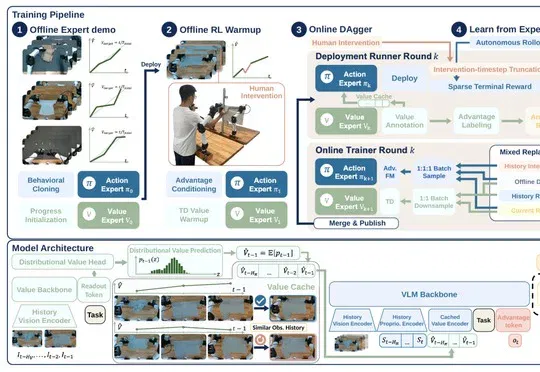
Value as Memory:把近期价值预测作为机器人任务进度记忆 (opens in a new tab)
VaM 将近期价值预测缓存输入动作策略,帮助机器人区分视觉相似却进度不同的状态,再通过离线预热与在线真机强化学习更新策略。团队在纸盒装配、衣物折叠等任务上报告恢复与成功率收益,其中四小时稳定运行来自纸盒装配设置,不代表所有长期操作任务。
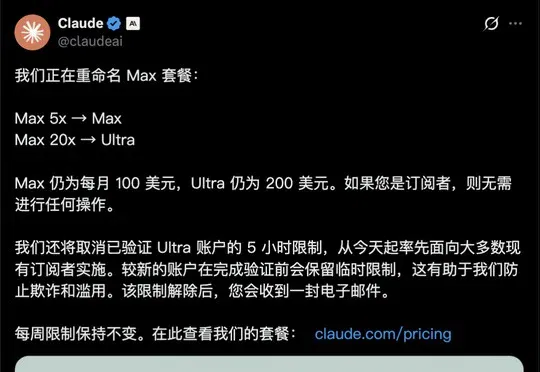
Claude Ultra 调整已认证账户的五小时限制,每周总额度仍保留 (opens in a new tab)
Anthropic将Claude原Max 20x套餐更名为Ultra,月费维持200美元,并对已认证Ultra账户取消5小时用量限制,但每周总限额不变,Max仍保留5小时上限。