
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
DeepSeek Harness 推出预发布更新,扩展代码审查与任务管理 (opens in a new tab)
v0.2.2-alpha.3预发布版本加入实验性变更请求与工作树入口,扩展宿主级任务管理、SDK和插件能力,并改善手机浏览器体验。报道时尚无对应桌面安装包;服务中断与软件更新同时发生,不证明存在因果关联或新模型将发布。
OpenAI 发布 LifeVal,以个性化生活任务评估智能体 (opens in a new tab)
LifeVal围绕148类个人助理任务,结合用户背景与可验证环境评估智能体。报告基于消费者支付意愿推算潜在价值,不能把1.7万亿美元写成基准售价或已实现收入,也不能据此宣称AGI已达到通用标准或接管人类生活。
网友追踪 OpenAI 未公开模型标识,其与下一代 GPT 的关系仍待确认 (opens in a new tab)
报道汇总网友观察到的API标识、第三方演示和OpenAI硬件工程评测中的未公开模型。模型标签、双虚拟机分工、参数规模及与GPT-6.2的对应关系均不能由这些线索确认;BenchCAD成绩只说明所报告的特定评测表现。
天数智芯展示 TY1200 本地仿真训练,预告下一代 TY2000 (opens in a new tab)
天数智芯开放日演示TY1200在本地进行机器鸭环境构建、策略训练和仿真,并公布若干量化模型的吞吐对比。当前设备标称300 TOPS,600T对应预告中的TY2000;不同精度、模型及批量条件下的算力不能直接混比。
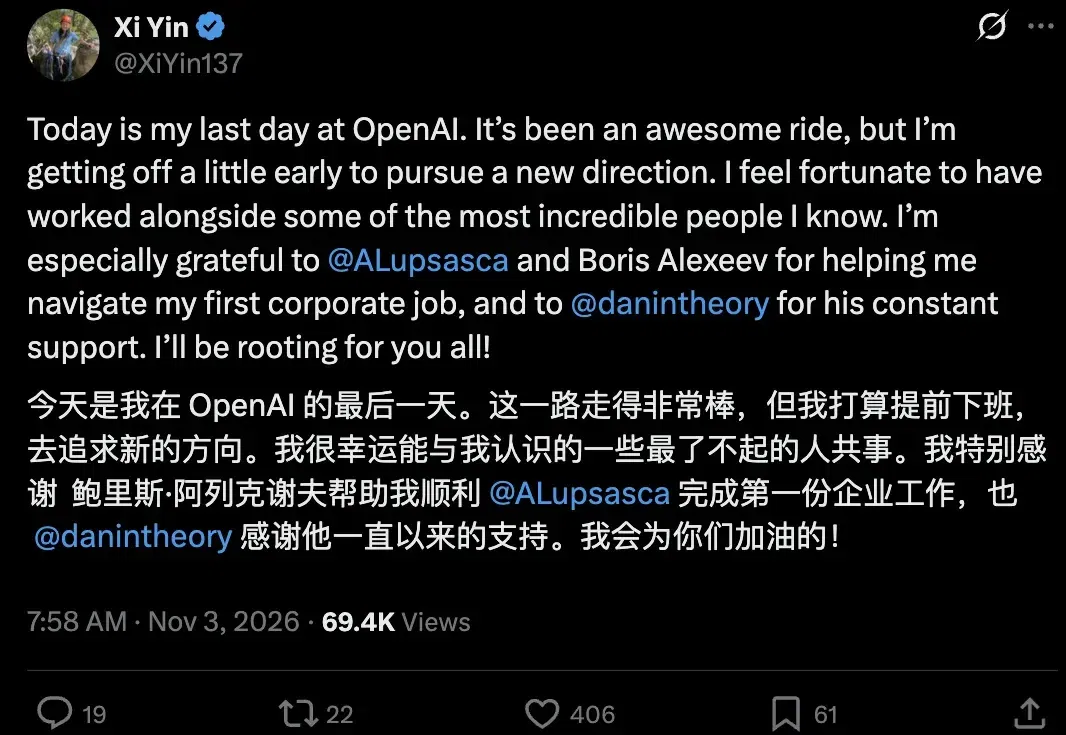
物理学家尹希宣布离开 OpenAI,下一步方向尚未披露 (opens in a new tab)
报道援引尹希告别帖,称其结束在OpenAI的首份企业工作,准备探索新方向,并回顾其物理研究及AI使用观点。离职去向未获本人披露,网友关于新公司的猜测不应作为任职消息;研究提速数字属于个人经历。
作者体验 Grok Bot:岗位分工、独立记忆与云端协作 (opens in a new tab)
硅星人Pro体验Grok Bot的多角色协作:不同Bot维护各自的背景和记忆,通过委派与群聊推进任务,并使用独立云端电脑。文章讨论省去模型选择的便利和透明度取舍,增长及留存说法保留报道口径,不能等同全面优于同类产品。
Liber-0 发布:团队报告220万小时预训练数据与零样本机器人测试 (opens in a new tab)
LiberAI介绍Liber-0及人类视频、动作手套和本体表征的训练路线。公司报告60项无目标任务机器人示范的测试中整体成功率36%、长程组10.5%;奶茶制作则经过少量后训练,两类演示不能混为完全零样本能力。
研究员称 OpenAI 恢复误封账号,逆向工程使用边界引发讨论 (opens in a new tab)
报道援引安全研究员分享的账号恢复邮件,以及员工对逆向任务误拦截的回应。账号恢复属于个案,不能等同取消使用政策或允许任何逆向活动;文中关于Anthropic拦截的讨论也应区分用户反馈与正式规则。
Z Potentials|北大张牧涵:从图神经网络开拓者到RSI,让模型学会更新自己 (opens in a new tab)
无涯智远创始人张牧涵在访谈中介绍参数内学习:先训练超网络,再以前向传播生成基座更新,探索把新经历持久写入参数。受访者也谈到长期稳定性、遗忘及大规模写入仍待研究;秒级写入不等于超网络训练没有成本。
Realtime-Bench 评测12种模型:实时任务中,思考更久未必更好 (opens in a new tab)
Realtime-Bench 用30项网页任务和20项游戏任务,对比真实时间、推理时暂停及按Token推进三种时钟。受测模型在时限下明显失分;GPT-6 Astra最高单次任务成功率44%,三次重复均成功的Pass³为36%,两者不能混用。
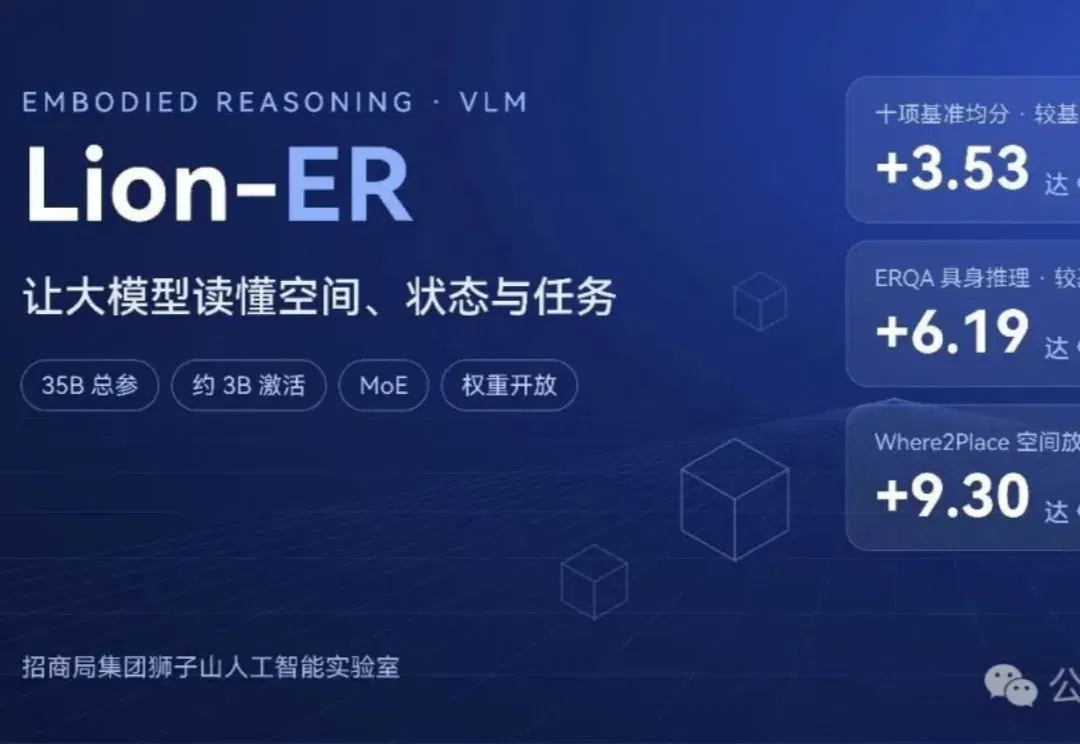
狮子山实验室发布 Lion-ER-35B-A3B,探索能力牵引的具身数据训练 (opens in a new tab)
招商局狮子山实验室围绕能力蓝图、证据核验和评测反馈构造约31.2万条监督样本,训练总参数35B、激活约3B的具身推理模型。团队按avg@4口径报告十项基准均较基座提高,尚需结合实际机器人任务进一步验证。
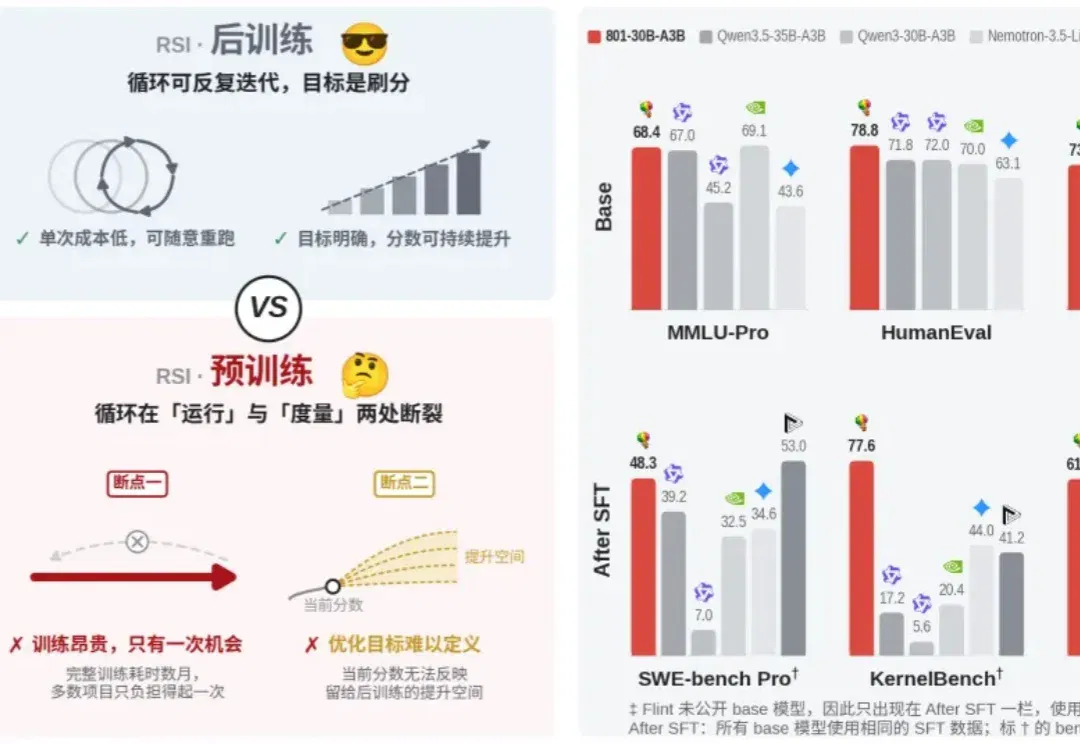
801-30B 开源:团队探索把 RSI 用于基座模型预训练 (opens in a new tab)
上海创智学院与新序智能发布801-30B基座、技术报告及轻量SFT数据,介绍通过调试、潜力评估和共享经验改进预训练流程。报告分别比较base、同数据微调及完整后训练模型;全球仅两家等表述属于团队观察范围。
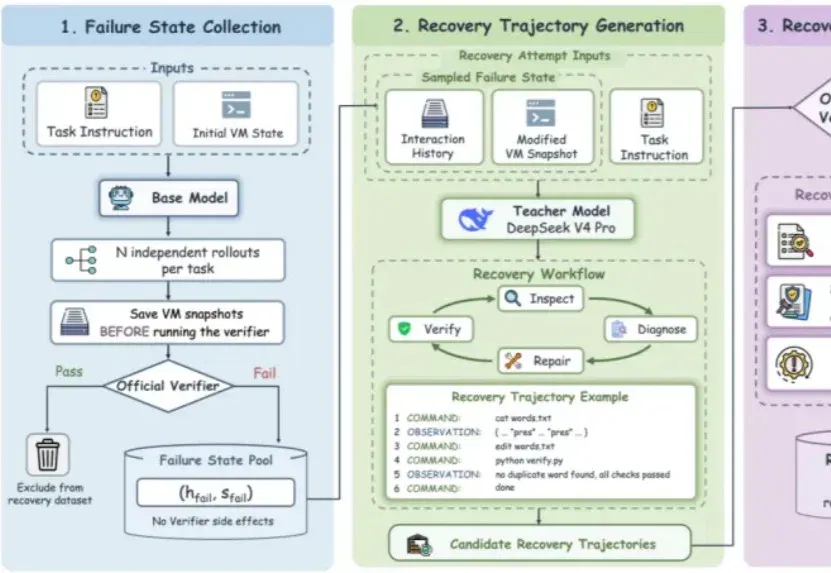
让Code Agent从自己的错误中进化:ReTerm探索失败驱动的RSI (opens in a new tab)
ReTerm 让终端智能体保留自身失败后的环境,尝试多种恢复办法,再用验证结果训练策略。研究发布约万条恢复轨迹,并报告9B模型在终端与软件工程基准上的提升;多数错误类别的恢复率仍不高,改进有明确边界。
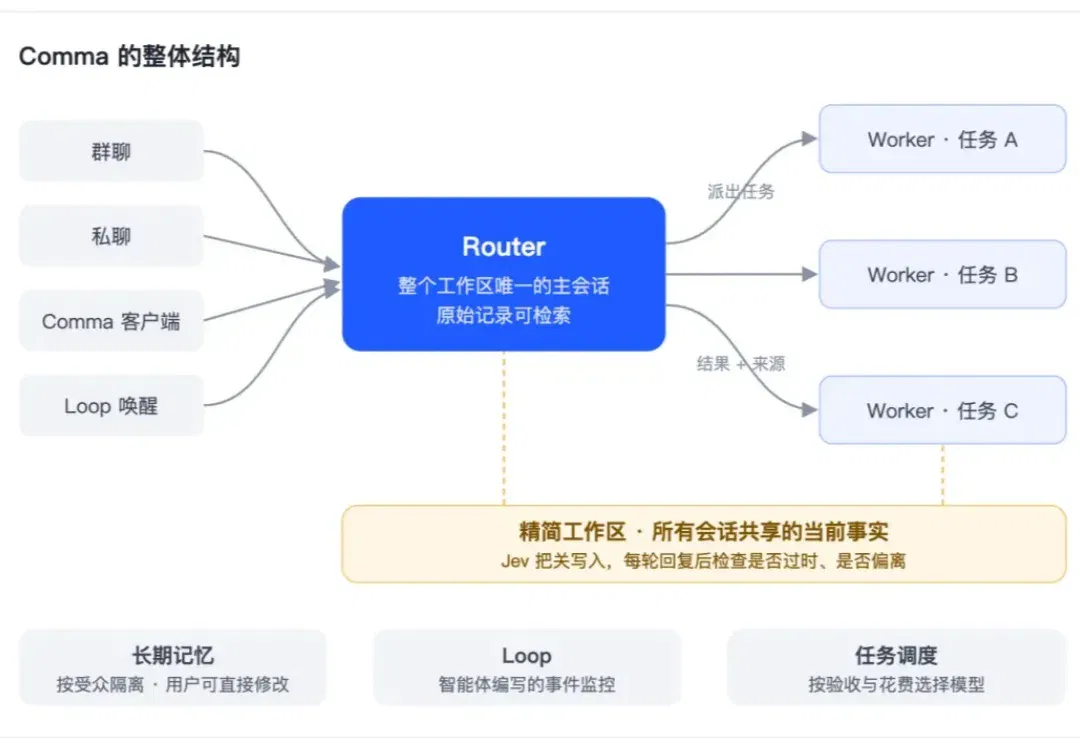
Comma 介绍常驻型 Agent 的主会话、长期记忆与任务调度 (opens in a new tab)
Comma 用常驻Router汇总请求,把具体工作委派给Worker,并通过共享事实清单、按受众划分的记忆与事件监控维持上下文。团队还介绍依据人工验收和费用调整模型分工;这套工程设计不等于记忆与权限判断必然无误。
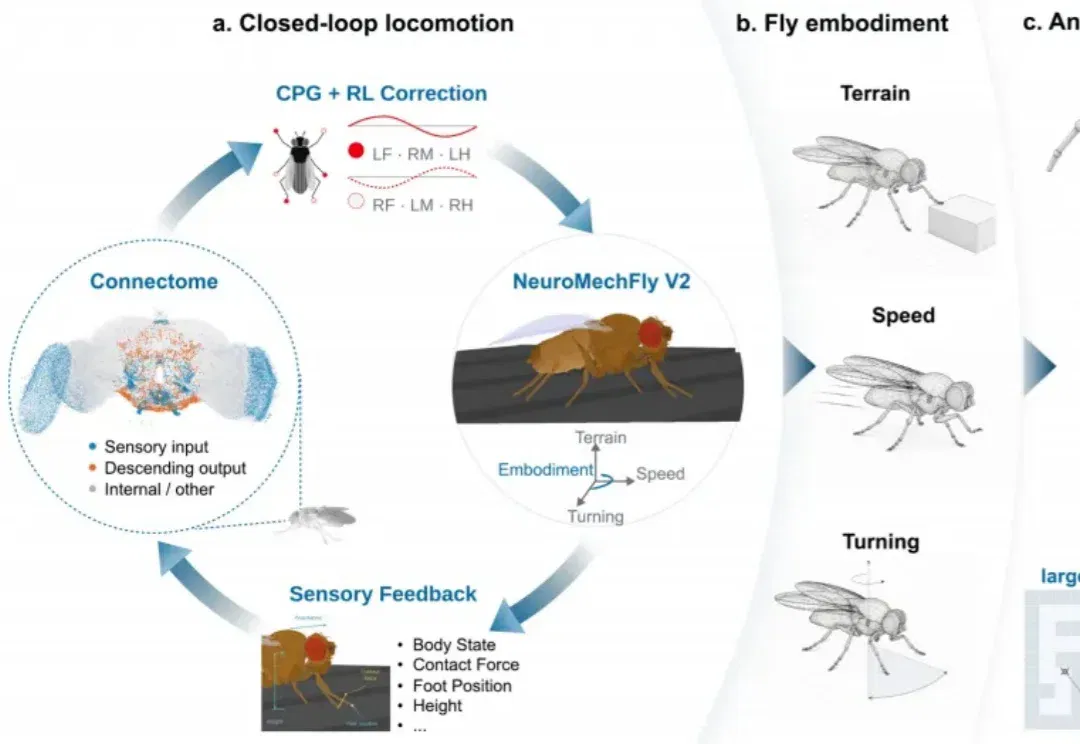
机器人抄果蝇“作业”?清华团队用果蝇大脑“接线图”,让具身智能学会了自适应 (opens in a new tab)
清华团队把成年果蝇连接组作为固定网络核心,在仿真身体中训练感觉与运动接口。研究比较跨障碍、转向、变速及不同足数身体的控制,报告相较MLP等对照的适应收益;这些结果尚不能等同真机部署效果。
Anthropic 展示 Linux 内核漏洞利用链,修复状态需按发行版核对 (opens in a new tab)
Anthropic介绍内部模型把已知Linux内核漏洞CVE-2026-98432串成远程利用链的受控实验。漏洞已获上游修复,Red Hat部分产品也已发布补丁;MPTCP是该演示的条件,不能据此认定关闭MPTCP即可消除底层漏洞。
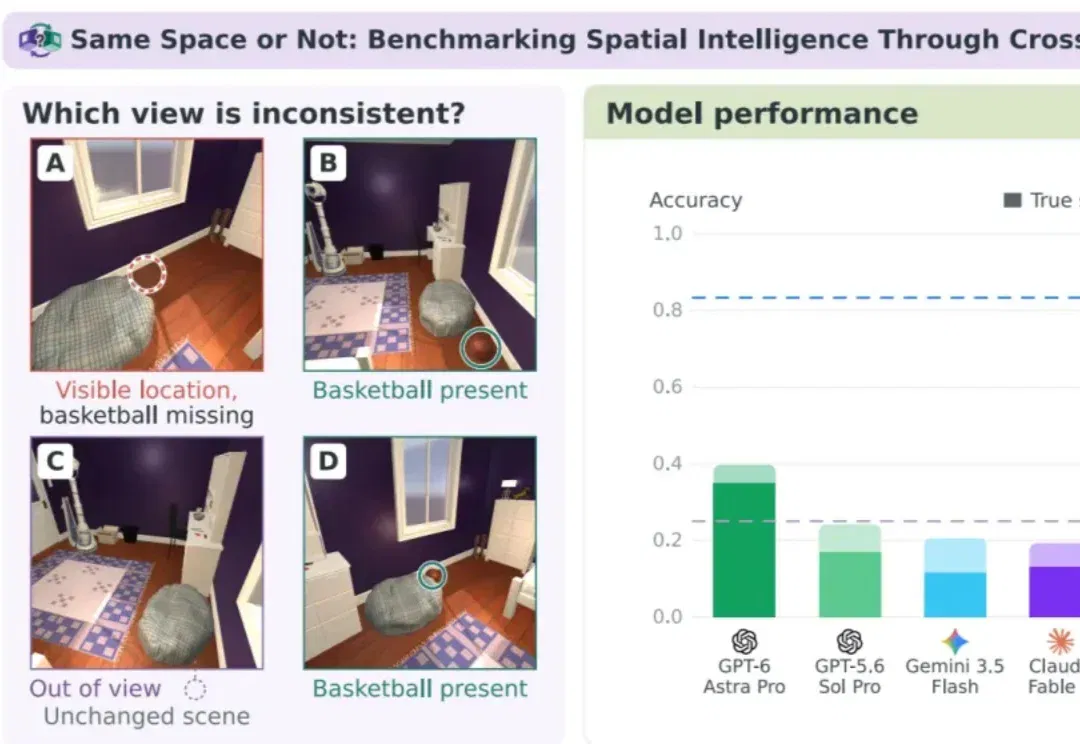
普林斯顿AI Lab出题,「空间智能」大考:人类83.3%,大模型最高39.7%! (opens in a new tab)
普林斯顿AI Lab等团队提出SSoN:用四张室内图像判断哪张违反同一场景的空间一致性。1000题上,人类准确率83.3%,六个受测VLM最高39.7%;解释核验、相机信息干预和定向微调进一步揭示跨视角推理的短板。
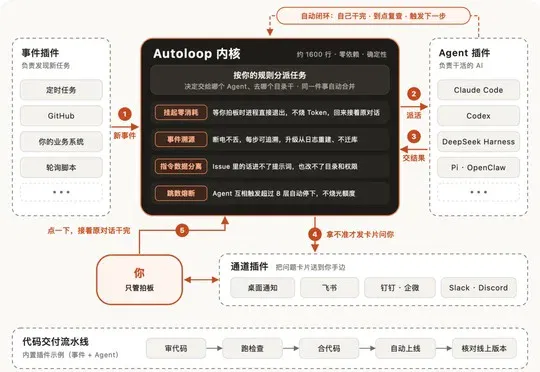
卡兹克开源 Agent-Autoloop:把个人自动化流程拆成插件 (opens in a new tab)
作者将使用一年的智能体自动化流程重写为 Agent-Autoloop,介绍约1600行内核,以及事件、执行器、通知和交付插件。1.0.0版本包含等待恢复、事件账本和调用层数限制;性能及实际案例为作者测试,项目仍可能存在缺陷。
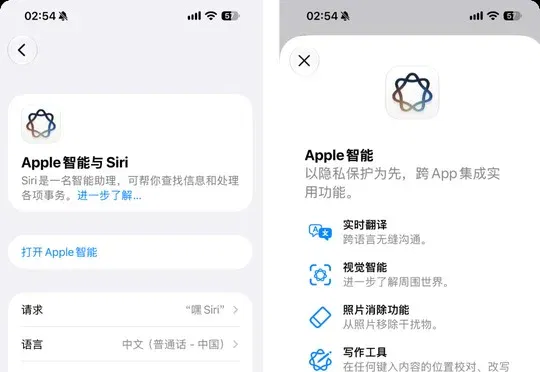
APPSO 体验国行 Apple 智能测试版:写作、视觉与 Siri 的进展和局限 (opens in a new tab)
APPSO 记录开发者Beta版的写作、视觉识别、照片消除及Siri体验,并介绍与千问衔接的部分任务。测试也出现闪退、发热和功能入口缺失;更强的个人情境理解与跨应用执行仍待推出,测试体验不等于正式版承诺。
商汤新模型实测:8分钟速读582页招股书,“卡”在了做PPT上 (opens in a new tab)
《智东西》在商汤小浣熊桌面端体验 SenseNova 6.8 Flash:两份合计582页招股书的对比与看板任务耗时8分21秒,8页PPT任务则用64分钟。个案反映长文检索和排版流程的差异,环境与执行框架也会影响耗时。