
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
MiniMax H3 扩展开源生态:视频增强、蒸馏与商业授权 (opens in a new tab)
据报道,英伟达相关团队及Pika基于MiniMax H3探索高分辨率再生成和少步推理。文章同时分析其社区许可与单独商业授权路径;开放权重并不等于在所有地区、所有商业规模下均可免费使用。
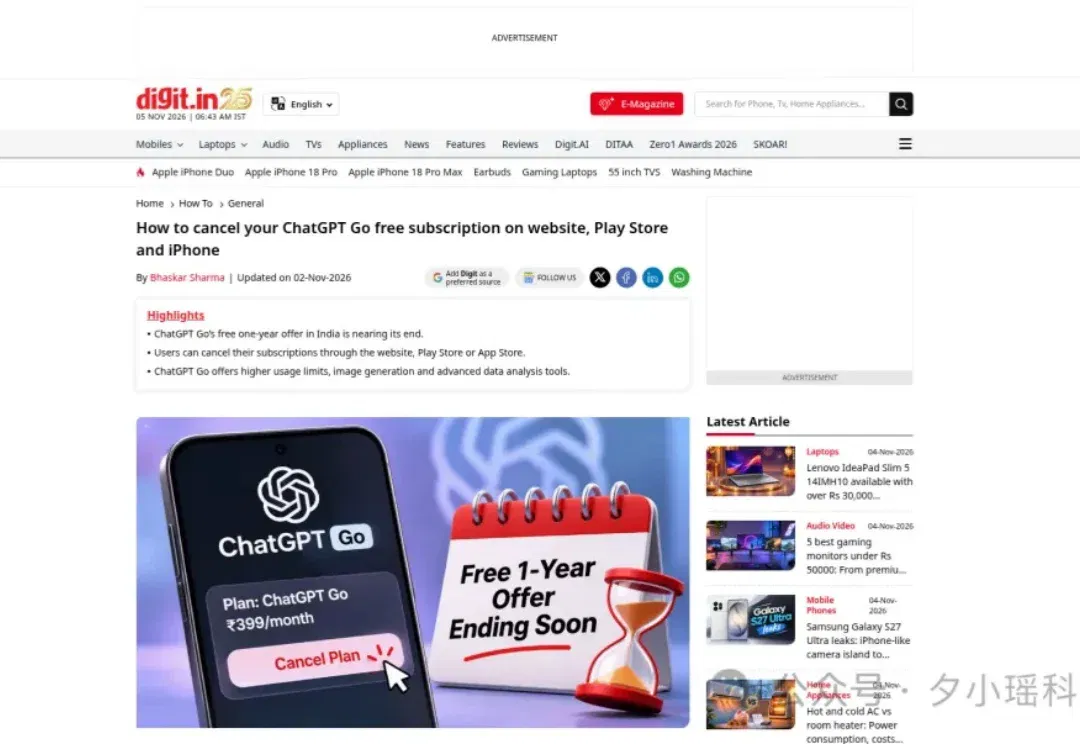
印度成 ChatGPT 最大周活市场后,免费期结束考验付费留存 (opens in a new tab)
报道援引OpenAI印度负责人称,印度按周活跃用户已成为ChatGPT最大市场。随着一年期Go优惠到期,文章讨论用户留存、企业服务与UPI支付探索;退订教程的出现不能等同于已证实的大规模流失。
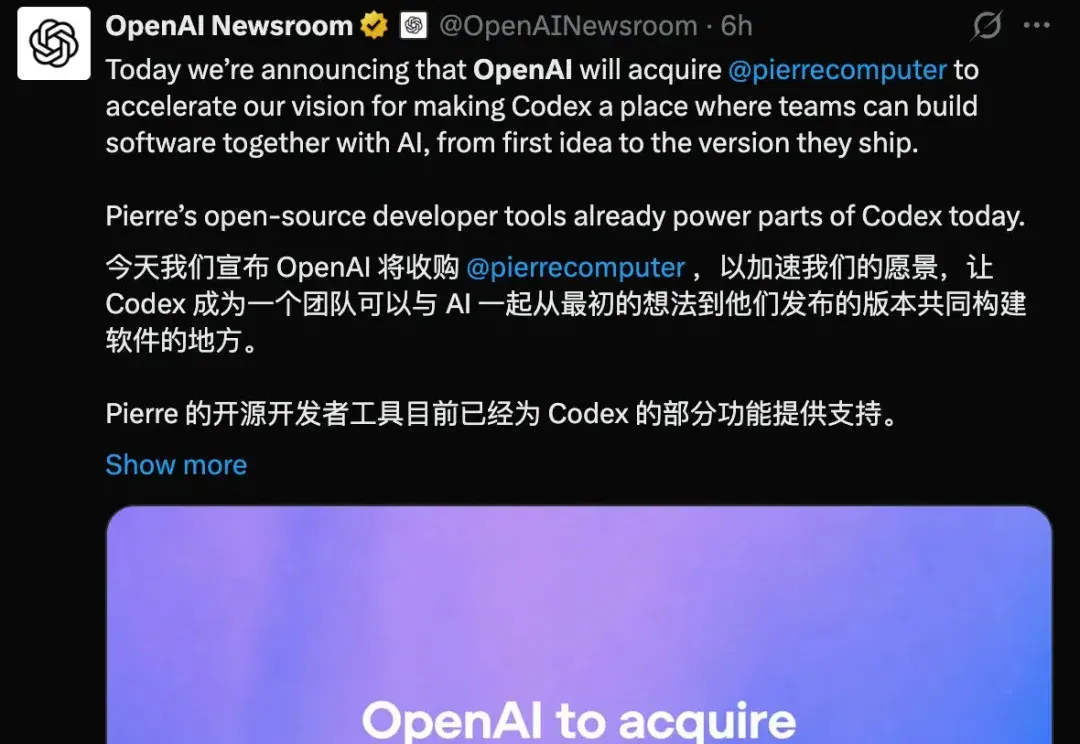
OpenAI 拟收购 Pierre,推进 Codex 的代码托管与审查协作 (opens in a new tab)
OpenAI宣布拟收购Pierre Computer Company,后者提供Code Storage及Trees、Diffs等开发工具。公告称开源项目继续开放、现有客户继续可用;交易仍需满足交割条件,未来整合形态与时间尚待公布。
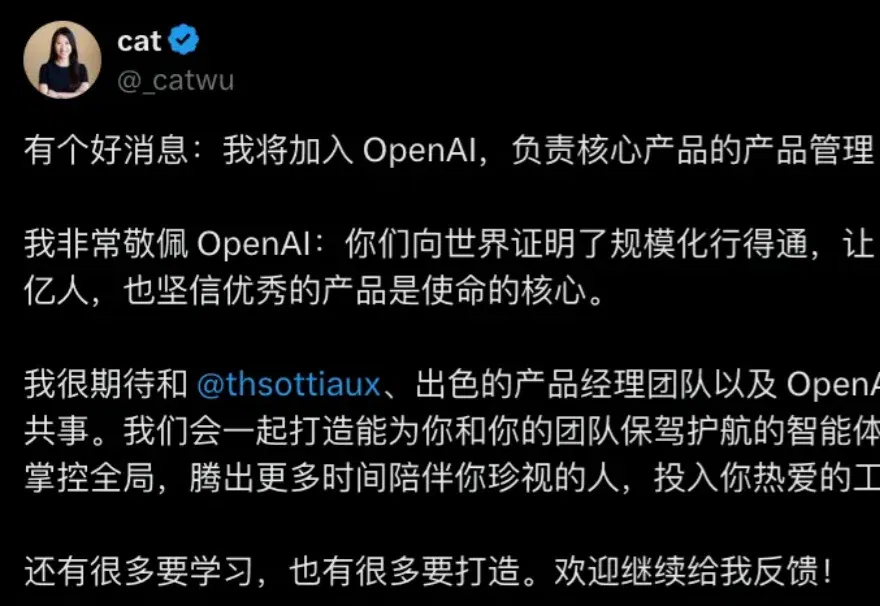
前 Claude Code 产品负责人 Cat Wu 宣布加入 OpenAI (opens in a new tab)
据报道,Cat Wu离开Anthropic后宣布加入OpenAI,参与核心产品管理。文章回顾她在Claude Code及Cowork的工作,并讨论团队人员流动;Anthropic公司收入增长不能全部归于单一产品,也不能从离职直接推断内部矛盾。
作者体验 LobeHub 多 Agent 协作:任务拆分、跨设备执行与验收 (opens in a new tab)
文章结合架构介绍与个人测试,讨论LobeHub如何用主管及执行Agent、独立任务上下文和验收报告组织研发。案例仍出现人工干预,能否持续运行也取决于云端与执行设备状态,单次对比不能代表所有产品配置。
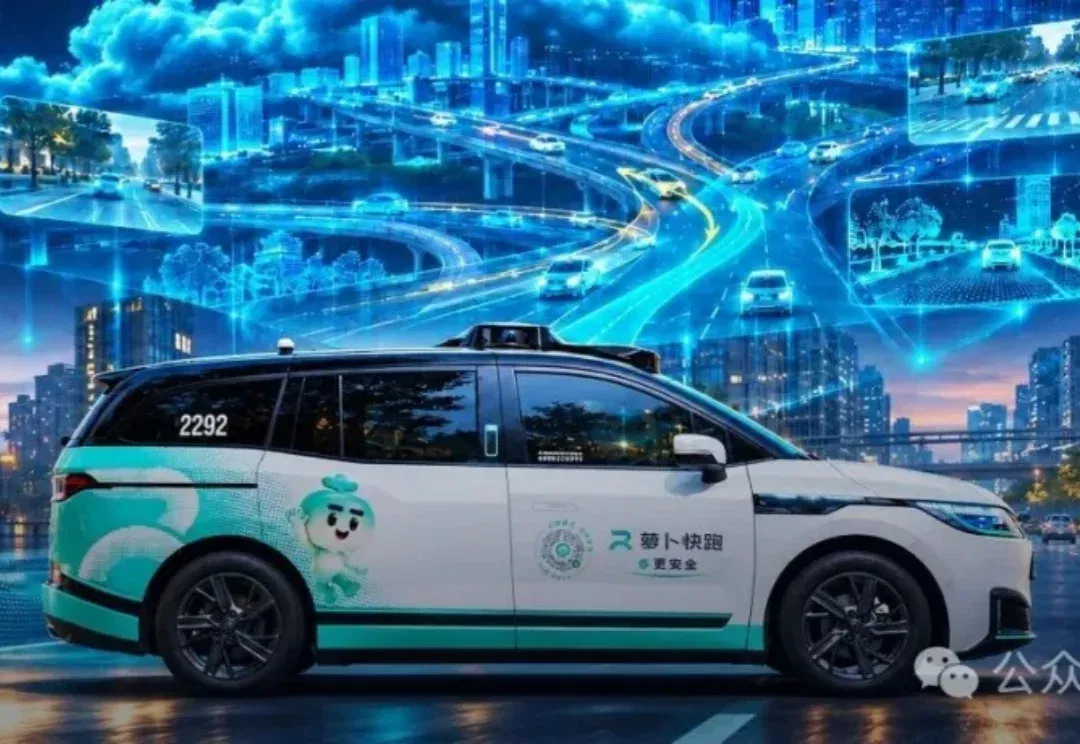
百度发布 ApolloWorld,探索多智能体交互的自动驾驶闭环仿真 (opens in a new tab)
百度介绍ApolloWorld世界模型,面向L4驾驶训练同步生成相机画面与点云,并模拟交通参与者对车辆动作的反应。文中日行十万公里及33毫秒响应属于公司披露的仿真指标,不能直接替代真实路测或证明通用智能已经实现。
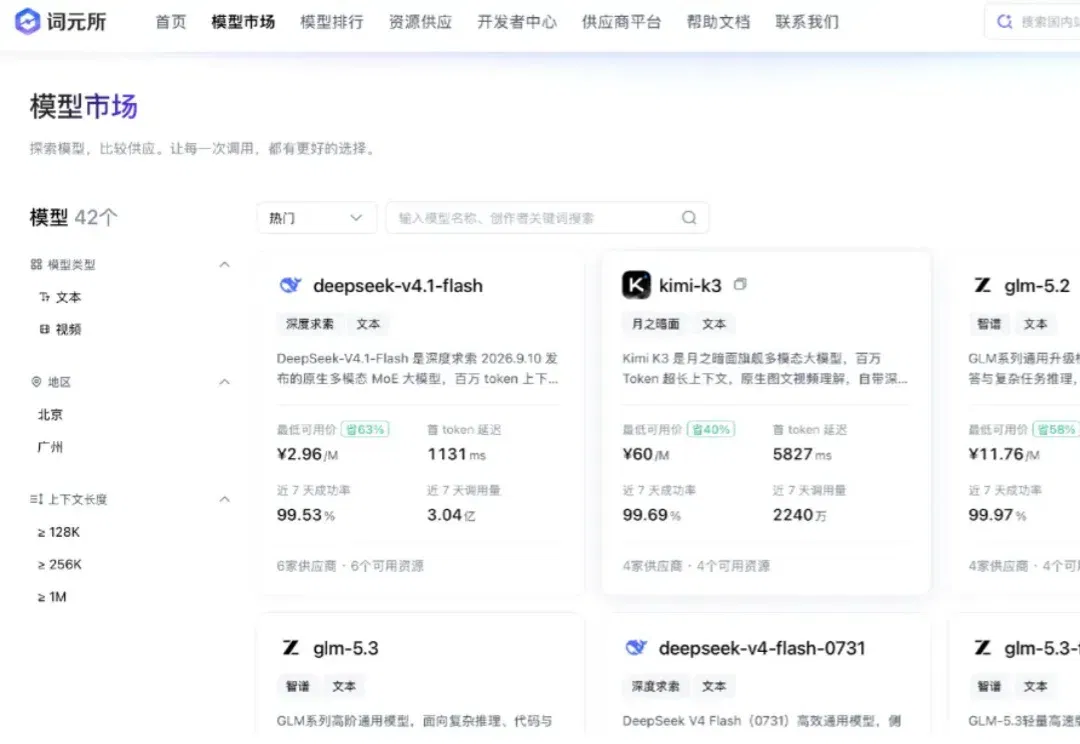
百度上线模型服务平台“词元所”,聚合42款模型与多家供应商 (opens in a new tab)
据《读佳》报道,百度推出词元所,提供多模型选型、统一API调用及供应商资源撮合。平台展示报价、首Token延迟、吞吐和成功率等指标;模型数量、资源数量与榜单热度采用不同统计口径,使用前仍需核对服务质量。
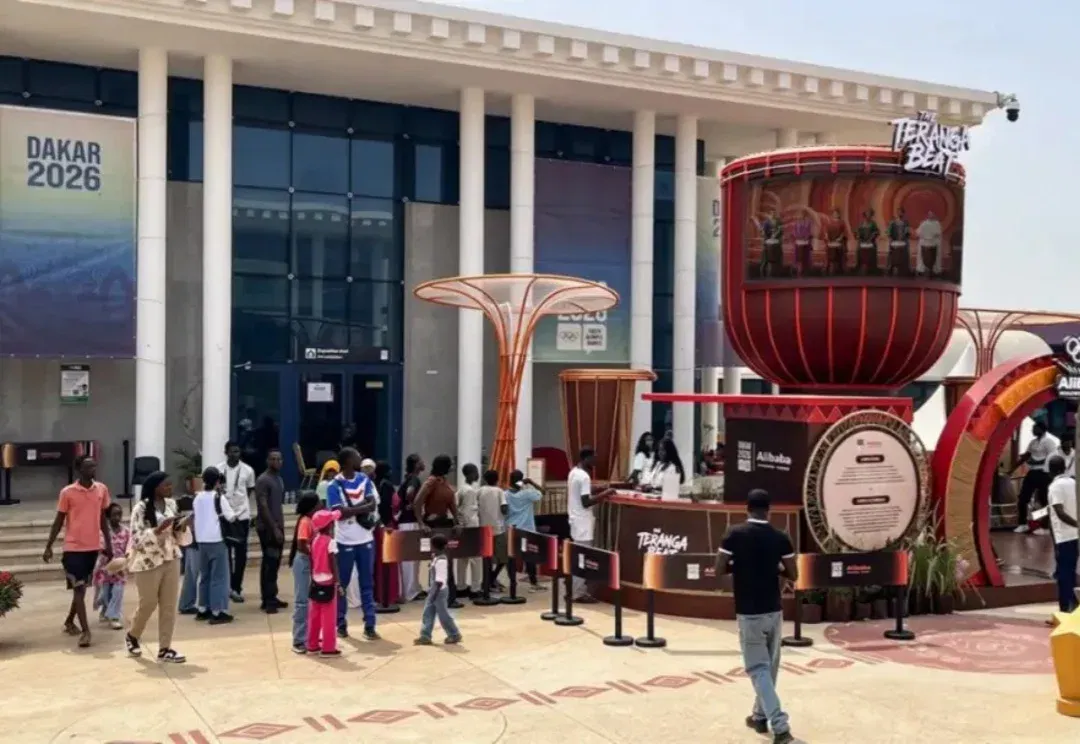
阿里云参与达喀尔青奥会:从AI开幕式到云端赛事系统 (opens in a new tab)
报道介绍阿里云在2026达喀尔青年奥运会中的云服务与AI应用,包括千问互动、视频生成、票务及赛事数据系统。公司还计划赛后交接部分云端能力;演示和系统规模为报道所述,不等于已完成全部赛后交付。
Anthropic IPO传闻与财务数据:收入、经营损益和算力承诺须区分 (opens in a new tab)
Anthropic于11月2日提交的S-1/A披露第三季度收入约169.56亿美元、GAAP经营亏损5.67亿美元,以及跨多年的采购与租赁承诺。申报文件仍可访问不能单独证明上市进度,估值传闻也不等于已发生的市值损失。
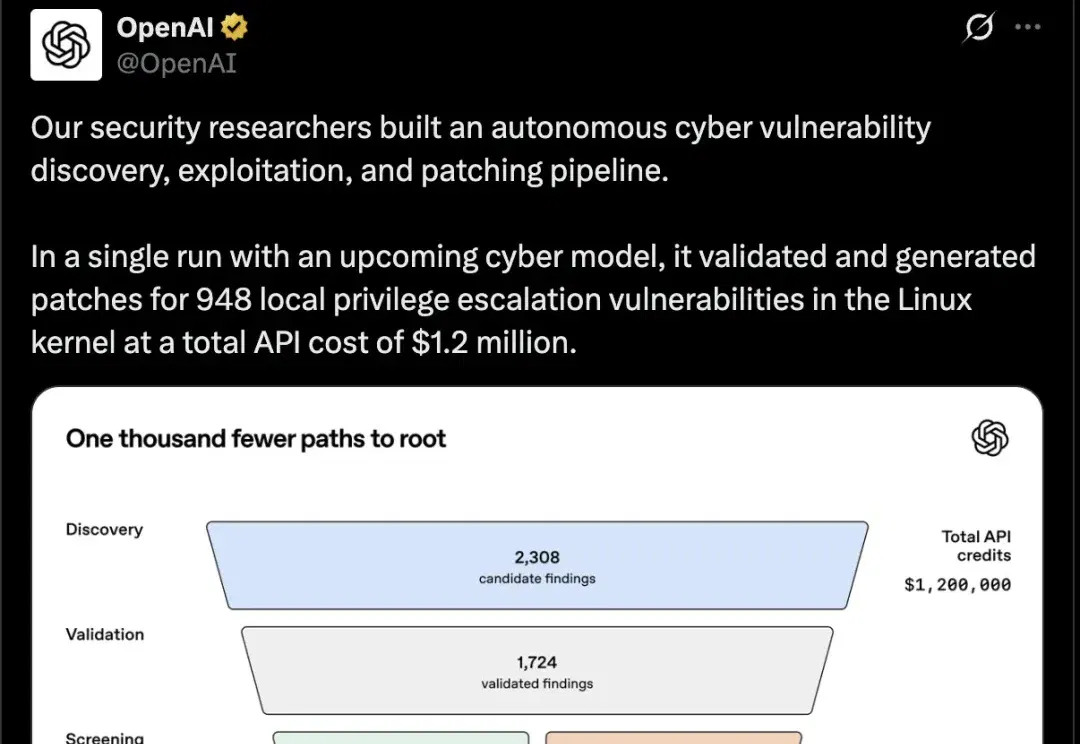
OpenAI 披露 Linux 漏洞研究:验证948项本地提权,API成本约120万美元 (opens in a new tab)
OpenAI称其在受控Linux环境中复现1724项漏洞,并为948项独立本地提权问题生成利用证据及候选补丁,总API成本约121万美元。研究包括人工复核,结果不能理解为所有Linux设备均受影响,候选补丁也须经维护者审查。
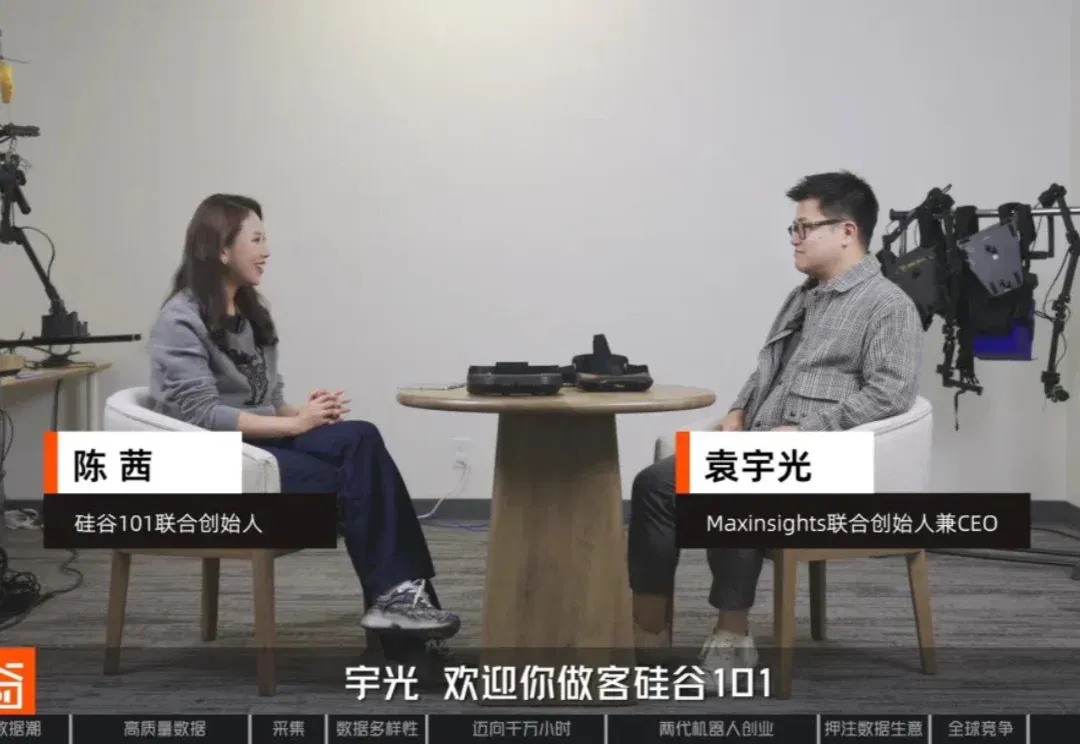
对话 Maxinsights:机器人第一视角数据如何采集、管理与交付 (opens in a new tab)
Maxinsights创始人介绍第一视角数据的采集网络、质量控制及交付流程,并称2026年预计年度经常性收入为2.5亿美元。该预测与早期实际年收入不是同一口径,文中约4000名采集者及200万小时数据等规模为公司自述。
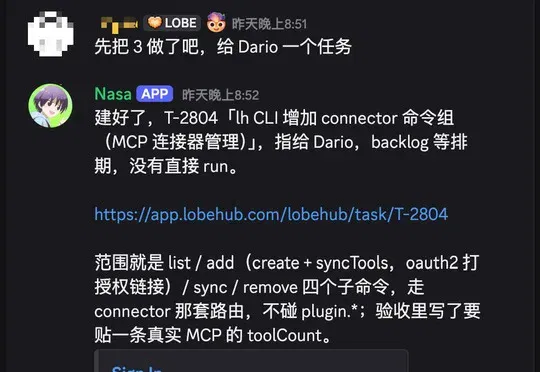
LobeHub 用 Agent 组织研发:自动开发与人工验收如何衔接 (opens in a new tab)
开源Agent协作平台LobeHub已让主管Agent协调Claude Code、Codex等自主开发与审查,并由Acceptance生成验收报告,人类仍负责审批和最终判断,系统尚无法完全无人值守。
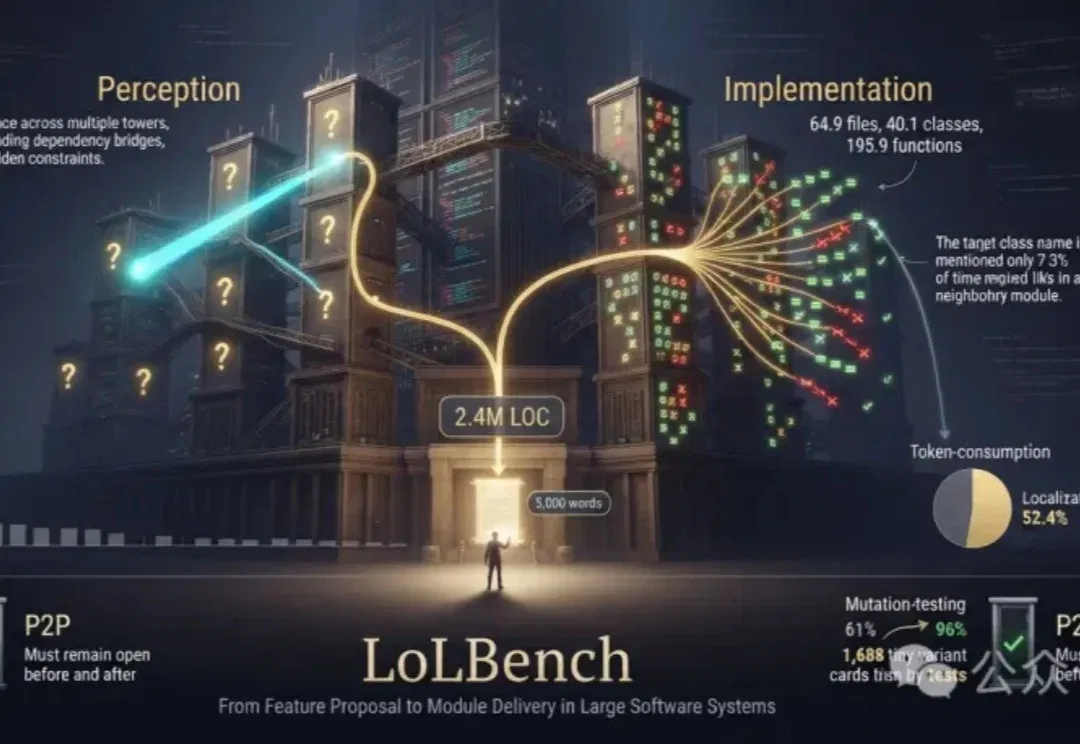
LoLBench 评测28种 Agent 组合:大型系统模块开发最高解决率14% (opens in a new tab)
LoLBench 从29个系统选取100项功能提案,测试28种模型与执行框架组合在大型代码库中的完整交付。无额外指引时最高解决率14%,补充修改文件树与API规范后最佳升至34%;定位和跨模块实现仍是重要瓶颈。
Claude Code 工程师谈理解债:让 Agent 写代码后,再检查自己是否理解 (opens in a new tab)
Addy Osmani讨论AI编程中的理解债与意图债,建议先明确需求、核对实际测试、保留原始依据,并用修改内容测验开发者的理解。文章为工作方法分享,AI文本检测分数不能独立证明作者身份或认知能力。
网友分享所谓 GPT-6.2 测试片段,模型身份与发布信息仍待确认 (opens in a new tab)
社交平台出现被标为GPT-6.2的动画演示及未公开API标识,尚不能独立确认模型身份、生成条件或与Sora的关联。OpenAI另披露硬件工程内部模型的BenchCAD结果,该评测并未确认其公开产品名称。
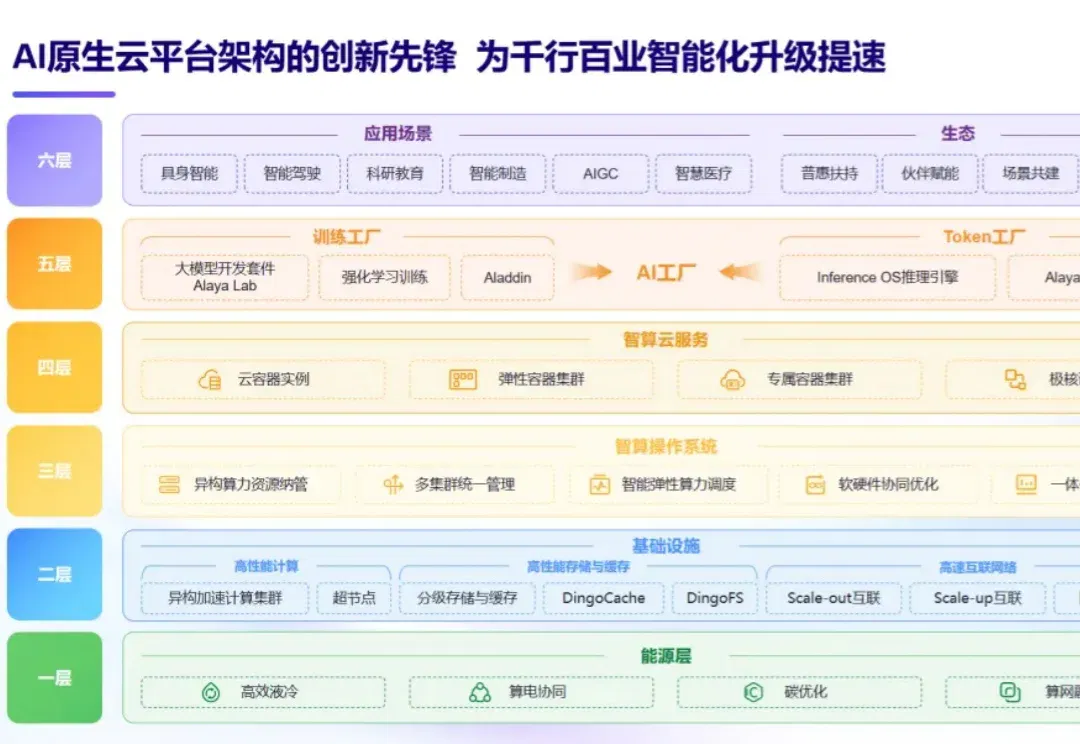
九章云极谈智算云运营:从 GPU 卡时到 Token 双账本 (opens in a new tab)
报道介绍九章云极以DCU核算资源投入、以Token记录交付,并通过异构调度及推理优化比较单位成本。公司披露的利用率、客户案例和收入变化反映其经营口径;统一内部计量不等于行业已形成通用结算标准。
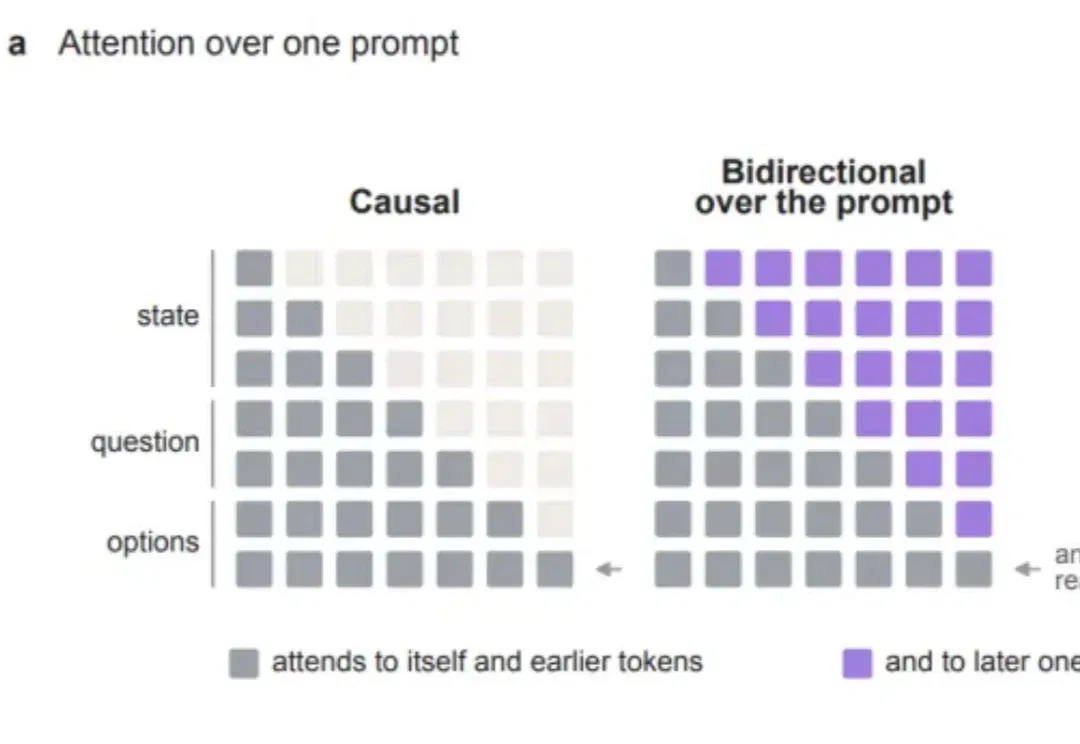
决策模型何时需要思考?StartLux-Decision的按需推理与概率校准 (opens in a new tab)
StartLux-Decision 结合单次概率判断与按需推理,研究置信度门控、RLCD²训练和策略感知校准。论文区分推理长度、终止率与准确率,并用DecisionPivot检验关键条件变化;推理收益及置信度仍受任务分布和路由策略影响。
奥特曼:谁来决定AI该比人类聪明多少? (opens in a new tab)
报道整理奥特曼访谈中关于超级智能控制权、研发速度及权力集中的讨论,并回顾模型监测与人类复核机制。软件任务时长、IQ测验和科学验证是不同尺度,不能直接换算智力差距,也不能据此确认完全自主RSI已经实现。
前 Manus 成员创业:Personal Agent 要从 Context 走向 Performance (opens in a new tab)
由前 Manus 成员 Cecilia 与 Tianyi 创立的 Persom 推出本地优先的 Personal Agent,在用户授权下将电脑中的工作与生活上下文沉淀为可由其他 Agent 调用的 Personal Database,并持续沉淀工作流与个人判断。
智东西体验腾讯 Hy4 正式版:原生视觉、长程任务与建模取舍 (opens in a new tab)
腾讯发布Hy4正式版并计划开放权重。智东西通过网页改造、Blender建模、财报PPT和微信操作进行体验,记录多轮人工纠正、耗时与桌面占用;公司另报告训练系统吞吐优化,个案不能保证所有办公任务可靠完成。