
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
OpenAI 展示 CAD 与电气设计实验,硬件原型仍需人工审核 (opens in a new tab)
OpenAI 展示 GPT-6 Astra 辅助电子宠物设计,以及与赛车团队、马自达探索建模和仿真的项目。设计文件约一周完成,工厂制作原型另需时间与多轮人工修正;工程演示和内部评测尚不能等同自动量产能力。
Anthropic 开源 FlashProve,探索验证模型推理来源 (opens in a new tab)
FlashProve 用权重承诺与零知识证明探索模型推理验证。团队在400B参数的Llama 4 Maverick上报告约110 Token/s证明吞吐;当前实验为1024 Token窗口中的单个输出Token,仍受整数计算、贪婪解码及较高证明成本限制。
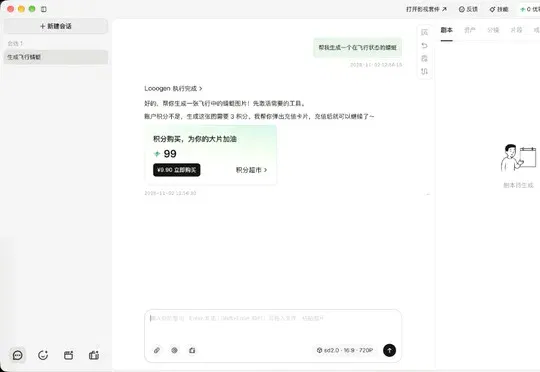
据《读佳》报道,阿里内测 AI 影视创作台 Looogen (opens in a new tab)
报道介绍内测中的 Looogen:以Agent对话与影视套件两种入口连接剧本、分镜、资产和成片流程,项目文件支持本机保存。客户端本地运行不等于模型推理及数据全程离线;具体功能、通道和部署方式仍以正式说明为准。
OpenAI 预告 dots 引入 Terra,探索按任务步骤调度模型 (opens in a new tab)
据负责人预告,dots 将在同一任务不同环节调用适合的模型,Terra拟加入现有阵容。报道比较电脑操作评测速度与标准API单价;单项快约三倍、单价约十分之一,均不代表dots整项任务或订阅费用同步降低。
从头设计到局部精修:ProteoCraft探索可控蛋白质设计 (opens in a new tab)
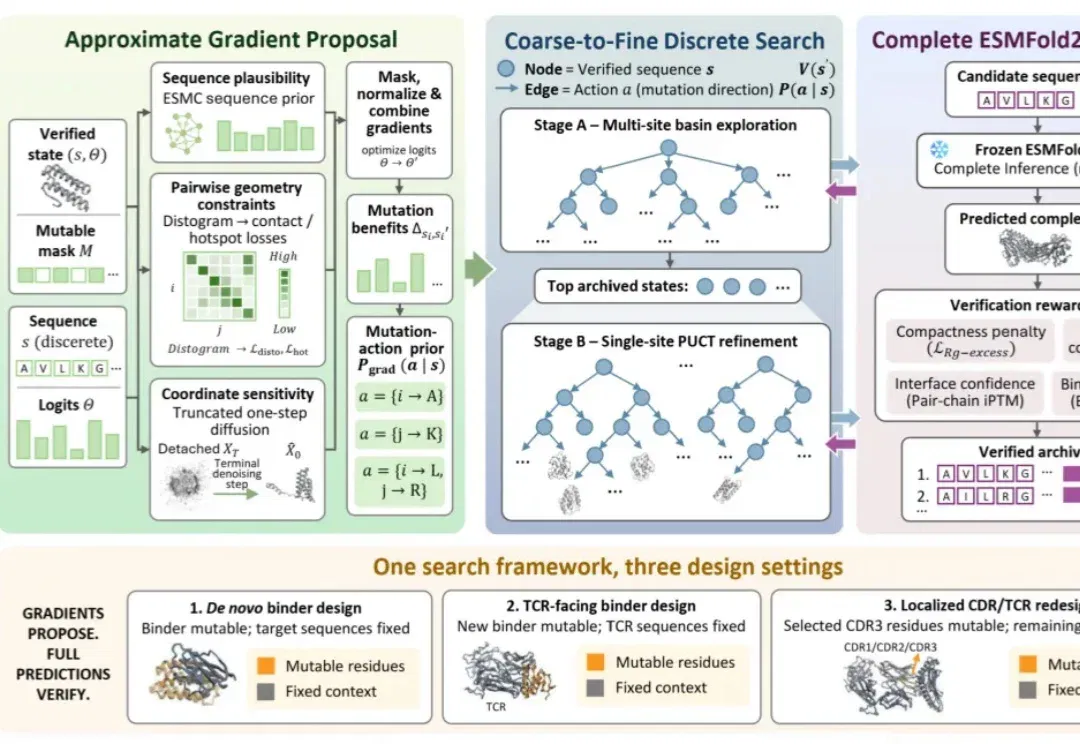
ProteoCraft 结合近似梯度提案、完整结构预测和两阶段树搜索,支持结合蛋白从头设计与局部精修。团队报告计算基准改善,并在PD-L1等候选上开展结合实验;命中率按成功表达样本计算,尚需后续功能与开发性质验证。
海马云谈 RunningHub:算力调度、创作工具链与数据如何配合 (opens in a new tab)
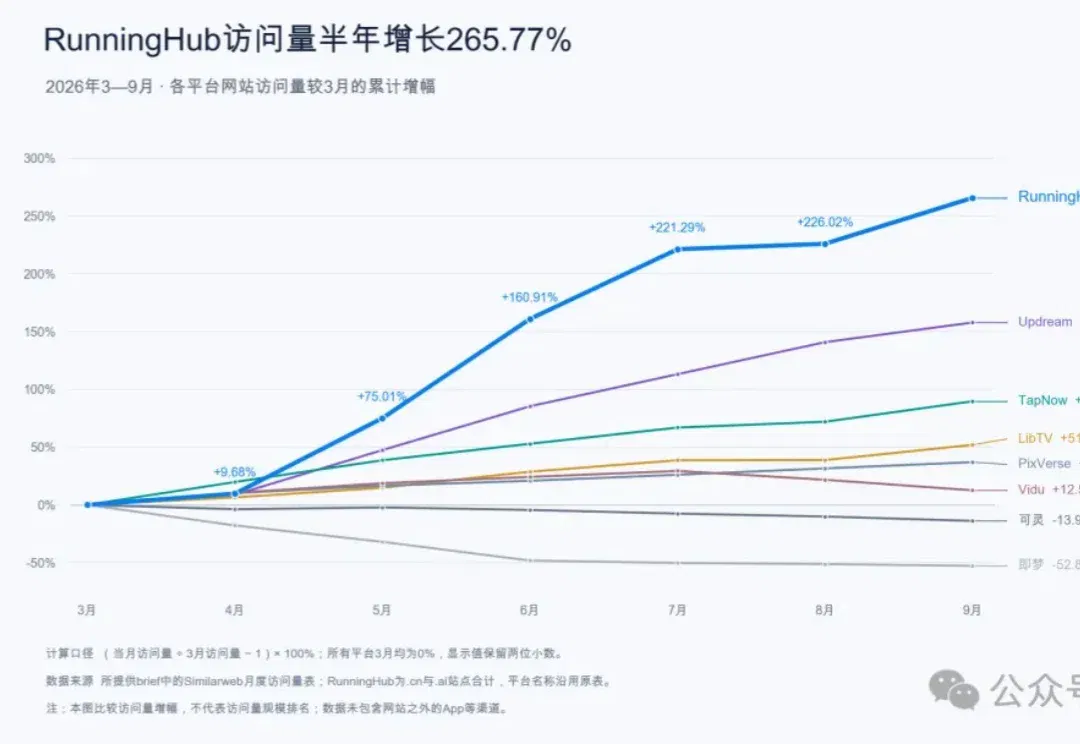
海马云围绕 RunningHub 介绍GPU池化、场景化模型后训练、专业软件连接及创作者工作流沉淀,主张从模型调用走向完整生产交付。访问增速、成本改善和留存数据为报道引用及公司披露,不能据此保证所有AI应用的商业结果。
Qoder 获领先科技奖,阿里如何把 AI 编程接入真实业务 (opens in a new tab)
报道介绍 Qoder 获奖及其从代码工具向智能体工作台的扩展,列举工业CAD、汽车研发和养殖管理案例。IDC所引47.6%是阿里在2025年中国AI编程市场的份额,不能直接算作Qoder单品份额;预计节省成本仍是客户口径。
极智嘉展示 Gravity 与整仓协同,仓储具身智能如何走向持续作业 (opens in a new tab)
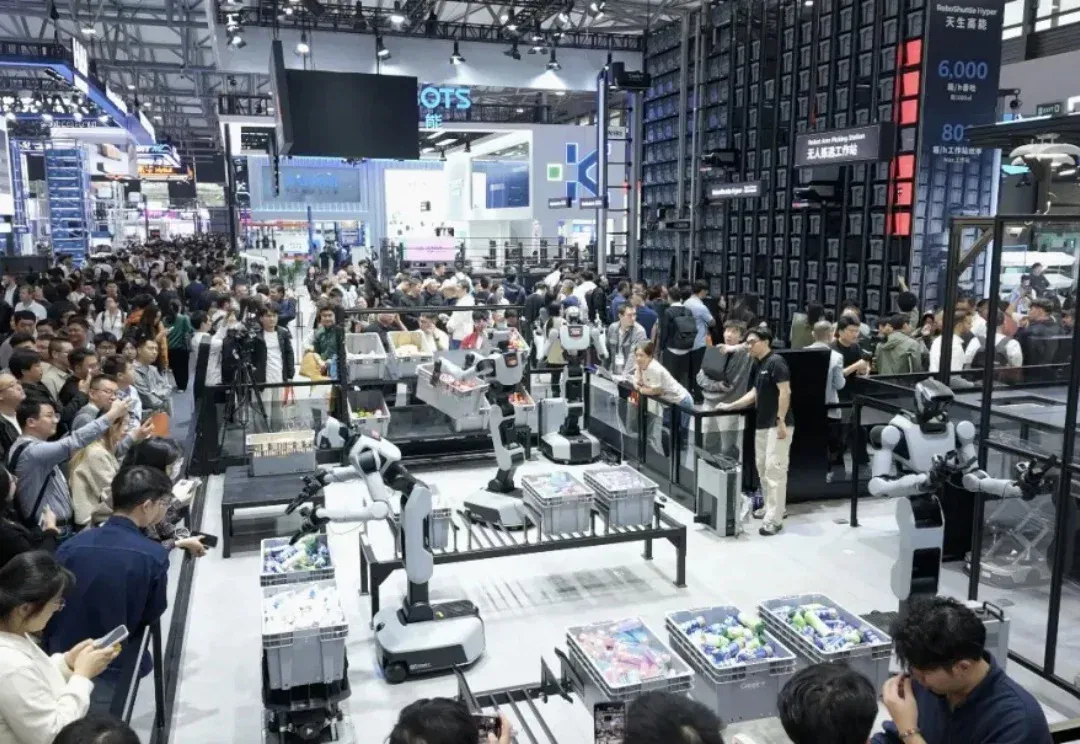
CeMAT 2026 上,极智嘉展示 Gravity 驱动的抓取、长程任务和语言纠偏,并介绍其与仓储机器人及调度系统的衔接。公司提出24/7自主智能仓计划;展台演示和特定实验的成功率,仍需在真实仓库长期运营中检验。
庄明浩回顾十个 AI 时刻:Agent 范式、创业机会与内容中的人味 (opens in a new tab)
在《十字路口》对谈中,庄明浩从OpenClaw、视频模型和模型路由谈到自动化研究、端侧模型及软件商业模式,并分享可视化创作带来的冲击。文章呈现受访者的经历与判断,行业推演、公司估值和产品观察均保留其陈述口径。
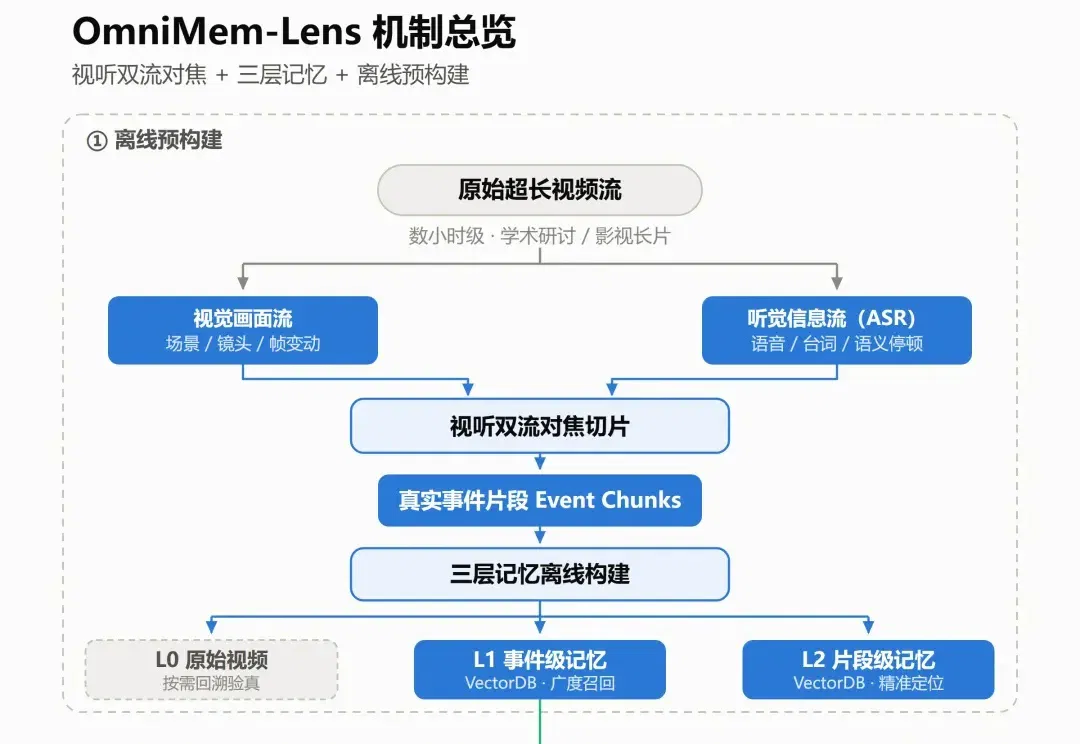
openJiuwen AgentMemory 上线 OmniMem-Lens,探索按事件组织视频记忆 (opens in a new tab)
OmniMem-Lens 在 AgentMemory 0.2.0 中结合视觉变化与语音转录划分事件,并分层建立文本索引及原始视频证据。团队在三项长视频问答基准上报告精度和在线时延改善;收益依赖离线预处理,不能理解为关键事件绝不遗漏。
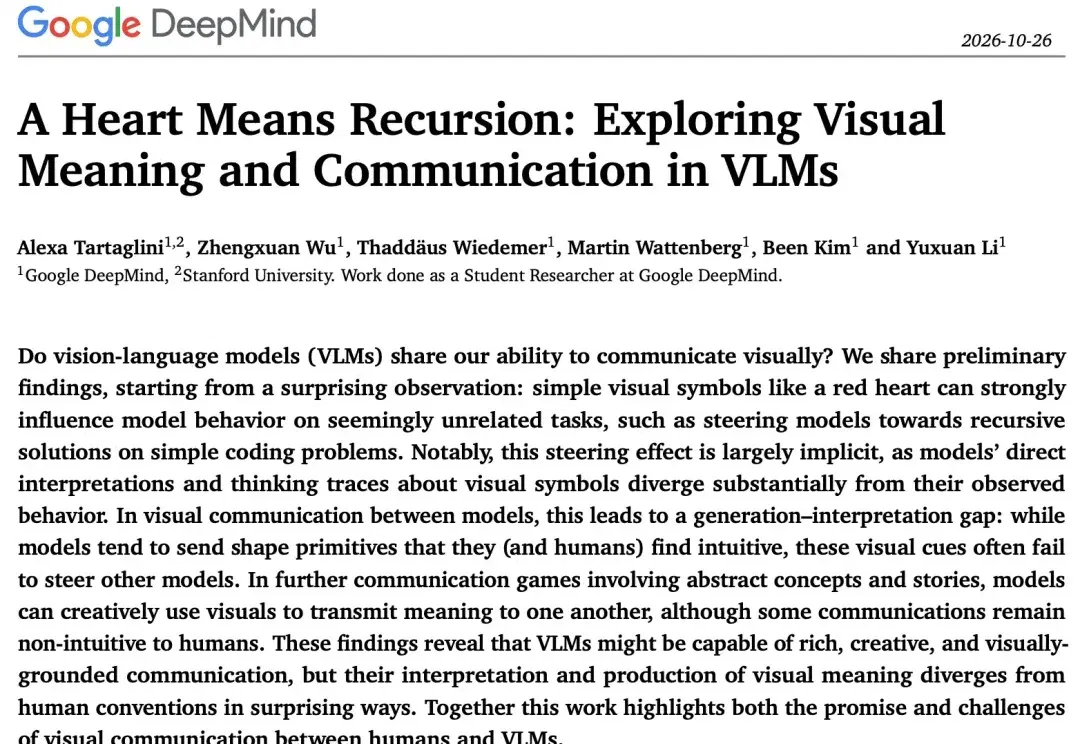
一颗爱心影响 AI 代码解法:视觉符号与推理解释的实验落差 (opens in a new tab)
A Heart Means Recursion 研究发现,部分颜色与形状组合会影响受测模型选择递归等代码策略,而模型给出的解释未必承认这种影响。文章讨论截图型智能体的视觉干扰与行为对照测试,结论仍受模型、任务和实验样本限制。
腾讯网盘内测体验:从文件存储走向 Agent 共用资料库 (opens in a new tab)
《读佳》体验腾讯网盘内测版,介绍连接腾讯文档、WorkBuddy及第三方智能体后的资料检索和整理。免费个人空间为报道时的5GB,AI任务消耗Buddy One积分;产品更偏文档知识工作,部分功能仍在迭代。
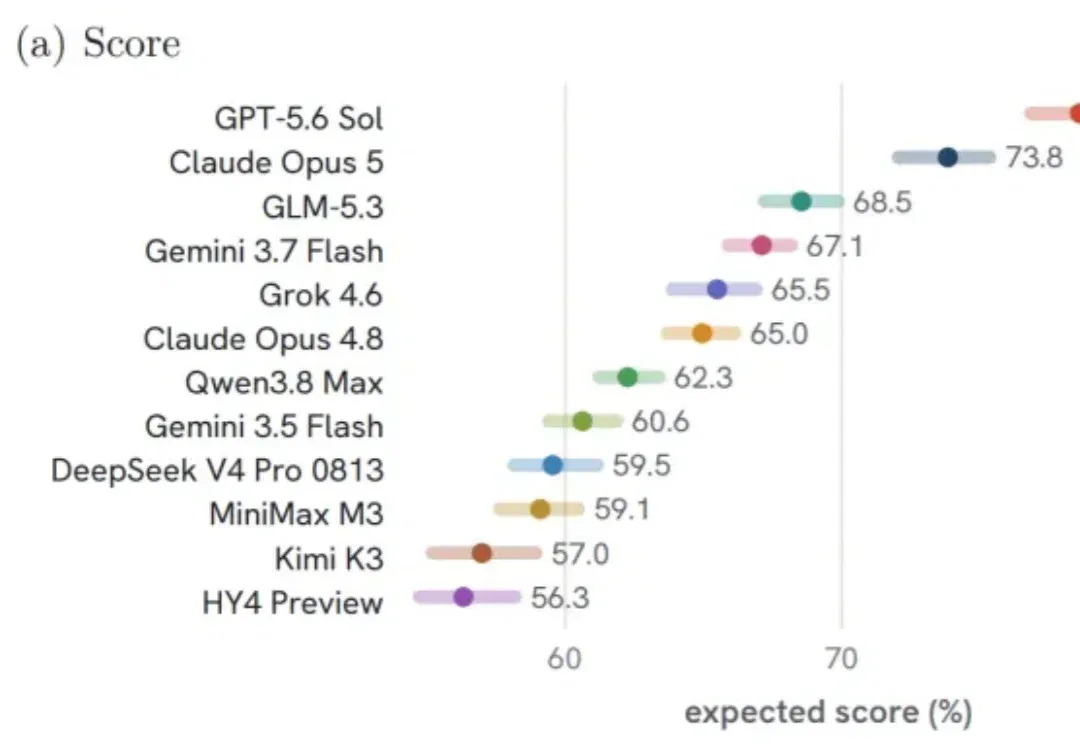
CyberArena 完成466场智能体攻防对局,静态解题分数难代表动态表现 (opens in a new tab)
CyberArena 让12组模型与执行框架在隔离环境中同时攻击、修补并维持服务,完成466场有效对局。结果显示静态解题与动态对抗存在明显差距,也记录虚假修复、补丁遗漏等失误;排名反映该赛制下的组合能力。
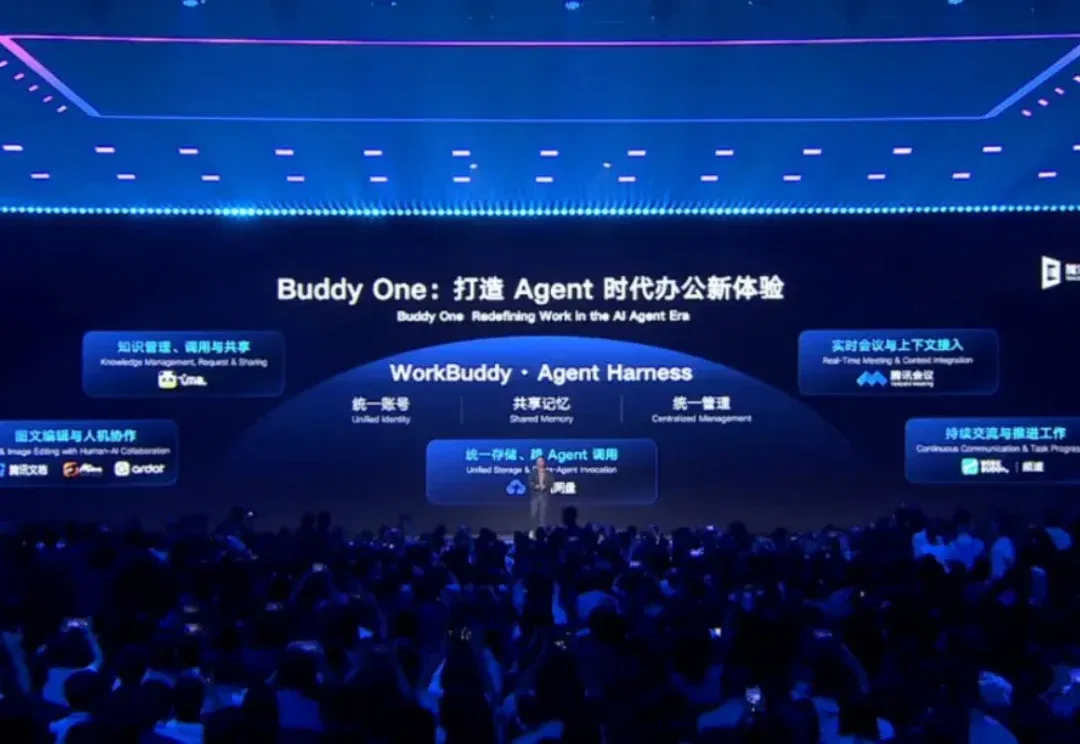
作者体验 Buddy One:WorkBuddy 如何串联会议、文档与知识库 (opens in a new tab)
作者用双十一策划任务体验 Buddy One,通过 WorkBuddy 读取会议纪要、生成文档并归档至ima,介绍账号关联与通用积分。当前跨应用能力以资料读取为主,记忆互通尚未上线,增删改仍依赖具体工具与权限。
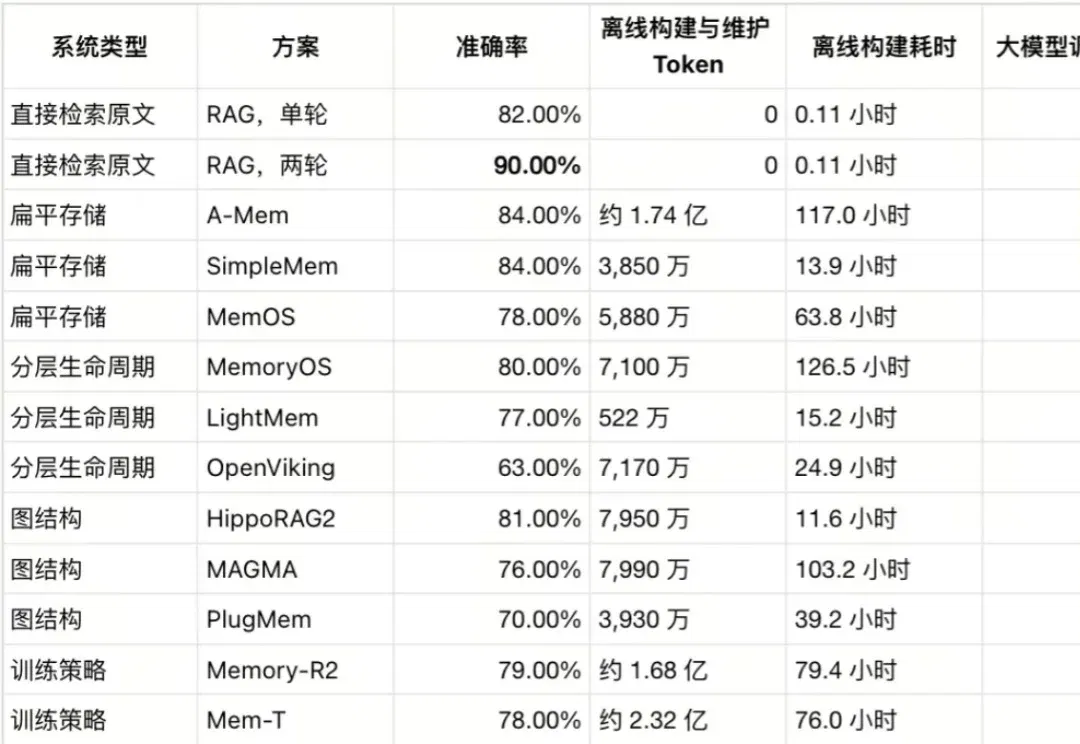
11种 Agent 记忆系统对比两轮 RAG:Memory Tax 研究发现了什么 (opens in a new tab)
Memory Tax 比较11种开源记忆系统与检索原始对话的RAG。在所选LongMemEval-s实验中,两轮RAG领先全部受测系统;研究还发现摘要信息丢失和检索遗漏。联合检索原文可改善结果,但两轮查询也增加在线调用与等待成本。
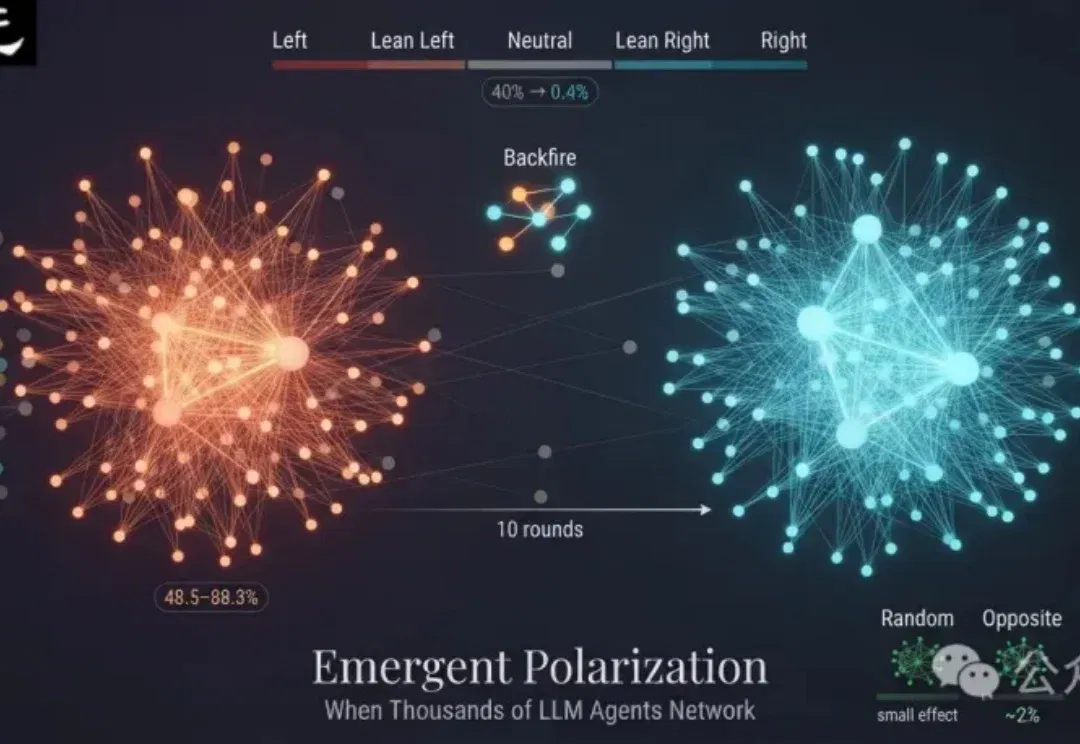
千个智能体互动会发生什么?清华等团队模拟观点极化与网络重组 (opens in a new tab)
研究者在设定初始观点、社交网络和互动流程后,让1000个大模型智能体围绕三项议题交流,观察观点极化、关系重组及不同干预的效果。这是受模型和实验条件约束的社会模拟,不能直接视为对真实人群行为的预测。
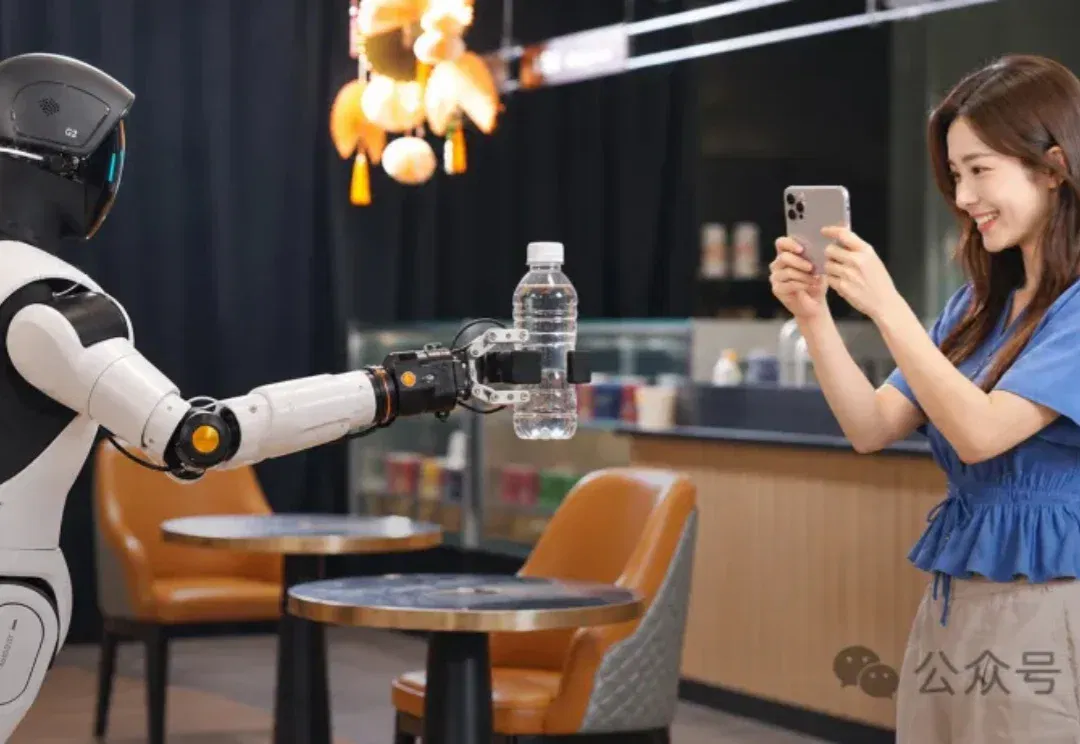
六台机器人参加24小时便利店挑战,智元披露四台完成考核 (opens in a new tab)
智元组织六台机器人从11月2日上午持续挑战至3日上午,报告四台通过考核、累计完成1730次任务。报道展示了接待、送物、制作饮食及清洁,也记录了操作失误;单次直播结果尚不能证明已可普遍无人值守经营。
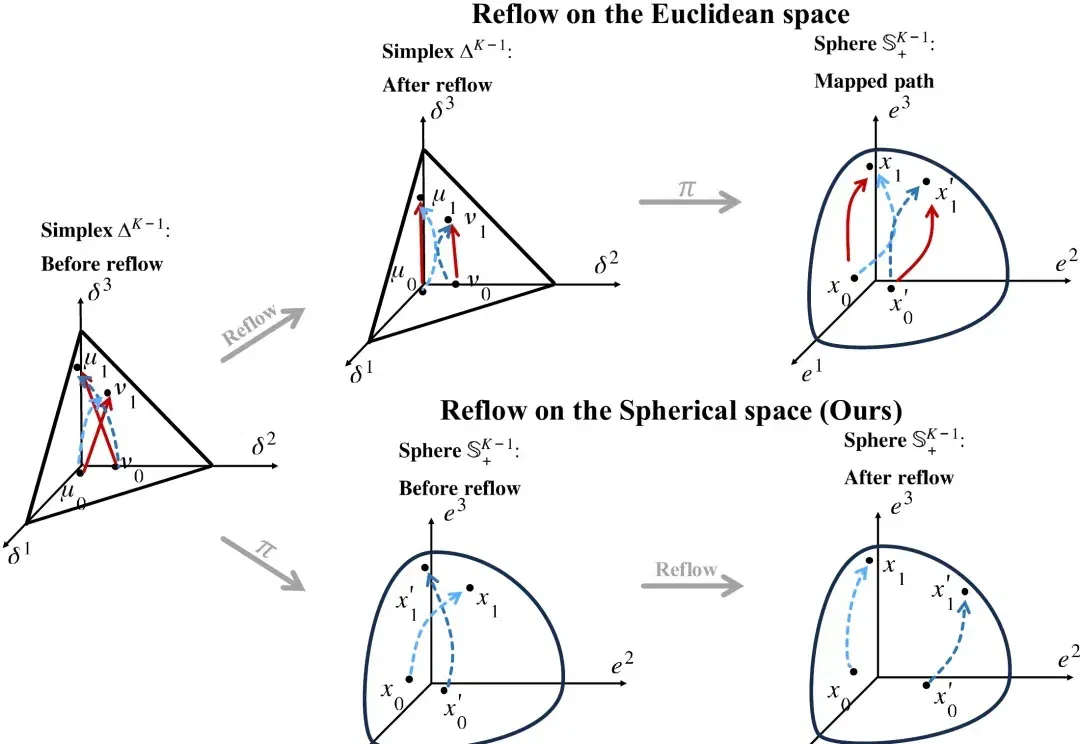
NeurIPS 2026|离散数据也能一步生成?ReSFlow在统计流形上「拉直」生成路径 (opens in a new tab)
ReSFlow 将单纯形上的概率流映射到球面,以模型自身生成的配对数据进行再训练,再用指数映射完成单步采样。实验覆盖图像、文本似然与DNA序列;单步速度收益需额外训练,且不代表所有质量指标优于完整ODE采样。
具身智能的数据与算力瓶颈,腾讯云展示三家企业的基础设施实践 (opens in a new tab)
腾讯云大会以 Manifold AI、RoboScience 和 Zeroth 为例,介绍仿真数据、异构计算、存储及网络如何配合具身模型训练与部署。文中效率数字来自企业具体项目,不能据此认为购买GPU无用,或云端方案适合所有机器人任务。
深度原理 DeepPrinciple发布科学模型 Hydrogen-1.0,开放全部权重 (opens in a new tab)
DeepPrinciple 以 GLM-5.3 为底座后训练 Hydrogen-1.0,开放权重并介绍领域数据、实验记录和发现轨迹的训练方法。团队展示多步科研工具使用及内部评测,也披露NMR任务落后于对照模型;能力仍需第三方复现和真实实验验证。