
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
Milvus 3.0 与 Elasticsearch 9.5 混合检索对比 (opens in a new tab)
Zilliz 作者在同机和相近资源配额下,用约 9.8 万条商品记录比较向量检索、BM25、融合、分组及聚合。结果适用于所用语料、索引和许可证配置,文章附复现实验。
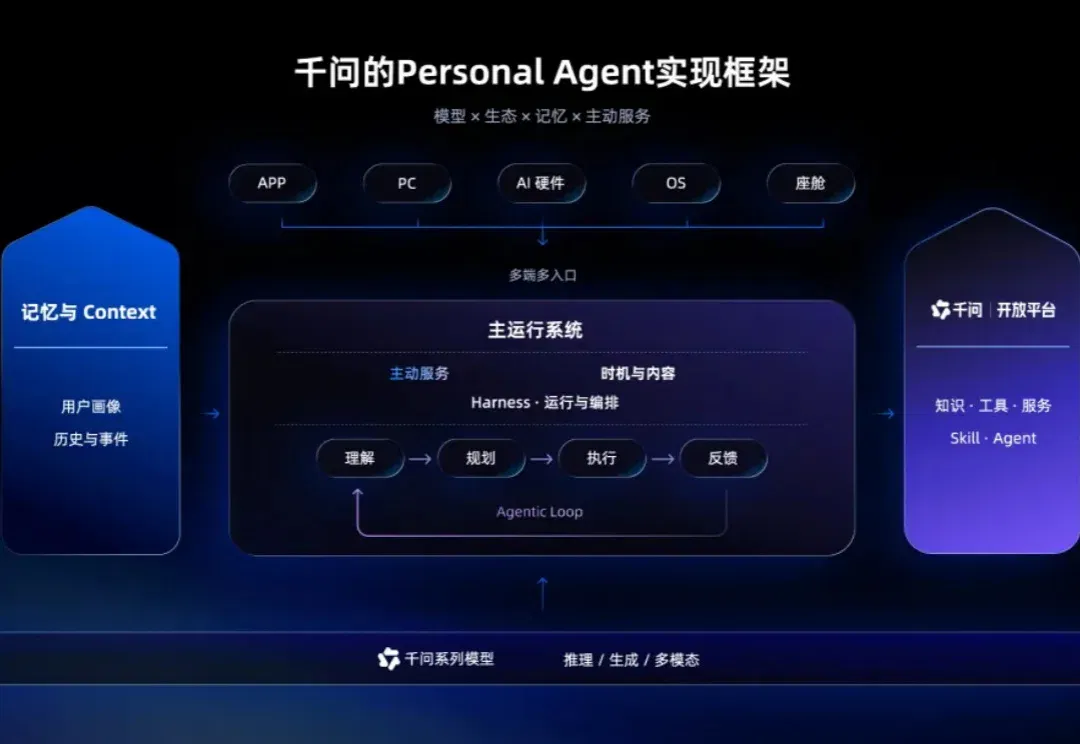
对谈千问蒋冠军:从模型、记忆到生态,Personal Agent的技术架构如何搭建? (opens in a new tab)
蒋冠军介绍邀测中的千问 Go!如何把模型、个人记忆和服务生态结合起来,包括按场景训练、压缩上下文、更新记忆和授权操作。航班现金理赔是受访者举出的单个案例。
冯若航谈 Super-agent:路由之外,怎样管理工作上下文 (opens in a new tab)
作者以 DeepSeek 的 Router 与 Worker 原型为起点,讨论如何按项目显式划分权限、在群聊中协作,并以数据库和文档保存任务、决策和长期记忆。文中同时说明完整方案仍属设想。
对话 ChatGPT 产品负责人:搜索、语音使用与 Dots 成本 (opens in a new tab)
Adam Fry 在访谈中称,ChatGPT 触发网页检索的查询量约为谷歌搜索量的五分之一,语音输入周活约 2.5 亿。他还谈到 Dots 当前算力开销、收入来源和简化产品界面的计划。
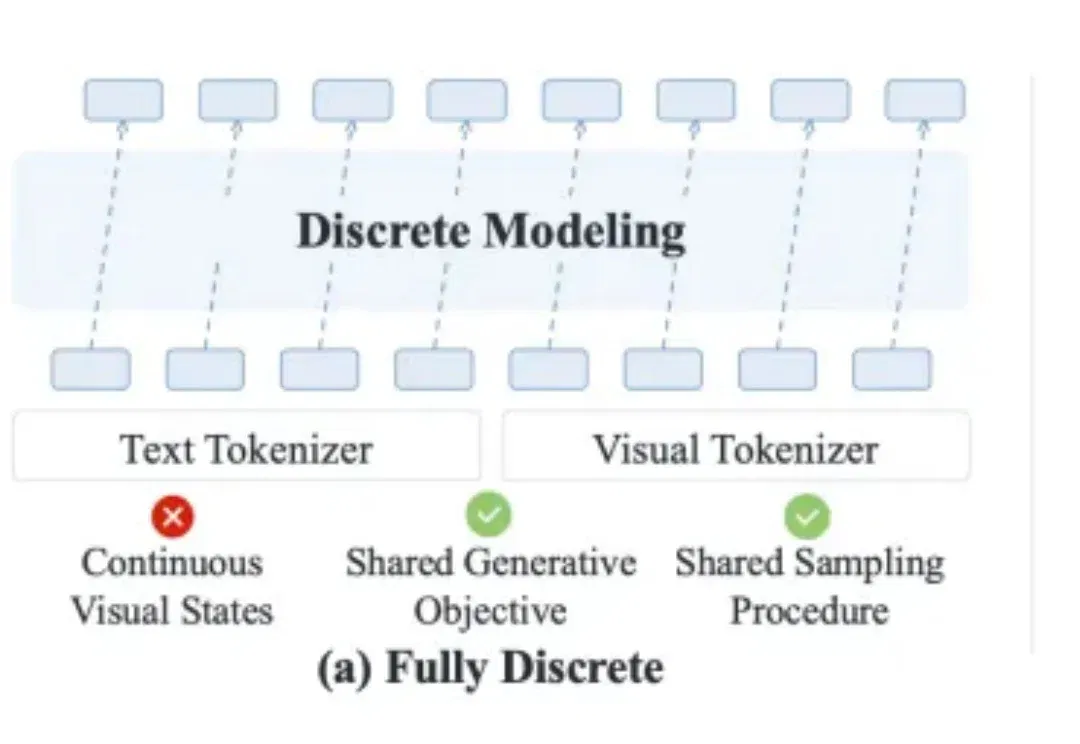
Multimodal Flow 用共享流匹配目标统一文本和视觉建模 (opens in a new tab)
团队将语言和图像分别编码为连续表示,用共享的流匹配目标和分块因果注意力训练 MF-1。在同预算对照中,报告比较了生成质量、视觉理解和混合预训练的迁移效果。
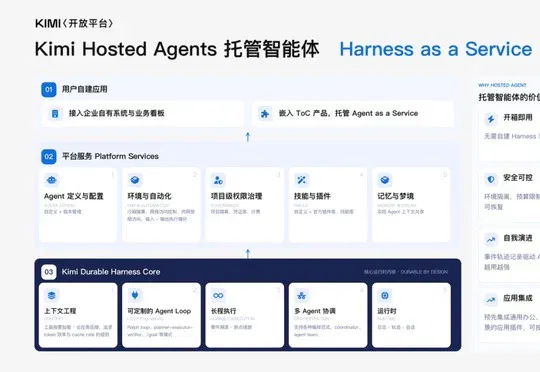
Kimi Hosted Agents 正式发布:Harness as a Service (opens in a new tab)
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
百度开放文心 5.5 Flash Base 权重,主打长上下文推理效率 (opens in a new tab)
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
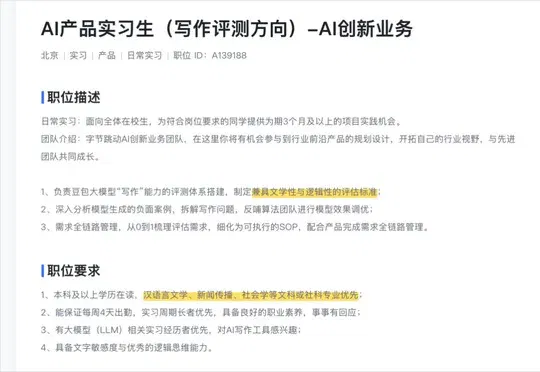
从三家大厂 1.7 万条招聘信息看 AI 内容、运营和评测岗位 (opens in a new tab)
作者统计 11 月 2 日字节、腾讯和阿里的公开社招页面,在筛选出的 9,183 个 AI 岗位中,2,985 个符合其非研发且未列明编程门槛的标准。文中还列举了写作评测、影视和古籍运营职位。
AI安全背后的哲学思想,有效利他主义如何影响硅谷?(上篇) (opens in a new tab)
《硅谷101》从 Anthropic 的招股披露切入,采访科技记者 Afra,讨论有效利他主义的演变、资助网络对 AI 安全研究的影响,以及如何看待评估机构的独立性。
对话张拳石:怎样用等效交互审计模型的判断依据 (opens in a new tab)
上海交大张拳石讨论思维链作为监控信号的局限,并介绍用输入遮挡、稀疏交互和等效拟合分析预测的研究。对谈也谈到跨模型共有特征和交流式学习的设想。
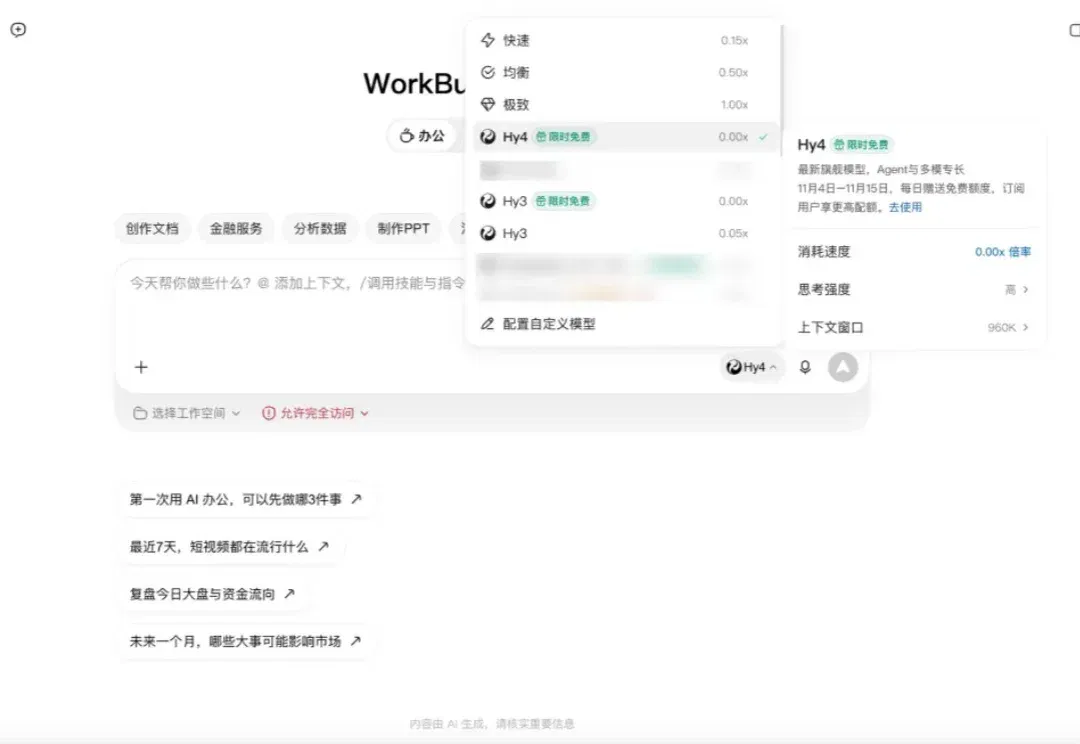
APPSO 实测 Hy4 与 WorkBuddy:网页游戏原型、建模和文档处理 (opens in a new tab)
报道在 WorkBuddy 里用 Hy4 测试录屏转网页原型、Blender 建模与批量文档整理,记录约半小时生成迷你 MOBA 的案例,以及航班应用原型仍需真实数据接口等限制。
原力灵机探索具身 MaaS,把后训练和部署做成平台服务 (opens in a new tab)
文章以模型服务市场数据作背景,介绍原力灵机在机器人平台中提供监督微调、纠偏和强化后训练。供包速度与成功率来自特定产线案例,跨机器人迁移仍有挑战。
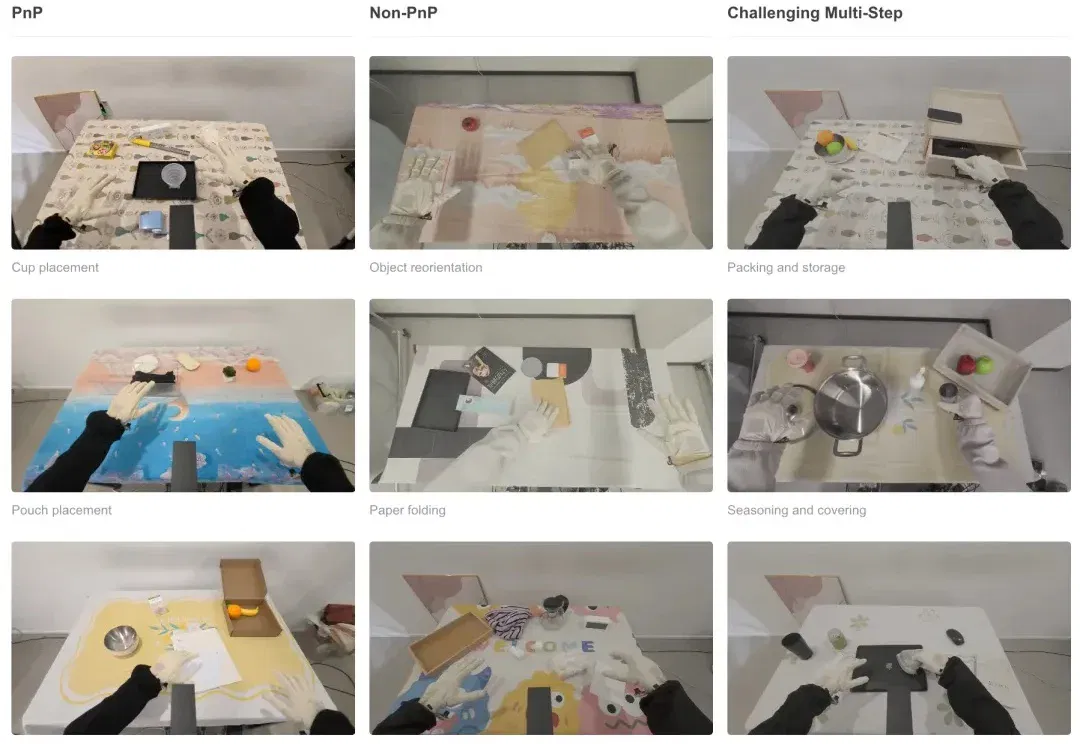
从RDT-1B到Liber-0,两年间,基模走了多远? (opens in a new tab)
从 RDT-1B 到 Liber-0,文章比较了具身基座的数据来源、操作本体与训练路线。Liber-0 的 60 项真机测试、手套数据对照和示范者多样性实验展示了部分迁移能力,也显示长程任务仍较难。
快手 AI 生产力沙龙笔记:从个人编程提效到团队交付 (opens in a new tab)
作者整理了快手部分团队的实践,包括把经验整理成共享 Skill、重组跨岗位协作、按风险分级测试,以及在公司层面管理权限与 Token 成本。试点成绩按发言团队口径呈现。
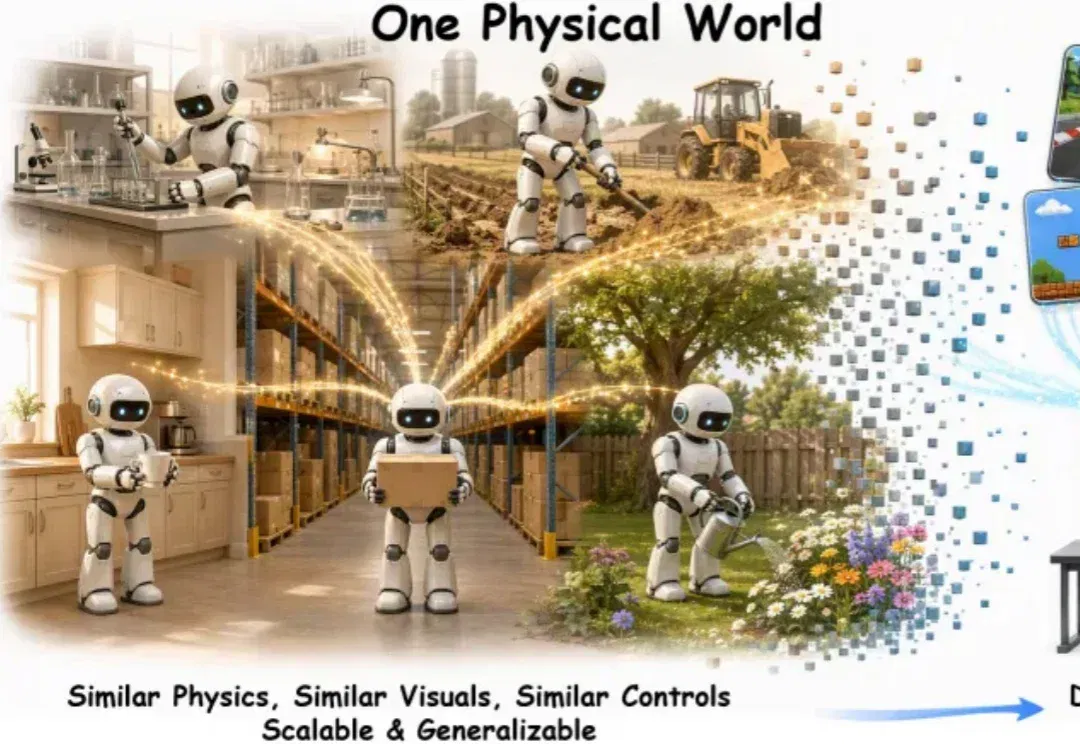
迈向通用游戏智能,清华、米哈游开源GameScaling系列模型 (opens in a new tab)
GameScaling 开放四档规模、八个模型,研究游戏操作能力怎样跨场景迁移。团队用 120 组训练配置比较模型大小、数据时长和游戏多样性,并测试实时交互与陌生游戏的表现。
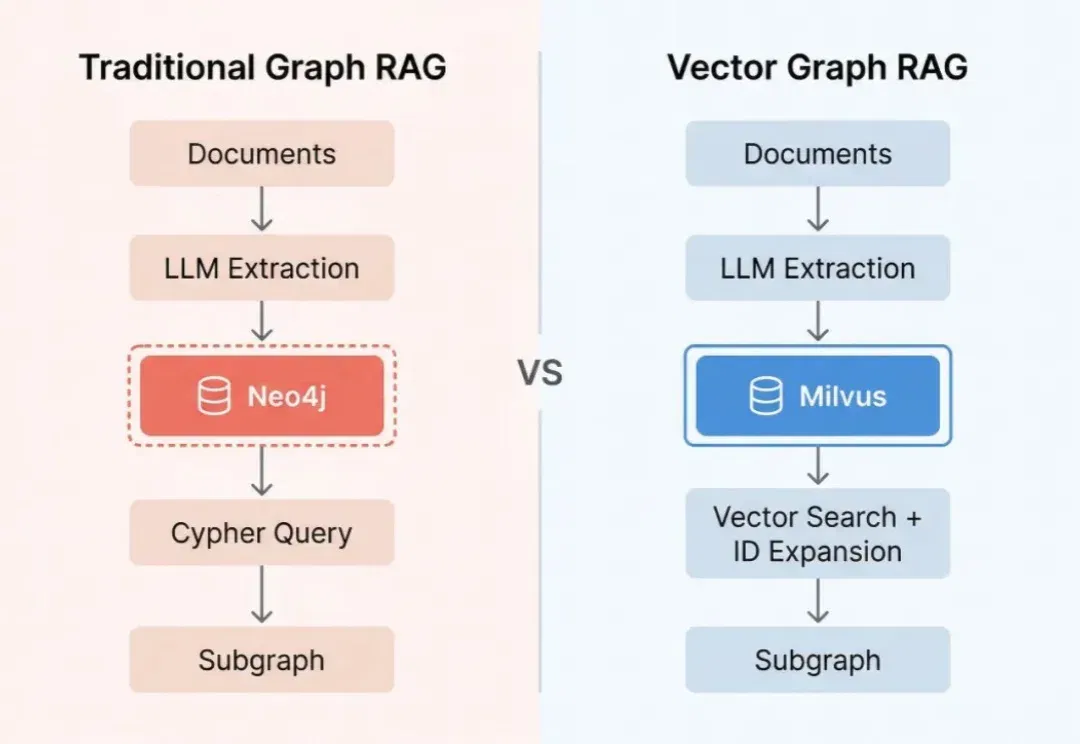
Milvus 与 Jev 两阶段重排提高多跳检索召回率 (opens in a new tab)
Zilliz 在 Vector Graph RAG 中先用 Jev 筛选关系,再重排关联的原文片段。在 MuSiQue 和 2Wiki 共 2,000 题的对比中,Jev 1.14 两阶段方案的平均 Recall@5 为 86.61%。
小米展示人形机器人在汽车工厂和公寓的作业测试 (opens in a new tab)
小米公开两组演示:汽车工厂两台机器人参与一个班次的盖板排序,公寓试验则让机器人连续完成多项整理任务。报道介绍了工位调度、异常恢复与真实场景数据回流。
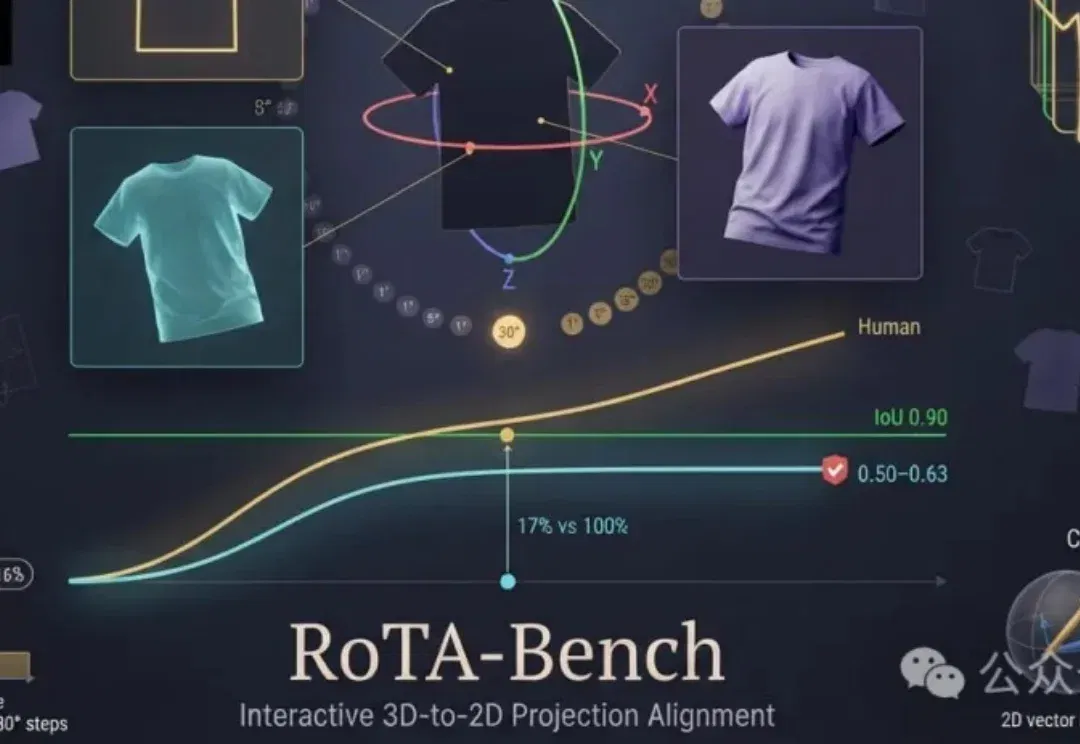
RoTA-Bench 评估视觉模型的三维旋转与投影对齐能力 (opens in a new tab)
厦门大学与南洋理工大学团队用可逆旋转构造交互任务。在 100 个测试任务中,所测最高模型成功率为 17%,本科生组 400 次运行全部成功。论文还分析了旋转方向、角度和交互历史。
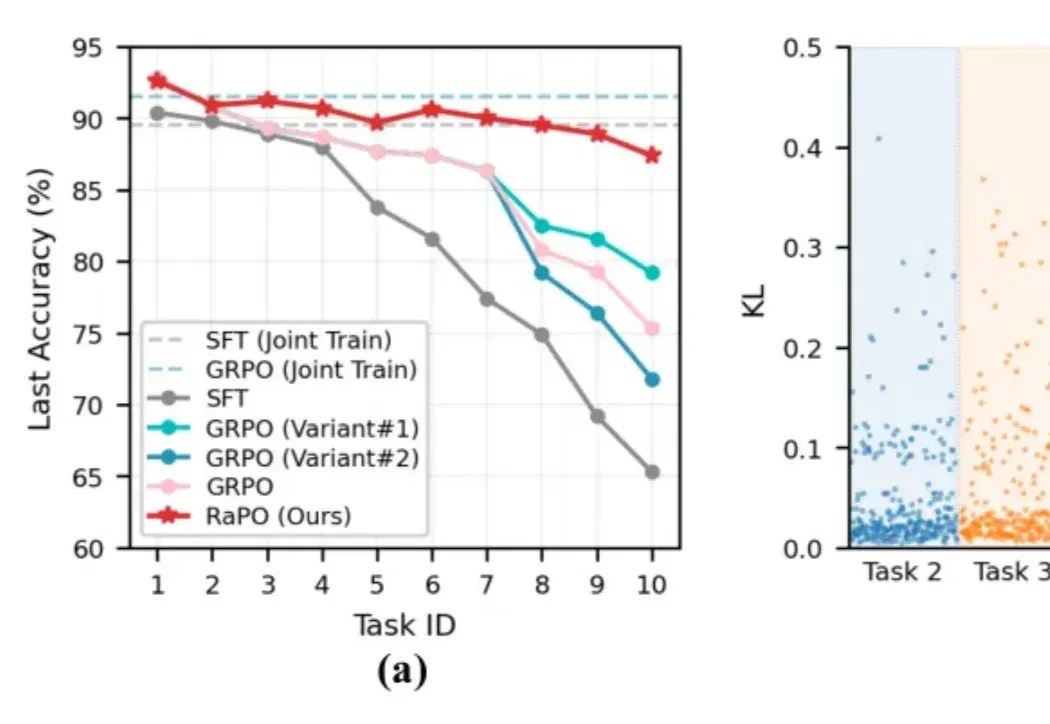
港大提出 RaPO,用强化微调缓解视觉持续学习中的遗忘 (opens in a new tab)
论文用轨迹级保留奖励和跨任务优势归一化,在无旧数据回放的连续视觉任务中评估微调。以 ImageNet-R 的 10 任务设定为例,报告遗忘率由标准 GRPO 的 20.02% 降到 4.69%。
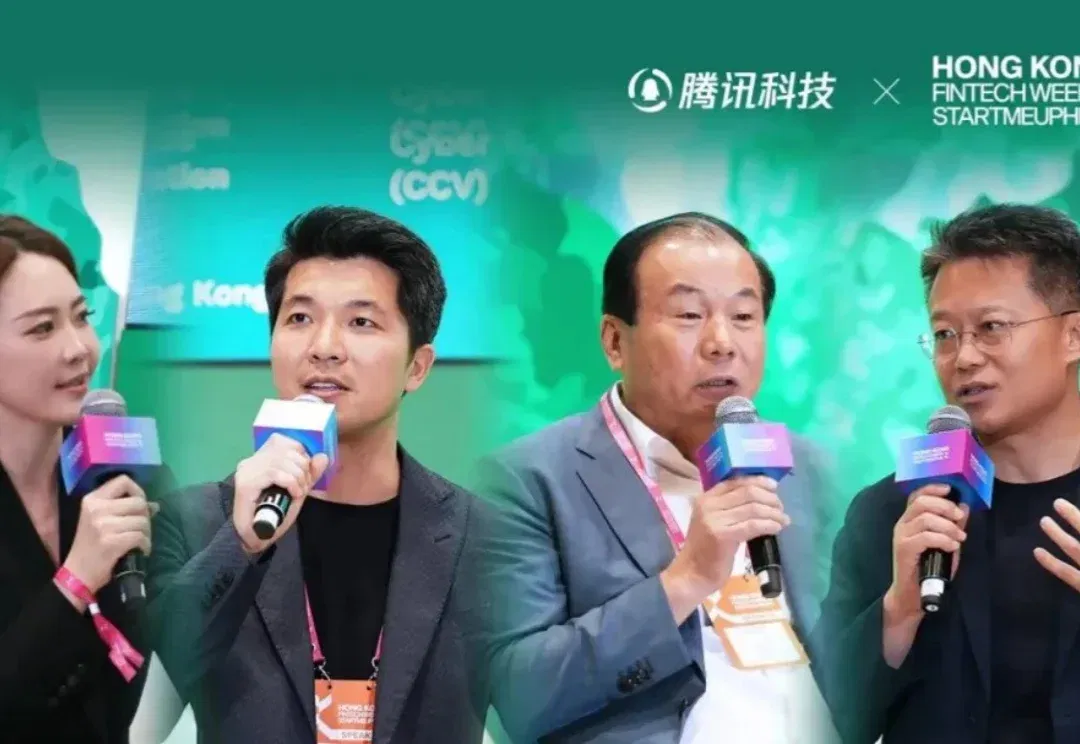
席宁、周炜、骆怡航同台:世界模型的下一步怎么走? (opens in a new tab)
香港金融科技周对谈中,席宁、周炜和骆怡航从工业控制、投资和产品研发三个角度讨论世界模型,并比较视频生成、物理预测和机器人行动的落地条件。