港大提出 RaPO,用强化微调缓解视觉持续学习中的遗忘
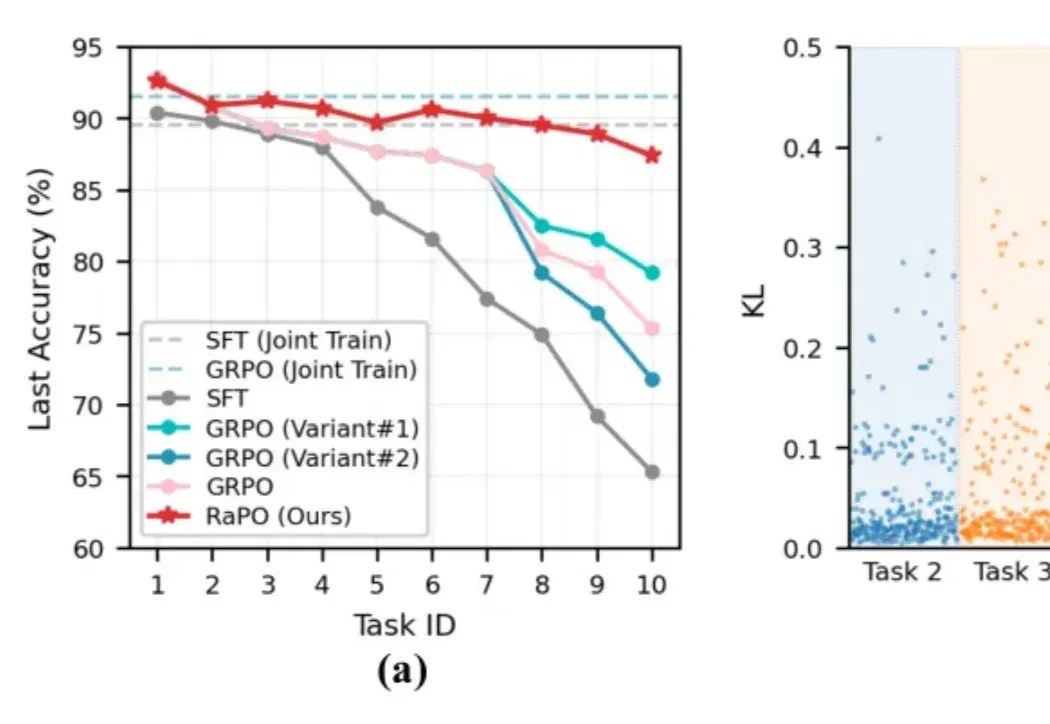
论文用轨迹级保留奖励和跨任务优势归一化,在无旧数据回放的连续视觉任务中评估微调。以 ImageNet-R 的 10 任务设定为例,报告遗忘率由标准 GRPO 的 20.02% 降到 4.69%。
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。然而,当将 RFT 应用于极具挑战的视觉持续学习(Visual Continual Learning)场景,例如在完全不回放历史数据(Rehearsal-free)的类增量持续学习(Class-Incremental Learning)与域增量持续学习(Domain-Incremental Learning)设定下,现有的 RFT 范式真的能够有效抵御 “灾难性遗忘” 吗?
近日,来自香港大学俞益洲教授团队 (https://i.cs.hku.hk/~yzyu/index.html) 首次系统性地探讨了强化微调在视觉持续学习中的瓶颈,首次揭示了标准 GRPO 框架下隐藏的 “轨迹级漂移不可知性(Trajectory-level Drift Agnosticism)” 缺陷,并提出了全新的 RFT 算法 Retention-aware Policy Optimization (RaPO)。基于标准的 MLLM,RaPO 在涵盖图像分类、目标检测、视频动作识别等不同视觉持续学习基准测试中展示了优越的性能和抗遗忘能力,代码已开源。
- 论文题目:Overcoming Catastrophic Forgetting in Visual Continual Learning with Reinforcement Fine-Tuning
- 录用会议:NeurIPS 2026
- 论文地址:https://arxiv.org/abs/2605.09640
- 代码仓库:https://github.com/LMMMEng/RaPO
- 第一作者:香港大学博士生娄蒙 (https://lmmmeng.github.io/)
一、研究动机:标准 GRPO 为何在持续学习中仍然存在遗忘问题?
在真实世界的开放环境中,AI 系统必须能够持续学习按时间顺序到来的新任务,同时避免对先前已掌握知识的灾难性遗忘(Catastrophic Forgetting)。传统的 SFT 往往需要引入复杂的参数隔离、动态架构扩展或蒸馏惩罚,但在严苛的无历史数据回放(Rehearsal-free)设定下,依然极易出现新旧知识的严重冲突。尽管一些工作在近期发现 RFT 相比 SFT 天然更具抗遗忘特性,但在多任务长序列的视觉挑战中,标准 RFT 的表现究竟如何却缺乏探索。
为此,研究团队以经典的 Qwen2-VL-2B 为基础模型,在 ImageNet-R 数据集上构建了一个典型的 Rehearsal-free Few-shot Class-Incremental Learning 的实验:200 个类别被划分为 10 个互不重叠的子任务,每个类别严格限制仅提供 5 个带标注样本。
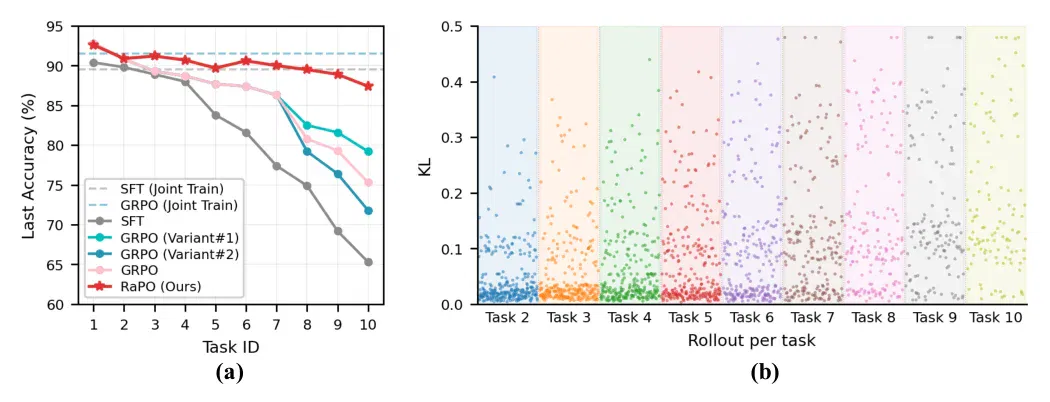
图 1:左:无回放类增量设定下 GRPO 全程优于 SFT,但自身遗忘依然明显;右:获得相同任务奖励的候选轨迹,相对上一任务策略的 KL 散度差异悬殊,且随任务推进增大。
实验结果如图 1 (a) 所示:虽然 GRPO 的整体表现超越 SFT,印证了 RFT 的抗遗忘特性;但随着任务数量的递增,GRPO 的最终准确率依然出现了不可逆转的大幅滑坡,这表明标准 RFT 仍然无法解决持续学习中的稳定性与可塑性(Stability-Plasticity)失衡问题。
- 部分轨迹呈现低漂移:在学会新类别的同时,模型的推理模式和特征空间高度保留了上一阶段的历史分布。
- 部分轨迹呈现高漂移:虽然刚好命中了新任务标签,但其在参数空间与表征分布上已发生了剧烈突变,彻底背离了历史知识。
由于标准 GRPO 仅根据 Task Reward 进行相对优势(Group-relative Advantage)的计算,导致优化器对这些正确但剧烈漂移的轨迹给予近似的信用分配(Credit Assignment)。随着任务序列的演进,这种对轨迹漂移的 “不可知性” 不断放纵模型滑向高漂移参数区域,从而不可避免地引发了严重的灾难性遗忘。
漂移与遗忘之间究竟是相关还是因果?团队设计了两个方向相反的 GRPO 变体,直接在 rollout 全对的组内做干预:变体 1 只保留低漂移轨迹的正奖励,变体 2 反过来只保留高漂移轨迹的正奖励。如图 1 (a) 所示,结果一目了然:前者显著缓解了遗忘,后者显著加剧了遗忘。至此因果关系坐实:保留 Task Reward 高且漂移小的轨迹,正是抗遗忘的关键。但硬阈值并不可行,二值门控会破坏细粒度的信用分配,rollout 数量有限时更新也极不稳定,更合理的做法是把 drift 本身变成连续的奖励信号。
二、方法:RaPO 重塑强化微调的信用分配与尺度归一
针对上述问题,研究团队提出了RaPO (Retention-aware Policy Optimization)。RaPO 没有对多模态骨干网络引入额外的参数模块或复杂的微调架构,而是从强化学习的 Reward Shaping 与数值稳定性出发,构建了两个核心组件:
1. Retention Reward:基于轨迹级分布漂移的有界奖励重塑
以往对抗遗忘的常规思路通常是在总 Loss 中加入一些正则项,例如 KL loss。然而全局 KL loss 是独立于每个 Rollout 获得的特定奖励的,它无法区分同一组内完成任务质量相近但遗忘程度不同的候选轨迹。因此,RaPO 直接将轨迹分布漂移映射为一个正向的密集标量奖励:Retention Reward,使其在组内相对优势计算之前介入:
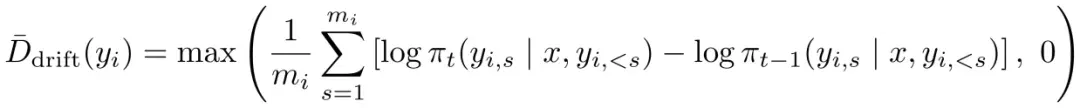
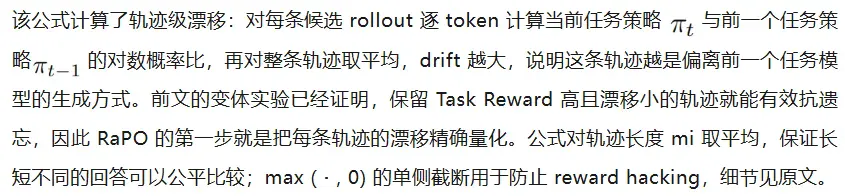
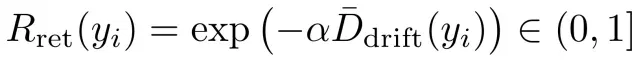
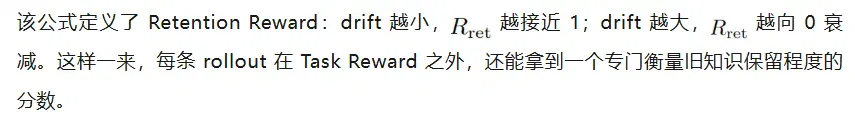
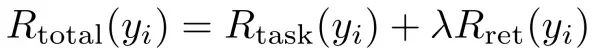
该公式给出了 RaPO 的总奖励:Task Reward 与 Retention Reward 的加权和。与常规 GRPO 只聚焦于如何学好当前任务不同,在 RaPO 中,一条既能答对新任务、又保持低漂移的轨迹才能拿到高分。当一组内多条轨迹的 Task Reward 相近时,drift 更小的那条将获得更大的 Advantage、被更强地正强化,策略梯度因此持续流向 “学好新任务、同时不忘旧知识” 的解。λ 平衡两项权重;该机制即插即用,分类的精度奖励、检测的 IoU 奖励都能直接组合。
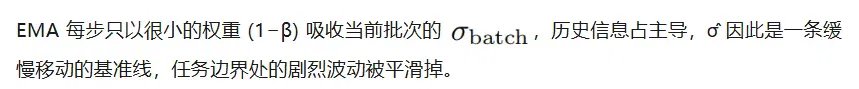
2. Cross-Task Advantage Normalization (CTAN)
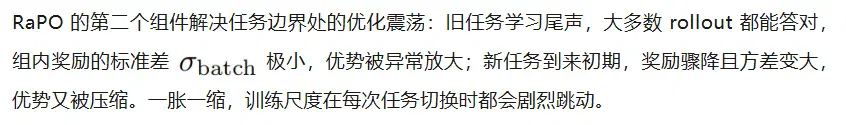
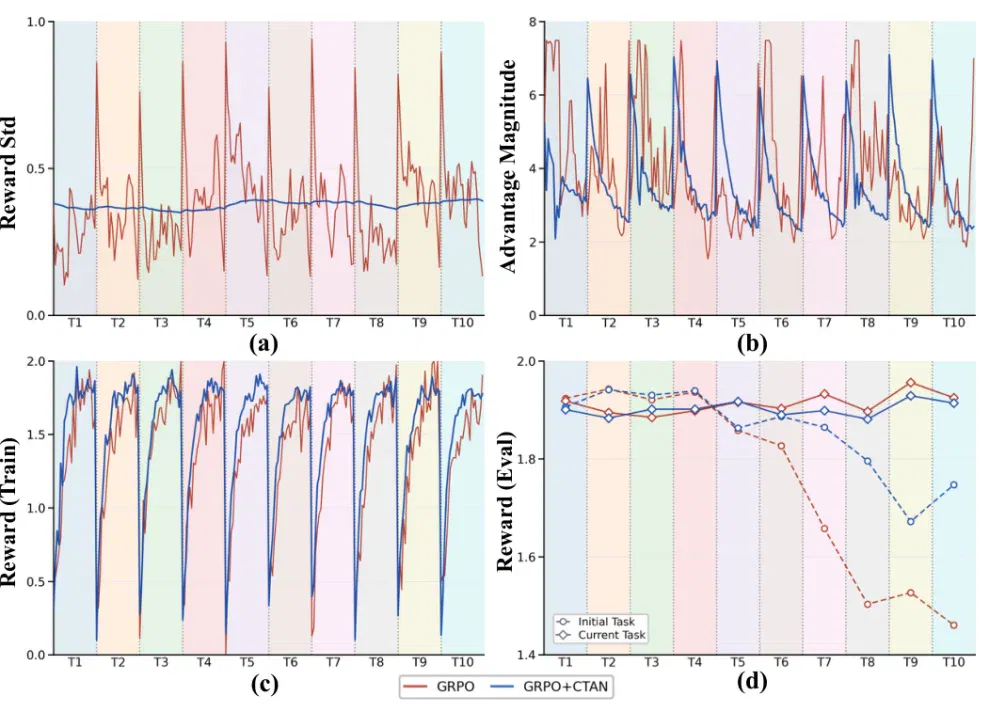
图 2:CTAN 用跨任务持久的 EMA 平滑奖励标准差(a),优势幅度(b)与训练、评估奖励(c、d)在任务边界处不再剧烈震荡。
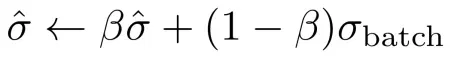

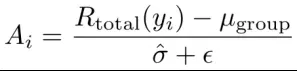

三、实验验证:五大视觉持续学习基准全面超越
为了全面衡量 RaPO 的通用性,研究团队依托 MLLM 的 free-form text 泛化能力,在严苛的 5-shot 低资源设定下,横跨图像、视频以及密集预测场景展开了详尽的对比评测。
1. 类增量图像分类 (CIL for Image Classification)
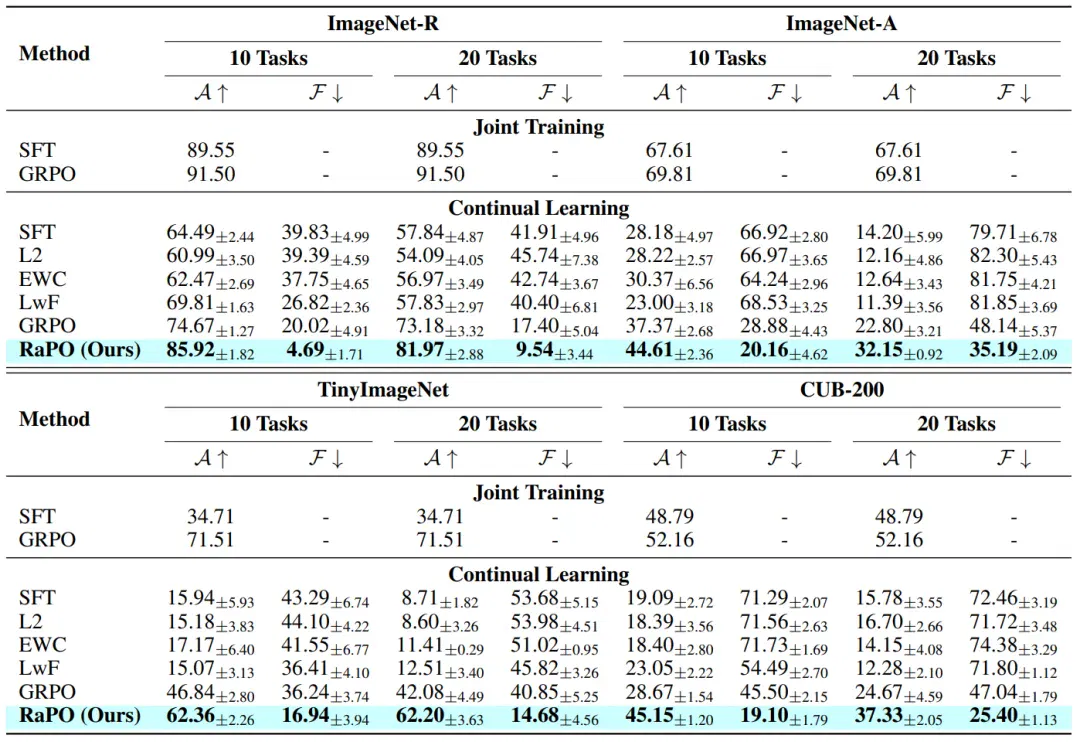
表 1:类增量图像分类结果。四个数据集、两种任务划分下,RaPO 的最终精度均为最高,遗忘率均为最低。
在 ImageNet-R、ImageNet-A、TinyImageNet 和 CUB-200 四个经典基准上(基于 Qwen2-VL-2B),传统 SFT 结合持续学习经典约束(如 L2 正则、EWC、LwF)的表现均不尽如人意,在经历 10 至 20 个连续任务后,准确率大多跌至 40% 以下。标准的 GRPO 虽展现出一定优势(在 ImageNet-R 10 任务上取得 74.67% 的 Last Accuracy),但遗忘率仍高达 20.02%。而引入 RaPO 后,模型的最终准确率显著提升至 85.92%,更关键的是,遗忘率被压到了 4.69% 的极低水准。在难度更高的自然对抗样本集 ImageNet-A 上,RaPO 同样实现了准确率提升 7.24%、遗忘率下降 8.72% 的显著突破。
2. 类增量目标检测 (CIL for Object Detection)
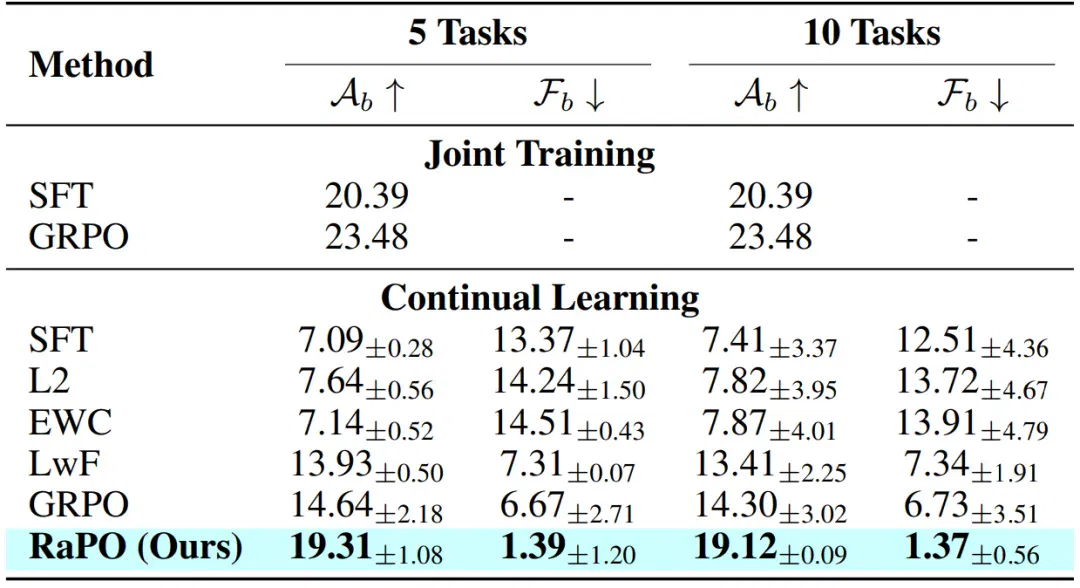
表 2:COCO 2017 类增量目标检测结果。
相较于图像分类,目标检测不仅需要语义识别,还依赖细粒度的空间坐标预测(团队采用 Qwen2-VL-7B 骨干网络)。在 COCO 2017 数据集的 5 任务与 10 任务拆分下,RaPO 的 Box AP 分别达到了 19.31% 和 19.12%,较标准 GRPO 分别提升了 4.67% 与 4.82%,而遗忘率更是被压低至 1.39% 和 1.37%。这证明 RaPO 的保留机制同样能够无缝适配通过匈牙利匹配(Hungarian Matching)计算的复杂结构化检测奖励函数。
3. 视频分类与域增量泛化 (Video Classification & DIL)
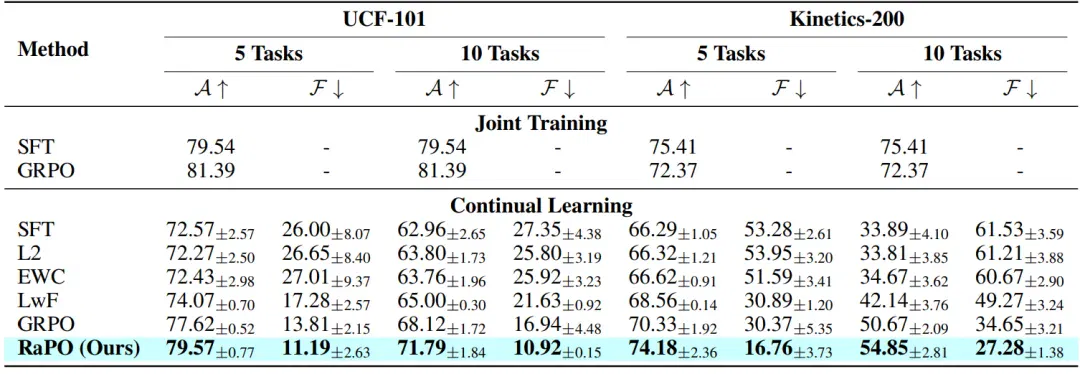
表 3:类增量视频分类结果(UCF-101 / Kinetics-200)。
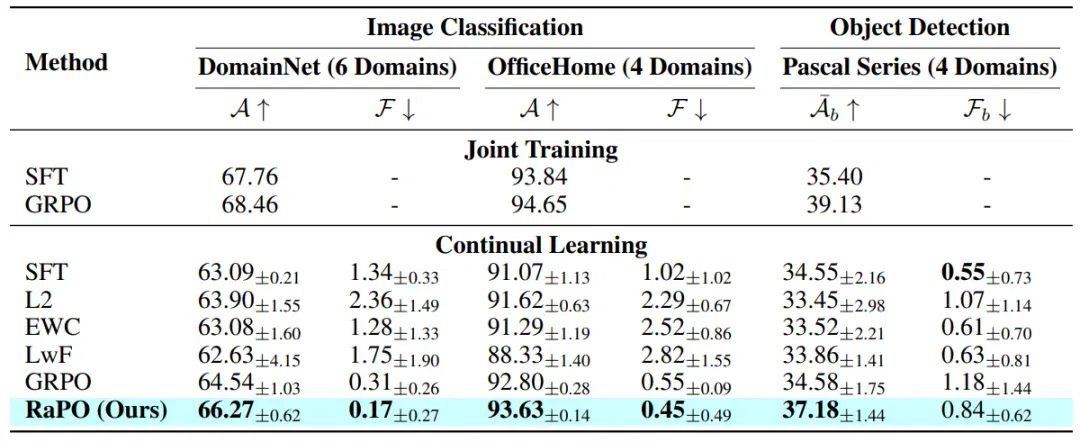
表 4:域增量学习结果(图像分类 + 目标检测)。
RaPO 在包含时空动态维度的视频任务中同样展现了强大的鲁棒性。在 UCF-101 与 Kinetics-200 视频分类任务中,RaPO 在长任务流学习后均取得了最佳准确率。而在无需更改标签空间、仅面临视觉分布漂移的域增量学习(DIL,如包含 6 个域的 DomainNet 和 Pascal 跨域目标检测)中,RaPO 同样全面领先现有基线;在 Pascal 系列跨域检测任务上,RaPO 取得了 37.18% 的平均 AP,甚至超越了使用多域数据进行联合微调(Joint-Training)的 SFT 上限(35.40%)。
4. 可视化洞察:深入解构 <think> 推理路径的抗遗忘机理
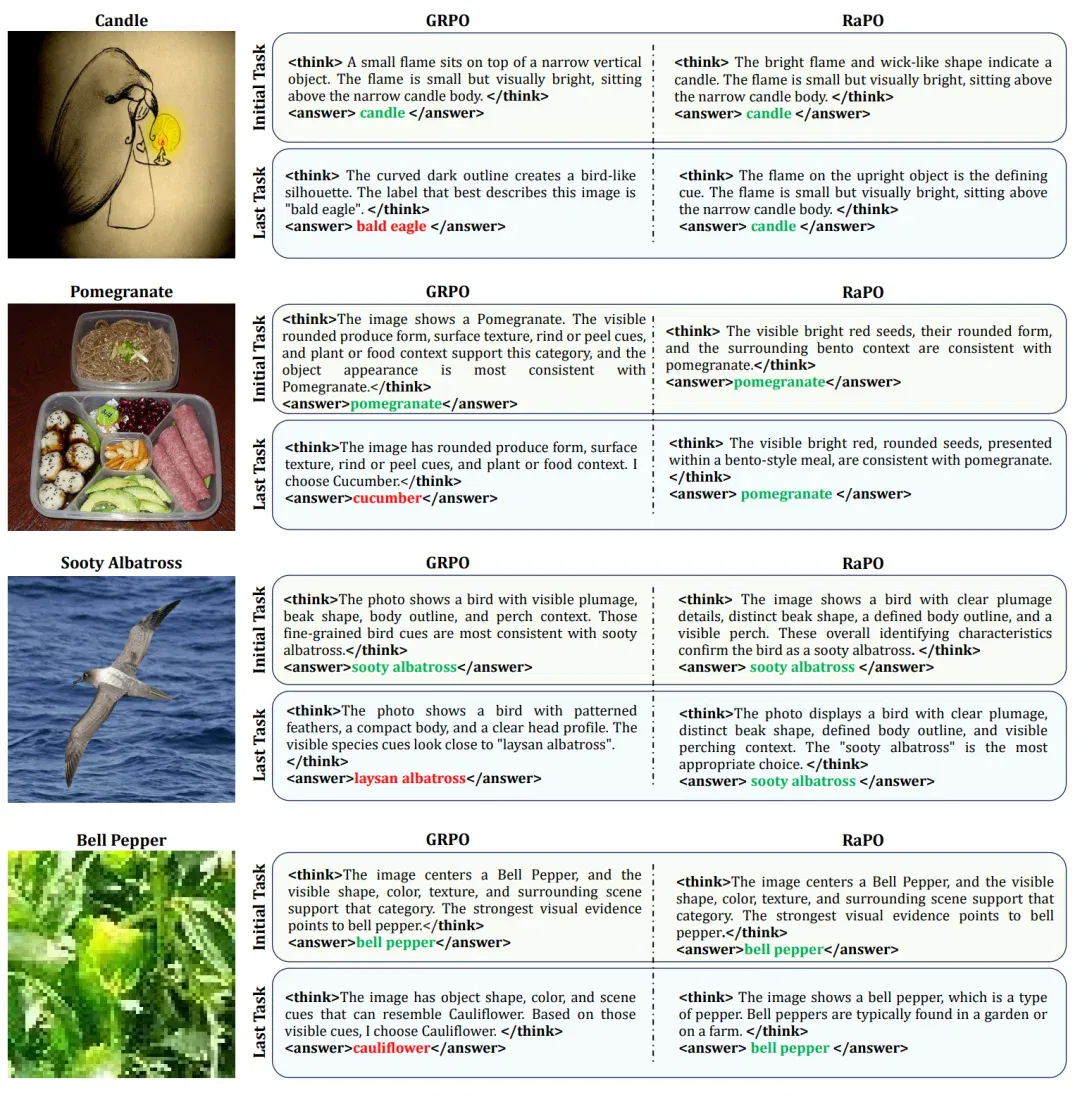
图 3:类增量分类的定性对比。学完最后一个任务后,GRPO 多次把旧类别认错,RaPO 的答案保持不变。
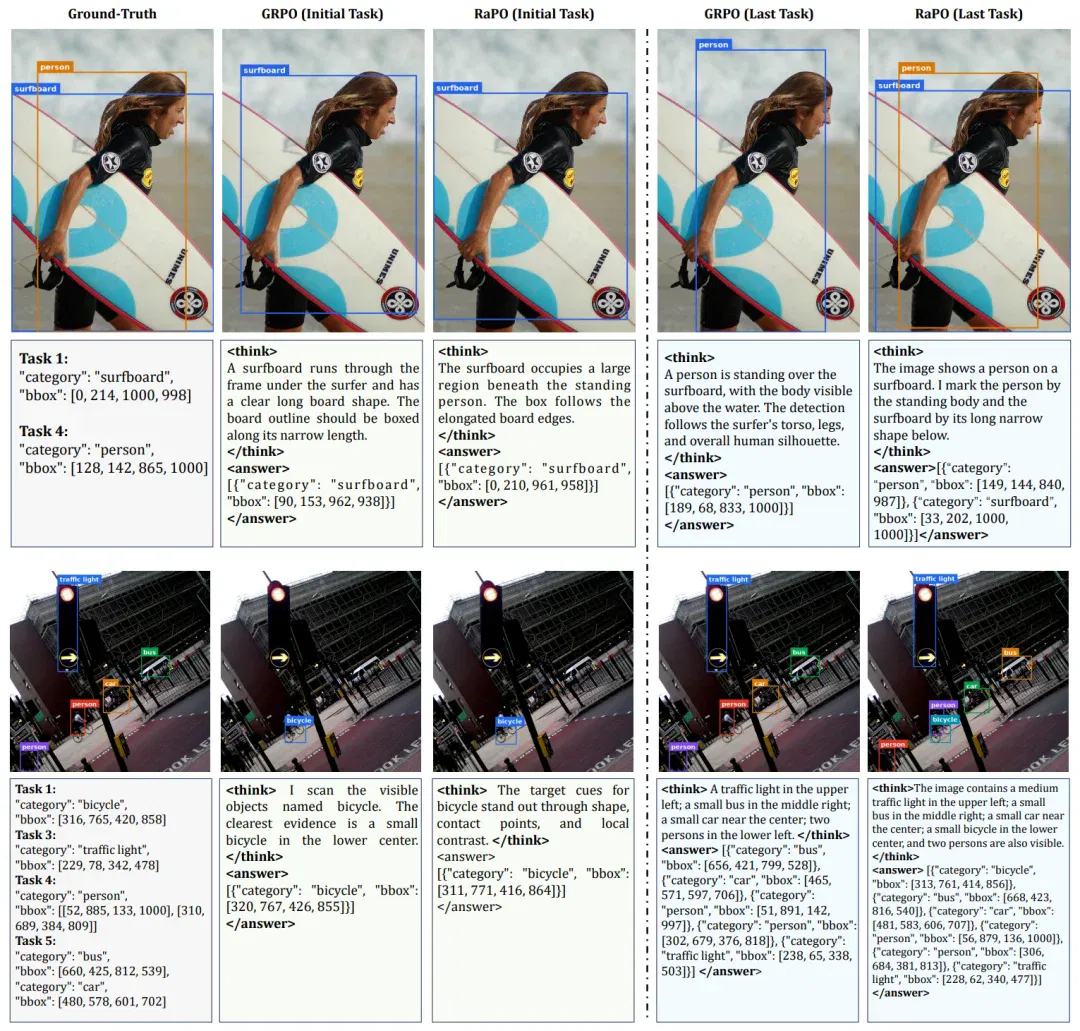
图 4:类增量检测的定性对比。学完全部任务后,GRPO 检测不到早期学过的自行车,RaPO 新旧类别均能检出。
论文通过定性样例直观展示了模型内部的推理演变过程:在经历完整的多任务流训练后,标准 GRPO 在面对早期的旧任务样本时,其 <think> 思维链极易被后续任务所学到的先验知识所混淆(例如将早期的 “蜡烛” 特征强行脑补为后期学到的 “白头海雕” 轮廓,或在目标检测中完全遗漏早先掌握的 “自行车” 类目)。而 RaPO 在输出中依然能够严密维持针对旧任务物体的特征辨析链路,准确捕捉局部的关键判别特征。这证明Retention Reward 不仅守住了表层的最终分类标签,更是从底层强化并固化了多模态大模型的结构化视觉推理轨迹。
四、结语
RaPO 为 MLLM 在流式环境下的参数微调与持续学习开辟了全新的解决视角。这项工作打破了 “RFT 天然免疫灾难性遗忘” 这个共识,精准锁定了 “轨迹级漂移不可知” 这一关键瓶颈,并用简单的数学形式重构了强化微调的信用分配与方差归一化逻辑。RaPO 能够以即插即用的方式无缝接入现有的 PPO/GRPO 训练框架中,有潜力为构建 “终身学习且不忘历史经验” 的自适应具身与视觉系统提供坚实的算法基座。
更多理论性质证明和实验结果,欢迎阅读原论文!代码已在 GitHub 全面开源,欢迎社区共同交流探讨。
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

Ankole outlines multi-user agent architecture: events, permissions and organizational memory (opens in a new tab)
The team describes its Business Harness design for fast and slow paths, shared state, Actor orchestration and dynamic permissions. Formal verification covers the modeled core permission state machine; it does not replace security checks of the full deployment, external interfaces or implementation.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.

Ask-to-Distill optimizes training questions using teacher–student distribution signals (opens in a new tab)
UIUC and collaborators propose A2D, training a question generator with frozen teacher–student disagreement and compatibility signals before on-policy distillation. The paper reports gains in math, code and agent tasks; its learning-value proxy has limits.