Milvus 3.0 与 Elasticsearch 9.5 混合检索对比
Zilliz 作者在同机和相近资源配额下,用约 9.8 万条商品记录比较向量检索、BM25、融合、分组及聚合。结果适用于所用语料、索引和许可证配置,文章附复现实验。
在RAG与Agent、法律以及电商等场景中,语义+关键词的混合检索已经成为越来越多搜索应用的常规配置。
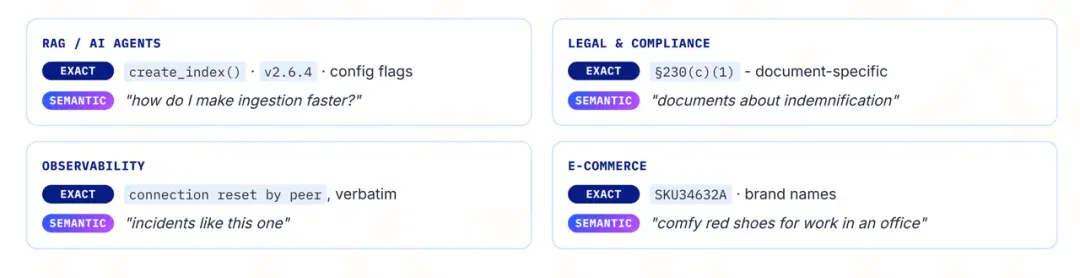
不少企业的通行方案,是在原有关键词检索架构之上,额外接入一套向量检索系统。随之而来的工程负担则是:两套系统要分别维护,数据更新要保持同步,查询结果还要合并排序,后期运维成本,会不断攀升。
那么,有没有可能把这两种需求放在同一个架构之中?
过去,我在 Elasticsearch 工作过四年,见证了Elasticsearch 是如何为其全文建立增加向量检索能力的,现在跳槽到Zilliz,也看到了Milvus 作为头部向量数据库产品已经补全的全文检索功能。
既然两边都能做混合检索,应该选 Elasticsearch,还是 Milvus?
于是,我在同一台机器上,用两个 Docker 容器分别运行 Milvus 3.0 和 Elasticsearch 9.5:相同的 CPU 和内存上限、同一份 Parquet 数据、同一批向量,以及尽量对齐的分析器配置,每条查询都实时并行的方式做了对比。
以下是实验细节(需复现的朋友,见文末代码仓库链接):
01
ES 与Milvus的底层架构有何不同
关键词搜索和向量搜索是在不同的搜索引擎中发展起来的,因此要兼顾两者就意味着要做出妥协。
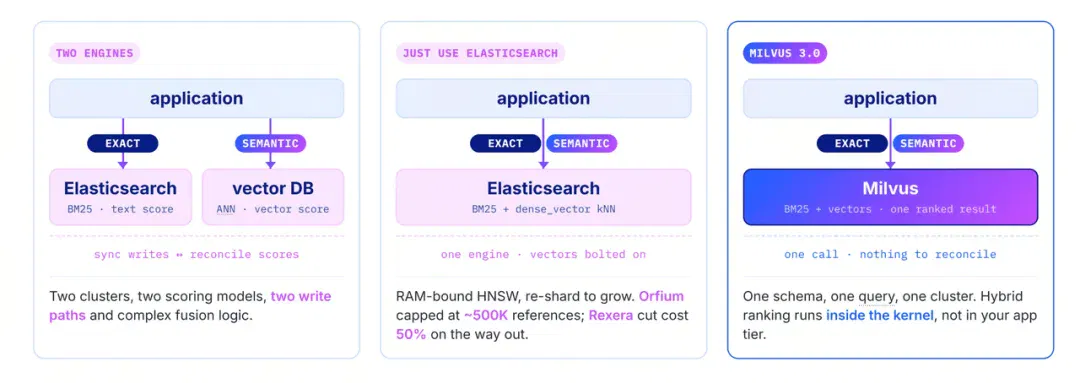
为此,行业中通常有三种解决思路:
双引擎方案:通常由 Elasticsearch 或 OpenSearch 负责 BM25,向量数据库负责 ANN。代价是维护两套集群、两条写入链路,业务侧还要对接两套完全不同的评分体系 —— 多路结果怎么融合、最终排序由谁计算,都需要上层应用额外开发。
直接使用 Elasticsearch 内置向量检索能力,可以省去一套向量集群。小规模场景下这套方案够用,但向量检索始终受限于 Lucene 底层架构:HNSW 图按分片段(segment)组织,向量容量受内存约束,扩容时还会触发分片重排。向量规模持续上涨的业务,很容易在这里碰到瓶颈。音乐版权服务商 Orfium 就踩过这个坑:迁移前的 Elasticsearch 架构,最多只能支撑约 50 万首参考曲目。
(OpenSearch 也采用了相同的 Lucene 向量架构,因此这些问题也普遍适用于 OpenSearch。Elasticsearch 特有的唯一区别在于许可:其 RRF 混合融合并非开源功能,下文将对此进行说明。)
Milvus 3.0 的思路是把 BM25 关键词检索和向量检索封装在同一套 Schema 内,一次调用即可完成混合查询,多路结果融合、排序逻辑全部在内核完成,原生内置 RRF 排序。
02
测试配置
本次实验采用单机版 Milvus 3.0、Elasticsearch 9.5,均跑在 Docker 容器中,单实例上限 4 核 8GB。Milvus 依赖的 etcd、MinIO 附属组件资源,一并计入该配额。
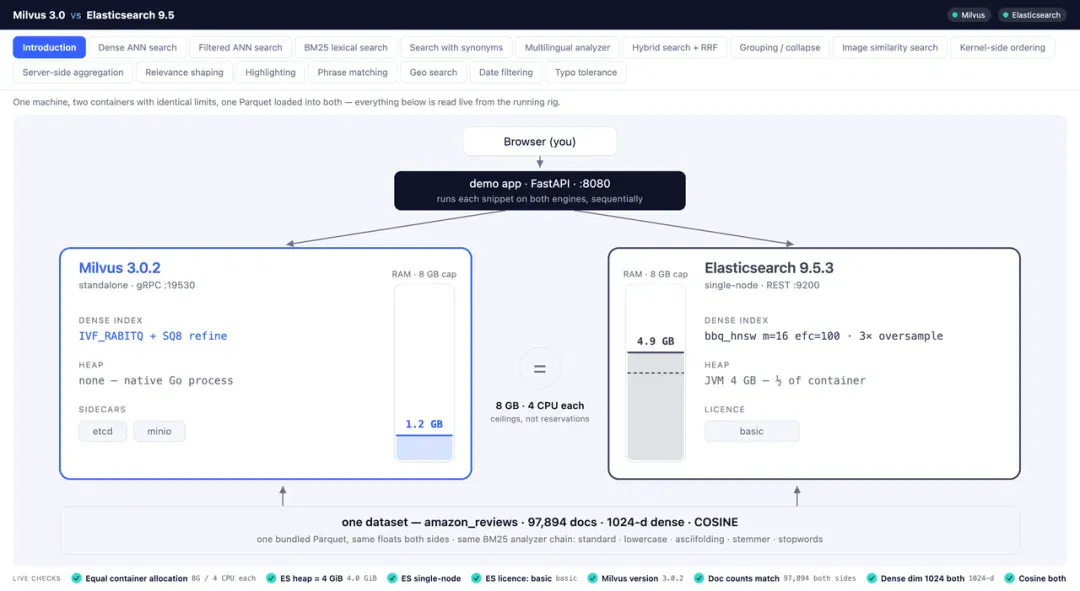
数据来自同一个 Parquet 文件,包含约 9.8 万条亚马逊商品记录,字节级对齐;
1024 维向量只生成一次,再分别加载,统一使用余弦相似度,避免embedding过程带来差异。
BM25 配置也尽量保持一致:标准分词、小写转换、ASCII 折叠、英语词干提取和停用词过滤。
向量索引方面,Milvus 使用 RaBitQ 1-bit 量化加 SQ8 精排,Elasticsearch 使用 bbq_hnsw。召回率则以全量数据的精确暴搜结果为基准。演示页面的首个标签页,会在发起查询前自动校验所有配置。
在这份数据集上,Milvus(含附属组件)整体内存占用约 0.5GB,Elasticsearch 约 5GB。
提前声明:JVM 预热、容器资源限制、缓存冷热状态都会影响延迟数值,文中耗时仅作参考,大规模生产性能请以官方基准报告为准。两者分词器也存在细微差异:Elasticsearch 的英文词干提取器是 Porter1,Milvus 为 Porter2。另外 Elasticsearch 的一条混合检索路径存在许可门槛,后面会展开说明。
这套实验环境更适合对比功能覆盖、查询行为、结果一致性与召回表现。
03
向量检索:关键收益来自精排
先看向量检索。使用同一个查询向量 qv,两边的调用如下:
# Milvus
client.search(
"amazon_reviews",
data=[qv],
anns_field="text_vec",
search_params={
"params": {
"nprobe": 4,
"rbq_bits_query": 4,
"refine_k": 2.0,
},
},
limit=10,
)
# Elasticsearch
client.search(
index="amazon_reviews",
knn={
"field": "text_vec",
"query_vector": qv,
"k": 100,
"num_candidates": 100,
},
size=10,
)
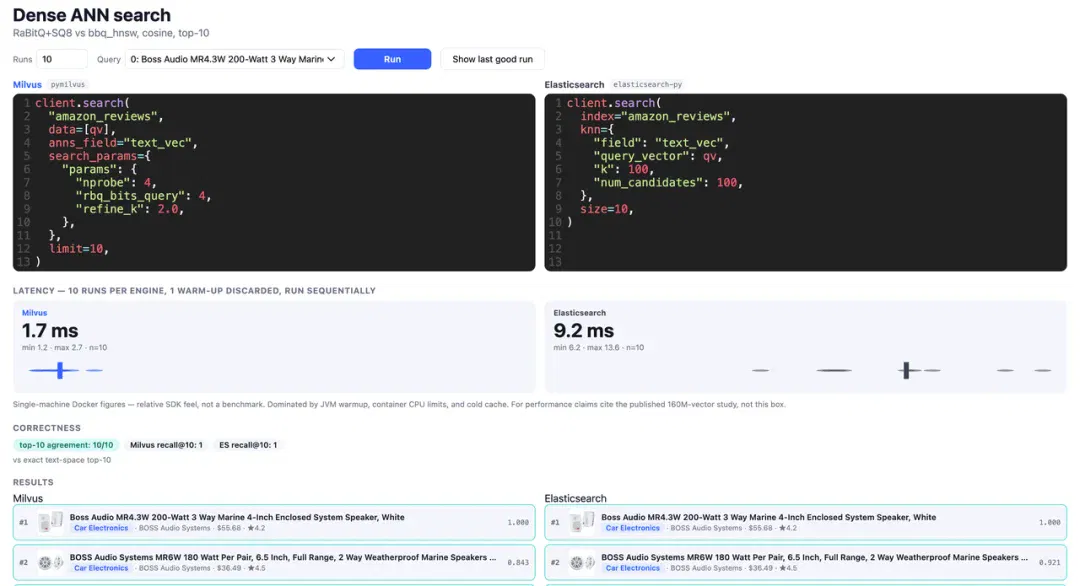
在高召回区间下,两边返回的近邻结果基本一致。相比召回结果,Milvus 参数调优呈现的规律更值得关注。
在实验默认配置 nprobe=64、refine_k=2.0 下,recall@10 约为 0.99。将两个参数分开调整,结果如下:
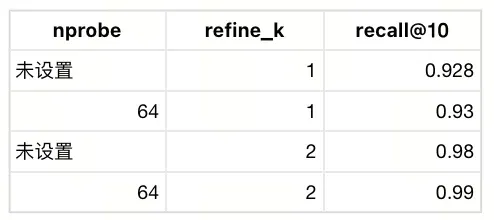
nprobe 的收益在约为 8 时就趋于饱和,继续提高,对召回率的影响不大。将 refine_k 从 1.0 提高到 2.0,却能带来 0.05~0.06 的提升。
也就是说,本次测试中的高召回率,核心来自 SQ8 对 1-bit 粗召回候选集的二次精排。单纯扩大粗召回范围,收益有限。
如果使用这组配置时召回率偏低,可以优先尝试提高 refine_k,本次实验中几乎没有额外开销。这里的取舍在于:1-bit 量化会损失精度,后续精排则可以同时兼顾低内存占用和高召回。
04
BM25:Top10 结果对齐,索引体积更小
关键词检索使用同一个查询 wireless earbuds:
# Milvus
client.search(
"amazon_reviews",
data=["wireless earbuds"],
anns_field="text_sparse",
limit=10,
)
# Elasticsearch
client.search(
index="amazon_reviews",
query={"match": {"text_snippet": "wireless earbuds"}},
size=10,
)
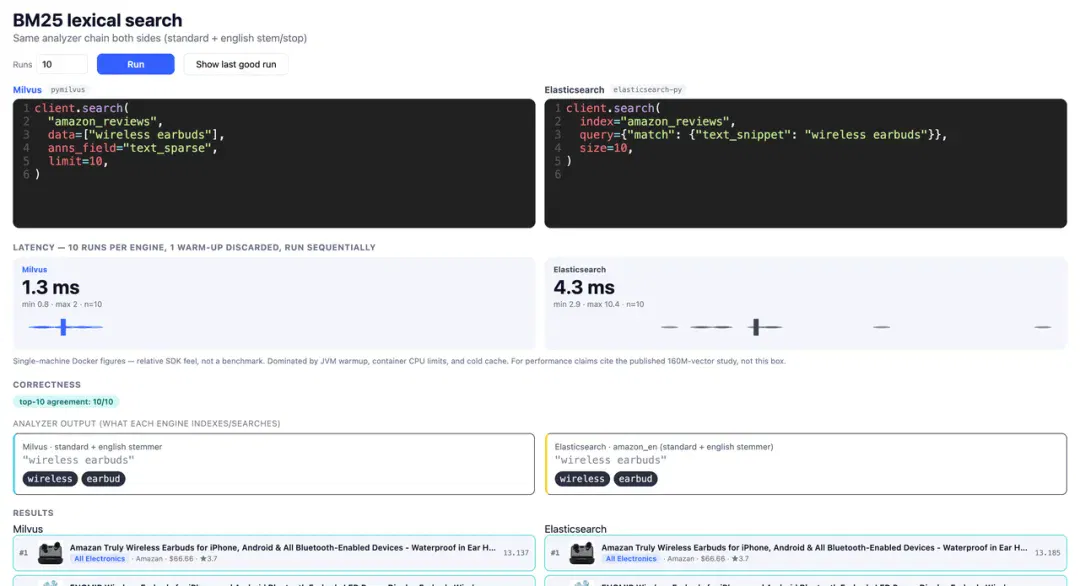
两边返回的前十条结果集合完全一致,Milvus 在不少运行中还略快一些。
更明显的差别在底层开销。Milvus 的 BM25 索引最初为 Zilliz Cloud 开发,随后贡献给开源社区,体积约为 Elasticsearch 的三分之一;同时没有 JVM 堆的开销,也不需要依赖副本保证持久性。
至少在这组查询中,把关键词检索交给 Milvus,并没有牺牲结果。
05
混合检索:核心差异在于多路融合的执行方
在 Milvus 中,向量检索、BM25 和 RRF 融合可以放在同一次调用里:
# Milvus
dense = AnnSearchRequest(
[qv], "text_vec", SEARCH, limit=50)
sparse = AnnSearchRequest(
["wireless earbuds"], "text_sparse", {}, limit=50)
client.hybrid_search(
"amazon_reviews",
[dense, sparse],
ranker=RRFRanker(),
output_fields=["parent_asin"],
limit=10,
)
Elasticsearch 的接口也很接近,同样可以用 rrf 融合两个检索器:
# Elasticsearch
sparse = {"standard": {"query": {
"match": {"text_snippet": "wireless earbuds"}}}}
dense = {"knn": {
"field": "text_vec", "query_vector": qv,
"k": 50, "num_candidates": 100}}
client.search(
index="amazon_reviews",
retriever={"rrf": {
"retrievers": [sparse, dense],
"rank_window_size": 50,
}},
size=10,
)
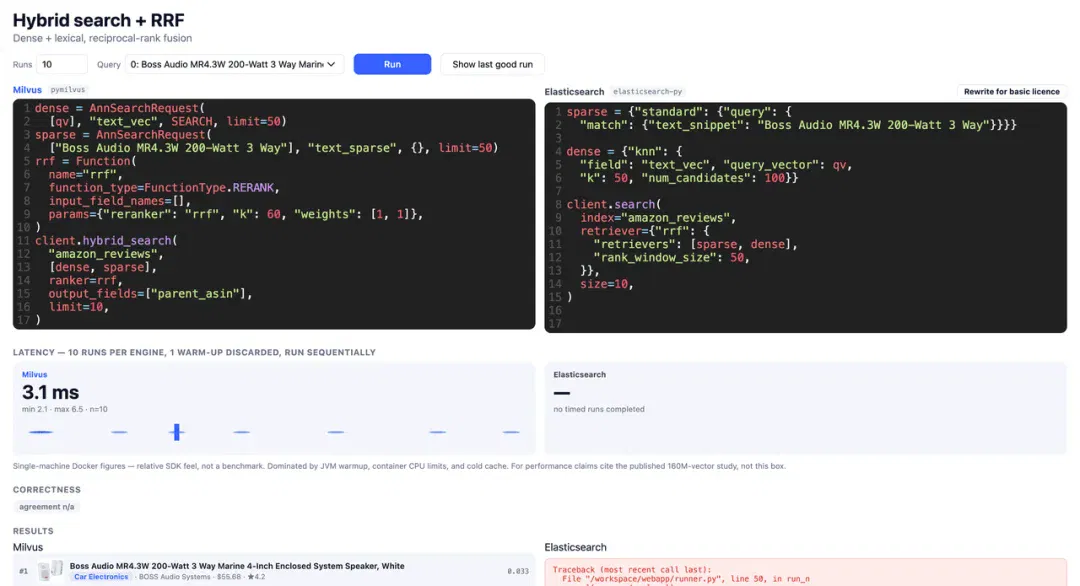
但这条查询在 Elasticsearch Basic 许可下会返回 403:rrf 和 linear 检索器属于 Platinum 级别。Milvus 的 RRFRanker 和 WeightedRanker 则包含在免费版本中。
如果只用 Basic 版本,只能手动给 knn 和 match 设置 boost 权重做加权融合:
# Elasticsearch, basic-licence rewrite
client.search(
index="amazon_reviews",
query={"match": {"text_snippet": {
"query": "wireless earbuds", "boost": 0.3}}},
knn={
"field": "text_vec", "query_vector": qv,
"k": 50, "num_candidates": 100, "boost": 0.7,
},
size=10,
)
但这种权重很难调优:BM25 分数没有固定上限,而余弦相似度区间在 0~1,0.3 和 0.7 并不代表两路检索在最终排序里的真实贡献。语料分布一变,权重就要重新调试。
双引擎架构里最头疼的分数对齐问题,在这里依然存在。
Milvus的RRF 基于名次融合,避开了分数尺度不一致的难题。对于希望简化上层代码的团队,这种引擎原生支持免费的服务端融合,是个很有价值的能力设计。
06
分组:group_by 与 collapse能否直接取到十个不同类别
搜索结果常常还要满足展示要求,例如每个商品类别只返回一个结果。
# Milvus
client.search(
"amazon_reviews",
data=[qv],
anns_field="text_vec",
group_by_field="main_category",
group_size=1,
search_params={"params": {"nprobe": 1, "rbq_bits_query": 4}},
limit=10,
)
# Elasticsearch
client.search(
index="amazon_reviews",
knn={
"field": "text_vec",
"query_vector": qv,
"k": 800,
"num_candidates": 1600,
},
collapse={"field": "main_category.keyword"},
size=10,
)
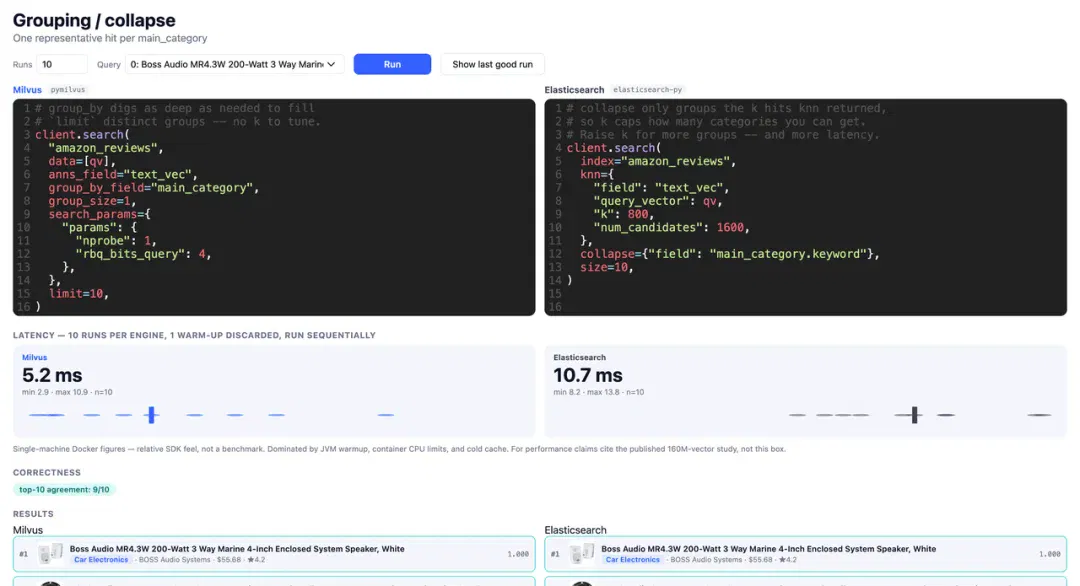
Milvus 的 group_by 机制会持续召回候选,直到凑齐 limit 指定的不同分组数量。Elasticsearch 的 collapse 只能在 kNN 已经召回的候选集内做去重分组,最终能覆盖多少类别,完全取决于候选池里的数据分布。
如果召回的候选集中大量结果集中在少数分类,就只能继续放大 k,承担更高的检索开销。这也是示例里 Elasticsearch 配置 k=800、num_candidates=1600,而 Milvus 只需要 limit=10 的原因:前者需要提前捞大量候选兜底,后者直接以分组数量为目标。
对于需要按品牌、类别或文档去重展示的搜索,这个差别会直接影响查询配置。
07
多阶段重排序:业务规则也可以留在引擎内
分组之外,应用还经常需要把评分、价格等业务因素加入排名。Milvus 3.0.1 新增的多阶段重排序,可以把这些处理串成函数链,在一次搜索中完成。
下面的例子先加入商品评分,再对 200 个候选按价格重新评分、保留 50 个,最后加入评论数量因素,返回 10 个结果:
# Milvus
l0 = (FunctionChain(FunctionChainStage.L0_RERANK)
.map("rated", fn.decay(col("average_rating"),
function="linear", origin=5, scale=4))
.map("$score", fn.num_combine(col("$score"), col("rated"),
mode="weighted", weights=[1, 0.2])))
# L1 re-scores all 200 by price, keeps 50.
l1 = (FunctionChain(FunctionChainStage.L1_RERANK)
.map("cheap", fn.decay(col("price"),
function="gauss", origin=0, scale=30, offset=10))
.map("$score", fn.num_combine(col("$score"), col("cheap"),
mode="weighted", weights=[1, 0.2]))
.sort("$score").limit(50))
# L2: 0.5 -> 1.0 ramp up to 100 reviews, keeps 10.
l2 = (FunctionChain(FunctionChainStage.L2_RERANK)
.map("proven", fn.decay(col("rating_number"),
function="linear", origin=1e6,
offset=1e6 - 100, scale=100))
.map("$score", fn.num_combine(col("$score"), col("proven"),
mode="weighted", weights=[1, 0.2]))
.sort("$score").limit(10))
client.search(
"amazon_reviews",
data=[qv],
anns_field="text_vec",
function_chains=[l0, l1, l2],
limit=200,
)
Elasticsearch 使用 function_score 和多个 rescore 阶段表达同样的逻辑:
# Elasticsearch
client.search(
index="amazon_reviews",
query={"function_score": {
"query": {"knn": {
"field": "text_vec", "query_vector": qv,
"k": 200, "num_candidates": 400, "boost": 2}},
"functions": [{"linear": {"average_rating": {
"origin": 5, "scale": 4}}, "weight": 0.2}],
"boost_mode": "sum",
}},
rescore=[
{"window_size": 200, "query": {
"rescore_query_weight": 0.2,
"rescore_query": {"function_score": {"functions": [
{"gauss": {"price": {
"origin": 0, "scale": 30, "offset": 10}}}]}}}},
{"window_size": 50, "query": {
"rescore_query_weight": 0.2,
"rescore_query": {"function_score": {"functions": [
{"linear": {"rating_number": {"origin": 1e6,
"offset": 1e6 - 100, "scale": 100}}}]}}}},
],
size=10,
)
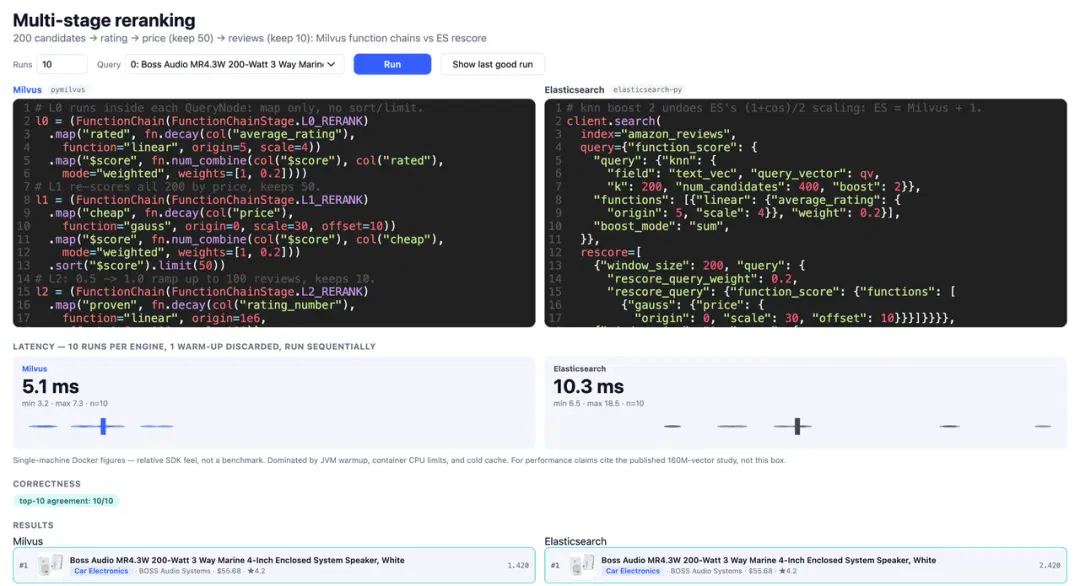
两边最终返回的前十条结果一致。对于示例中的业务排序,两种引擎都能在服务端完成,不必把候选全部取回应用层处理。
08
聚合:已有基础能力,成熟度仍有差距
检索和排序之外,如果还想把 Elasticsearch 一并替换掉,聚合也是绕不开的一项。
Milvus 3.0 新增了服务端聚合,通过 group_by_fields 指定分组,在 output_fields 中定义计算指标:
# Milvus
client.query(
"amazon_reviews",
group_by_fields=["main_category"],
output_fields=[
"main_category", "count(*)", "avg(price)",
"min(price)", "max(price)", "avg(average_rating)",
],
order_by_fields=[{"field": "main_category", "order": "asc"}],
limit=20,
)
Elasticsearch 从 1.0 版本起就支持聚合,对应查询如下:
# Elasticsearch
client.search(
index="amazon_reviews", size=0, request_cache=False,
aggs={"by_group": {
"terms": {
"field": "main_category.keyword",
"size": 20,
"order": {"_key": "asc"},
},
"aggs": {
"avg_price": {"avg": {"field": "price"}},
"min_price": {"min": {"field": "price"}},
"max_price": {"max": {"field": "price"}},
"avg_rating": {"avg": {"field": "average_rating"}},
},
}},
)
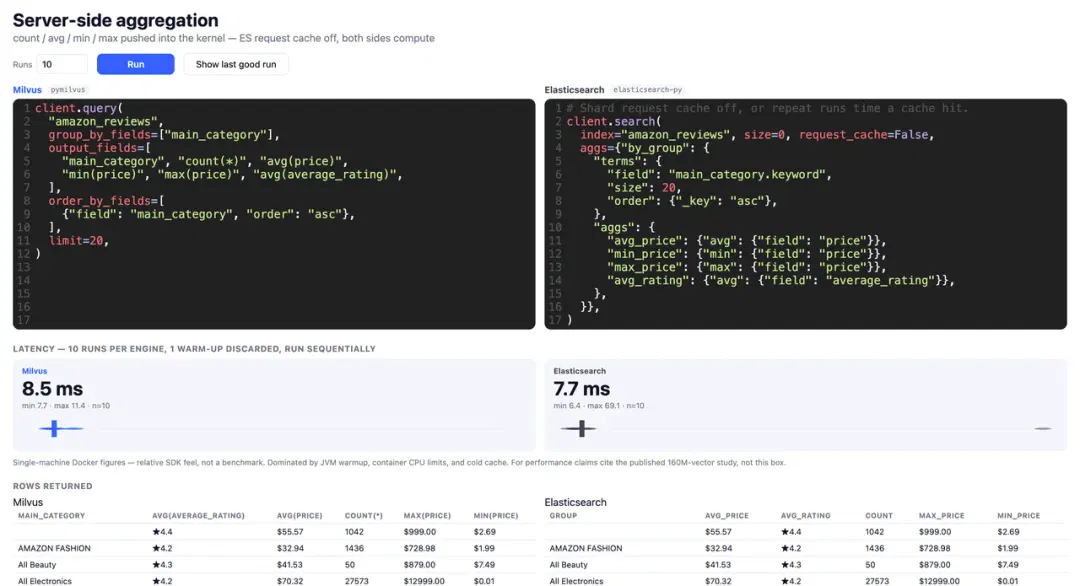
本次聚合结果一致,Elasticsearch 略快。(为了单独比较计算性能,测试关闭了 Elasticsearch 的请求缓存。)
两者的聚合方式也有区别。Elasticsearch 的 terms 聚合在字段取值数量超过各分片返回范围时,可能产生近似结果:分片只返回本地排名靠前的词项,可能导致计数偏低,或影响前 N 项的结果。Milvus 3.0 则对查询时可见的全部行进行精确聚合,计算各分组结果。
不过,Milvus 的聚合功能刚刚推出,还在持续优化。如果应用以聚合为主,不能只看检索表现就决定迁移,仍应先用自己的数据测试,不要更多要求,可以扫描文末二维码私信我们。
09
总结
前文提到的几项测试结果,以及Milvus几项规划中能力总结如下。
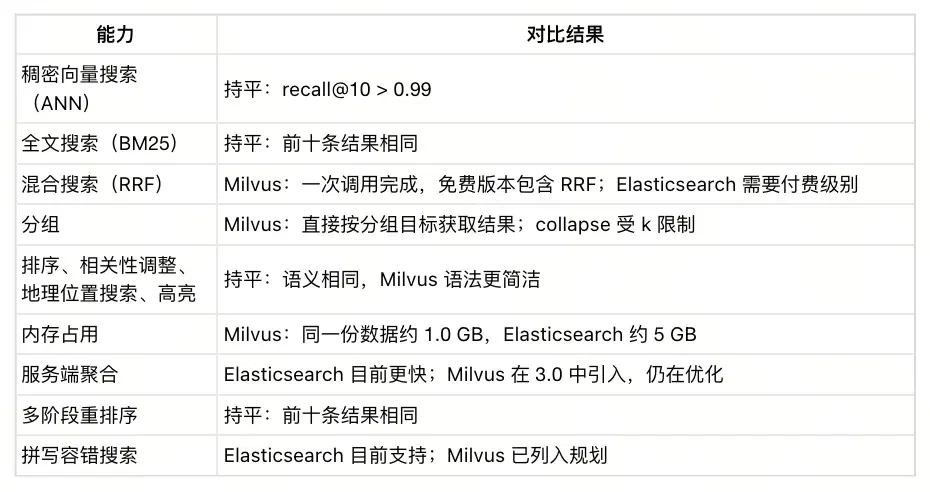
总的来说,Milvus 在核心关键词和向量操作方面与 Elasticsearch 不相上下,在混合搜索、分组和内存管理方面更胜一筹,仅在聚合成熟度和模糊匹配方面略逊一筹,而这两项功能目前都在其开发路线图中。
对于我们最常见的几种工作负载(关键词加语义搜索,越来越多地应用于 AI 和 RAG 用例),Milvus 3.0 能够很好地兼顾两者,甚至能以更小的资源占用取代双引擎架构。
如果您的搜索是传统的以聚合为先的 BM25 模式,请在迁移之前先进行基准测试;对于所有大规模的混合搜索或向量密集型搜索,Milvus 应该是您的首选。
小结
除本次实验外,不少团队在原有架构碰到Elasticsearch 或者OpenSearch的容量、成本、延迟瓶颈后,选择迁移到 Milvus / Zilliz Cloud:
- 123RF:图像检索,OpenSearch → Zilliz Cloud,2 亿素材向量;检索成本减半,延迟降到 50ms 以内
- PLAUD:智能体记忆,OpenSearch → Zilliz Cloud,单区域超 100 亿记忆片段,支撑 200 万台设备,平均召回延迟低于 200ms
- Rexera:RAG 与智能体,Elasticsearch → Zilliz Cloud,检索准确率提升约 40%,成本下降约 50%
- Orfium:音频匹配,Elasticsearch → Zilliz Cloud,2.5 亿音频向量,突破原有架构容量上限
- OpenArt:多模态检索,Elasticsearch → Zilliz Cloud,迁移 4.56 亿向量,无需重算嵌入;P99 延迟从 25 秒降至 300ms,计算成本下降 85%
以上数据来自客户落地案例与内部压测,实际效果受数据分布、索引参数、业务配置影响。
如果您也有迁移意向,不妨先用已有数据做一次结果复现(Docker 至少分配 16GB 内存)。
docker compose up -d
python data/fetch.py # 下载Parquet数据集,约370MB
docker compose exec demo python data/load_milvus.py
docker compose exec demo python data/load_es.py
全部对比代码仓库见:https://github.com/simonhearne/milvus_es_lab。
Simon Hearne
Solutions Architect at Zilliz
文章来自于"Zilliz",作者 "Simon Hearne"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Claude Code and Milvus tutorial: local search, recommendations and vector retrieval (opens in a new tab)
A Zilliz author builds local search, recommendation and similar-user APIs with FastAPI, Milvus Lite and MovieLens data, first checking the flow with hash vectors before switching to embeddings. The examples validate a local prototype; quality needs separate evaluation.
Milvus 引入 SVS Vamana,英特尔团队比较高召回检索与内存开销 (opens in a new tab)
英特尔团队在四组数据上对比 LeanVec 与两种 HNSW 存储方式。多数配置中查询和内存表现更优,文中也列出 FP16 更快的例外及构建限制。
NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图 (opens in a new tab)
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
AI搜索的下一站:可信度三层过滤机制,从点击监督到答案级反馈 (opens in a new tab)
百度联合中国科学院计算技术研究所与武汉大学的研究者围绕这一现状,提出答案支撑、内容可信与上下文组织三阶段框架,并结合百度搜索工业实践,梳理了从检索排序、可信度判断、结构化上下文组织到生成后反馈的优化链路。

长期知识库怎么维护?WeKnora 维护机制拆解与Milvus 接入实测 (opens in a new tab)
给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。