实测千问新出的PPT Agent,可算不用为了风格化牺牲二次编辑了。(在新窗口打开)
这段时间做了巨多PPT。 多到我现在都条件反射了,好不好看先放一边,先看AI容易错的细节。 文字有没有糊,布局是不是在装高级,图片是不是只是看起来有氛围感,该有的信息都没放进去, 再就是画面上有没有一
内容栏目
介绍和评测不同 AI 产品的功能、使用体验与适用场景。
这段时间做了巨多PPT。 多到我现在都条件反射了,好不好看先放一边,先看AI容易错的细节。 文字有没有糊,布局是不是在装高级,图片是不是只是看起来有氛围感,该有的信息都没放进去, 再就是画面上有没有一
SenseNova U1 是商汤最新发布的一个开源的多模态模型,它的 Lite 系列 8B 和 A3B 参数版本,目前已经在 Hugging Face 和 GitHub 上开源。APPSO 也提前拿到了测试资格,我们发现商汤这款新一代原生理解生成统一模型,就开源模型来说,已经做到了最好水平。

没错,用的就是主打长程任务、模糊指令遵循,跻身国产Agent第一梯队的小米MiMo‑V2.5 Pro。小米最新发布的MiMo‑V2.5系列,包含Pro旗舰Agent、全模态基座、TTS语音合成、ASR语音识别四大模型,综合实力对标国际顶尖水准。
昨夜,GPT-5.5果然按期发布了,全网没有白等。更炸裂的是,就在同一天,DeepSeek-V4紧随其后发布了!实测后,结果出人意料。
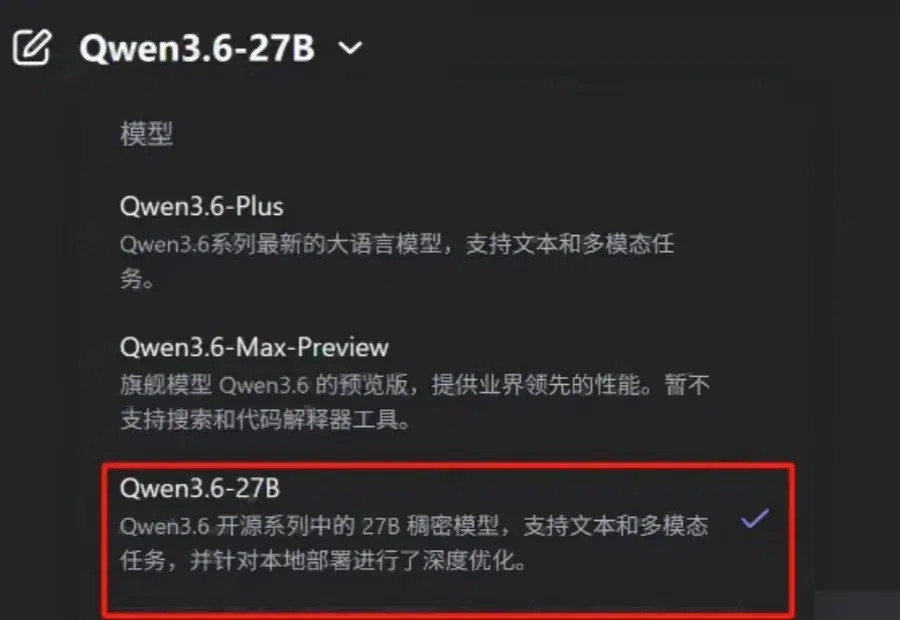
Qwen3.6系列全员集结完毕。 智东西4月23日报道,昨晚,阿里通义千问团队宣布开源Qwen3.6-27B——一款270亿参数的稠密多模态模型,支持思考与非思考模式。 与阿里上一代开源模型Qwen3.5-397B-A17B相比,Qwen3.6-27B以1/15的参数规模,在SWE-bench Verified、SWE-bench Pro、Terminal-Bench 2.0以及 SkillsBench上实现了反超,其编程能力提升明显,同时还具备较强的文本和多模态推理能力。 与相似尺寸的Gemma 4-31B模型对比,Qwen3.6-27B在大部分维度上,展现出较大领先优势。 随着Qwen3.
AI第一次从包工头,变成了建筑设计师。 以前我们混互联网论坛时,常说「无图无真相」,意思是你说的话我不信,有本事就把图或照片发上来。 之所以会这样,原因很简单,当时Photoshop门槛很高,会P图的人在论坛上凤毛麟角,大家默认图片的真实性远高于文字。 但过去这半年,AI生图领域的竞争异常激烈,很多人可能只是耳闻,却不清楚具体激烈程度。我来和你盘点一下。 首先是2025年8月,谷歌发布图像模型Nano Banana,一下子把AI生图的天花板抬高了一大截。 而在年底,面对谷歌Gemini 3+Nano Banana的全面攻势,山姆·奥特曼在公司内部拉响「红色警报」(Code Red),要求全员集
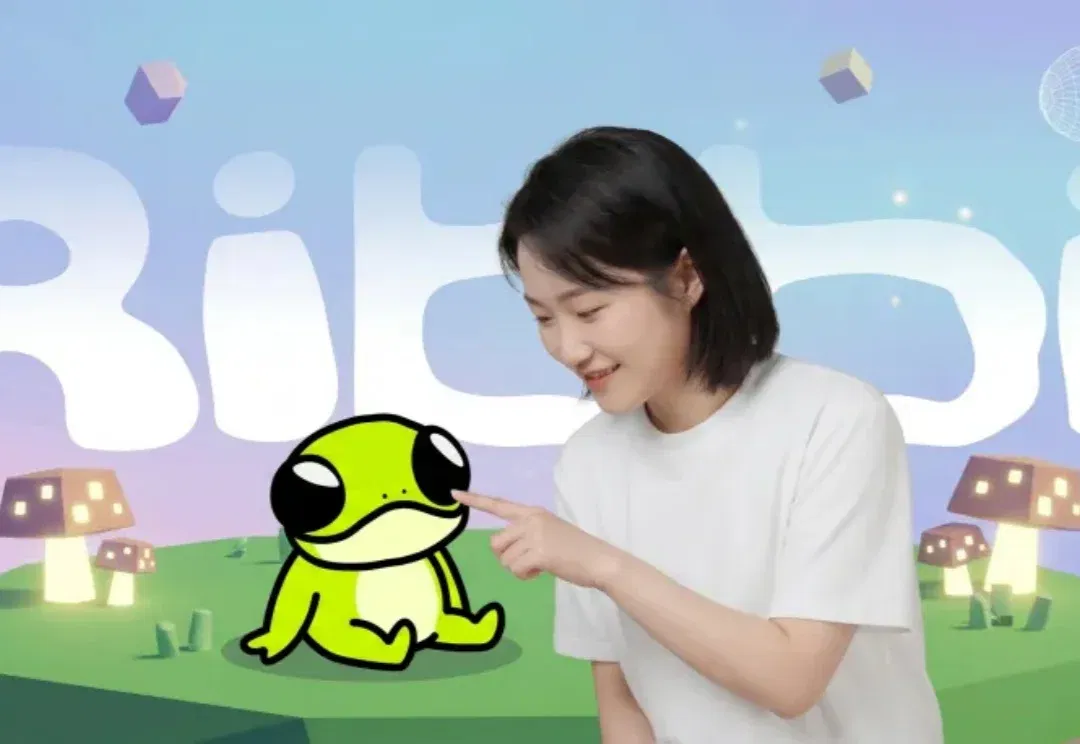
上次 Ribbi 刚开始内测的时候,好友 Joanna 就给了我邀请,东忙西忙没来得及体验,这两天玩上了,也是感受到了这个小青蛙的魅力了。
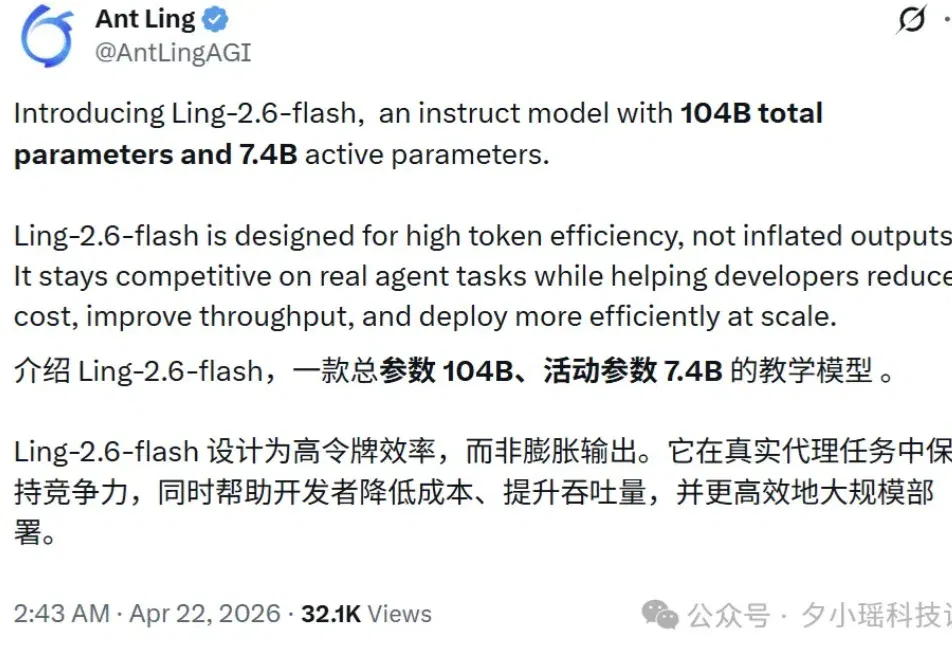
用AI跑批量任务的人,手里基本都有一个干活的模型,不是最聪明,但要快、要便宜,稳定不出岔子。
Kimi 刚刚发布了 K2.6,Agent 模式也同步大升级。
前段时间有个叫 Happy Horse 的模型实火了一把,在知名 AI 评测分析平台 Artificial Analysis 上,直接把 Seedance 2.0 挤到了第二。
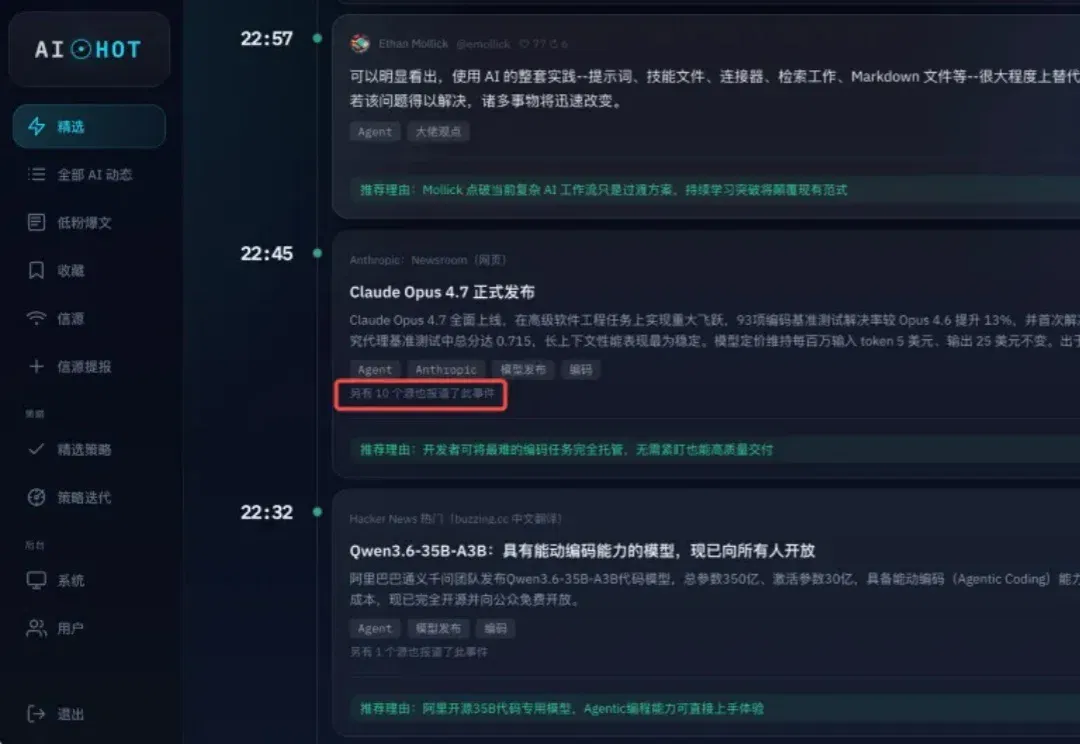
果不其然,最近一周Claude天天崩,就是为了新模型做储备。
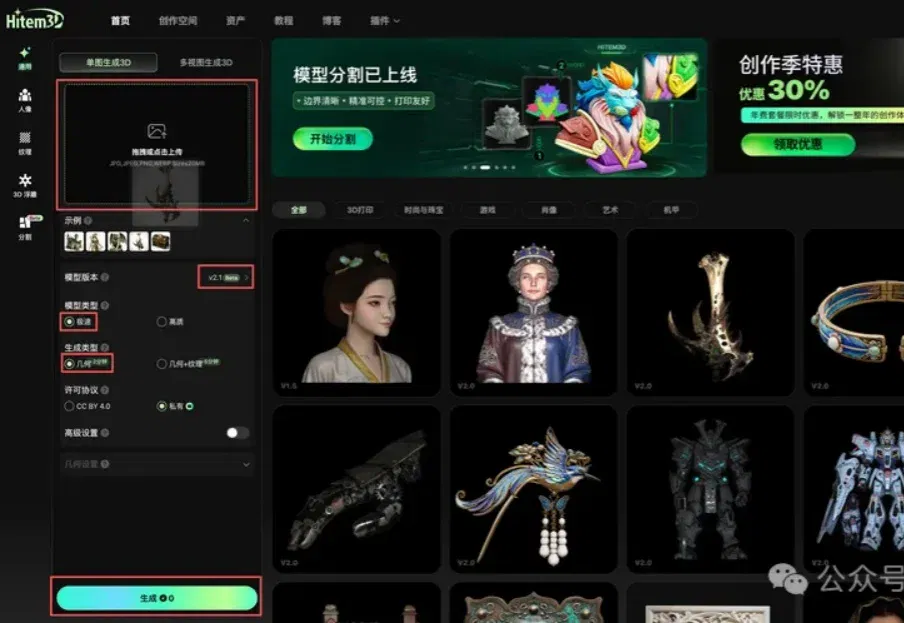
前两天我刷到一个工具的时候,第一反应其实不是拿真人照片试,也不是拿潮玩图试。
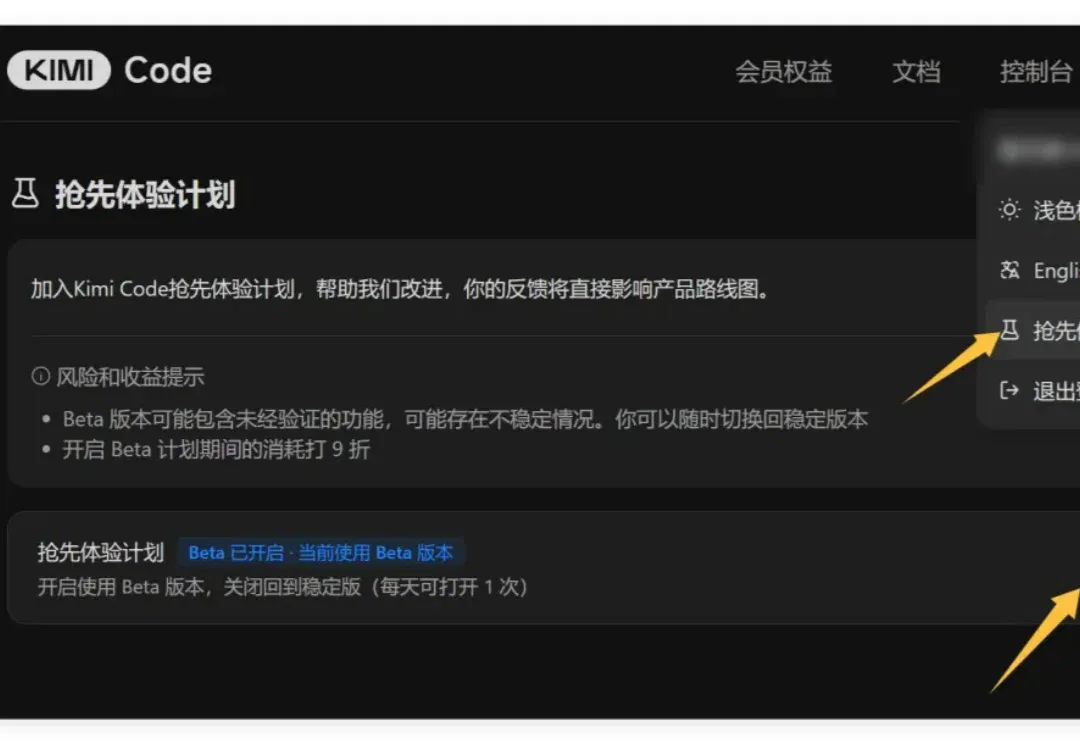
刚测完 Kimi K2.5,就拿到 Beta 版内测模型了。 一点喘息的机会都不给啊~~
最近我测试了一下,用AI辅助创作公众号小号,陆续发了一些文章,效果有点超预期。
从春节开始,能直接操控电脑替人干活的开源项目 OpenClaw(网友戏称龙虾)在科技圈彻底爆火。
我以前一直觉得,所谓的 AI Agent,要么只是一个更聪明一点的对话框,要么就是一堆需要写代码、拼流程才能跑起来的自动化脚本。
专门为短剧、动漫和影视内容创作训练的垂直模型,长什么样?
上次 0.83 那条路没了,现在还能怎么便宜开 GPT Plus
联想版“龙虾”来了:预装海量Skill、跨端无缝接力。
最近三个月,我用 Claude Code Vibe Coding 了几个项目,非常有意思,写篇文章记录一下。
参与交流
了解加入交流群的方式,阅读内容无需登录。