用K3和GPT的同款考题,测了Gemini 3.6 Flash的前端(在新窗口打开)
谷歌的前端功底有多深,不需要任何人来认证。
内容栏目
介绍和评测不同 AI 产品的功能、使用体验与适用场景。
谷歌的前端功底有多深,不需要任何人来认证。
WAIC 2026上,百度秒哒带来了3.5版本。据官方数据,秒哒累计服务超过3500万用户,创造了350万个具有商业价值的应用,每天有近20万人在使用这些应用解决真实问题。
开始忘记软件以后,创作才真正开始。 三个月前,我第一次体验 LibTV。它更像一套专业的视频制作工具。我花了很多时间理解 Workflow、节点和模型之间如何协作,最后得出的判断是:只要掌握了 LibTV,就能完成过去一个影视团队才能完成的事情。 三个月后,LibTV 上线了 Agent 和 Skill 功能。我决定重新体验一次。 这一次,我给自己设了一个限制:不学习任何功能,不切换任何面板,全程只和 Agent 对话,来做出 AI 视频。 做到第三个 Demo 时,我突然意识到,我开始想的,不再是下一步该怎么操作,而是这个故事还能怎么发展。 这时,软件退出了,创作进入了。 过去大家讨论 AI
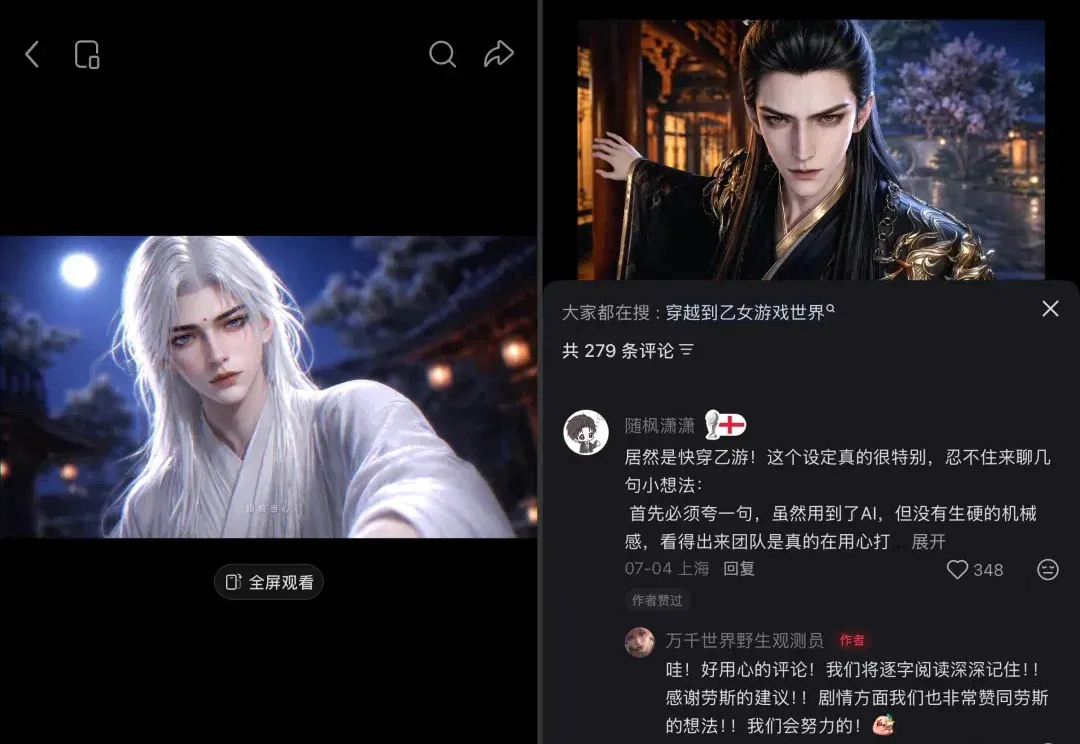
最近有三个女孩火了。 起因是市面上的乙游总缺她们真正想看的角色和剧情,她们干脆用 AI 做了一支快穿乙游 PV,视频发出后迅速引发热议,获得全网万赞。 比点赞更说明问题的,是评论区那一串追问:「这是什么游戏?」「什么时候能玩?」 严格来说,这个内部代号「万千」的项目还算不上一款真正的游戏。但三个女孩没等游戏做完,就先验证了一件过去往往要拖到开发后期才敢确认的事:这套角色和故事,真有人想玩。 更有意思的是 PV 里那两次醒目的输入框:女孩们敲进角色的剧情描述,AI 顺着这些要求,把接下来的画面生成出来。 这正是她们动手的理由,既然现有乙游里想看的角色和情节不够,那就用 AI 自己补。 传统流程里
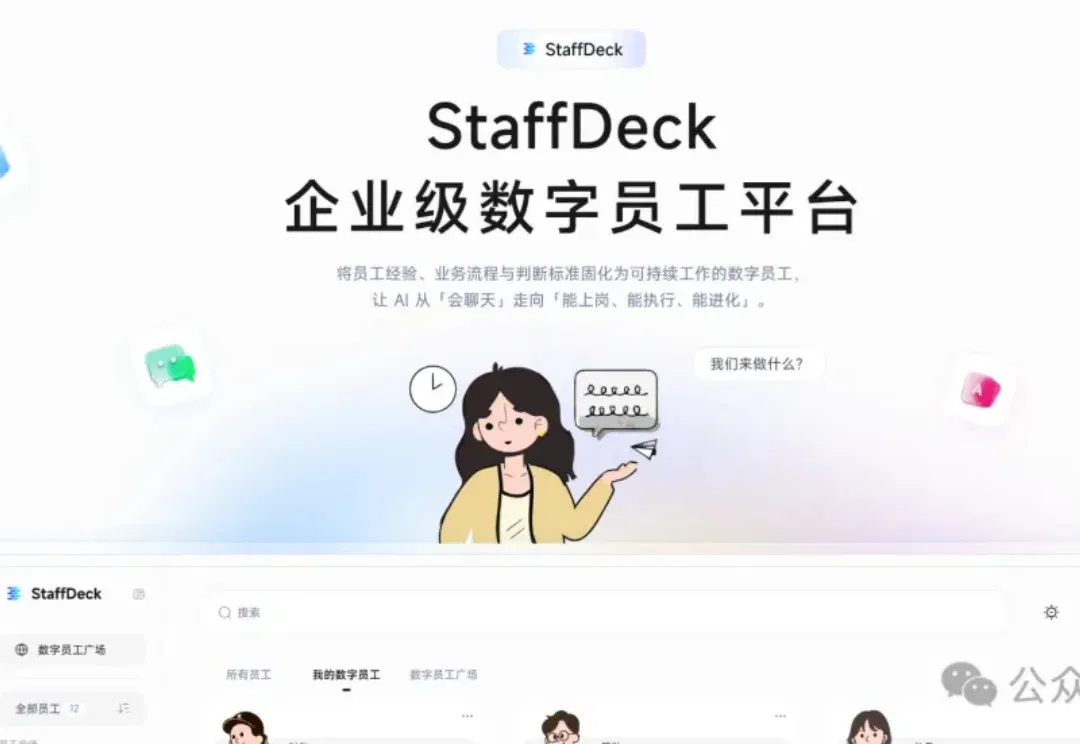
面壁智能上周开源了一个叫 StaffDeck 的东西。
我刚刚 AGI Bar 小程序里建了一个共享钱包,并往里面充了 1 万块,未来 24h可点开领取
发布之前,我在 X 上看到有人说,测 K3 的感觉就像在测 Fable 5。虽然离 Fable 5 还差一点点 🤏,但超过 Opus 4.8 和 GPT 5.5 基本没有问题。在前端能力,K3 的提升非常明显,我已经用它复刻了前段时间爆火的独立工作室 Abeto 推出的一款 3D 网页游戏 《 Messenger》(ps. 音乐手动配的,主角模型是 K3 自己判断、自主去游戏官网找的)
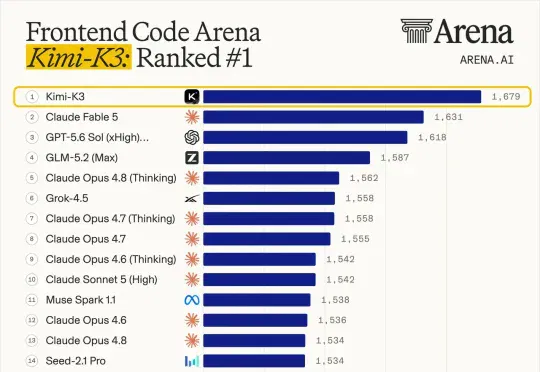
今天凌晨看到 Arena AI 更新 Code Arena 榜单时,我第一反应是有点意外。刚刚发布的 Kimi K3 拿到了 1679 分,排在全球第一,压过了 Claude Fable 5 的 1631 分和 GPT-5.6 Sol 的 1618 分。
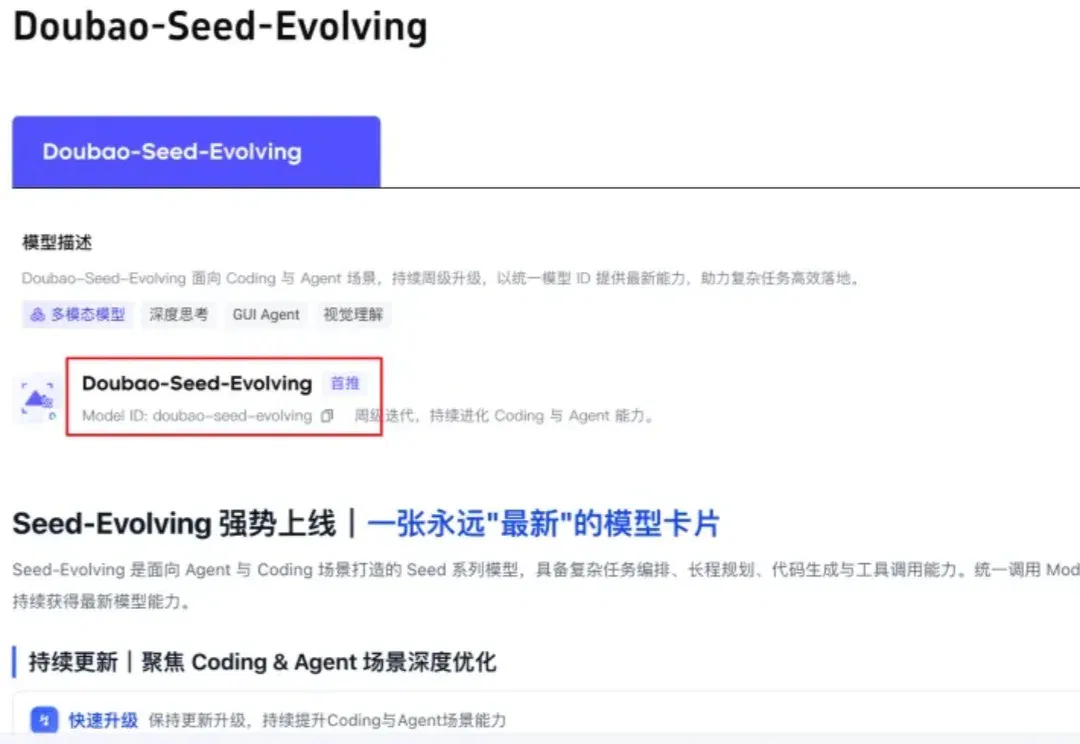
大家好,我是袋鼠帝。 前几天,火山的朋友提前跟我同步了一个消息,说豆包Seed模型又更新了。
不知不觉,整个AI影像行业全线迈进了Agent创作与AI视频C端普及的时代。
过去半年,国产大厂扎堆发布一种新东西:桌面Agent。如果你最近在刷相关讨论,会发现 WorkBuddy、豆包专业版、QoderWork 这三个名字出现得特别频繁。如果一个普通办公用户今天就想选一款桌面 Agent,到底该先试谁?
7 月 8 日,xAI 发布了 Grok 4.5。马斯克给的定位很直白,「Opus 级别,但更快,更便宜」。
AI 生图最难的地方,早就从「生成一张好看的图」变成了「把那张差一点的图改对」。
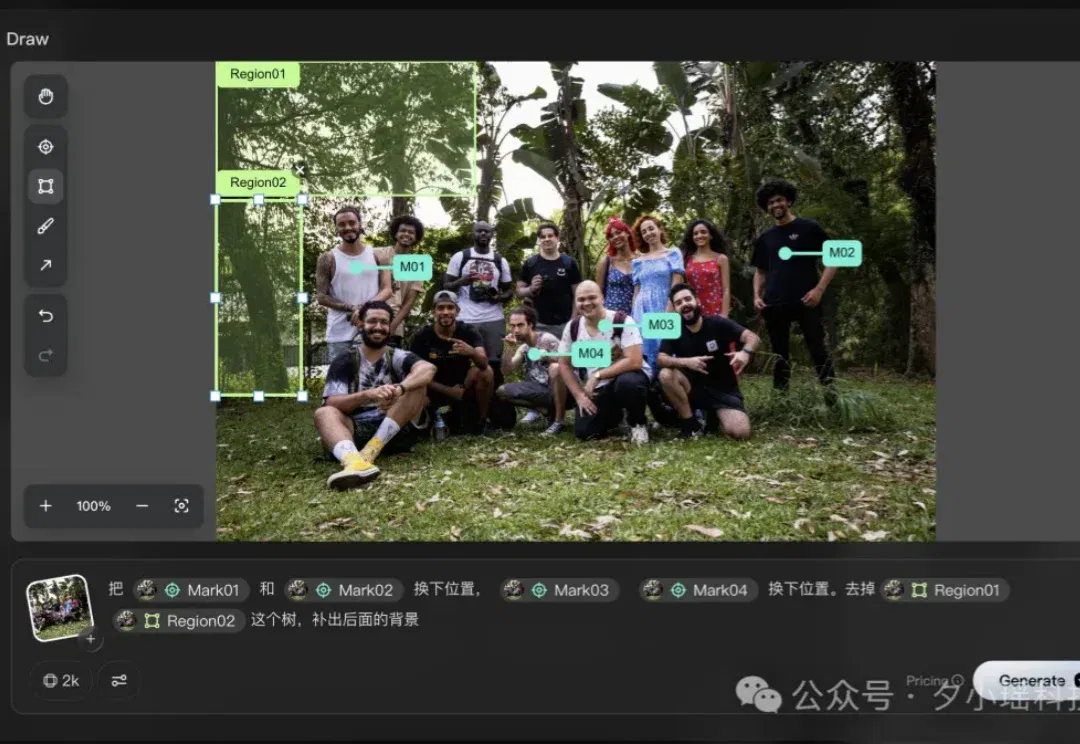
用 AI 生图的人,应该都体会过这种痛苦。
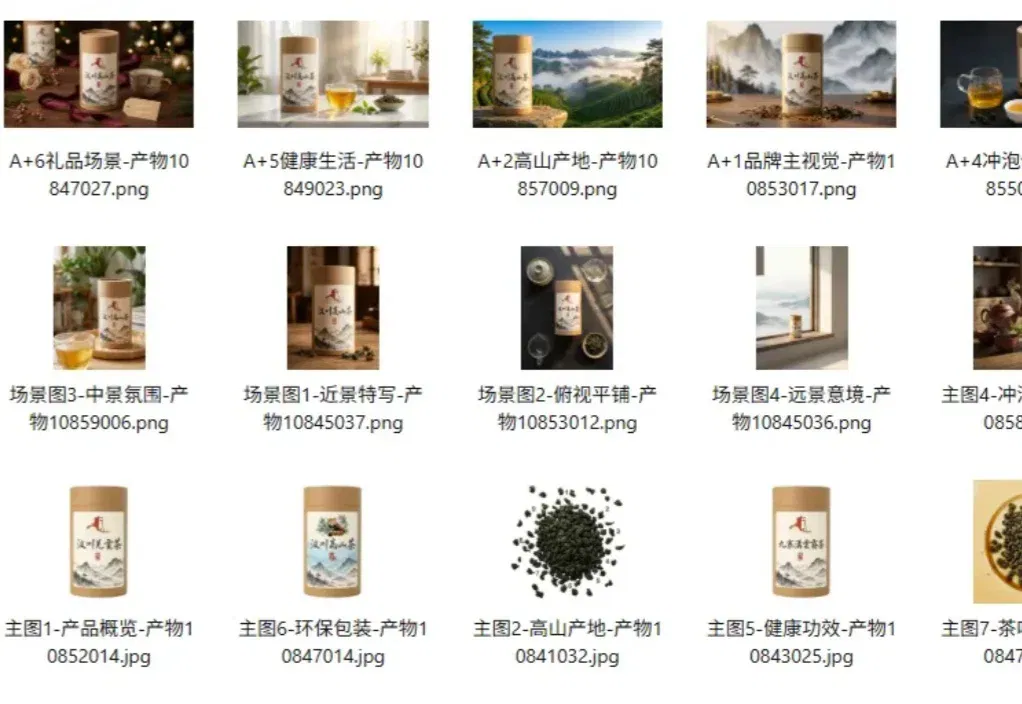
大家好,我是冷逸。 前段时间,我设计了一家民宿「冷同学的院子」,视觉还算有点意思,不少朋友跑来问设计上的事。也有人问我:要是自己网上开店,有没有那种“够简单、说一句就能出设计”的电商工具?
我自己花时间,把三款主流国产桌面 Agent 从头到尾测了一遍:Trae、WorkBuddy、ZCode。用三个最日常的工作任务——做 PPT、分析表格、写小游戏,看看它们到底能不能帮普通打工人干活。这篇文章就是完整的实测记录,希望对你选工具有点帮助。
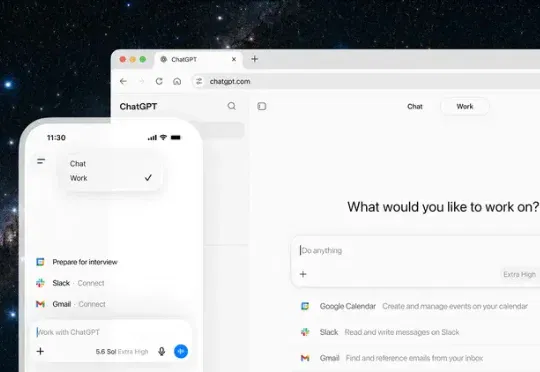
7 月 9 日,OpenAI 一口气发了三样东西,新模型 GPT-5.6,一个把 Chat、Work、Codex 装进同一个壳的新桌面应用,以及本文的主角 ChatGPT Work。官方的说法是,ChatGPT 从此不再只是回答问题,而是把活真正干完,交出来的不是聊天记录,是表格、文档、PPT,甚至一个能直接分享的网站。
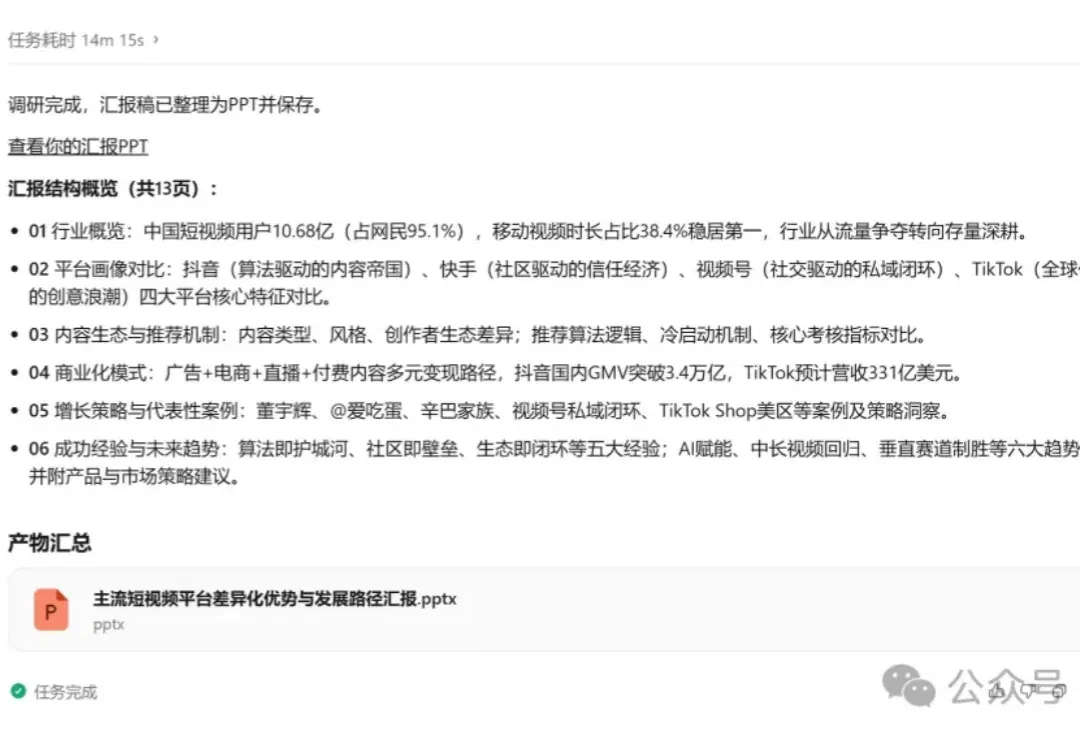
最近这段时间,国内外模型更新得很快。 如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。 但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。 尤其是 Agent 场景。 一个复合任务需要大模型去调用多个工具,比如让模型做一份 PPT,它并不是简单写几页文字。中间要先理解需求,再去搜索资料,阅读网页,提取关键信息,整理成汇报结构,必要时还要生成代码或调用插件,最后产出一个可以正常使用的PPT文件。 下面测试两个Agent任务,使用同样的提示词,相同的Agent工具-Trae Work。
上个月也就是昨天,我写了一篇LongCat 2.0的实测,用四个任务测了一下它的编程能力,当时我的评价是「有些地方惊艳,有些地方还差点意思」。
微信和企业微信的 Agent,同时出牌。
参与交流
了解加入交流群的方式,阅读内容无需登录。