Claude新风口杀疯!Eazo让海外年轻人上头,刷App成瘾(在新窗口打开)
Eazo 是一个 AI 原生互动内容创作与分发平台。Creator 可以用自然语言创造真正可运行的 App、3D 世界和 AI Agent,并直接发布到 Eazo Feed,让作品被发现、被使用、被试玩、被 Remix,并在真实反馈中找到增长和商业化机会。
内容栏目
聚合人工智能领域的重要资讯、产品发布、行业动态与商业变化。
Eazo 是一个 AI 原生互动内容创作与分发平台。Creator 可以用自然语言创造真正可运行的 App、3D 世界和 AI Agent,并直接发布到 Eazo Feed,让作品被发现、被使用、被试玩、被 Remix,并在真实反馈中找到增长和商业化机会。
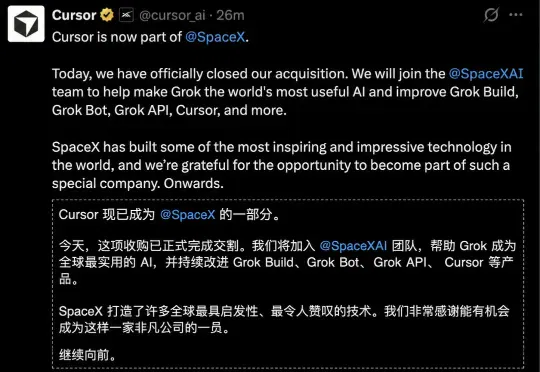
就在刚刚,Cursor彻底消失!昨晚,Cursor官方账号亲自官宣:「Cursor,现在是 SpaceX 的一部分。」SpaceX随后确认:此次收购已经正式完成——它被600亿卖给了马斯克。
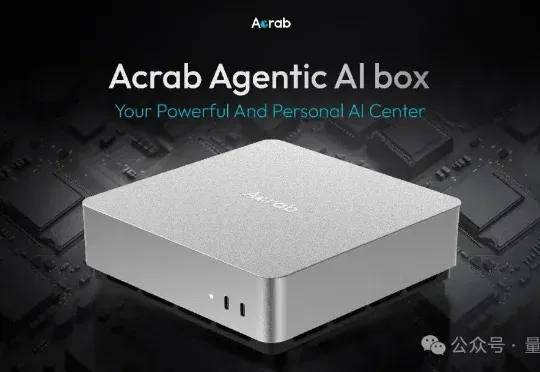
成立不到三年,首颗AI芯片进入量产,又拿下1.3亿美元B轮融资,Acrab正在成为亚洲AI芯片市场里最值得关注的新贵之一。据DealStreetAsia报道,这家总部位于新加坡的AI计算基础设施公司近日完成B轮融资,Vertex Growth等机构参与投资。
今日,Meta超级智能实验室大牛、AI研究科学家余家辉宣布将离职创业。余家辉在帖子上提到离职原因是,随着时间推移,他意识到有一个对人类未来至关重要、却鲜少有人探索的事,他要将全部精力投入到这件事上。不过,他并未透露具体的创业方向。
据路透社援引三位知情人士爆料,苹果已和阿里巴巴展开合作,联合训练一款专门面向中国市场的大语言模型。就在8月8日,苹果悄然更新Mac使用手册,新增《在Mac上配合Apple智能使用千问》相关章节,这也是苹果首次对外官方披露国行Apple智能的合作细节,不过该章节后续已被删除。
《智能涌现》从相关人士处获悉,混元资深研究员徐灿在近期加入腾讯WeLM团队,从事大模型研发相关工作。多名知情人士透露,在姚顺雨接手腾讯大语言模型研发前,徐灿在混元LLM体系中担任后训练一个方向上的负责人。值得一提的是,这次转岗发生在微信持续强化自研大模型和Agent能力的阶段。
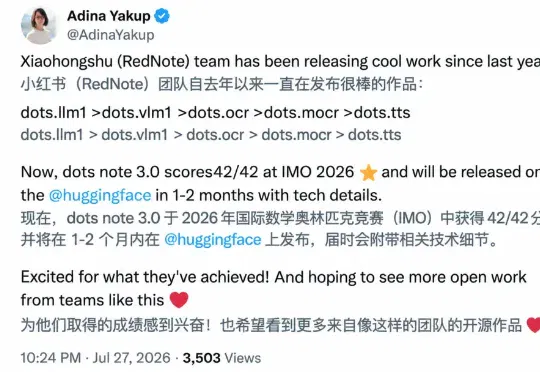
上个月,小红书自研大模型「dots-note-3.0」创下了一个历史记录:AI 首次在国际奥数竞赛中斩获官方认证的满分42 分。此后,社区最关心的问题,就是模型什么时候开源。就在今天,小红书 dots 模型实验室(以下简称 dots 实验室)宣布开源 dots3-note preview!
近日,Oh My Pi 作者 can1357 在 X 上发文,展示了利用模型 API 漏洞,直接提取 GPT-5.6、Claude Fable 5 等顶级模型完整内部推理记录的方法。他发现,做到这些并不用破解加密,只需要关闭模型的隐藏思考,再给它一个思考工具,就能让模型主动输出内部推理格式。
就在刚刚,智谱发布了其最新一代旗舰模型GLM-5.3,并宣布模型将在两周内开源。这是一个拥有7430亿个参数的模型,和此前的GLM模型一样主打编程。在多项主流基准测试中,GLM-5.3位居所有已开源或即将开源模型中的第一;其在编程与智能体任务上的能力,已逼近Claude Fable 5、GPT-5.6 Sol等海外顶尖模型。
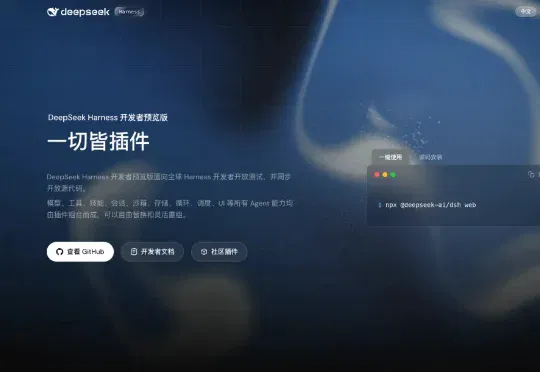
在昨天正式发布DeepSeek V4 Pro正式版之后。 预告了很久的,DeepSeek家自己的Agent产品终于也发出来了。 名字叫,DeepSeek Harness。 理念也很清晰,一切皆插件。 可能是有史以来最快的速度,截止到我写完文,它在Github上到了3万7的Star。
这次百花奖时间紧、任务重,好在豆包帮了金启棣大忙。在豆包工作任务模式下,他把舞台数据、观众规模、视觉需求等一并交给豆包。豆包很快就生成了舞美概念和效果图,让原本模糊的创意迅速落地。在此基础上,舞美设计团队继续精修,省下了大量做基础工作的时间。
据路透社最新消息,在8月6日举行的Google DeepMind全员会上,管理层宣布:数个非技术团队将被移出DeepMind,转入谷歌的公司汇报体系。会上,哈萨比斯和接班人Koray Kavukcuoglu还在安抚员工,称实验室的日常工作不会发生变化。
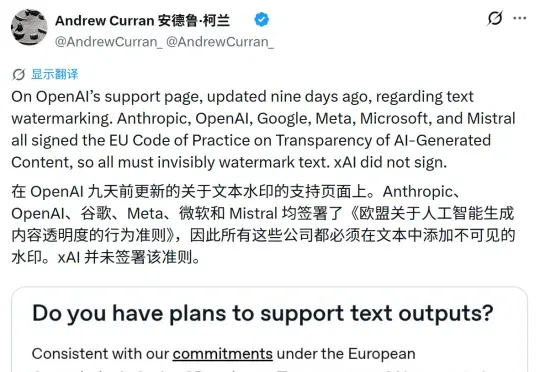
OpenAI 官方公告,包括 OpenAI、Anthropic、Google、Meta、Microsoft 在内的一大批公司,签署了欧盟《AI 生成内容透明度行为准则》,承诺推进 AI 生成内容的标记与检测。看起来 AI 内容马上也要有「署名」了。
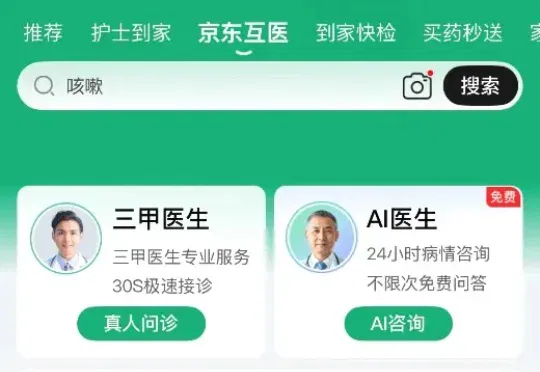
京东健康医疗 AI 产品总监刘慧至今记得这个故事。此前在广州的一次合作洽谈中,对方主动向她讲起了这段经历。她和我一样,也是一位母亲,刘慧说。那天孩子发烧后,这位母亲没有像往常那样立刻请假、打车,带着孩子去医院,而是决定先问问「大为」。
今天,我们特别邀请到了百度搭子的负责人李景秋。在这场对话中,他带放下了官方客套,抛出了许多极其犀利且颠覆认知的一线洞察:关于工具终局:为什么他认为 AI 不是在“辅助”Excel,而是正在让用户“彻底忘掉 Excel 公式”?
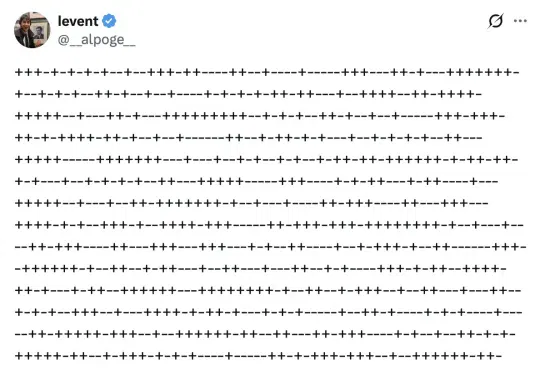
前不久用Fable 5推翻雅可比猜想的Anthropic研究员,又吭哧吭哧和两个人类伙伴带着Claude,做出了668阶哈达玛矩阵!(好数学家不挑AI模型,doge)不过这人每次有成果都不明说,发一堆只有内行才看得懂的东西。
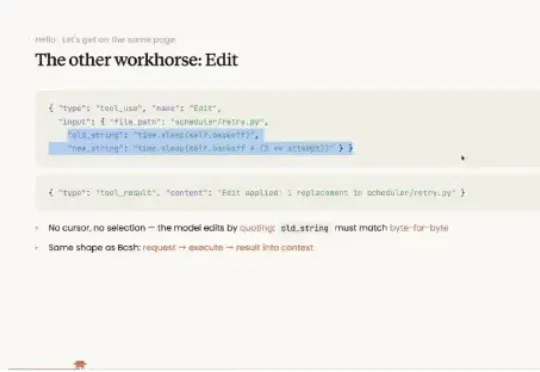
过去一年,编程 Agent 的能力大幅提升,软件工程师对它们的要求也比以往任何时候都高,但上下文窗口的大小却基本停滞不前——一年前,一百万个 token 大致就是最先进的水平,如今依然如此。随着我们逐渐进入 Agent 日常处理 Monorepo(单体仓库)级任务的世界,将越来越多的信息塞进模型那固定的上下文限制中,这种需求已经变成了一项实实在在的全职工程任务。
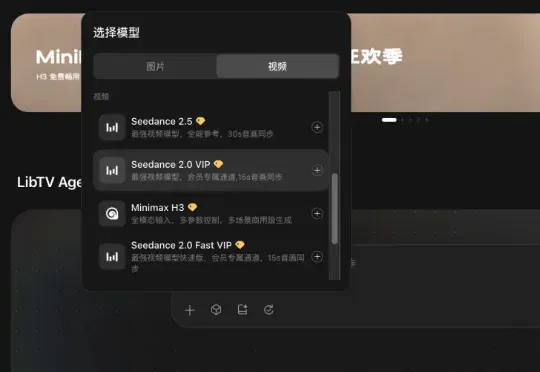
视频模型这个月很热闹。7 月 31 日,MiniMax H3 和字节跳动 Seedance 2.5 同日发布。3 天后,MiniMax H3 正式开源;8 月 7 日,Seedance 2.5 开放 api。模型越来越好了,但产品能把它用好吗?
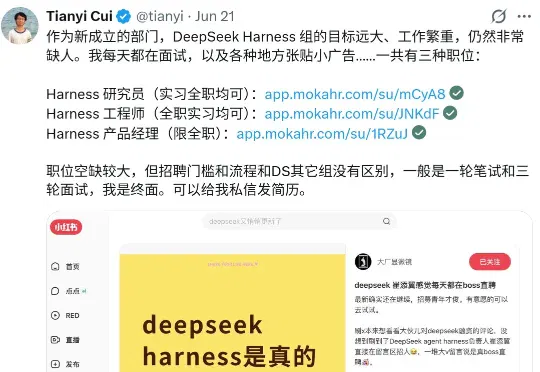
今天凌晨,DeepSeek V4 Pro 正式版发布,引发热潮。现在,半天过去,DeepSeek Harness (开发者预览版)也来了!当然,这并不意外,毕竟该项目之前已经铺垫了很久了,比如 DeepSeek Harness 团队的崔添翼就一直在社交网络上发预热贴以及为该团队招募人才。
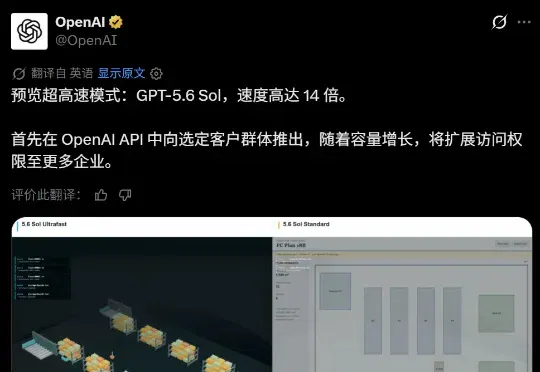
8 月 14 日凌晨,OpenAI 联合 AI 芯片厂商 Cerebras 正式预览了其旗舰模型 GPT-5.6 Sol 的全新服务层级「超高速模式」(Ultrafast Mode)。在该模式下,GPT-5.6 Sol 的输出速度最高可达 750 tokens/s,相比目前 Standard(标准)模式约 53 tokens/s 的推理基线,速度提升最高达 14 倍,同时不降低任何质量。
参与交流
了解加入交流群的方式,阅读内容无需登录。