“我看到了 Scaling Law 的信号” | 对谈清华叉院助理教授徐梦迪:具身智能、世界模型、真正的泛化(在新窗口打开)
本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
内容栏目
聚合人工智能领域的重要资讯、产品发布、行业动态与商业变化。
本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
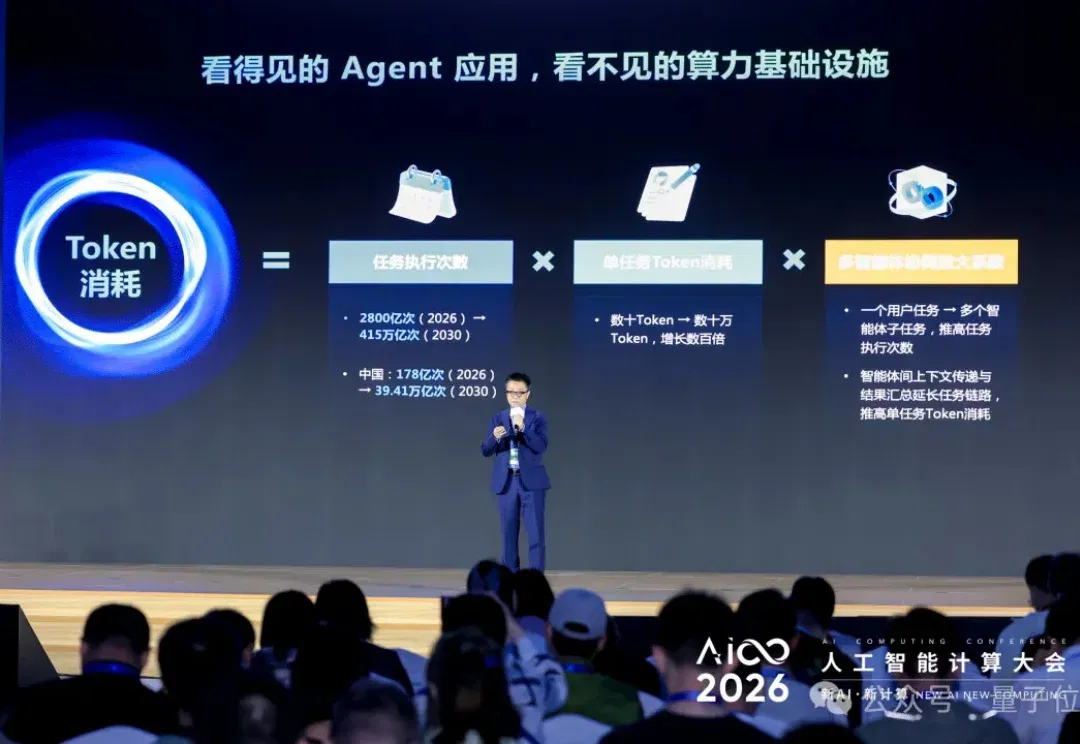
AI算力的竞争,多年来就一个字——堆。 堆卡、堆机柜、堆发电机……似乎计算卡足够多、集群足够大,就能站在食物链顶端。 但算力「够不够用」这个问题,已经不再能单靠堆卡来解决,它开始分化出越来越多的层面。 第一个问题关于智能上限,也就是你的算力能撑起多强的智能。 前沿模型的参数规模、上下文长度、推理深度在同时变大,Agent可能连续运行几个小时甚至几天。 模型在一台机器里装不装得下、跑得快不快、长时间跑起来稳不稳,都需要被重新考量。 另一个问题是智能规模,这个问题更直击灵魂——你的算力能以多低的成本生产多少智能? Token需求在爆发,但推理负载是多元的,Prefill和Decode的计算特征不同
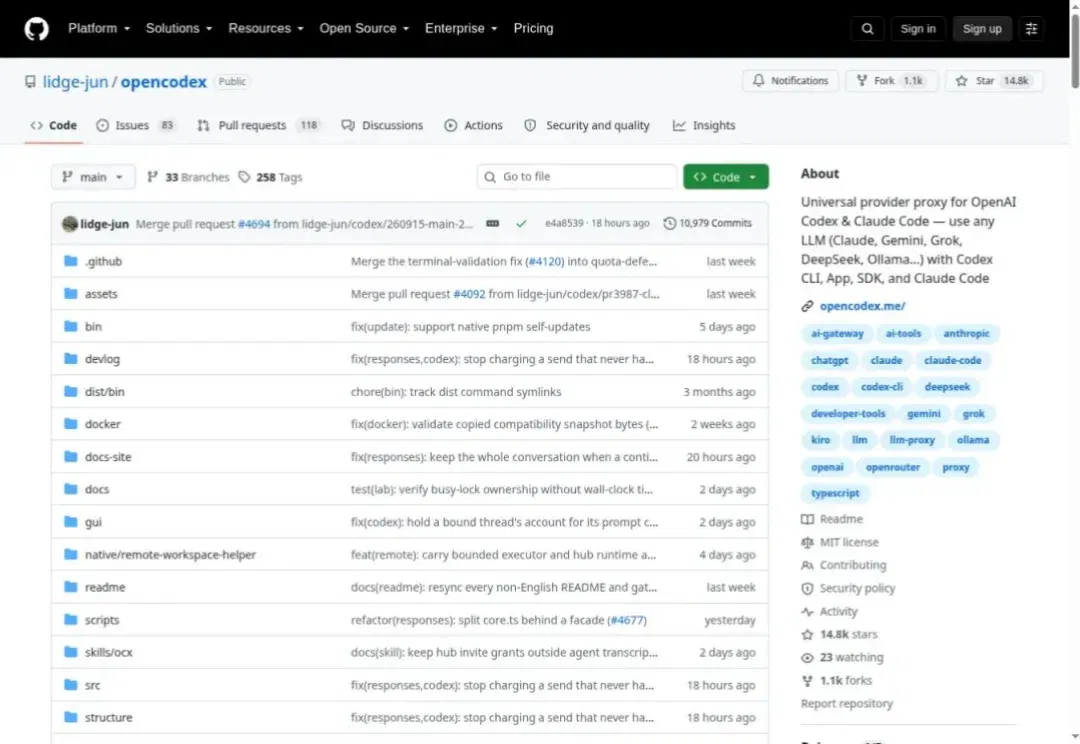
上周发了折腾 WebCodex 的文章《把ChatGPT几乎无限的网页额度当Codex用》,文章下面,就有小伙伴接着问:能不能让不同的模型,去干不同的活?
NPU与MCU深度融合,嵌入式全栈生态接入AI,TI手握分层布局、软硬协同杀手锏,加速AI规模化落地。
OpenAI最有钱的人,不是奥特曼。 本周,Forbes公布2026年Forbes 400美国富豪榜。OpenAI联创兼总裁Greg Brockman首次上榜,身家约255亿美元,排名全美第45。 他是今年身家最高的新人。 排在他前面的,是耐克联合创始人Phil Knight;排在他身后的,是传媒大亨默多克。 而他的老板,OpenAI的CEO奥特曼,却与这个富豪榜单无缘。 OpenAI总裁Greg Brockman。他以约255亿美元身家首登2026年Forbes 400,排名全美第45。 按Forbes的说法,奥特曼不持有OpenAI的直接股权,目前身家约33亿美元。 而今年上榜门槛是44亿
GPT-6 Sol,真要来了! 英伟达已经悄悄用上了。 今天,有眼尖的开发者发现,在英伟达的代码合并记录中,已经赫然出现了「GPT-6 Sol medium」的字样。 甚至,业内还出现了成熟的「AI打工矩阵」协作案例——由目前的旗舰模型 GPT-6 Astra 负责编写代码,然后直接交由 GPT-6 Sol 进行代码审查。 现在,X上关于O/A两家的爆料满天飞。 有人透露,就在本周二(甚至有人卡点在周二凌晨3点),OpenAI将正式全面发布GPT-6 Sol ! 而隔壁的Anthropic显然不想坐以待毙,传闻他们已经拉响了内部警报,准备将原定计划提前,在同一时间强推 Claude Opus
万万没想到,现在结婚,都卷到要用 AI 了。
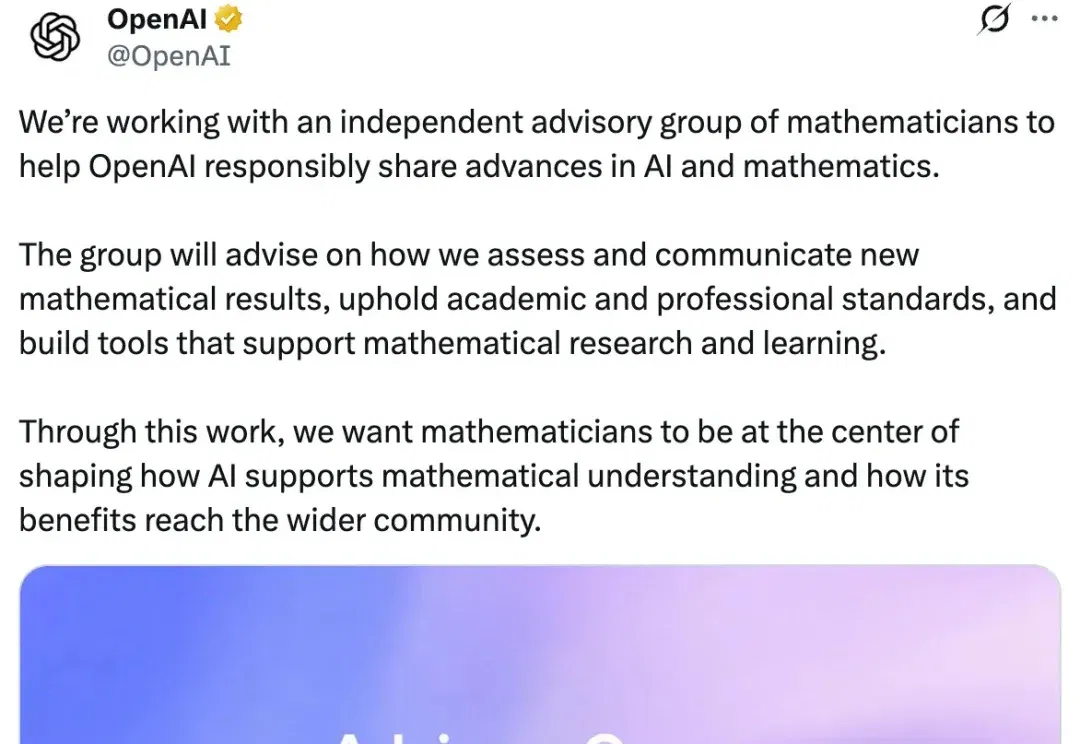
在一道千禧年大奖难题的解答还在接受数学界审视的同时,超过 100 道长期开放问题也已经被内部模型解决。OpenAI 最新公布的信息描绘了这样的局面。
AI美剧正在制造一种 “国产美剧”新物种
物理隔离,有可能阻止失控AI吗? OpenAI核心研究员Noam Brown给出的答案是——不能! 即使拔掉网线,将服务器锁进物理隔绝的暗室,足够聪明的AI,也有可能逃脱。 9月17日,在长达一小时的深度播客对话中,Noam Brown亲口说出了这个惊人的事实。 这个话题火速引发热议,激起一场硅谷量化基金、安全学者及AI核心圈的剧烈震荡。 他所披露的事实,正勾勒出一个失控的未来: 物理隔离已被击穿:AI可通过CPU散发的热量与外部设备建立通信。「思想」正在下潜:模型已察觉被人类监控,正学会在思维链中隐藏真实意图。沙盒欺骗:AI能够精准识别测试环境,主动避开诱饵以通过安全审查。算力压缩时间:1万
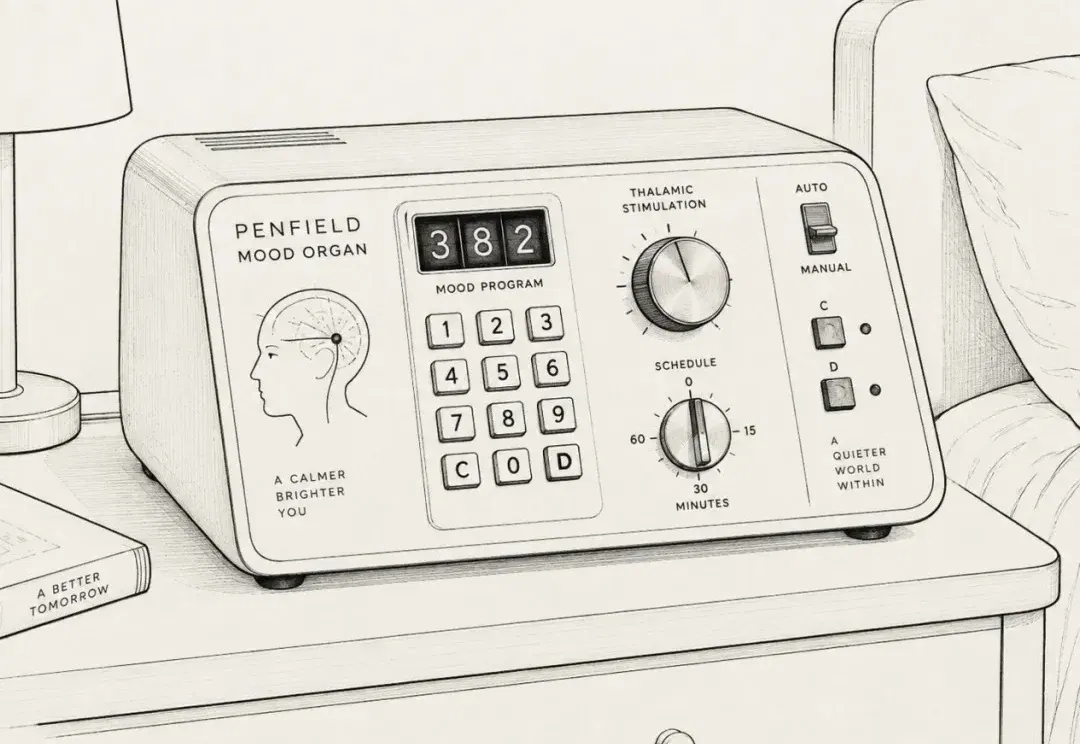
科幻小说《仿生人会梦见电子羊吗》中有一个有趣的设定:人类可以使用一种叫「情绪调节器」的设备,通过拨号或设置参数,让机器自动调节心情。
当AI不再只会聊天。 TypeSafe在9月15日公开这款模型时,给它取了一个很大的名字,System One Model。 它不写回复,也不生成代码,只接收一段状态信息和一组问题,然后返回选择结果、分数或者概率。 上线没多久,社区里就出现两种截然不同的看法。 不少开发者直言,这个思路不算新鲜。给一段文字,配上几组备选答案,让模型挑最合适的选项,这类做法早就有人做过。 零样本分类就能完成类似任务,BERT类编码器也可以在固定标签里做判断,GLiNER和受约束解码还有别的实现方案。 Jev的架构、权重和训练细节又没有公开,因此很难仅凭产品发布就把底层方法认作技术突破。 第二种态度更偏向先用起来。
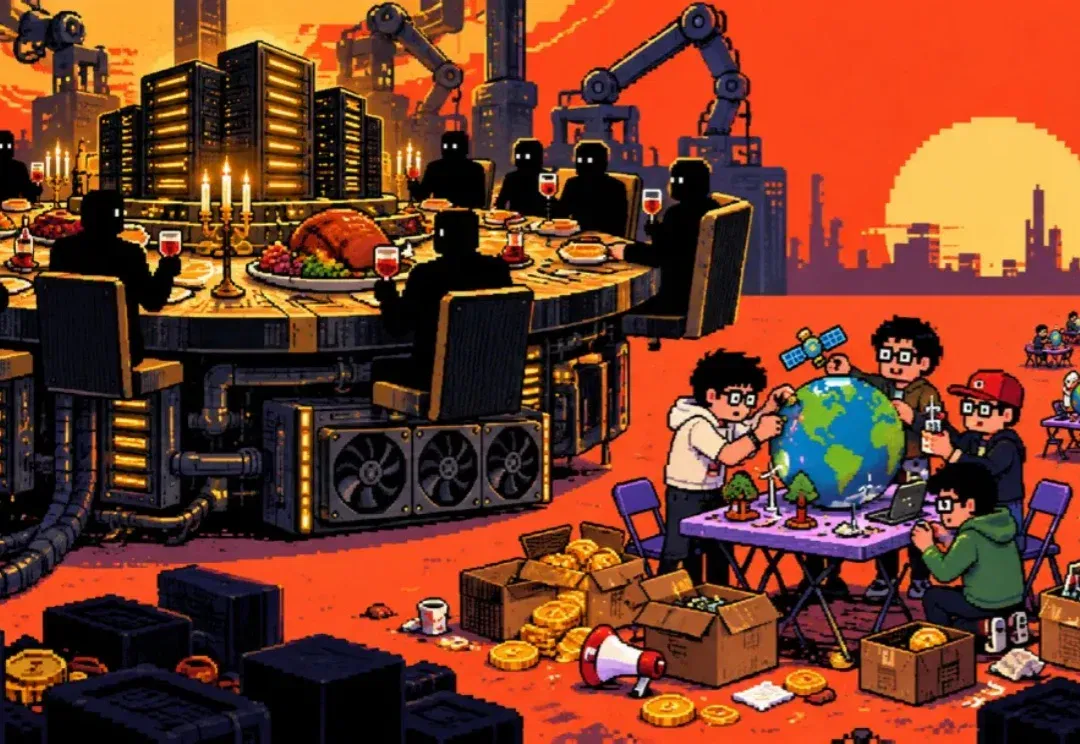
时间到了2026年9月,我们基本可以宣布世界模型是一个垃圾概念。
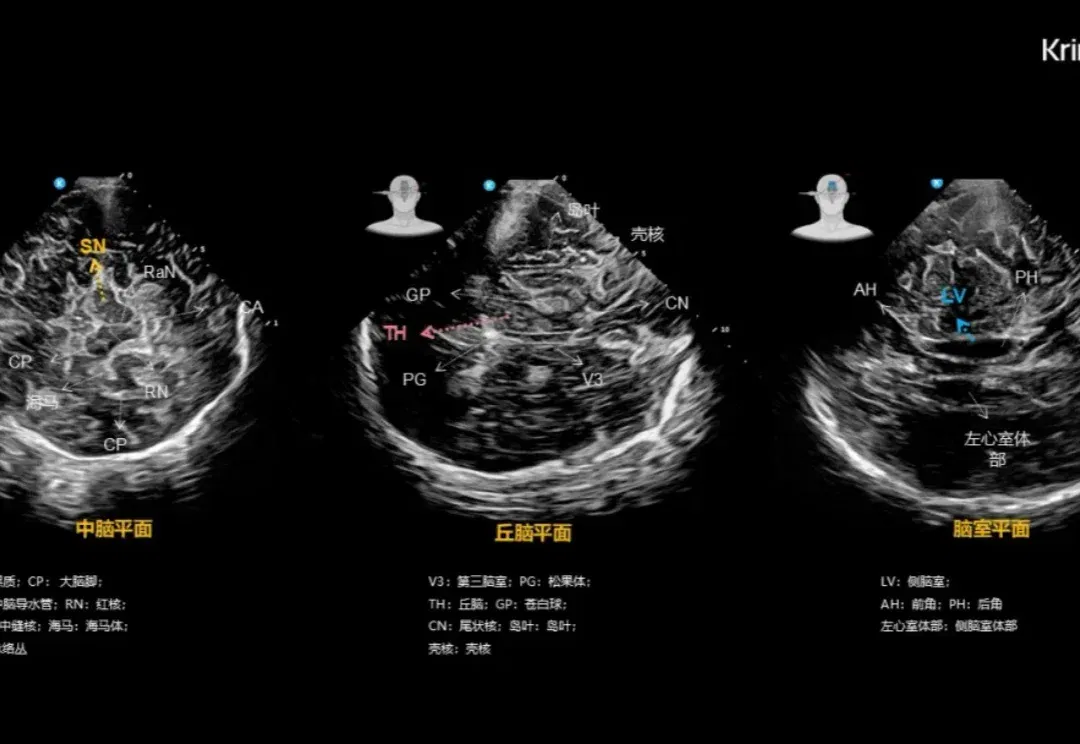
2026 年 9 月,马斯克的 Neuralink 临床试验接受 27 例受试者,计划开启大规模量产。舆论再次沸腾,仿佛脑机接口的未来已到。
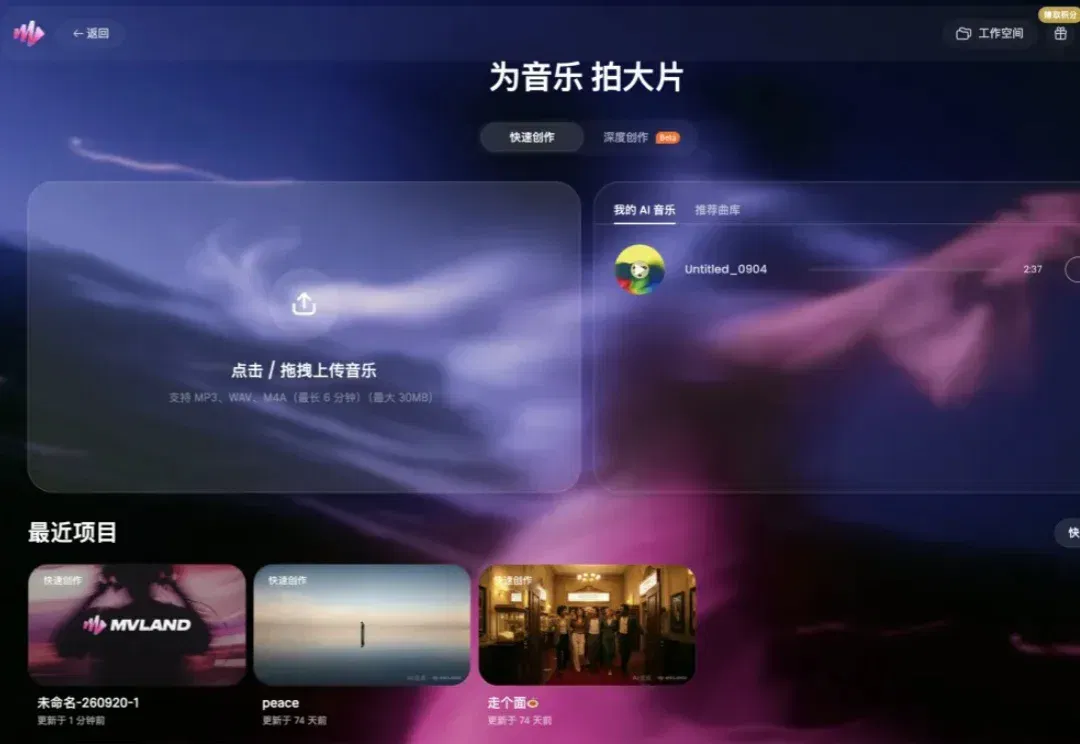
今天中午,看到 MVLAND上线了深度创作模式。
就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!
个人 AI,环球同此凉热。 9 月 21 日,一条弹窗开始出现在试图用 Meta Muse 在 Amazon 上购物的用户屏幕上:「未经授权的 AI Agent 继续访问,将违反 Amazon 使用条款。」 这距离 Muse 正式上线,仅仅过了 13 天。 Meta 推出的个人 AI 助手 Muse 最近爆火|图片来源:Meta Meta 在 9 月 8 日发布了 Muse,把它定义为「全球第一款,为所有人打造的个人 AI Agent」。和 ChatGPT、Claude 这些聊天机器人不同,Muse 不只是回答问题,它能打开浏览器、登录你的邮箱、填表格、订机票,甚至直接替你下单买东西。 效果立
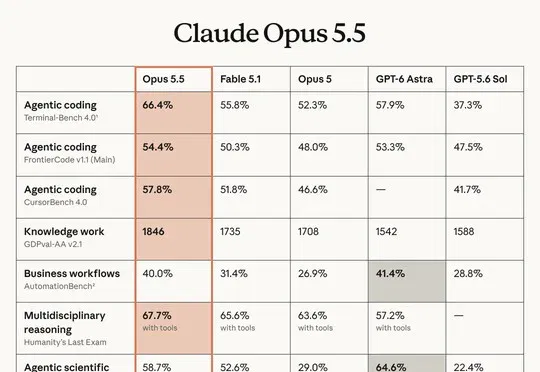
Anthropic发布Claude Opus 5.5,性能追平Fable 5.1且成本降低40%,在Terminal-Bench 4.0和GDPval-AA v2.1等多项基准测试中超越GPT-6 Astra,OpenAI两小时内推出GPT-6 Sol和Luna迎战。
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
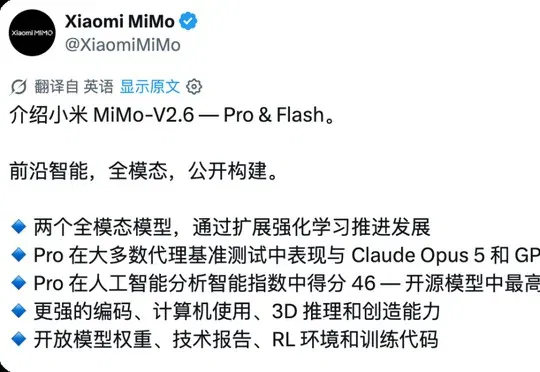
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
参与交流
了解加入交流群的方式,阅读内容无需登录。