RTX Spark迷你主机展示本地AI与共享计算,最高配备128GB统一内存
报道介绍英伟达RTX Spark的N1X平台、本地模型与机器人演示,以及迷你主机的多设备共享用途。文中给出指定模型、功耗和电价下的运行费用估算,128GB是CPU与GPU共享的统一内存。
编辑核对(2026年11月21日):文中最高128GB为CPU与GPU共享的统一物理内存,不是GPU可无条件独占的显存。成本比较是指定模型与负载下的电费估算,未计硬件购置等总成本;云端路由及多设备PAIR也有软件、模型、网络和资源条件。NVIDIA RTX Spark官方规格(在新窗口打开)NVIDIA统一内存区域与使用限制(在新窗口打开)NVIDIA平台发布与CPU合作说明(在新窗口打开)NVIDIA PAIR请求路由与内存边界(在新窗口打开)
「哈喽,大家好呀!」
画面里,一台「无头骑士」版宇树机器人,正在和观众挥手互动。
它的头被一台笔记本电脑取代,屏幕上显示的是一位可爱的美少女形象。
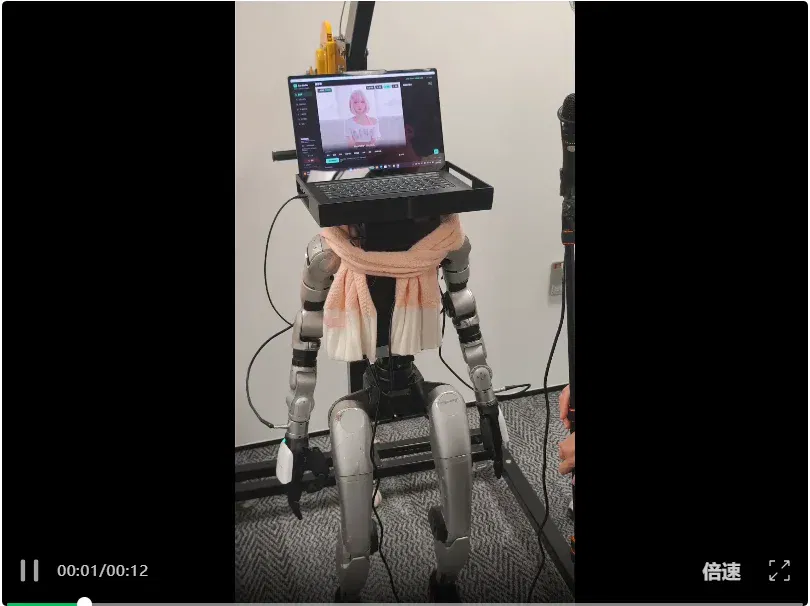
这套机器人是B站up主特效小哥的杰作,他先前就设计了数字少女图零零这个形象。
在英伟达RTX Spark的一次分享会上,特效小哥把图零零带进了物理世界。
在宇树提供的身体上,图零零能够与观众语音对话互动,做出飞吻、拥抱,甚至模仿奥特曼等一系列动作。
背后的训练过程,用的正是脖子上顶着的那台笔记本。
别看这台「顶在脖子上的笔记本」外观轻薄,里面装的正是英伟达此前在今年Bilibili World上展出过的RTX Spark超级芯片。
它把CPU与GPU集成并通过高速互连连接,最高配置提供128GB统一内存。厂商展示了笔记本运行120B模型和虚幻引擎5大场景的用途;128GB是CPU与GPU共享的物理容量,不是独立128GB显存,也不表示每种配置都能运行同样的模型或场景。
这一次在分享会现场,RTX Spark又被玩出了更多新花样。
一台笔记本,撬动机器人训练
物理学家阿基米德说过,给我一个足够的支点,我能撬动整个地球。
RTX Spark笔记本撬不动整个地球,但可以撬动整个机器人训练的完整过程。
除了前面的图零零,现场还有一只叫microduck的「小鸭子」机器人,来自GitHub上一个非常火的开源项目。
首先,英伟达的技术人员通过Hermes调用本地部署的Qwen 3.8模型,直接把microduck项目拉了下来。
整个过程都不需要关心项目是什么原理,也不用担心环境怎么用,本地的Qwen直接自动搭好仿真环境,顺带控制小鸭子在仿真里做起了各种动作。
甚至直接在仿真环境里放两台机器人,让它们比赛踢足球。
但高手还是得看民间,旁边的展台就有大神用3D打印给microduck捏了身体。
这下,这只小鸭子从屏幕里走了出来。
当然,用的工具也是RTX Spark笔记本。
只见这只小鸭子迈着轻盈的步伐在地面上行走,翻了跟头也不怕,立马就能爬起来。
大神还如法炮制,另外做了一个人形载体。
另外一台笔记本里,直接同时塞进了千问和GR00T两个大模型,接上SO-101机械臂就开始干活。
演示人员不用写代码,直接用日常大白话跟智能体聊天,就能让机械臂自己动手。
整个过程由本地部署的Qwen 3.6-35B-A3B担任「大脑」,从思考规划到每一步执行全在本地完成。
接到抓试管的指令后,智能体会先通过外置摄像头和从臂腕部摄像头做一轮安全检查,确认机械臂周围没有物体遮挡。
检查一通过,它就立刻唤醒后台同样在本地跑着的GR00T模型,让从臂精准识别位置,稳稳把试管夹了起来。
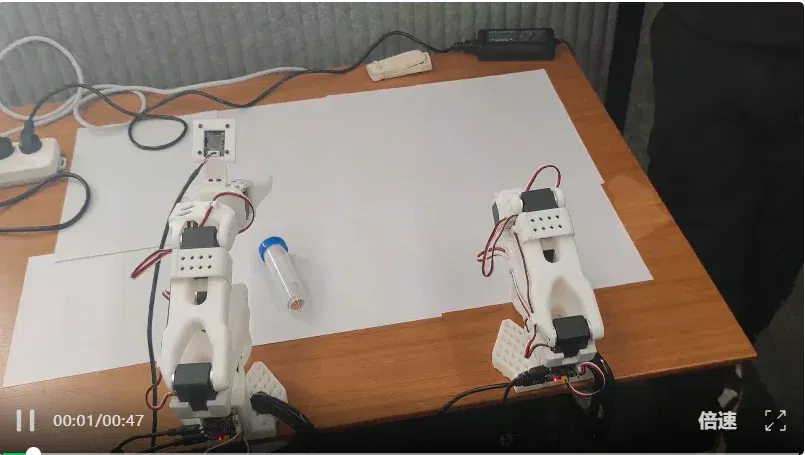
生化环材出身的我看到这,直接梦回学生时代,不得不感叹这动作真的很利索。
有了本地模型,能玩的肯定就不只是机器人了。
日常上班用得上的工具也没落下,比如曾经热门的OpenClaw和Hermes这次都升了级。
OpenClaw加上MXC权限隔离来防误操作,Hermes接入Switchyard智能路由,日常任务留本地,遇到难啃的硬骨头再切到云端。
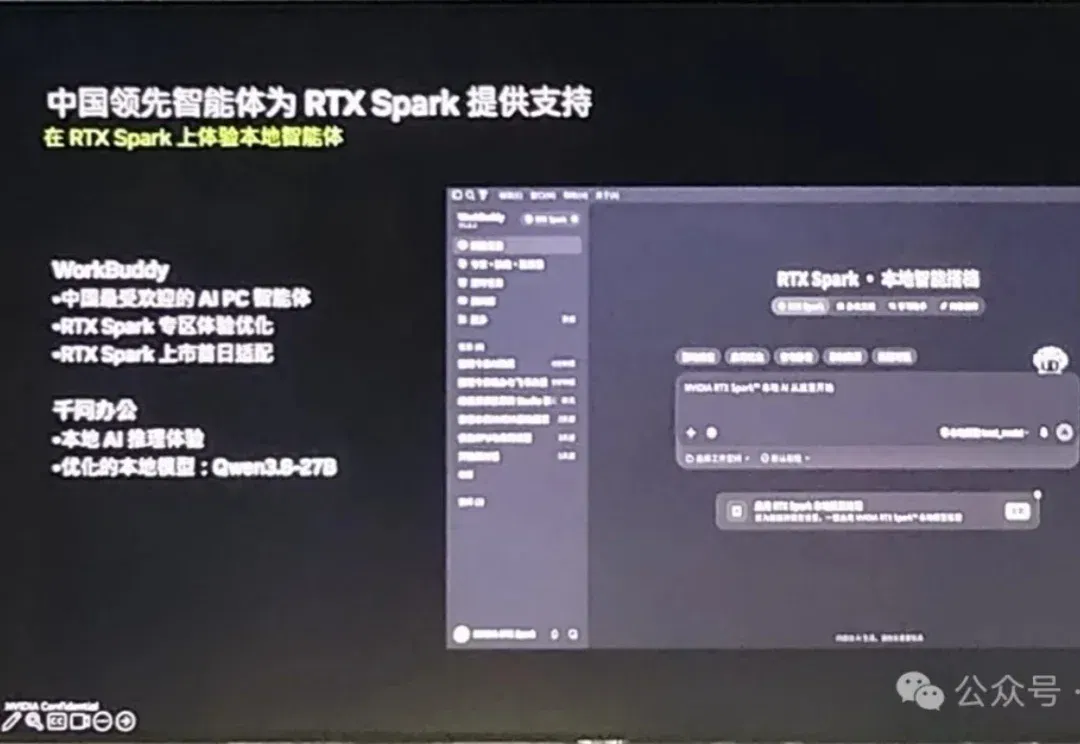
英伟达也没忘了国内市场,像我们更熟悉的WorkBuddy和千问办公,这次也全部支持通过RTX Spark进行本地模型部署。
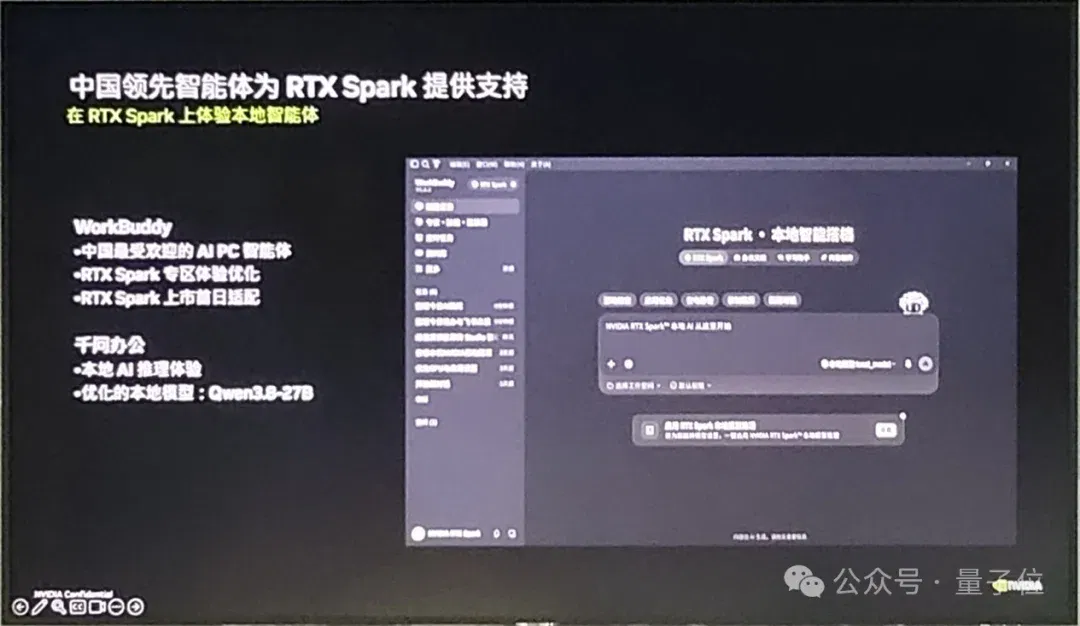
整理文件夹、汇总表格、写文档等任务,可以在相应授权和部署条件下使用本地模型处理,减少云端Token支出及文件上传需求。但Hermes等工具仍可能按路由转向云端,插件或外部工具也可能发送数据;是否出网应检查具体设置和数据流,不能仅因模型本地部署就作出绝对隐私保证。
最高128GB统一内存:本地推理电费与云端API费用估算
我们来简单回顾一下RTX Spark机身里的N1X超级芯片。
N1X采用与MediaTek合作定制的最高20核NVIDIA Grace CPU,以及最高6144核Blackwell RTX GPU,通过600GB/s NVLink-C2C互连连接,配备最高128GB统一内存;厂商公布的FP4 AI峰值算力最高为1Petaflop。这里的128GB为CPU与GPU共享的物理内存,不是另有128GB独立显存。
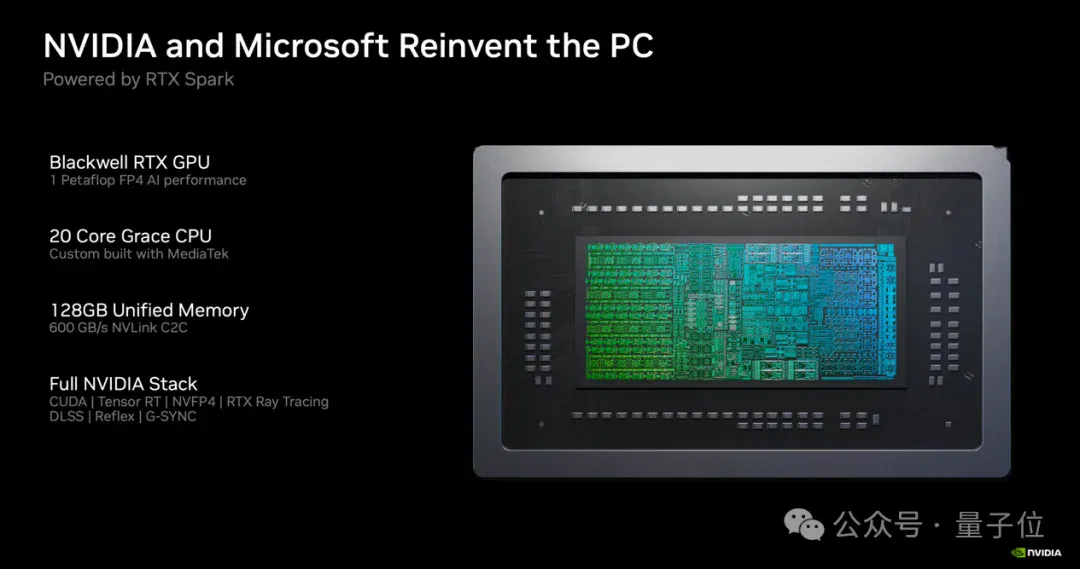
共享内存可以减少CPU与GPU之间的数据复制。厂商称平台可运行最高120B参数模型、支持最长100万Token上下文,但实际可用规模取决于模型格式、量化、推理引擎及运行开销。Windows会把物理内存划分为GPU保留区、共享系统区和CPU专用区,GPU不能使用CPU专用区,因此不能把全部128GB视为GPU无条件可分配空间,也不能保证所有配置同时达到最大模型与最长上下文。
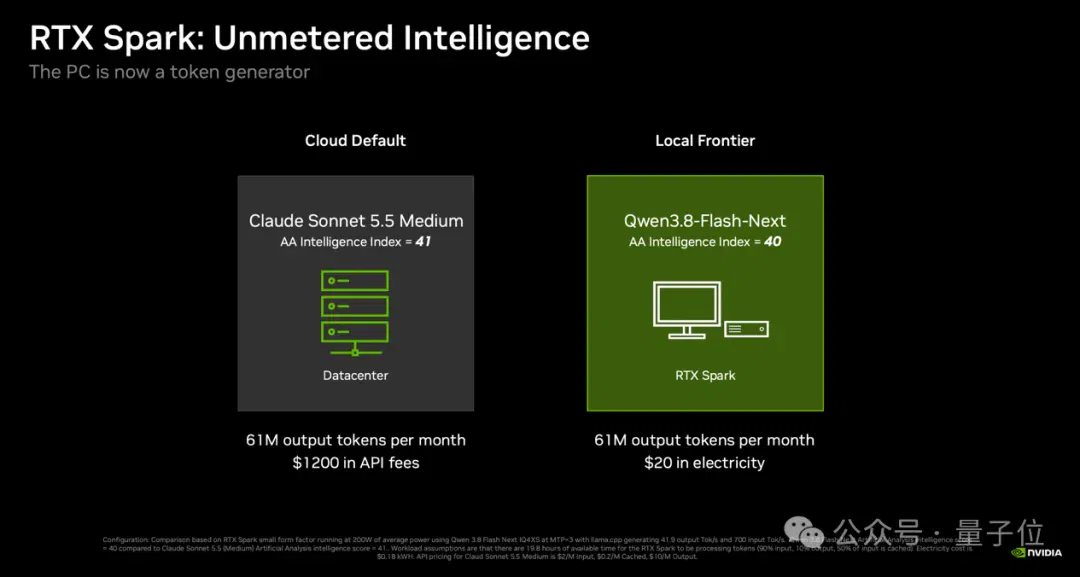
英伟达现场给我们算账,用RTX Spark到底能省多少Token预算。
RTX Spark上,在200W平均功耗下用llama.cpp跑Qwen3.8-Flash-Next,每秒能吐出41.9个Token,输入速度达到每秒700个Token。
现场援引Artificial Analysis榜单称,该本地模型智力指数为40分,云端Claude Sonnet 5.5 Medium为41分。这个特定综合指标接近,不等于两个模型在全部任务、稳定性、工具使用或服务条件上相同。
Sonnet算是Anthropic的甜品级模型,一般的日常办公需求足够用。
本地模型能否满足类似办公需求,仍需结合实际任务、质量要求与响应速度判断,不能只凭接近的榜单分数认定全面等价。
厂商现场按高强度后台智能体、每月输出6100万个Token的指定负载估算,所比较的云端API费用约为每月1200美元,而RTX Spark本地运行的电费约为每月20美元。这是特定模型与用量下的API支出和运行电费比较,不包含4399美元起的设备购置及其他成本,不能直接当作总拥有成本,或保证不同模型始终完成同等质量的任务。
约20美元电费采用美国电价0.18美元(约1.2元人民币)/度、平均功耗200W、每天约19.8小时负载的估算条件;实际月天数、电价和功耗变化都会影响结果。
若当地居民电价约为上述假设的一半以下,同样负载的电费也会相应降低。原报道据国内电价估为每月六七十元人民币,这仍是特定电价和使用条件下的近似数,不是各地统一账单。
再看英伟达这边,模型适配也在同步提速。
英伟达已经为多款热门开源模型提供了Day-0首发支持,像国内开发者最熟悉的千问、智谱GLM、DeepSeek、MiniMax,以及生图模型FLUX等等,在Ollama、llama.cpp、LM Studio和ComfyUI里全都能直接拉起。
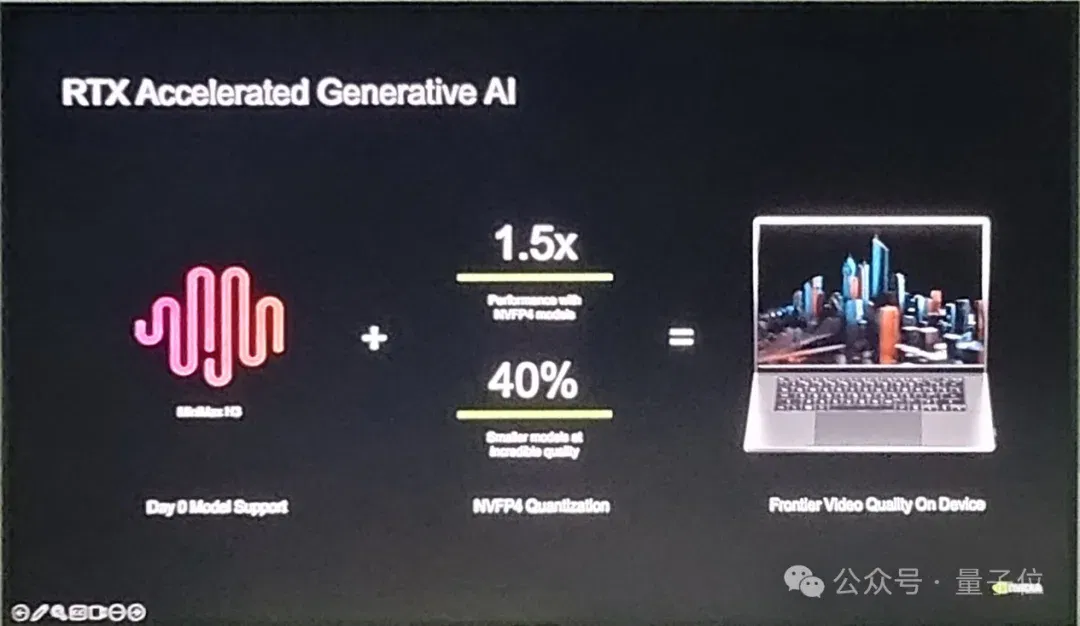
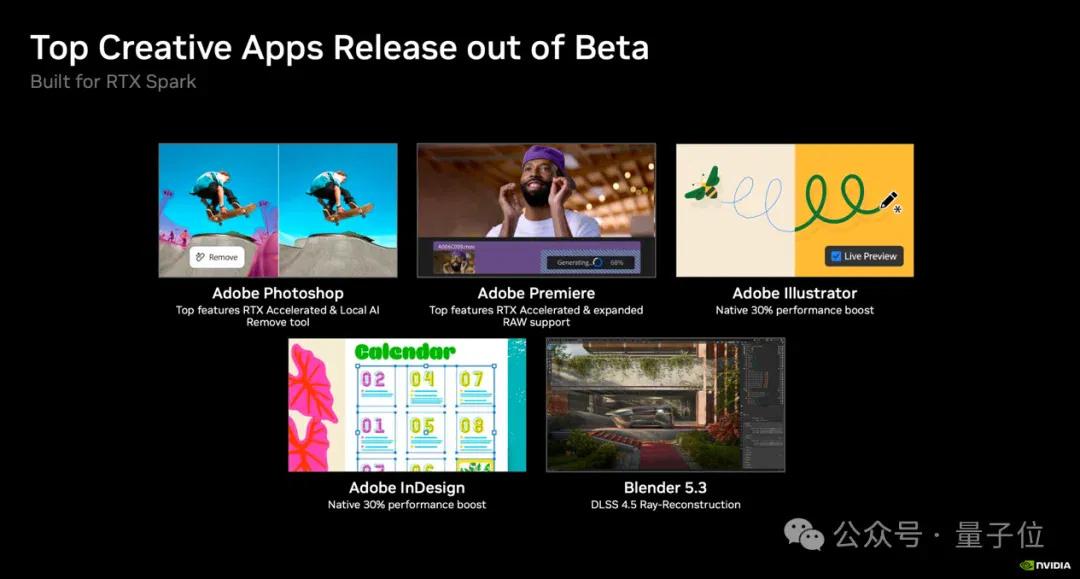
除了AI,像3D创作等等同样需要GPU资源的传统任务,也跟着往前推了一步。
不过,最高128GB仍是共享总内存;3D场景与AI任务也要受系统占用、GPU可用区域及应用实际需求的限制。
Blender 5.3已经用上DLSS 4.5的光线重建,Adobe旗下的Photoshop、Premiere、Illustrator和InDesign也全部走出Beta阶段,推出正式版原生加速。
当然游戏这边,英伟达也没把玩家落下。
比如英伟达的「大力水手」——DLSS 5,就有新的落地进度。
今年3月DLSS 5刚发布时没少挨骂,玩家吐槽它AI滤镜感太重、动不动给角色改脸,YouTube演示视频甚至被踩出84%的点踩率,性能开销更是离谱到需要两张RTX 5090才勉强跑得动。
不过到了10月,英伟达推送了一轮大改版,把模型参数量缩减24%降到1.18亿,4K显存占用省下20%,模型推理速度比3月初版快了10倍,如今单张RTX 50系显卡就能流畅带起来。
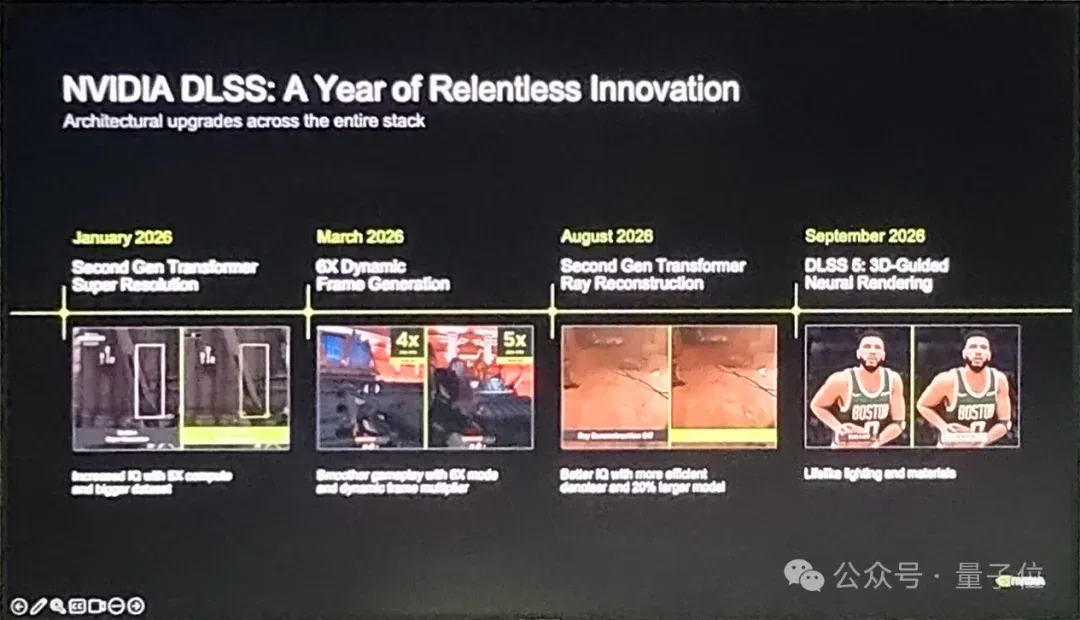
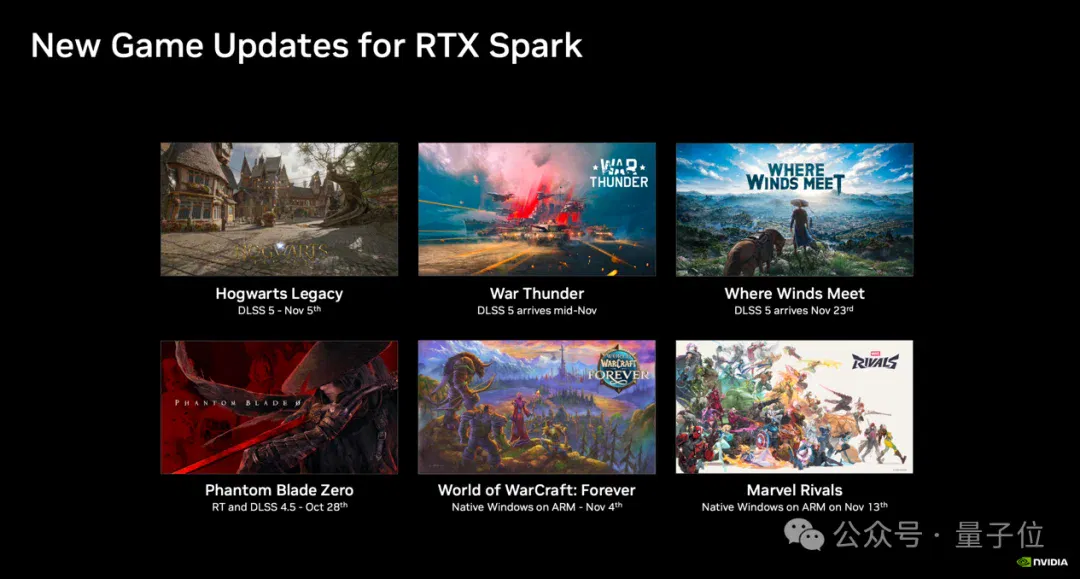
11月5日刚刚更新支持DLSS 5的《霍格沃茨之遗》里,画面改动也克制了许多,不再像早先演示那样用力过猛。
接下来11月中旬《战争雷霆》、11月23日国产武侠《燕云十六声》也将陆续上线DLSS 5。
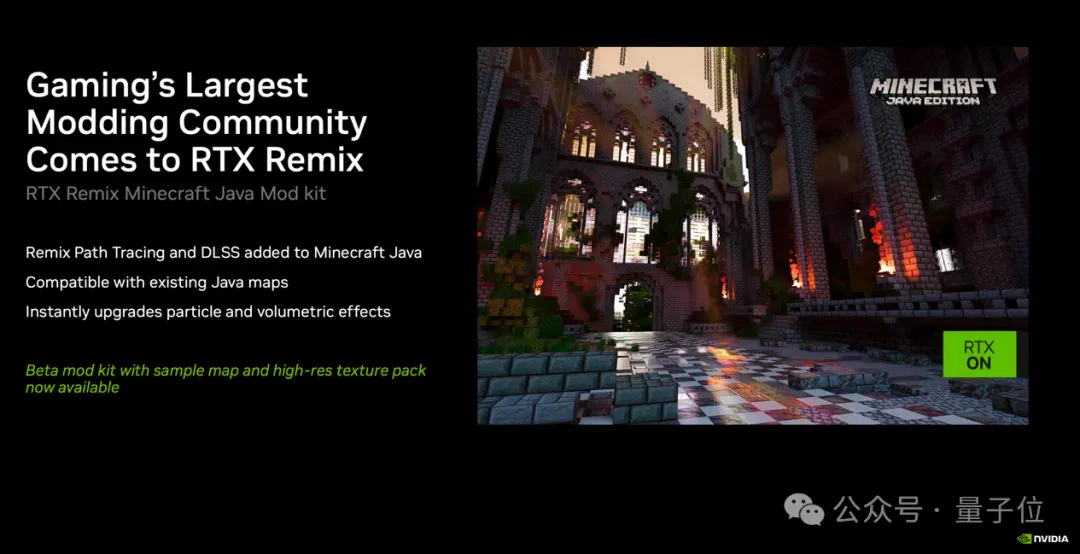
另外,《我的世界》Java版玩家也等来了全新的RTX Remix光追Mod工具包。
好家伙,马赛克方块配上官方路径追踪,老玩家又有新玩具可以折腾了。
还有一件事就是,跑智能体和打游戏并不是对立的两个需求。
有些用户平时喜欢后台挂着智能体干活、前台同时打游戏,为了这部分人,新版NVIDIA App里新加了个GPU资源优先级滑块。
想专心打游戏就切到「前台优先」,游戏稳在75帧,后台智能体每秒照样跑11个Token;切到「后台优先」全力干活时,智能体速度拉到每秒20个Token,前台游戏依然能保住60帧。
One More Thing
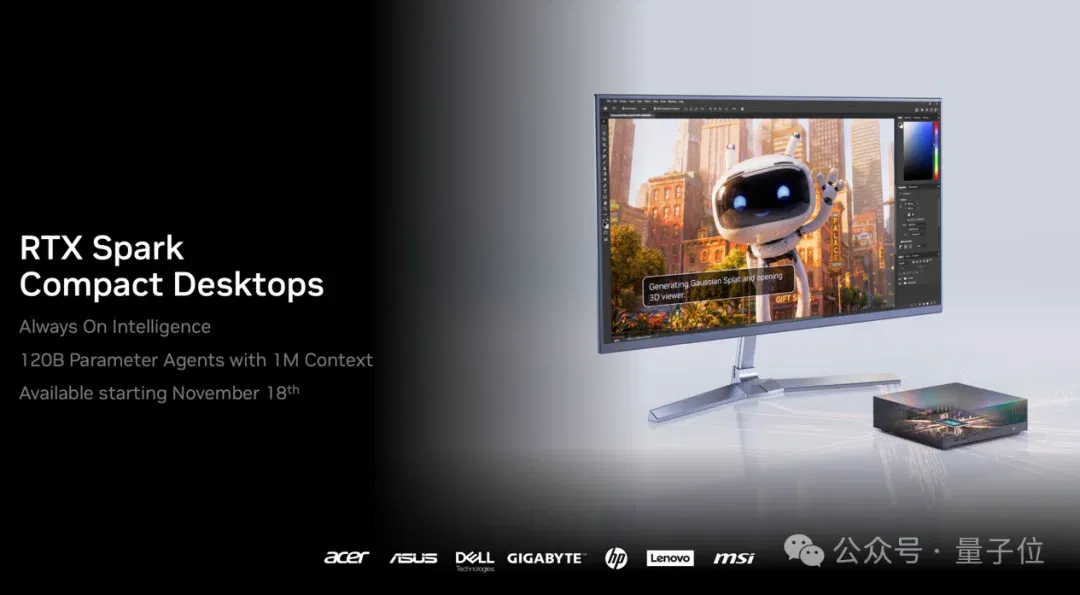
如果你不用每天背着电脑跑外勤,更想要一台24小时插电干活的机器,英伟达这次还带来了全新的RTX Spark迷你桌面主机Compact Desktops。
4399美元起,宏碁、华硕、戴尔、技嘉、惠普、联想和微星同步推出各自机型。
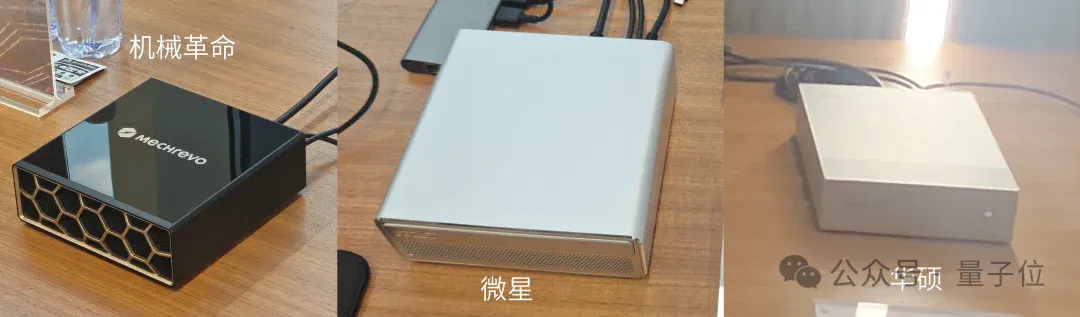
分享会上我一共见到了三台真机,分别来自鸡哥(机械革命)、微星和华硕,各有设计但大致形态上都是一个小巧的方盒子。
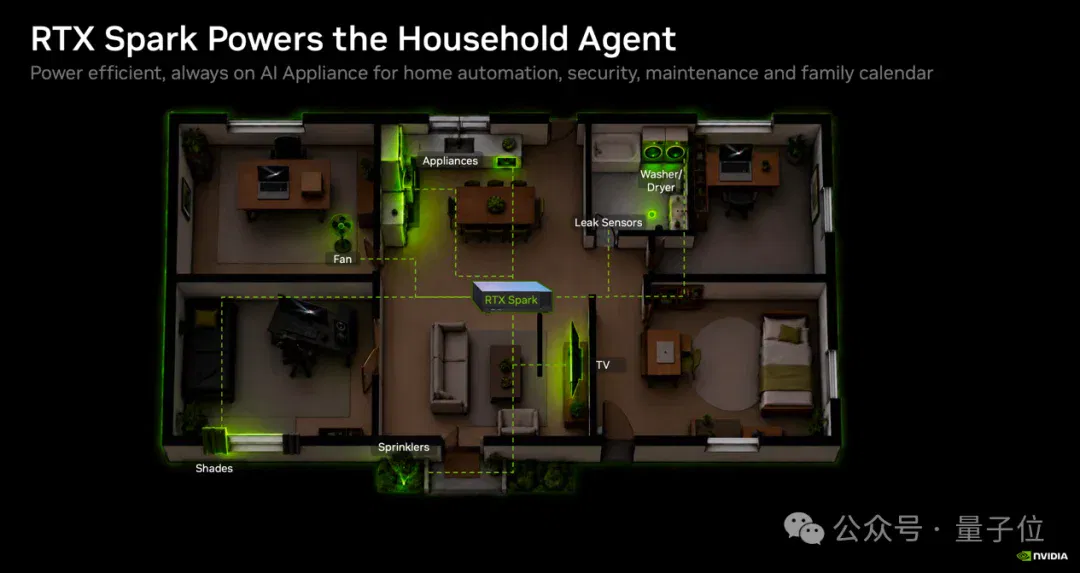
Compact Desktops采用N1X配置,最高提供6144核GPU、20核CPU与128GB统一内存,主打7×24小时运行的「Always On Intelligence」。具体内存容量依机型而定,CPU与GPU共享及系统内存分区的限制同样适用。
配合英伟达PAIR,兼容的Mac、游戏PC或轻薄本可以把独立AI推理请求路由给可信本地网络上具备所需模型、引擎和可用资源的机器,例如这台Compact Desktops。PAIR并不会把各机内存合成一块更大显存,也不把单个模型或请求拆分到多台机器,因此不能概括为全家所有跑不动的AI任务都能接过来算。
这样看,有了一台Compact Desktops,就相当于在书桌角落放了一台全家人共享的私人AI小主机。
文章来自于"量子位",作者 "克雷西"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
这台卖37999的RTX Spark电脑,让我实现了Token自由。(在新窗口打开)
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
英伟达RTX Spark真机上手!黄仁勋的AI PC杀招终于来了(在新窗口打开)
3万块的RTX Spark电脑,能干哪些事?
首款RTX Spark电脑,开卖!可跑1200亿参数大模型(在新窗口打开)
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
老黄RTX Spark真机现身Bilibili World!CPU和GPU直接焊在一起,笔记本跑120B大模型(在新窗口打开)
就在这届Bilibili World上,英伟达首次面向大众玩家展示了搭载RTX Spark超级芯片的笔记本电脑。这款芯片专为个人智能体打造,不仅搭载了Blackwell RTX GPU,连CPU也是出自英伟达的Grace CPU。
英伟达版「MacBook Pro」曝光:老黄自研了CPU!(在新窗口打开)
英伟达版Macbook Pro,真的要来了。