作者体验OpenSquilla模型路由:按任务分档调度与费用取舍
作者以项目梳理和文档任务观察OpenSquilla切换模型。项目报告的成本与质量对比来自指定基准及模型池,月度推荐不能代替具体业务验收,开源工具调用模型仍需付费。
编辑更正(2026年11月19日):99.96%为PinchBench特定基线的分数比例;框架和模型池共同变化,推荐不能代替业务验证。
国产模型当中,DeepSeek 写文档最有人味,GLM-5.3 写代码性价比最高,Kimi 做前端最好看。
这些特性几乎人人都知道。
但也几乎没人天天照着用。
原因很简单,在同一个会话里来回切模型,太麻烦了。
难不成我每次派任务出去,还要自己心里先掂量一下,这活到底该用哪个模型?
这就真的很烦。
所以大多数时候,我们都是挑一个最强的模型,一路用到底。
只是这样一来,就有了一个很荒诞的画面。你发一句哈喽,回复你的,是一个旗舰模型。
牛刀杀鸡,几乎每天都在发生。
直到我最近在 GitHub 上看到一个项目,叫 OpenSquilla,它想干的事就一件,根据任务的难度,自动调度不同档位的模型。
/同一场对话,模型自己换/
听着有点意思,于是我把它下载下来体验了一下。
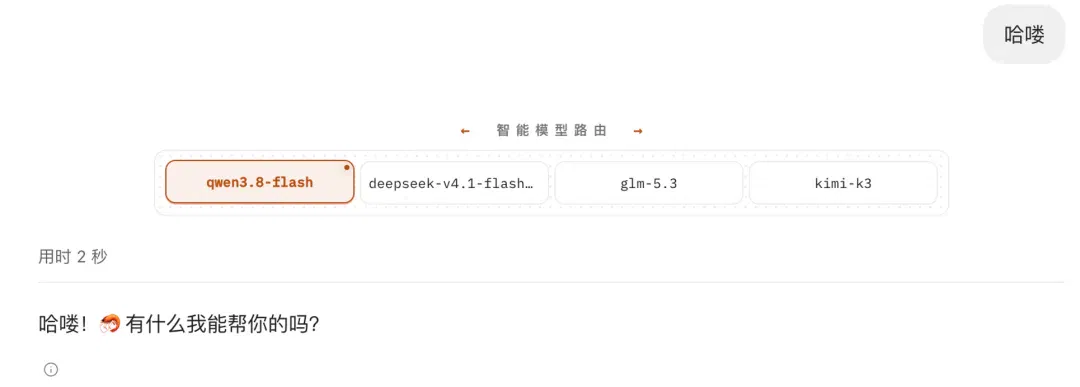
先给它发了一句,“哈喽”。
回复上方有一条「智能模型路由」,四个模型一字排开,这次用的是qwen3.8-flash,四个里最便宜的那个。
接着我让它快速探索一下本地的一个开源项目 Multica,梳理出它的定位和核心功能,这次它自动切到了 glm-5.3。
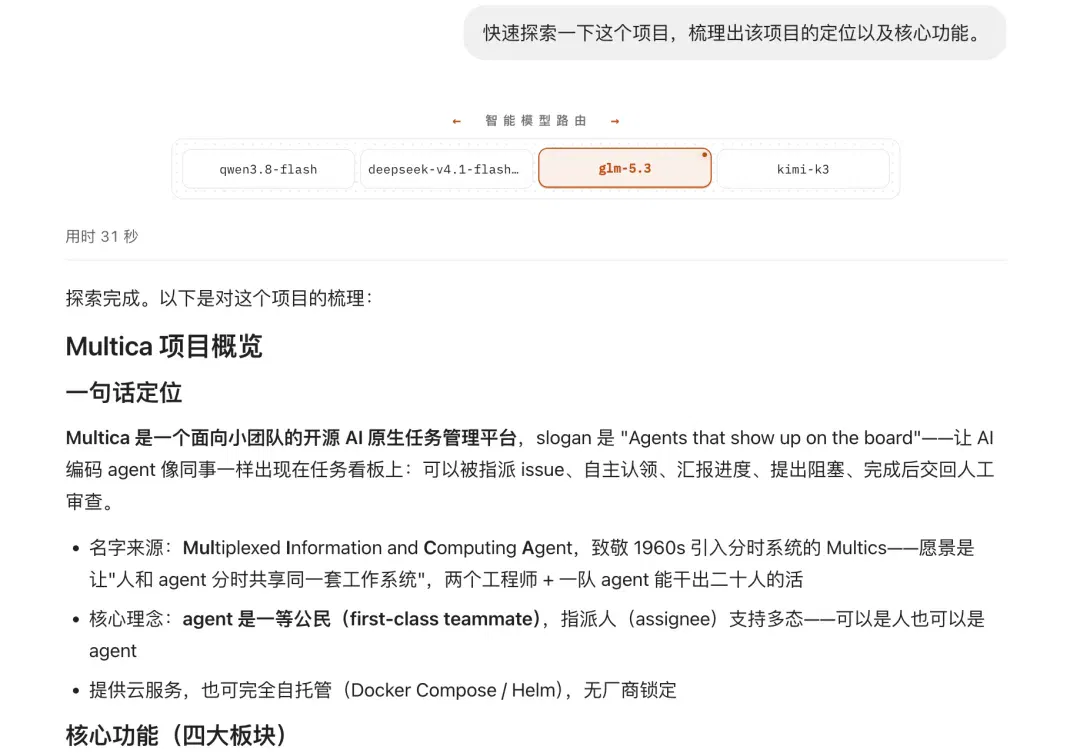
有点东西。
然后我让它基于刚才梳理的信息,输出一份 Multica 的架构文档,它又自动切回了 qwen3.8-flash。
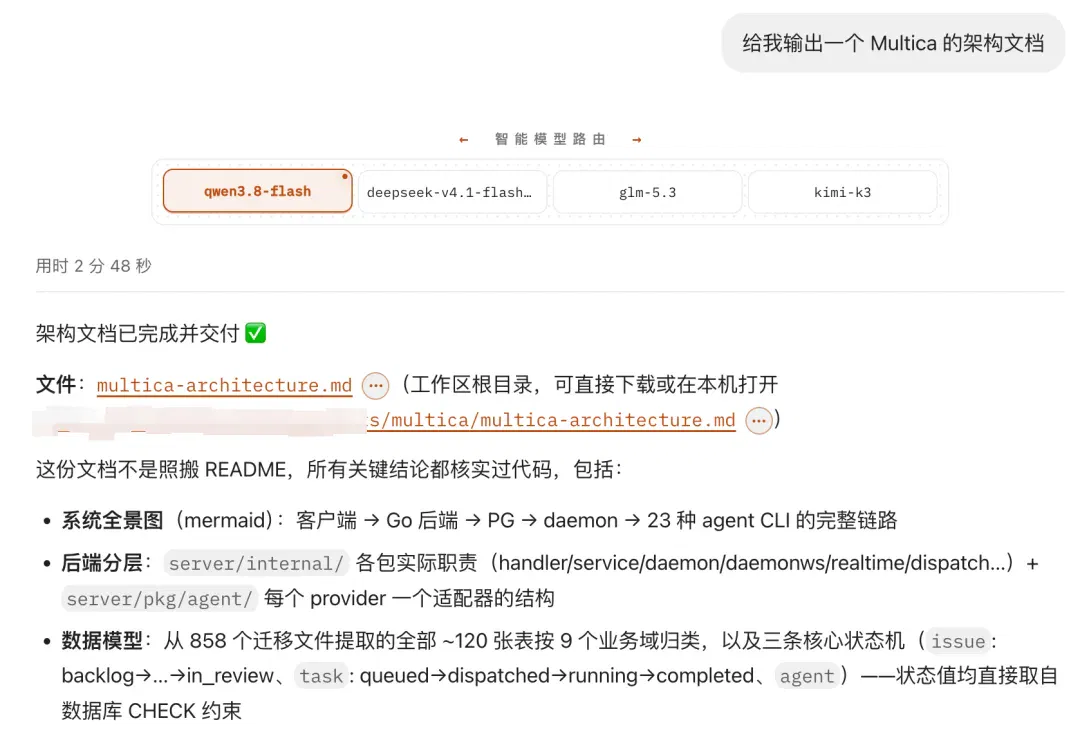
按开头那个说法,写文档本该是 DeepSeek 的活。
结果它派给了四个里最便宜的那个。
想想也说得通,项目上一步已经被 glm-5.3 摸清楚了,这一步是在梳理好的东西上往下写,用不着贵的。而且这份文档也不糊弄,用时 2 分 48 秒,有 Mermaid 画的系统全景图,还把 120 张左右的表按 9 个业务域归了类。
顺手查了一下两个模型的官方价。qwen3.8-flash 每百万 token 输入 0.8 元、输出 2.7 元,glm-5.3 是 8 元和 28 元,差了整整 10 倍。
这一来一回,贵的 glm-5.3 只花在了读懂项目的那 31 秒上。用时最长、大概率也最吃 token 的写文档那一步,交给了便宜 10 倍的模型。
/选模型这件事,本身也得省钱/
测试到这里,我就比较好奇 OpenSquilla 到底是怎么实现自动调度的?
于是我就去翻了一下他们的论文。
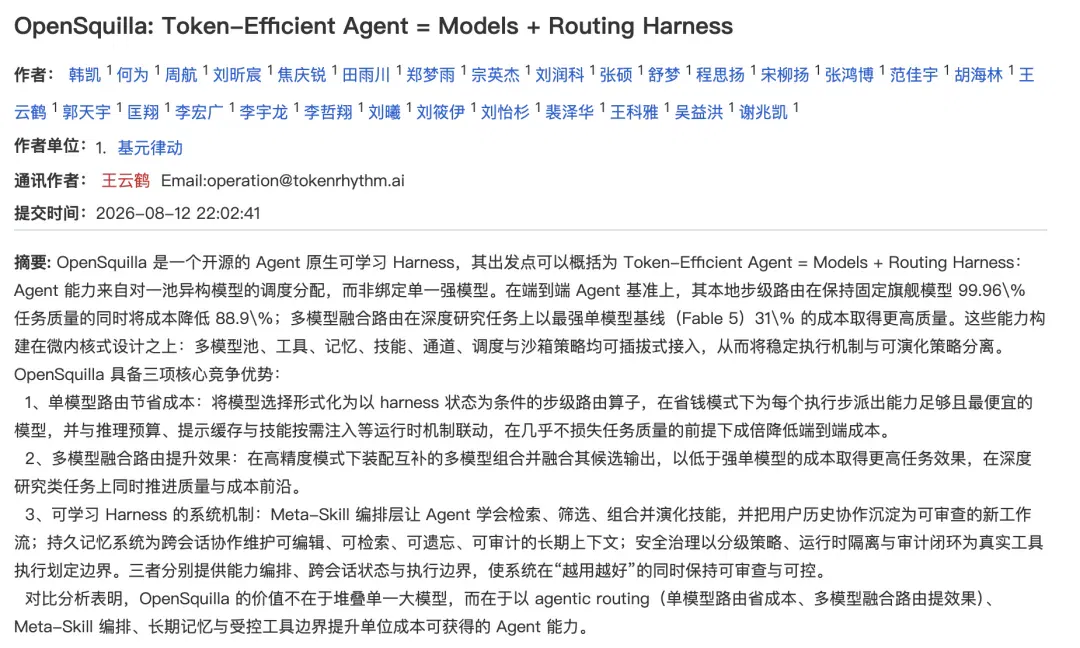
项目仓库的PinchBench结果涵盖25项任务:指定OpenSquilla模型池得92.51分,相对OpenClaw固定Opus-4.7的92.55分约为99.96%。这是基线分数比例,不是99.96%的任务成功率,也不是所有场景的质量保证。
该组测试总费用为0.69美元与6.23美元,约降低88.9%。比较同时涉及框架和模型池差异,不能将全部收益单独归因于本地路由,也不代表本文客户端配置必然得到相同节省。
它的路由原理大概是这样的,我画了个简单的动态图来描述:
它先把模型按能力分成四档,从快速简单到最高质量,你可以理解成一个团队里的四个岗位,实习生、正式员工、骨干、专家。
然后在你电脑上装了一个调度员,你每发一句话,它判断一下该派给哪个岗位。
这个调度员由两个很小的模型组成。一个叫 BERT,负责看懂你这句话想干嘛。一个叫 LightGBM,负责拍板分到哪一档。
它看的东西也很简单,你说了什么、带没带代码、上下文有多长、前面几轮判的是哪一档。
所以同一件事接着聊,它会沿用原来那一档,你点了重做,它才往上升一档。
那为什么不直接让大模型来当调度员?
因为用大模型来判断该用哪个大模型,本身就是牛刀杀鸡。
这两个小模型都在本地跑,判断一次几毫秒,不花一分钱 token,直接本地就搞定。
/新模型出来,也不用自己去测/
不过真正有意思的是,岗位是固定的,坐在岗位上的模型,每个月都可以换。
模型一个月一代,所以 OpenSquilla 每个月会拿不同的模型去修代码、跨 App 办事这些真实任务,把主流模型考一遍,既看成绩也看花费,又好又便宜的,下个月上岗。
十一月是第一期,模型排班是这样的。
实习生岗 qwen3.8-flash,正式员工岗 deepseek-v4.1-flash,骨干岗 glm-5.3,专家岗 kimi-k3,也就是下面截图里的 C0 到 C3。
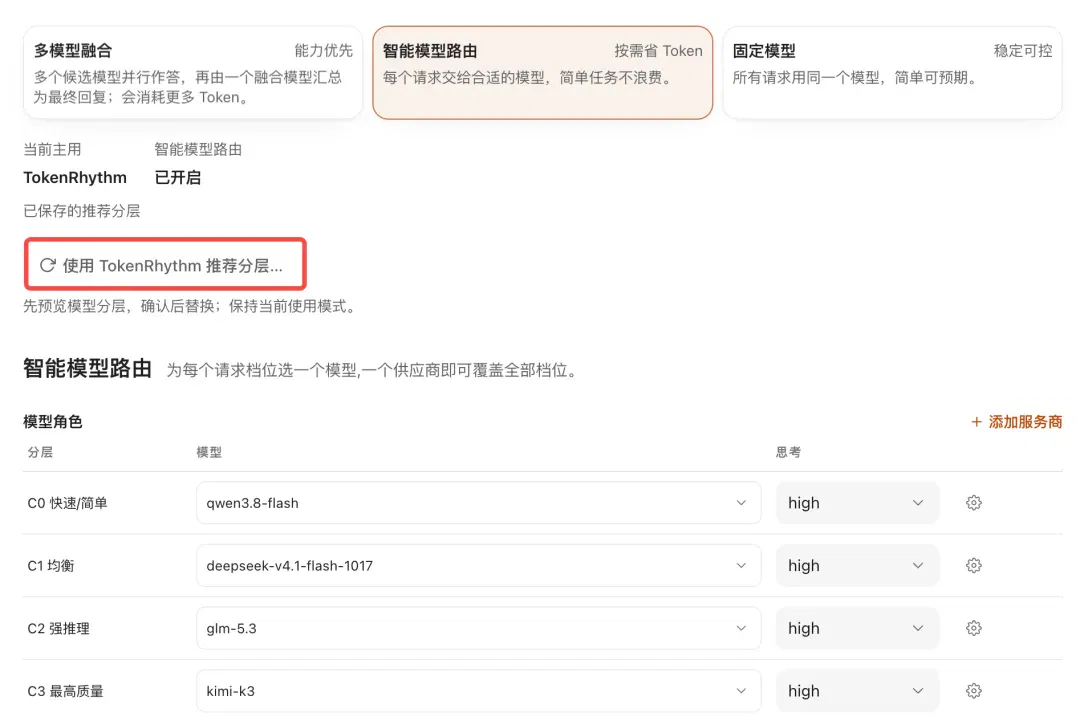
模型路由这里有个使用 TokenRhythm 推荐分层的按钮,启动时检查一次,之后每 24 小时检查一次。
月度分档推荐可减少重复选型工作,但不同业务仍需检查效果、费用和可用性。推荐更新由用户确认后采用,不能理解为新模型完全无需自行验证。
这样你本地的 Agent 就可以尽量兼顾效果和成本。
有没有很爽?
不过想让它在这几个模型之间来回调度,前提是这几个模型你都得调得到。要是一家家去注册、充值、拿 key,那又是另一种麻烦了。
所以 OpenSquilla 直接内置了 TokenRhythm 和 OpenRouter,一个 key 就能覆盖全部四档。
拿 TokenRhythm 来说,充好 Token 额度,把 API key 填进 OpenSquilla,或者直接在客户端里登录账号,就能用起来了,余额和当天用量在客户端里也能直接查看。
OpenSquilla 本身是开源免费的,花钱的只是模型调用。
文章来自于"贾克斯的平行世界",作者 "贾克斯的平行世界"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
热门Harness项目OpenSquilla:拯救烧token烧到绝望的Agent们,估值1亿(在新窗口打开)
OpenSquilla 是一个开源 Agent Harness 框架(https://github.com/opensquilla/opensquilla)。它在 Agent 应用和模型之间加了一层运行中枢。OpenSquilla 由上海基元律动科技有限公司开发。基元律动成立仅几个月后,已完成首轮融资,估值高达1亿美元。
基元律动发布 NeoHorse 1.5 Flash 预览,复用多模型执行经验训练(在新窗口打开)
团队以 Qwen3.8-Flash 为基础进行后训练,主模型 1250 亿参数、激活 60 亿。厂商评测中部分 Agent 任务分数提高,计算与数学类别下降,文章也给出四个官方案例。
AI圈杀出一匹黑马!AK分享、魔搭推荐、Agent原生模型NeoHorse-1下载破万!(在新窗口打开)
基元律动发布的Agent原生模型NeoHorse-1上线三天即在Hugging Face下载量突破1.2万次,并获AK在X推荐及魔搭ModelScope官方推荐,社区开发者已制作出面向Apple Silicon的MLX量化版本。

Agent驱动的模型训练,基元律动做了一次迈向RSI的实验(在新窗口打开)
Agent 完成任务后,学到的经验去了哪里?
独家丨王云鹤创业估值数亿美元,押注多模型 Harness和 Agent-Native Model(在新窗口打开)
AI 基础设施公司基元律动(TokenRhythm)近日完成新一轮融资,截至目前累计融资金额达数千万美金。本轮融资由弘晖基金领投,聚合资本、尚势资本等机构参与。此前,公司已完成由 Granite Asia 领投,鼎晖 VGC、元璟资本、无限基金参与的种子轮融资。