Know AI. See What’s Next.
第 1 张,共 5 张:Anthropic成长路径:Claude商业化、治理架构与AI安全争议
最新资讯流
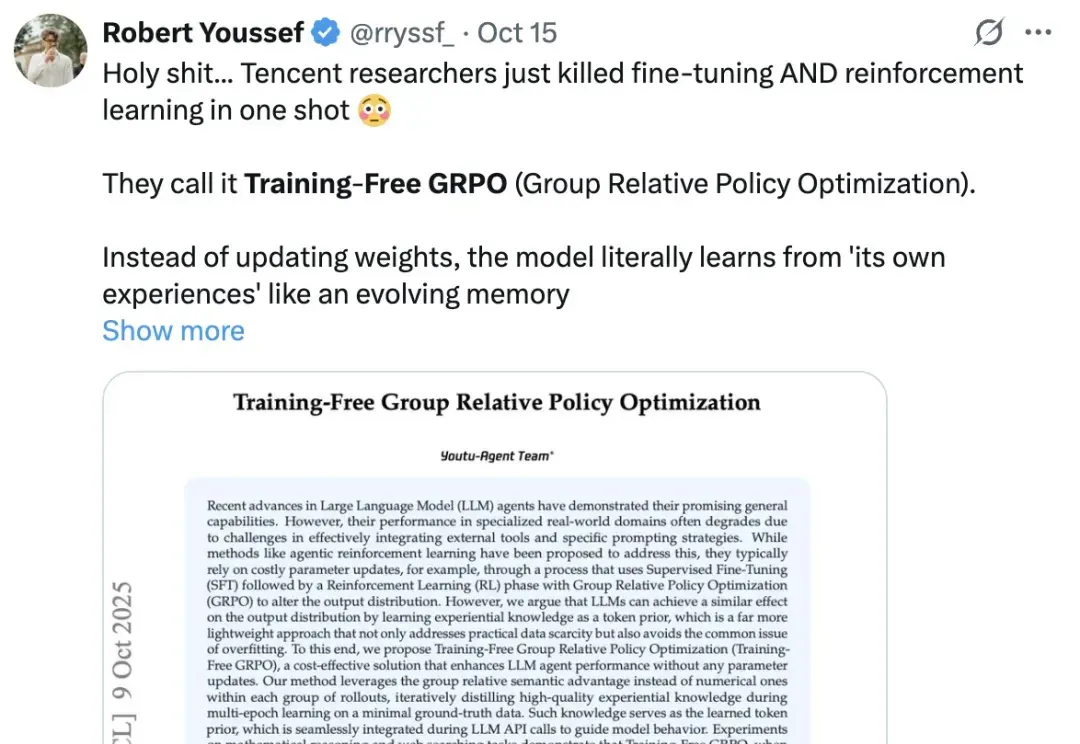
X上63万人围观的Traning-Free GRPO:把GRPO搬进上下文空间学习(在新窗口打开)
年初的 DeepSeek-R1,带来了大模型强化学习(RL)的火爆。无论是数学推理、工具调用,还是多智能体协作,GRPO(Group Relative Policy Optimization)都成了最常见的 RL 算法。
增速12.8%,人工智能成为上海经济发展重要动力(在新窗口打开)
上海前三季度GDP增5.5%,AI制造业增12.8%,成增长引擎。
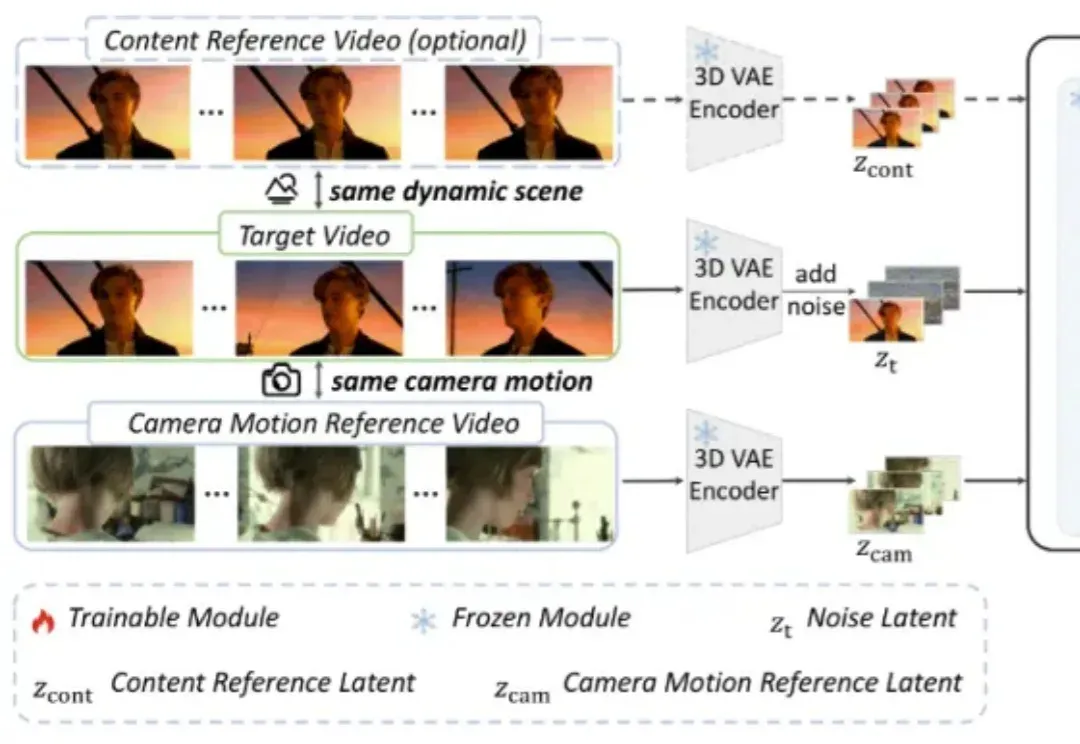
SIGGRAPH Asia 2025|电影级运镜一键克隆!港中文&快手可灵团队发布CamCloneMaster(在新窗口打开)
作为视频创作者,你是否曾梦想复刻《盗梦空间》里颠覆物理的旋转镜头,或是重现《泰坦尼克号》船头经典的追踪运镜?
LiblibAI完成1.3亿美元B轮融资,拿下国内最大单笔AI应用投资(在新窗口打开)
10月23日,AI应用公司LiblibAI宣布完成1.3亿美元B轮融资,由红杉中国、CMC资本及一战略投资方联合领投,多家老股东超额增持。高榕创投曾于2023年联合领投LiblibAI天使轮。 在AI
攻克长文档与多模态挑战,Paper2Video实现学术视频的自动化生产(在新窗口打开)
学术展示视频作为科研交流的重要媒介,制作过程仍高度依赖人工,需要反复进行幻灯片设计、逐页录制和后期剪辑,往往需要数小时才能产出几分钟的视频,效率低下且成本高昂,这凸显了推动学术展示视频自动化生成的必要性。
比Transformer更强的架构来了?浙大新作Translution,一统卷积和自注意力(在新窗口打开)
近日,范鹤鹤(浙江大学)、杨易(浙江大学)、Mohan Kankanhalli(新加坡国立大学)和吴飞(浙江大学)四位老师提出了一种具有划时代意义的神经网络基础操作——Translution。 该研究认为,神经网络对某种类型数据建模的本质是:
只有0.9B的PaddleOCR-VL,却是现在最强的OCR模型。(在新窗口打开)
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。
碾压超算13000倍!1个月内,谷歌量子AI连斩诺奖+Nature封面(在新窗口打开)
当谷歌用量子计算机窥探到经典世界无法触及的物理秘密时,我们离那个能设计新药、创造新材料的「量子霸权」又近了一大步,下一个诺贝尔奖的种子或许已在此刻种下。
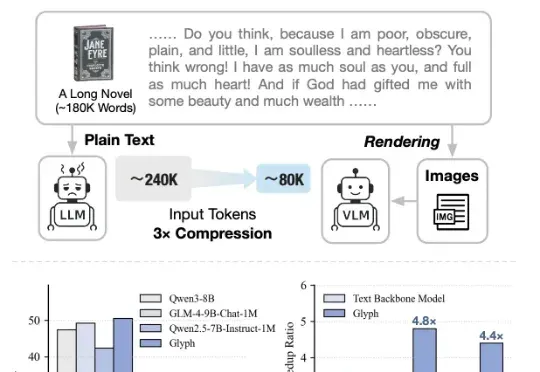
智谱运气是差一点点,视觉Token研究又和DeepSeek撞车了(在新窗口打开)
太卷了,DeepSeek-OCR刚发布不到一天,智谱就开源了自家的视觉Token方案——Glyph。既然是同台对垒,那自然得请这两天疯狂点赞DeepSeek的卡帕西来鉴赏一下:
Accel领投2200万美元,这家让YC创始人都心动的公司,打造浏览器AI agent的"操作系统"(在新窗口打开)
虽然浏览器 AI agent 的概念听起来很美好,但实际构建这样的系统却面临巨大挑战。这正是 Kernel 要解决的核心问题。我发现很多开发者想要构建 AI agent,但却在基础设施层面遇到了各种障碍:性能不稳定、运行时间不可靠、定价不合理、身份认证复杂、权限管理混乱,以及一个本来就不是为 agent 设计的互联网世界。
ChatGPT缔造者联手DeepMind大神,用AI攻坚高温超导,半个硅谷抢着投(在新窗口打开)
OpenAI前研究副总裁Liam Fedus与DeepMind材料科学领军者Ekin Cubuk共创Periodic Labs,以一轮高达3亿美元的种子融资走出隐身模式,震惊硅谷。然而,曾给出祝福的前东家OpenAI,并未参与本轮投资。
OpenAI设立秘密项目,招募华尔街专家训练AI构建金融模型,时薪上千元(在新窗口打开)
10月21日消息,据最新披露的文件显示,OpenAI正在秘密推进一项名为“水星项目”(Project Mercury)的绝密计划,已招募超过100名前投资银行家,协助训练AI系统构建复杂的金融模型,从而取代初级投行员工耗费大量时间的工作。
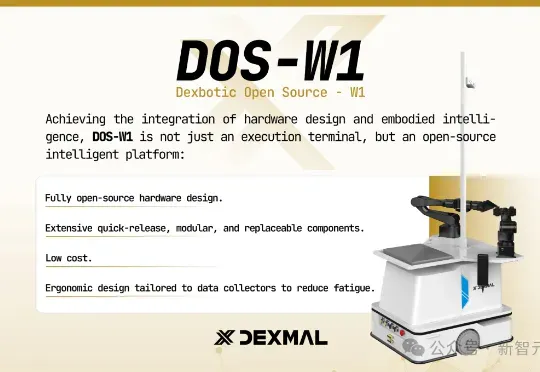
刚刚,Dexbotic开源!VLA性能+46%,机器人叠盘子100%成功,统一具身智能底座(在新窗口打开)
刚刚,这个开源的VLA一站式平台,不仅让UR5e真机实现了100%成功率,还在五大仿真环境中全面领先,最高性能提升高达46%,而且还支持RTX 4090训练!最近,由Dexmal 原力灵机重磅开源的Dexbotic,则构建了一个「VLA统一平台」。Dexbotic作为具身智能VLA模型一站式科研服务平台,可以为VLA科研提供基础设施,加速研究效率。
速递|OpenAI 日本竞争对手 Sakana 正洽谈以 25 亿美元估值融资(在新窗口打开)
总部位于东京的人工智能开发商Sakana AI 正与美国和日本投资者洽谈,拟以 25 亿美元的估值融资 1 亿美元,较一年前一轮融资的估值上涨 66%。参与商谈的两位知情人士透露了这一消息。
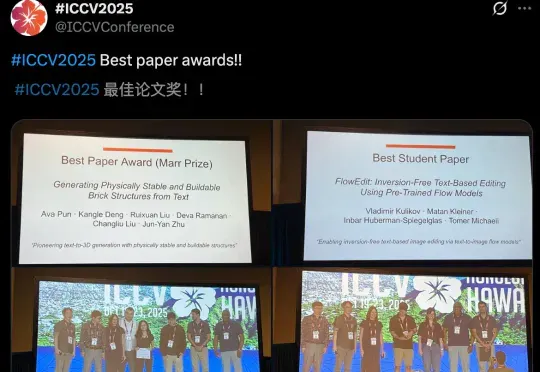
ICCV 2025最佳论文出炉!何恺明、孙剑等十年经典之作夺奖(在新窗口打开)
ICCV最佳论文新鲜出炉了!今年,CMU团队满载而归,斩获最佳论文奖和最佳论文提名。同时,何恺明团队论文,RBG大神提出的Fast R-CNN,十年后斩获Helmholtz Prize,实至名归。
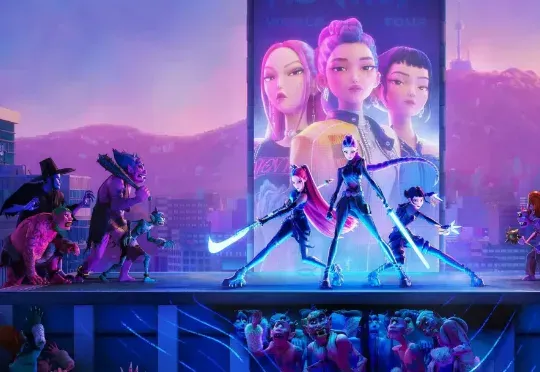
刷屏的《海贼王》真人版片场花絮,居然是 AI 做的,4 步教你复刻同款(在新窗口打开)
视频里,演员们穿着精致的戏服,在片场与工作人员互动、准备拍摄;摄影机、灯光、演员、助理,全都在忙。 就是这样一个 35 秒的「泄露」片段,在社交媒体上迅速疯传,YouTube 相关视频播放量破千万。
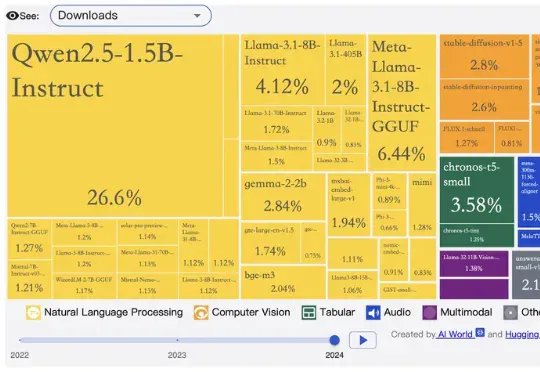
如果中国大模型不再开源(在新窗口打开)
美国 AI 圈开始出现“担心中国开源断供”的苗头了吗?10 月 20 日,在专注于开源模型讨论、拥有 55 万成员的 Reddit 分论坛“r/LocalLLaMA”上,一位网友发布了一则“当中国公司停止提供开源模型时会发生什么?”的提问,并表达了假如中国模型逐渐闭源或开始收费该怎么办的担忧。
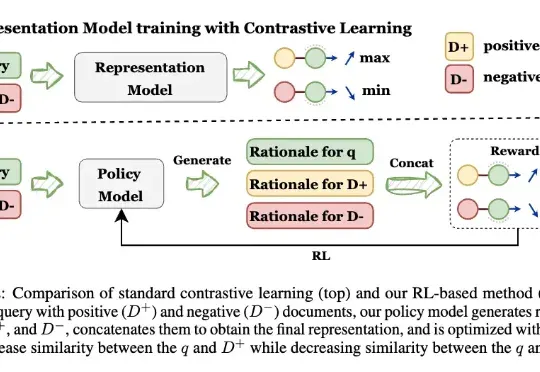
Embedding黑箱成为历史!这个新框架让模型“先解释,再学Embedding”(在新窗口打开)
让模型先解释,再学Embedding! 来自UIUC、ANU、港科大、UW、TAMU等多所高校的研究人员,最新推出可解释的生成式Embedding框架——GRACE。过去几年,文本表征(Text Embedding)模型经历了从BERT到E5、GTE、LLM2Vec,Qwen-Embedding等不断演进的浪潮。这些模型将文本映射为向量空间,用于语义检索、聚类、问答匹配等任务。
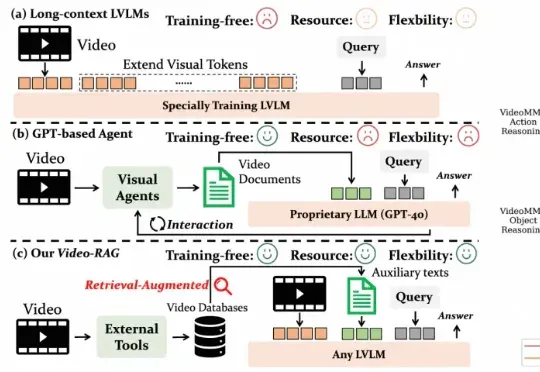
轻量高效,即插即用:Video-RAG为长视频理解带来新范式(在新窗口打开)
尽管视觉语言模型(LVLMs)在图像与短视频理解中已取得显著进展,但在处理长时序、复杂语义的视频内容时仍面临巨大挑战 —— 上下文长度限制、跨模态对齐困难、计算成本高昂等问题制约着其实际应用。针对这一难题,厦门大学、罗切斯特大学与南京大学联合提出了一种轻量高效、无需微调的创新框架 ——Video-RAG。
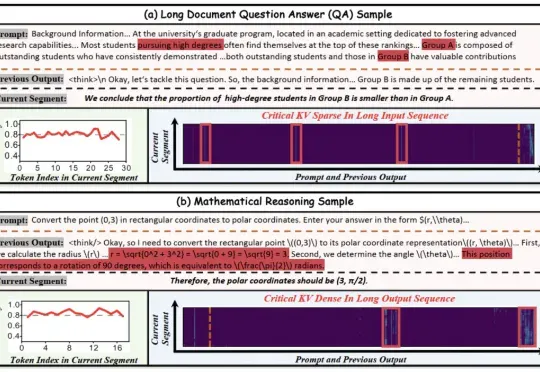
长序列推理不再卡顿!北大华为KV缓存管理框架实现4.7倍推理加速(在新窗口打开)
北大华为联手推出KV cache管理新方式,推理速度比前SOTA提升4.7倍! 大模型处理长序列时,KV cache的内存占用随序列长度线性增长,已成为制约模型部署的严峻瓶颈。