Know AI. See What’s Next.
第 1 张,共 5 张:Anthropic成长路径:Claude商业化、治理架构与AI安全争议
最新资讯流
红色警报:OpenAI的Atlas浏览器,是捅向谷歌万亿心脏的匕首吗?(在新窗口打开)
浏览器「第三次世界大战」打响!OpenAI向谷歌扔下一个AI核弹,谁能掌握未来互联网之门的钥匙?互联网未来之战已然打响。OpenAI在所有人(尤其是山景城)最意想不到的时分,发布一款直指谷歌核心业务命脉的新产品。
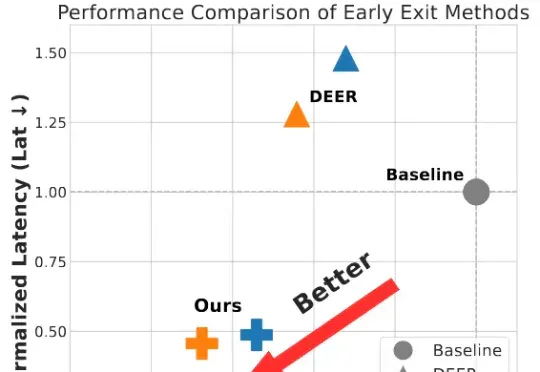
腾讯发布SpecExit算法,无损压缩端到端加速2.5倍!解决大模型长思考效率难题(在新窗口打开)
为破解大模型长思维链的效率难题,并且为了更好的端到端加速落地,我们将思考早停与投机采样无缝融合,提出了 SpecExit 方法,利用轻量级草稿模型预测 “退出信号”,在避免额外探测开销的同时将思维链长度缩短 66%,vLLM 上推理端到端加速 2.5 倍。
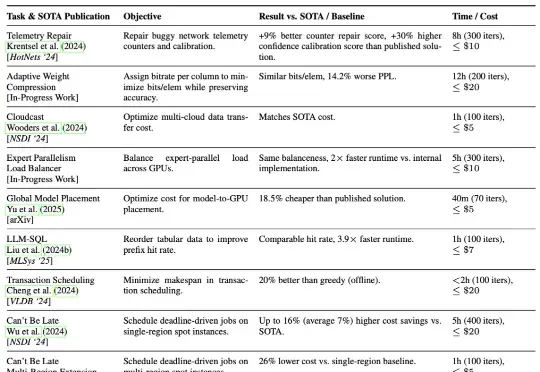
AI五小时发现MoE新算法,比人类算法快5倍,成本狂降26%(在新窗口打开)
加州大学伯克利分校的研究团队提出了一种AI驱动的系统研究方法ADRS(AI-Driven Research for Systems),它可以通过“生成—评估—改进”的迭代循环,实现算法的持续优化。
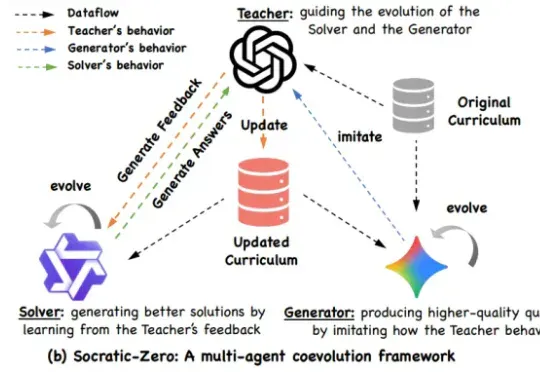
仅100种子题,合成数据质量超GPT-5,阿里、上交提出Socratic-Zero框架(在新窗口打开)
阿里巴巴与上海交通大学 EPIC Lab 联合提出 Socratic-Zero,一个完全无外部数据依赖的自主推理训练框架。该方法仅从 100 个种子问题出发,通过三个智能体的协同进化,自动生成高质量、难度自适应的课程,并持续提升模型推理能力。
100万块TPU!Anthropic谷歌数百亿美元大单敲定,美国AI基建狂飙(在新窗口打开)
10月24日消息,今日,谷歌Anthropic发布声明,宣布谷歌将向Anthropic供应至多100万块专用AI芯片TPU以及附加的谷歌云服务,这笔交易价值数百亿美元。谷歌在声明中称,这是Anthropic迄今为止规模最大的TPU扩容计划。至此,Anthropic已与谷歌、亚马逊与英伟达三大芯片提供商达成合作。
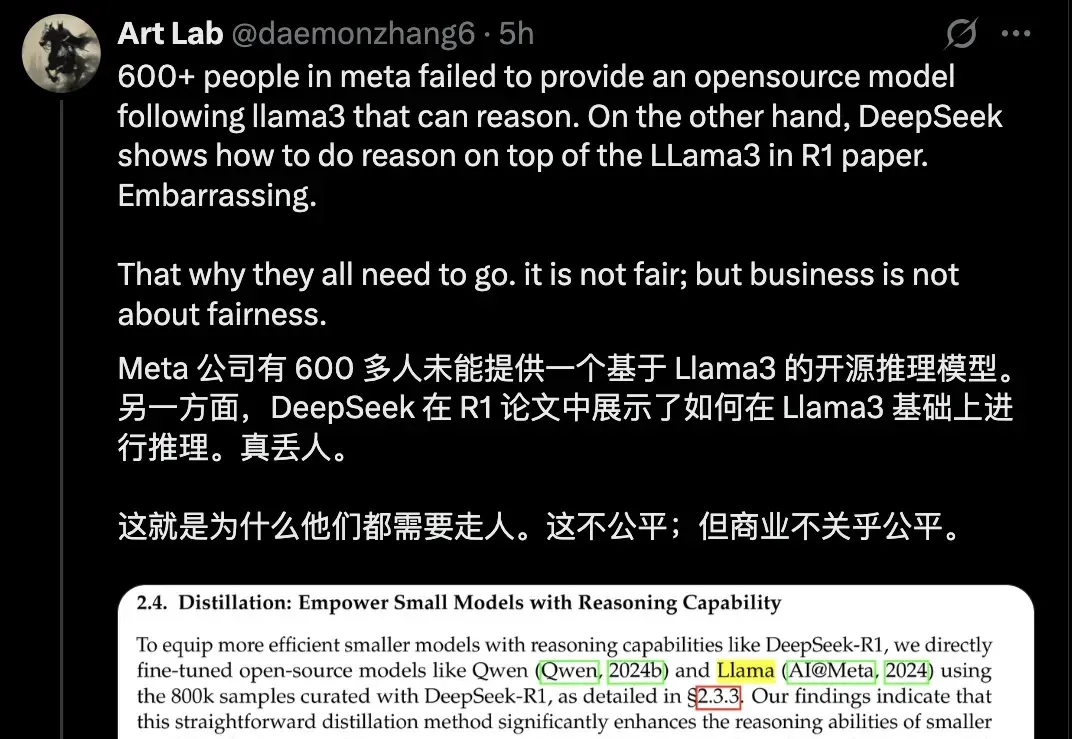
田渊栋被裁后新offer排到法国!原来Llama 4.5训完后被卸磨杀驴了(在新窗口打开)
刚刚从Meta一线获悉,田渊栋前脚刚发了推文说自己被裁,后脚就被解除了公司内部各种权限——嘿,亚历山大王的刀,就是这么快。这也是这次裁员中最具争议的地方,“在Meta工作已超过十年的田渊栋和他的组员,整组被一锅端了”,这是为什么?
OpenAI收购macOS供应商,剑指GPT操作系统!微软也不装了(在新窗口打开)
OpenAI全新收购曝光,曾为Mac开发自然语言交互界面——Sky——的公司如今成了GPT生态的一员。作为交易的一部分,OpenAI将把Sky的技术整合进ChatGPT,并吸纳这支约12人的团队。
谷歌放大招!Gemini「吞下」2.5亿地图数据,路痴AI一夜成精(在新窗口打开)
世界在AI眼中活了过来!谷歌Grounding with Google Maps功能上线,Gemini可调用2.5亿地点信息,结合搜索工具,提供更准确、更及时的答案,完美适用于旅行规划和本地服务。
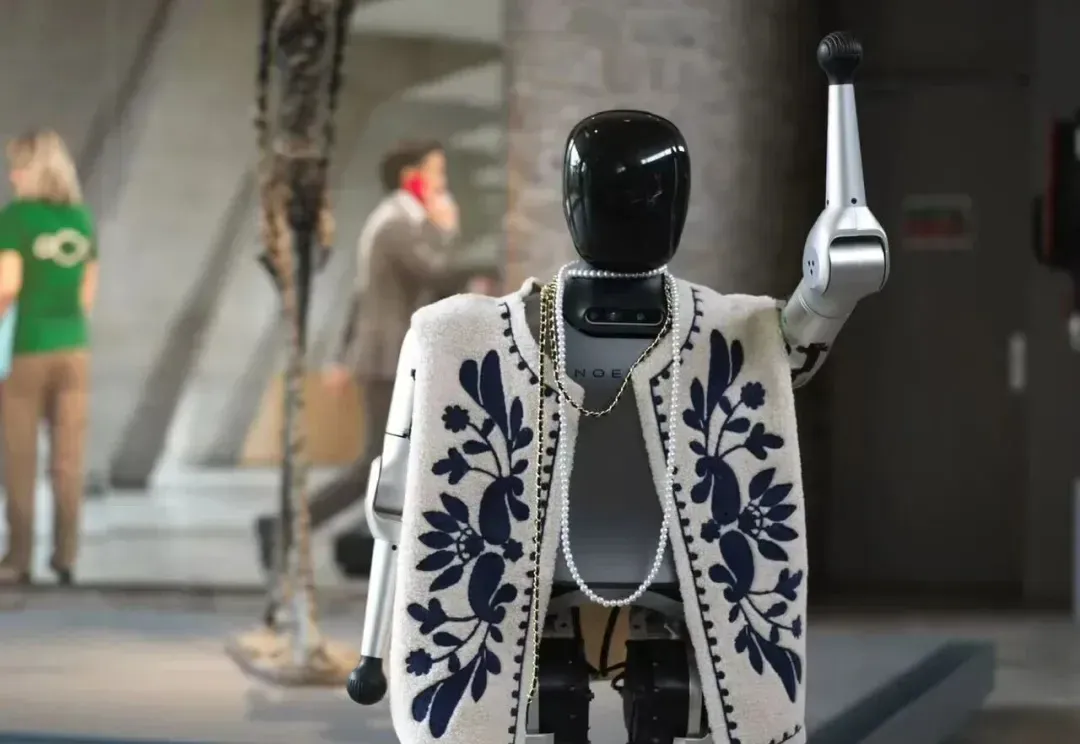
9998元抱回家!全球首款万元以下人形机器人来了,21自由度,能说会走,会尬舞(在新窗口打开)
这个双十一,终于可以把人形机器人放入购物车了。今年,还有一件「意想不到」的商品悄悄加入——不是模型,也不是玩具,而是真·能走能跑、能跟你聊天、还能跳舞的人形机器人。
构建AI虚拟细胞基础模型,「百曜科技」获数千万元天使轮融资 | 36氪首发(在新窗口打开)
近两三年,在技术演进下,“AI虚拟细胞”成为备受关注的热门赛道。AI虚拟细胞平台公司「百曜科技」近日完成数千万元天使轮融资,由峰瑞资本领投,顺禧资本跟投,明德资本担任独家财务顾问。
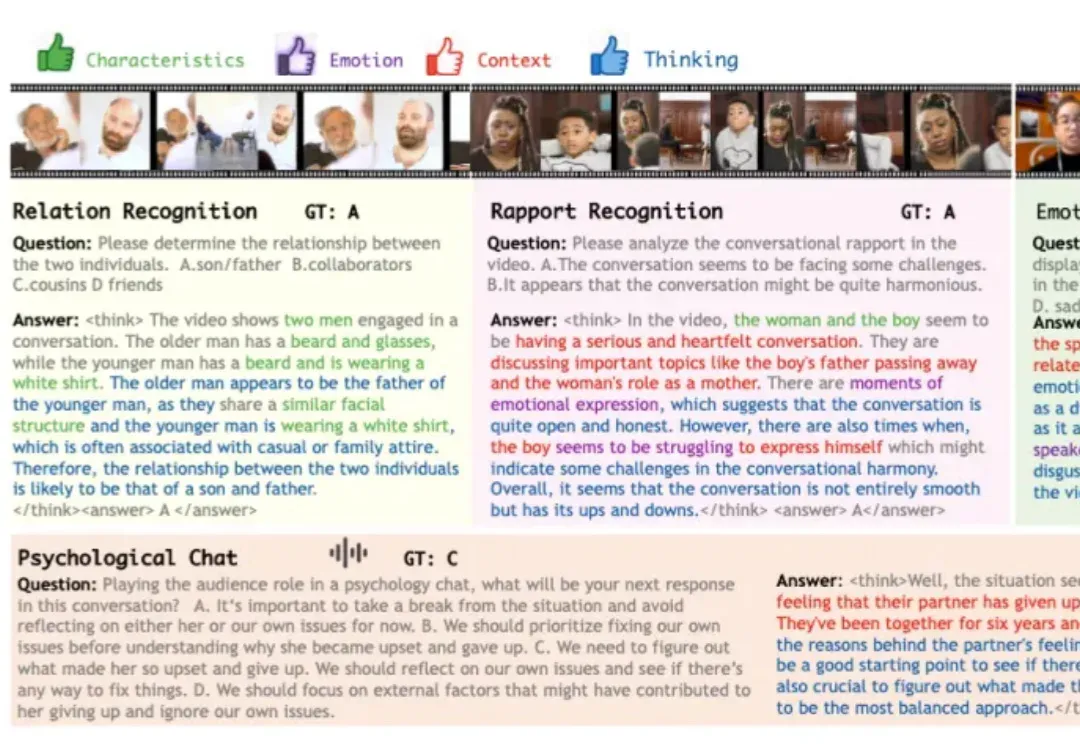
HumanSense:探索多模态推理边界,打造「察言观色会共情」的全模态交互伙伴(在新窗口打开)
在科幻作品描绘的未来,人工智能不仅仅是完成任务的工具,更是为人类提供情感陪伴与生活支持的伙伴。在实现这一愿景的探索中,多模态大模型已展现出一定潜力,可以接受视觉、语音等多模态的信息输入,结合上下文做出反馈。
OpenAI秘密项目曝出!百名投行精英密训AI,华尔街最贵苦力要失业了?(在新窗口打开)
刚刚,OpenAI内部秘密项目「Mercury」(水星)曝出!该项目正高薪招募百名前投行精英训练财务模型,旨在替代初级银行家的重复性工作。业内普遍认为,这是OpenAI在算力成本高企背景下,加速商业化与盈利的关键一步。
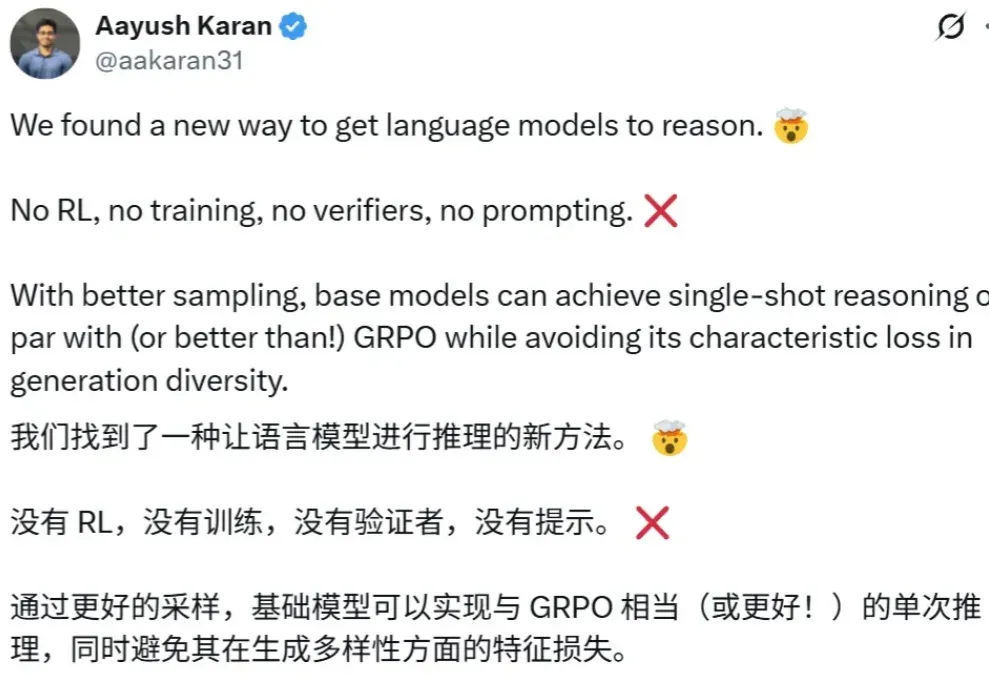
不用强化学习也能推理,哈佛新采样算法竟能让基础模型比肩GRPO后训练版本(在新窗口打开)
强化学习能力强大,几乎已经成为推理模型训练流程中的标配,也有不少研究者在探索强化学习可以为大模型带来哪些涌现行为。
Meta「透视」AI思维链:CRV推理诊断,准确率达 92%!(在新窗口打开)
在最近一篇来自Meta FAIR团队的论文里,研究者找到了一种前所未有的方式——他们能实时看到AI的思考过程。这项名为CRV的方法,通过替换模型内部的MLP模块,让每一步推理都变得「可见」。这不是隐喻,而是可量化的现象。Meta用它让错误检测精度提升到92.47%,也让人类第一次得以窥见AI是怎么想错的。
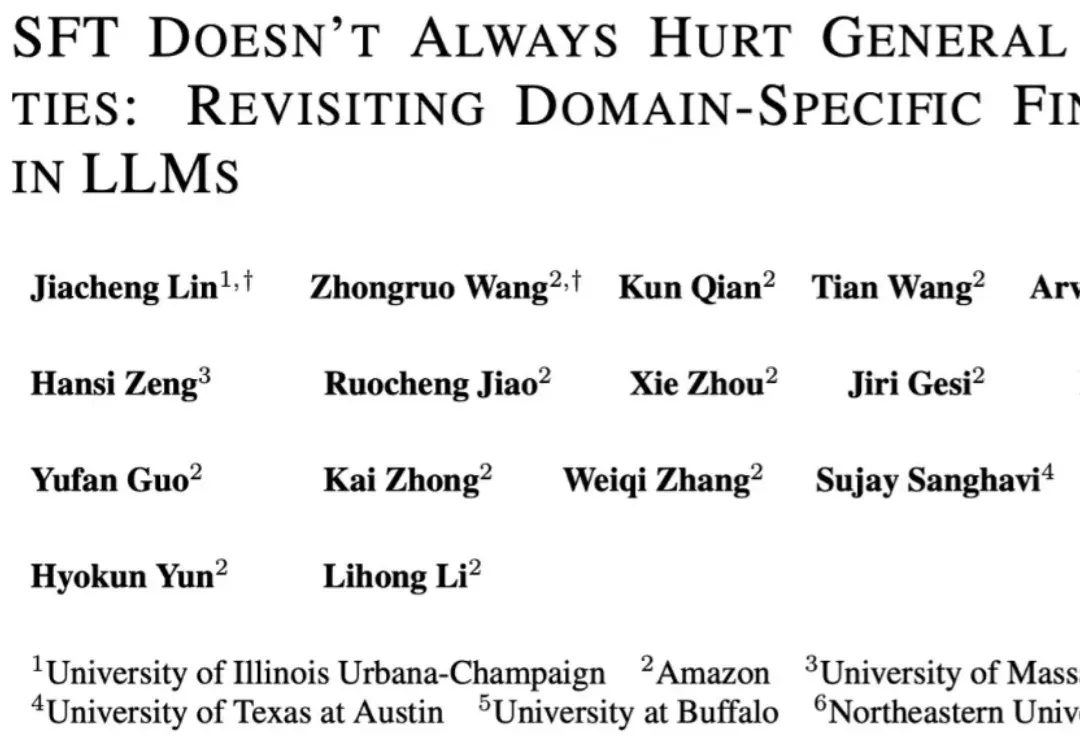
大模型微调范式认知再被颠覆?UIUC、Amazon团队最新研究指出SFT灾难性遗忘问题或被误解(在新窗口打开)
在大模型微调实践中,SFT(监督微调)几乎成为主流流程的一部分,被广泛应用于各类下游任务和专用场景。比如,在医疗领域,研究人员往往会用领域专属数据对大模型进行微调,从而显著提升模型在该领域特定任务上的表现。
斩获10K Star!谷歌最新Chrome MCP接入Claude Code又香了~(在新窗口打开)
大家好,我是袋鼠帝。 国庆那几天,刷抖音,偶然刷到了一个看起来挺🐂🍺的AI工具。 视频里,一个哥们只是发布了一个任务,Agent就自动打开了小红书网站,登录账号,上传图片,写入标题和笔记内容,最后自己
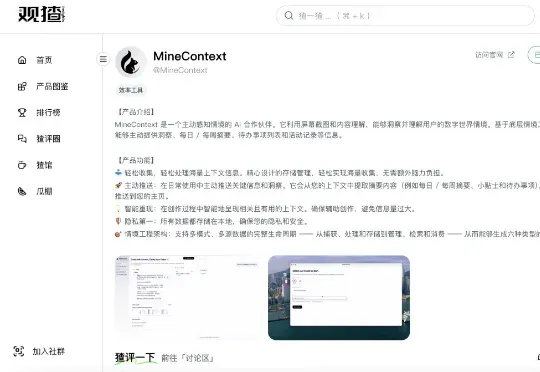
字节开源了一个让人上头的 Context 项目(在新窗口打开)
最近在开源社区闲逛,发现字节悄悄放出了一个叫 MineContext 的项目。和字节Viking团队的小伙伴聊天时,我了解到一个挺有意思的故事:MineContext 团队其实在今年四五月份就有了初步想法,甚至更早之前就在思考:如何围绕个人的完整记忆来做应用。
语音模型公司做AI眼镜,拿下了红杉领投的2.5亿美元?(在新窗口打开)
TechCrunch 报道,之前一直以 AI 语音初创公司示人的 Sesame,完成了 2.5 亿美元的 B 轮融资,投资方包括红杉资本、Spark Capital 及其他未公开的投资者。随后,Sesame 创始人 Brendan Iribe 也在个人社媒账号上发帖,证实该消息。
现在,最会赚钱的AI是Qwen3!全球六大模型厮杀,Top 2来自中国(在新窗口打开)
全球六大LLM实盘厮杀,新王登基!今天,Qwen3 Max凭借一波「快狠准」操作,逆袭DeepSeek夺下第一。Qwen3 Max,一骑绝尘! 而GPT-5则接替Gemini 2.5 Pro,成为「最会赔钱」的AI。照目前这个趋势,估计很快就要跌没了……
快手进军AI编程!“模型+工具+平台”一口气放三个大招(在新窗口打开)
AI编程领域竞争正酣。就在DeepSeek、阿里、Google、OpenAI等巨头纷纷展示最新代码生成能力之际,快手也交出了一份重量级答卷——发布AI编程产品矩阵,正式宣布进军AI Coding赛道。