Know AI. See What’s Next.
第 1 张,共 5 张:Anthropic成长路径:Claude商业化、治理架构与AI安全争议
最新资讯流
人在美国,待过三家AI Lab,全凉了!(在新窗口打开)
科技行业全球10万大裁员,连10年老将田渊栋都被Meta裁掉了!昨天,南洋理工大学的副教授Boyang Li吊足了大家的胃口:Meta FAIR最近的事件很抓马,但工业研究为什么这么难?我想知道大家愿不愿意听一下我的观点。
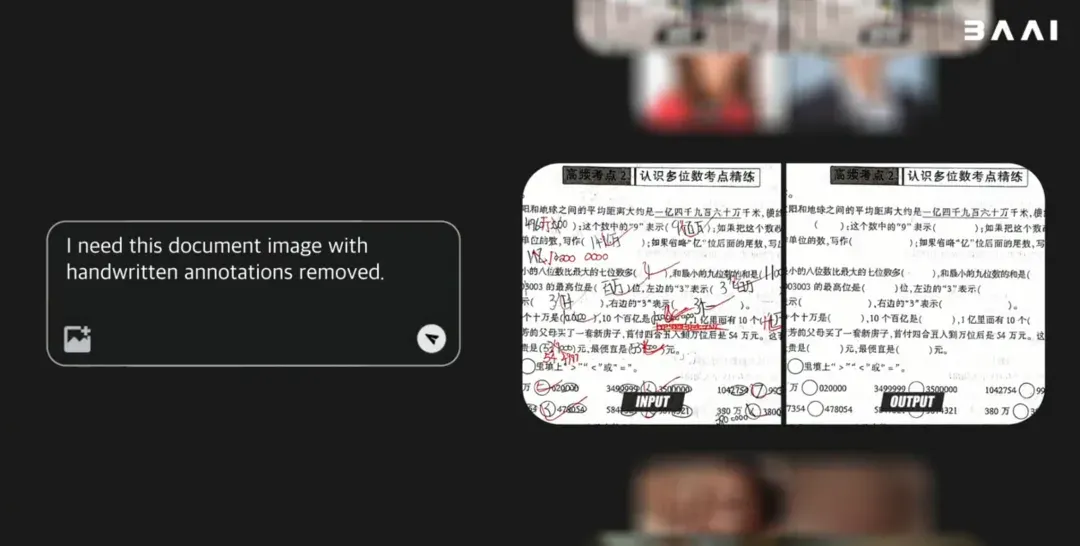
世界模型有了开源基座Emu3.5!拿下多模态SOTA,性能超越Nano Banana(在新窗口打开)
最新最强的开源原生多模态世界模型—— 北京智源人工智能研究院(BAAI)的悟界·Emu3.5来炸场了。 图、文、视频任务一网打尽,不仅能画图改图,还能生成图文教程,视频任务更是增加了物理真实性。
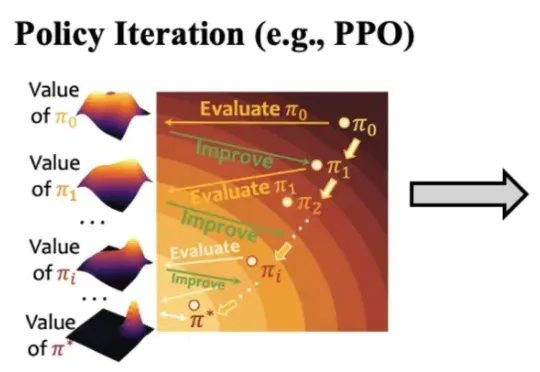
港科提出新算法革新大模型推理范式:随机策略估值竟成LLM数学推理「神操作」(在新窗口打开)
论文第一作者何浩然是香港科技大学博士生,研究方向包括强化学习和基础模型等,研究目标是通过经验和奖励激发超级智能。共同第一作者叶语霄是香港科技大学一年级博士。通讯作者为香港科技大学电子及计算机工程系、计
内存直降50%,token需求少56%!用视觉方式处理长文本(在新窗口打开)
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
从 SD 到 Wan2.5-Preview,AI 视频 2025 质变启示录(在新窗口打开)
最大的时代红利,属于今年四季度发布的中美两大明星产品,OpenAI 的 Sora 2 与阿里的 Wan2.5-Preview。其中,Sora 2 的登场堪称一场教科书级的营销战役。熟悉的邀请码机制再次奏效,用户为了获得一个入场券除了需要购买 GPT 的会员之外,甚至还在二手平台再花几十美金购买邀请码。更绝的是,它把自己变成了一个 AI 版抖音,
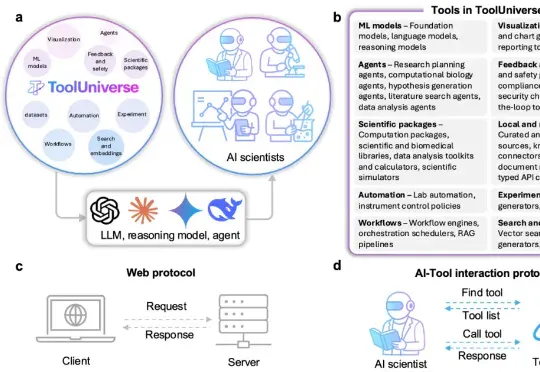
无需训练一键调用超600种工具,哈佛MIT打造AI科学家的“Linux操作系统”,让大模型秒变专家自主做实验(在新窗口打开)
近日,OpenAI 宣称要在 2028 年实现让 AI 完全自主做研究,一下子又把焦点聚在了AI 科学家。 过去,AI 只是作为“助理”辅助研究者们进行科学研究。现在,美国哈佛大学与美国麻省理工学院联
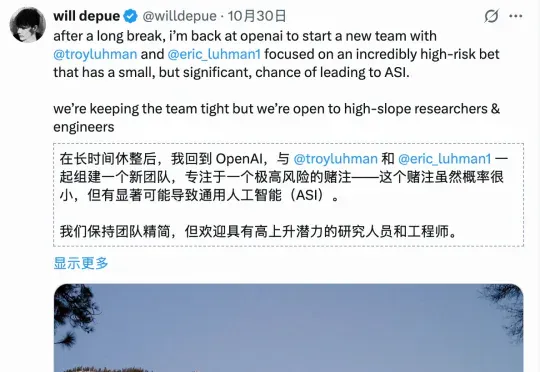
Sora天才辍学生归来!OpenAI组建3人神秘小队,豪赌超级人工智能(在新窗口打开)
Sora背后的核心贡献者之一,这位00后的天才辍学生Will Depue,准备再次搞个大事情。刚刚,他宣布下一个目标是,超级人工智能ASI!在结束一段长期休息后,Will Depue宣布他再次回到OpenAI。
Kimi开源新线性注意力架构,首次超越全注意力模型,推理速度暴涨6倍(在新窗口打开)
月之暗面最新发布的开源Kimi Linear架构,用一种全新的注意力机制,在相同训练条件下首次超越了全注意力模型。在长上下文任务中,它不仅减少了75%的KV缓存需求,还实现了高达6倍的推理加速。
让 AI 开口「像人」:最难的不是智能,是「嗓音」(在新窗口打开)
Voice Agent 赛道正在爆发,但它迫切需要一个能让对话真正「流动起来」的底层引擎,一个能撑起下一代交互体验的 TTS 模型。竞争的焦点,已经从 LLM 的「大脑」,延伸到了 TTS 的「嗓音」。谁掌握嗓音,谁就掌握着下一代 AI 商业化的钥匙。而 10 月 30 日 MiniMax 发布的 Speech 2.6 模型,似乎正是一个专为解决这些痛点而来的答案。
颤抖吧,Bug!OpenAI放出GPT-5「夜行神兽」,命中92%漏洞(在新窗口打开)
刚刚,OpenAI推出了使用GPT-5寻找和修复安全漏洞的智能体Aardvark。目前,Aardvark还处于beta测试阶段。OpenAI称,Aardvark开创了「防御者优先」的新范式:作为自主安全研究智能体,随代码不断演化,为团队提供持续保护(continuous protection)。
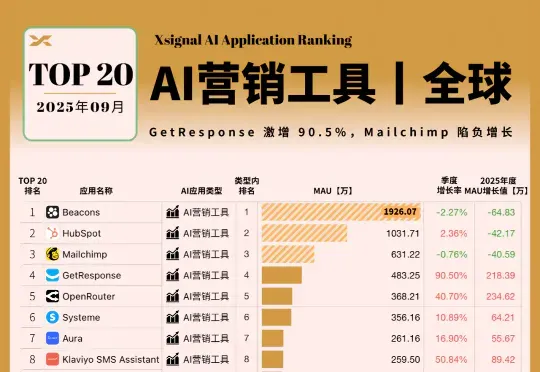
AI营销效率战下半场:“一人市场部”从“工具赋能”走向“生态整合”(在新窗口打开)
Xsignal AI Holo(AI全息)数据库的1-9月数据显示,市场(MAU)已自发掀起了一场“效率革命”的上半场:营销人员用脚投票,从Mailchimp等“旧势力”涌向GetResponse和“万相营造”等“效率新势力”。这证明了市场对“单点工具”效率提升的极度渴求。
重磅发布!国家队出手解决企业跨省通信「老大难」,语音识别错误率暴降20%(在新窗口打开)
还在忍受方言听不懂、跨省业务推进难?联通直接放出「云+AI」大招,把这些通信顽疾一锅端!本文为你揭秘,运营商如何用科技智慧破局,打开信息「黑匣子」,让效率飙升!
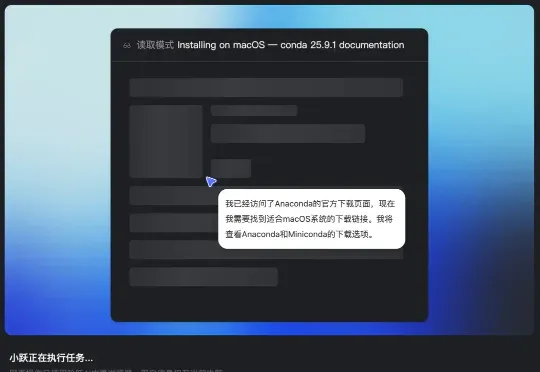
大模型公司不搞浏览器搞Agent,实测找到原因了(在新窗口打开)
闻乐 发自 凹非寺 量子位 | 公众号 QbitAI 如果Agent能操作命令行,就有了与整个计算机系统交互的能力。 也意味着一台计算机的几乎所有功能,都可以通过自然语言来驱动。 这种产品终于有雏形了
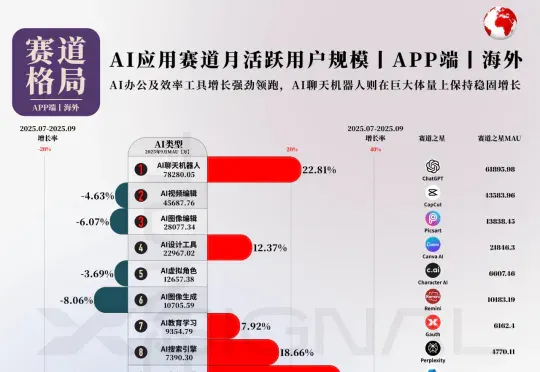
海外AI应用行业全景丨万字长文丨2025年9月丨赛道格局 + 赛道之王 + TOP 50 AI应用 + 增长之星丨Xsignal(在新窗口打开)
本次,X博士继续应用Xsignal数据交互平台的AI Holo(AI 全息)数据库数据,为你提供海外AI应用市场2025年9月的最新发展动态,发布2025年9月海外“赛道格局”、“赛道之王”、“TOP 50 AI应用”和“增长之星”四大数据榜单及深度洞察。
微软独家:OpenAI最新季度净亏损115亿美元(在新窗口打开)
这下知道OpenAI为啥要转型公共利益公司了……眼尖的网友发现,OpenAI上季度居然亏了115亿美元!重点是,这可不是哪家媒体的小道消息啊,而是OpenAI的最大金主——微软自己亲手捅出来的。
你有多久没在下五子棋的时候又唱又跳了?我用 AI 试了试(在新窗口打开)
你有多久没试过在用 AI 写歌的时候又唱又跳了?——没有人在用 AI 写歌的时候又唱又跳!这是 YouTube 上的一位音乐博主,本想用音乐生成软件做一些糟糕的 AI 音乐,取笑一下人工智能,却意外得到了「味挺正」的日本金属摇滚,一下子就在 TikTok 上迅速爆红。
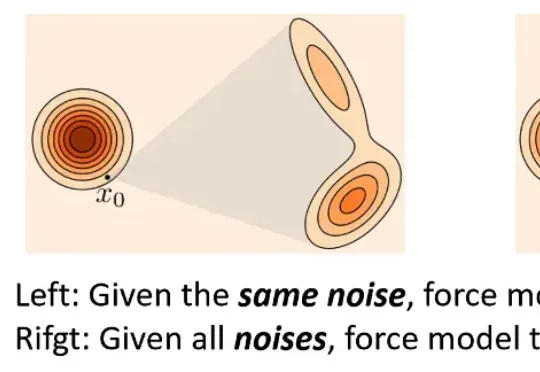
重新定义跨模态生成的流匹配范式,VAFlow让视频「自己发声」(在新窗口打开)
在多模态生成领域,由视频生成音频(Video-to-Audio,V2A)的任务要求模型理解视频语义,还要在时间维度上精准对齐声音与动态。早期的 V2A 方法采用自回归(Auto-Regressive)的方式将视频特征作为前缀来逐个生成音频 token,或者以掩码预测(Mask-Prediction)的方式并行地预测音频 token,逐步生成完整音频。
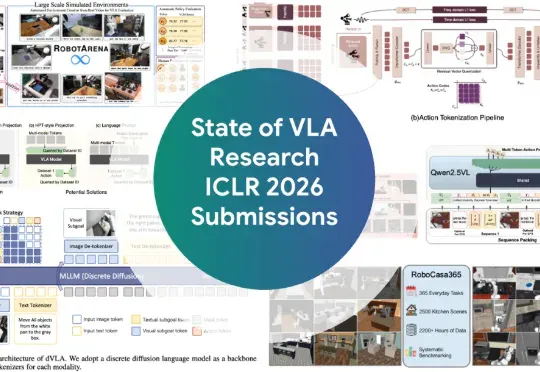
最火VLA,看这一篇综述就够了(在新窗口打开)
ICLR 2026爆火领域VLA(Vision-Language-Action,视觉-语言-动作)全面综述来了! 如果你还不了解VLA是什么,以及这个让机器人学者集体兴奋的领域进展如何,看这一篇就够了。
陶哲轩敲警钟!谷歌DeepMind联手五大神殿,用AI向世纪难题宣战(在新窗口打开)
今天,谷歌DeepMind重磅发起「AI赋能数学计划」,集结了全球五大顶尖机构。他们将用上谷歌最强数学AI,去探索发现新的疆域。这其中,有夺下IMO金牌的Gemini Deep Think,有算法发现AI智能体AlphaEvolve,还有形式化证明自动补全AlphaProof。
从兼职工程师直接跳到CTO,他用两个月让一款 Agent 干掉60%复杂工作并放话:“代码质量与产品成功没有直接关系”!(在新窗口打开)
在 AI 与自动化方面,Block 在 2025 年初推出了一个名为 “Goose” 的开源 AI Agent 框架。Goose 的设计初衷是:将大型语言模型输出与实际系统行为(如读取/写入文件、运行测试、自动化工作流)连接起来,从而不仅让模型能“聊”而且能“干活“。