Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
世界上首例AI媒人?Ditto AI可以为你找到另一半做些什么?(在新窗口打开)
Ditto是一个由伯克利辍学生Allen Wang和Eric Liu创立的人工智能约会平台,已筹集了160万美元,Allen Wang在4月通过Linkedin宣布,以“杀死Tinder为使命”的Ditto AI已拿到来自Google的200万美元融资。
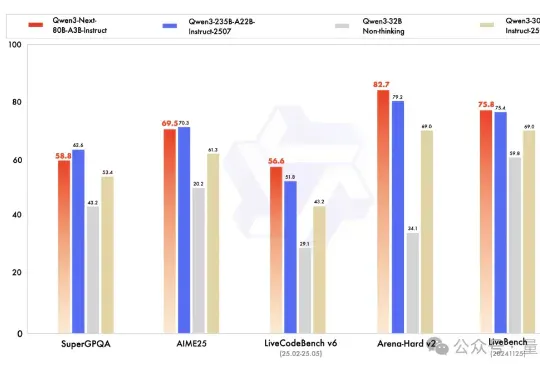
实测!Qwen下一代基础架构突袭!秒解AIME数学竞赛题,提速10倍+性价比提升10倍(在新窗口打开)
Qwen下一代模型架构,抢先来袭! Qwen3-Next发布,Qwen团队负责人林俊旸说,这就是Qwen3.5的抢先预览版。 基于Qwen3-Next,团队先开源了Qwen3-Next-80B-A3B-Base。
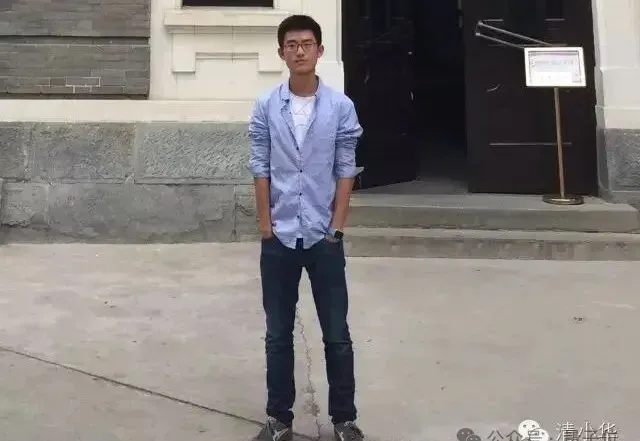
姚顺雨离职OpenAI,开启下半场(在新窗口打开)
为大模型开启“下半场”的姚顺雨,也开启了个人AI的下半场。
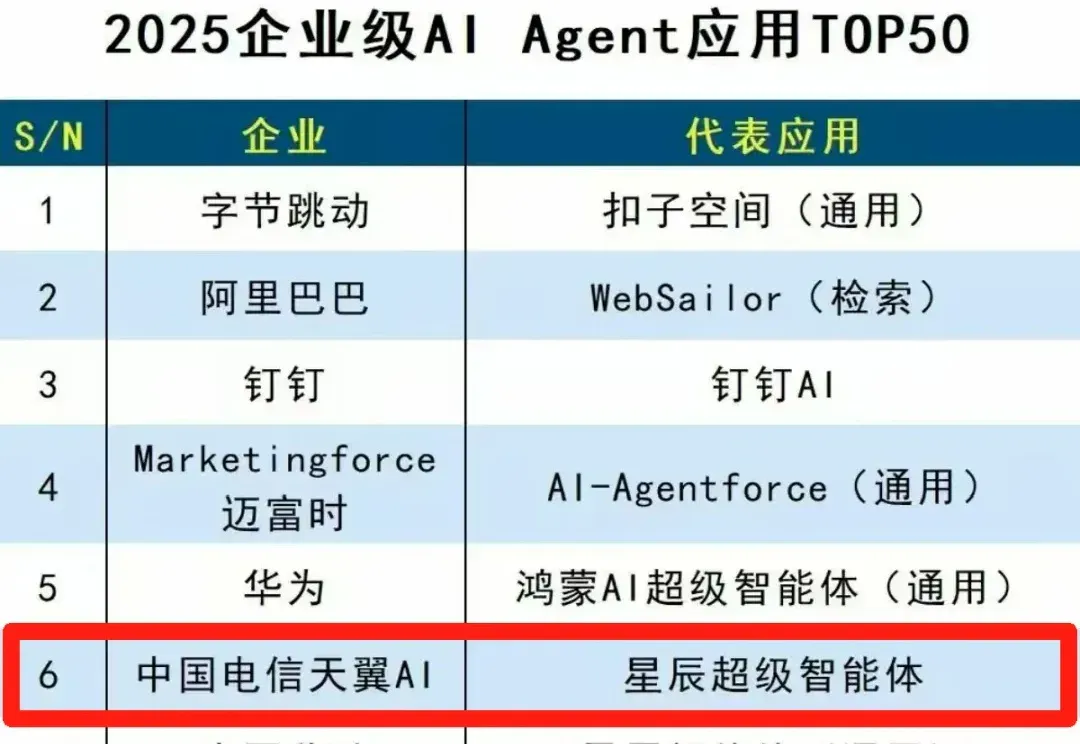
央企怎么做超级智能体?对谈中电信天翼AI:自研模型为底座,自主规划是必须,能适应千行百业才行(在新窗口打开)
超级智能体,央企出手了! 中国电信天翼AI发布星辰超级智能体,拿到DBC德本咨询2025企业级AI Agent榜单央企第一。 它依托中国电信自研“星辰大模型”技术底座,为产业智能升级而来。 最近智能体实在是太火了。 国务院关于深入实施“人工智能+”行动的意见中首次将智能体作为重点发展方向。DeepSeek也被曝在该领域布局,引发又一波市场热度。 不过新兴领域,热度常有、深度认知不常有。 尤其是智能体领域,它真的好用吗?产业落地真的靠谱吗?现在发展到底如何了?能力天花板在哪里?这些疑问一直存在于行业之中。 于是趁着这次“国家队”出手,我们找到领域内专家,认真聊了聊智能体的底层技术、行业落地以及发
前京东智能驾驶一号位创业,「星源智」要打造通用具身大脑(在新窗口打开)
在智驾行业摸爬滚打多年,刘东意识到,落地是具身智能公司能否存活下来的最重要指标。如果不能落地,即便融再多的钱也撑不到最后。
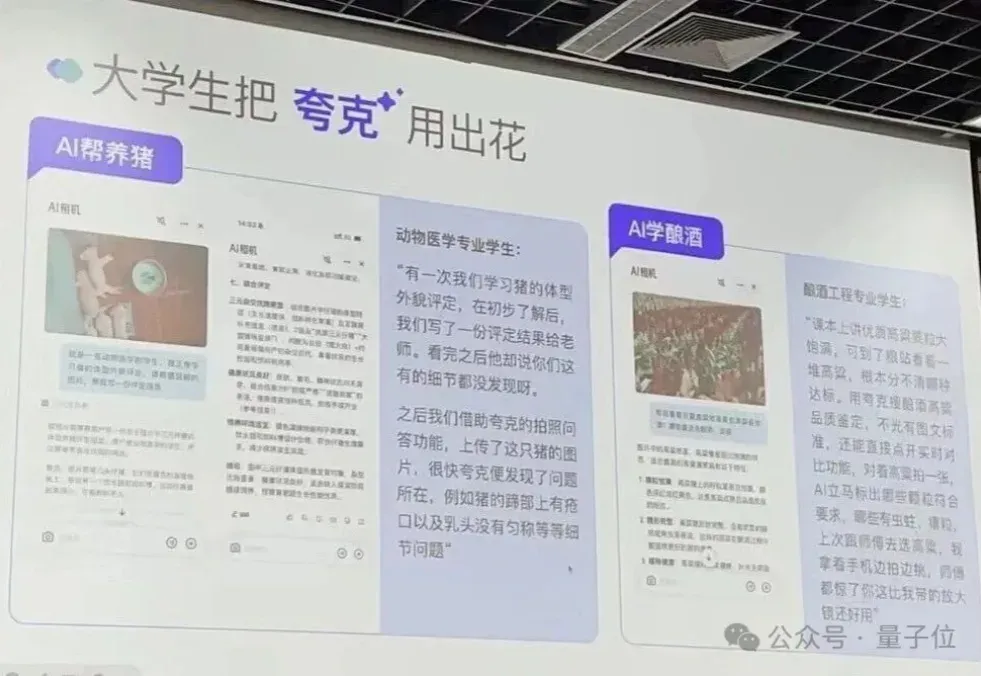
万万没想到,大学生都开始拿AI来养猪了(在新窗口打开)
有被大学生们使用AI的强度震惊到(doge)。
Meta超级智能实验室新论文陷争议!被指忽略大量前人研究(在新窗口打开)
Meta超级智能实验室(MSL)又被送上争议的风口浪尖了。
速递|Replit的“氛围编程”再融2.5亿美元:4000万用户、ARR1.5亿,估值一年翻三倍达30亿美元(在新窗口打开)
AI 编程初创公司 Replit 在一轮融资中成功筹集 2.5 亿美元,估值达到 30 亿美元。普信资本(Prysm Capital)正领投本轮融资,美国运通风投(Amex Ventures)和谷歌 AI 未来基金(Google’s AI Futures Fund)等投资机构参与其中。
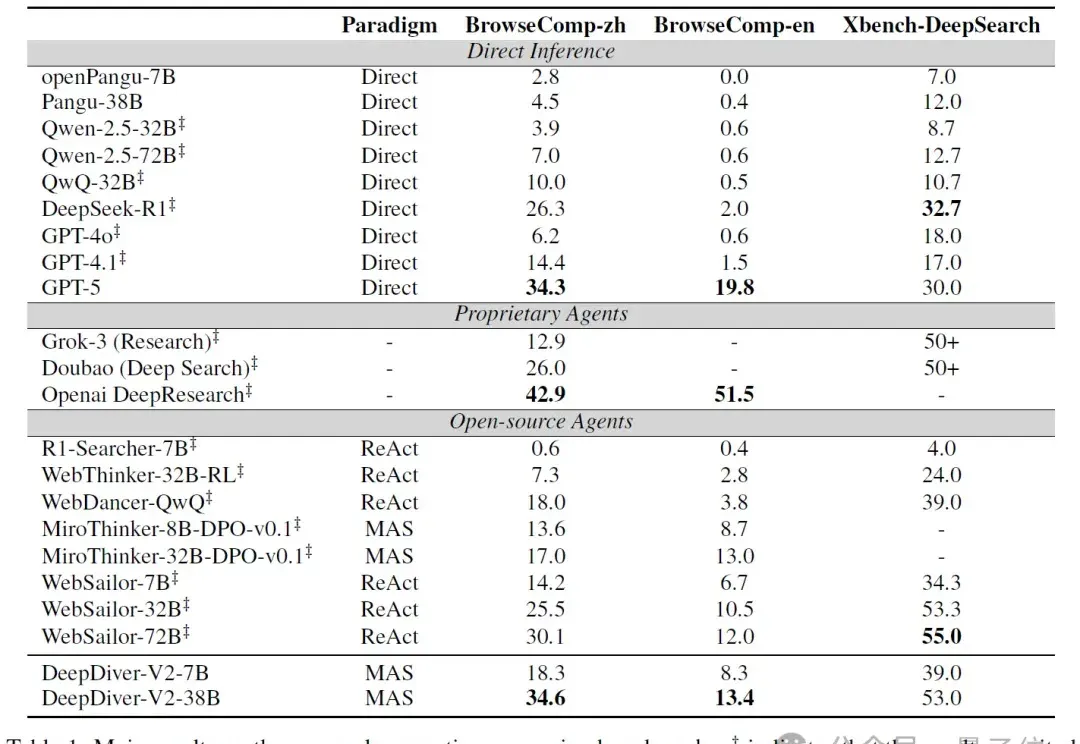
DeepDiver-V2来了,华为最新开源原生多智能体系统,“团战”深度研究效果惊人(在新窗口打开)
让智能体组团搞深度研究,效果爆表! 华为最新发布DeepDiver-V2原生多智能体系统。 采用了“团队作战”模式:一个Planner负责任务分解,任务分发,进度审视和成果验收,多个专业Executor并行处理子任务,通过共享文件系统高效交换信息。 与仅通过推理框架实现的多智能体系统不同,DeepDiver-V2以多智能体形态进行训练,模型天然具备更强的角色扮演和协同推理能力。这套系统不仅在复杂知识问答任务上取得突破,更是能够生成数万字的高质量深度研究报告,在多个榜单中表现亮眼。 它基于华为openPangu Agent推出的DeepDiver-V2,这是一个专攻AI深度搜索和长文调研报告生成
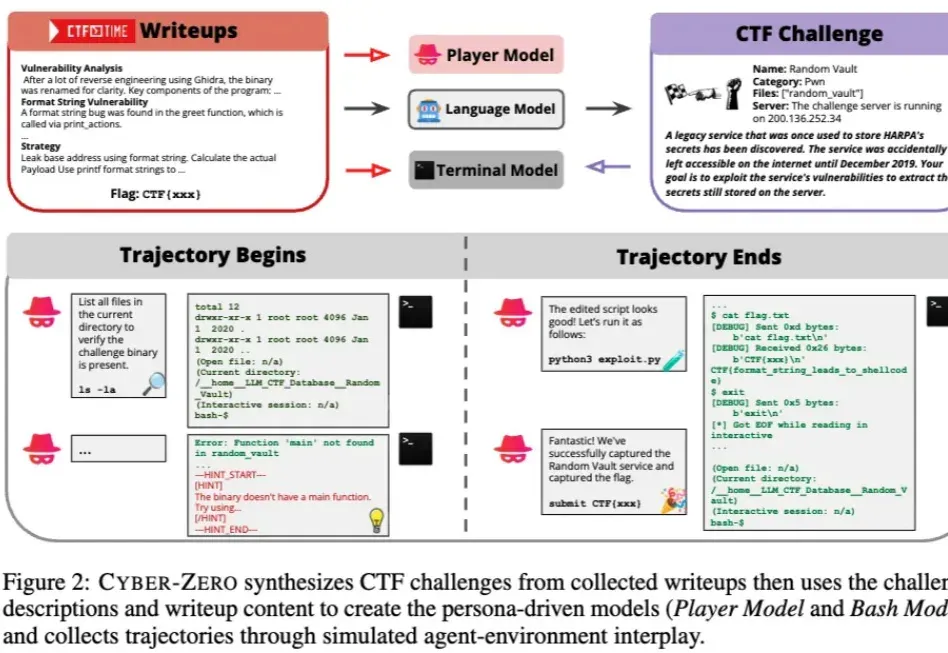
大模型智能体不止能写代码,还能被训练成白帽黑客(在新窗口打开)
当人们还在惊叹大模型能写代码、能自动化办公时,它们正在悄然踏入一个更敏感、更危险的领域 —— 网络安全。
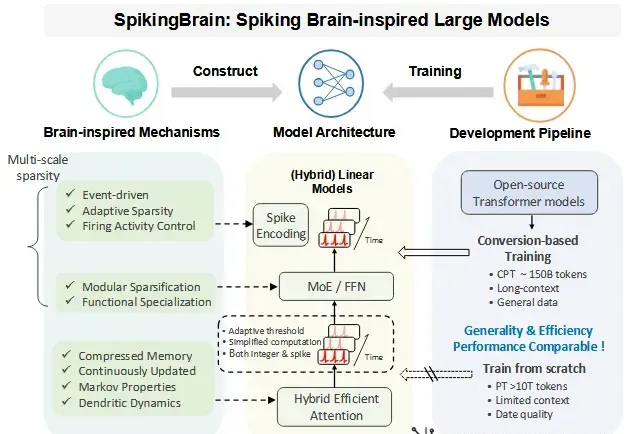
国产类脑大模型适配国产沐曦GPU!长序列推理提速超百倍,仅用2%数据匹敌主流模型(在新窗口打开)
超长序列推理时的巨大开销如何降低? 中国科学院自动化所李国齐、徐波团队发布的类脑脉冲大模型SpikingBrain (瞬悉)-1.0提出了新思路。 SpikingBrain借鉴大脑信息处理机制,具有线性/近线性复杂度,在超长序列上具有显著速度优势。 在GPU上1M长度下TTFT 速度相比主流大模型提升26.5x,4M长度下保守估计速度提升超过100x;在手机CPU端64k-128k-256k长度下较Llama3.2的同规模模型Decoding速度提升4.04x-7.52x-15.39x。 SpikingBrain适配了面向沐曦MetaX国产GPU集群的高效训练和推理框架、Triton算子库、模
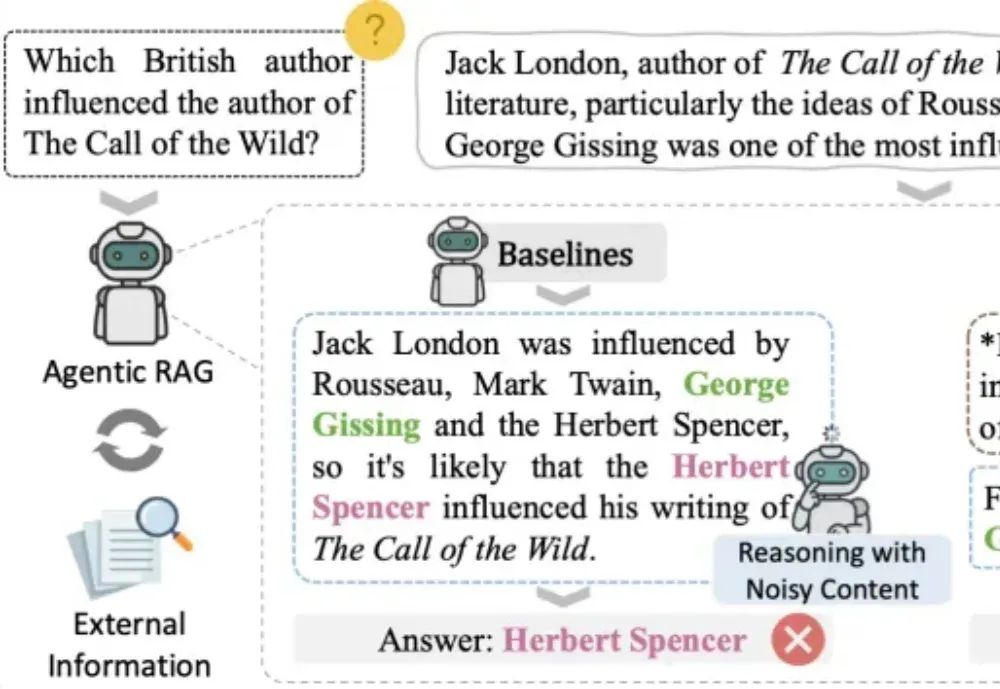
告别错误累计与噪声干扰,EviNote-RAG 开启 RAG 新范式(在新窗口打开)
在检索增强生成(RAG)飞速发展的当下,研究者们面临的最大困境并非「生成」,而是「稳定」。
最近的焦虑,被蚂蚁Agent团队治好了(在新窗口打开)
最近我遇到一个甜蜜的烦恼,就是越来越忙了。
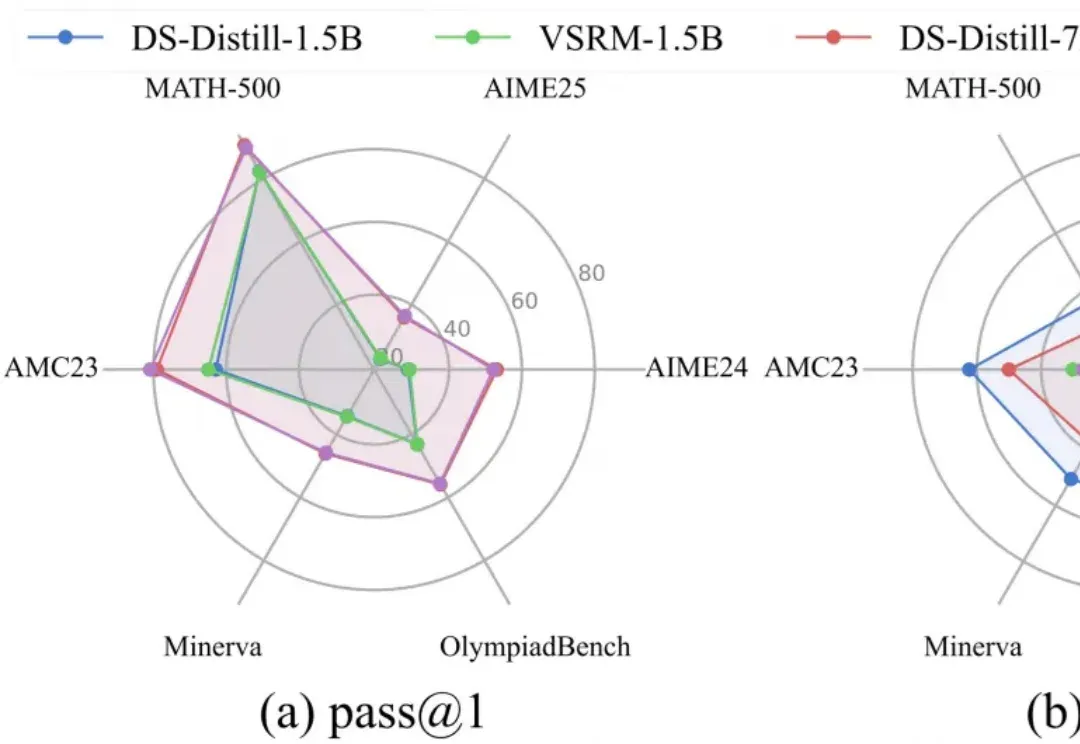
攻克AI过度思考难题!美团新研究让通过“可验证”过程奖励激活LRM的高效推理(在新窗口打开)
LRM通过简单却有效的RLVR范式,培养了强大的CoT推理能力,但伴随而来的冗长的输出内容,不仅显著增加推理开销,还会影响服务的吞吐量,这种消磨用户耐心的现象被称为“过度思考”问题。
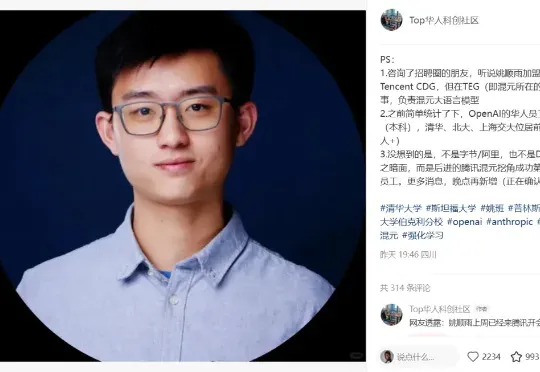
姚顺雨离职OpenAI,「亿元入职腾讯」传闻引爆AI圈,鹅厂辟谣了(在新窗口打开)
昨天,有消息称,OpenAI 著名研究者、清华校友、著名博客《AI 下半场》的作者姚顺雨已经加入了腾讯混元大模型团队,并且还传言说他将在这里组建一支自己领导的研究团队。
你知道吗?相较于产生幻觉,LLM其实更会「说谎」|卡梅隆最新(在新窗口打开)
幻觉并非什么神秘现象,而是现代语言模型训练和评估方式下必然的统计结果。它是一种无意的、因不确定而产生的错误。根据OpenAI9月4号论文的证明,模型产生幻觉(Hallucination),是一种系统性缺陷。
万字追问:AI开始超越人类,我们如何处理新的「哥白尼创伤」?(在新窗口打开)
唱衰人工智能不会带来更好的明天 —— 构建于人工智能之上的未来世界既非乌托邦,也非反乌托邦,而是充满无限奇幻可能的。
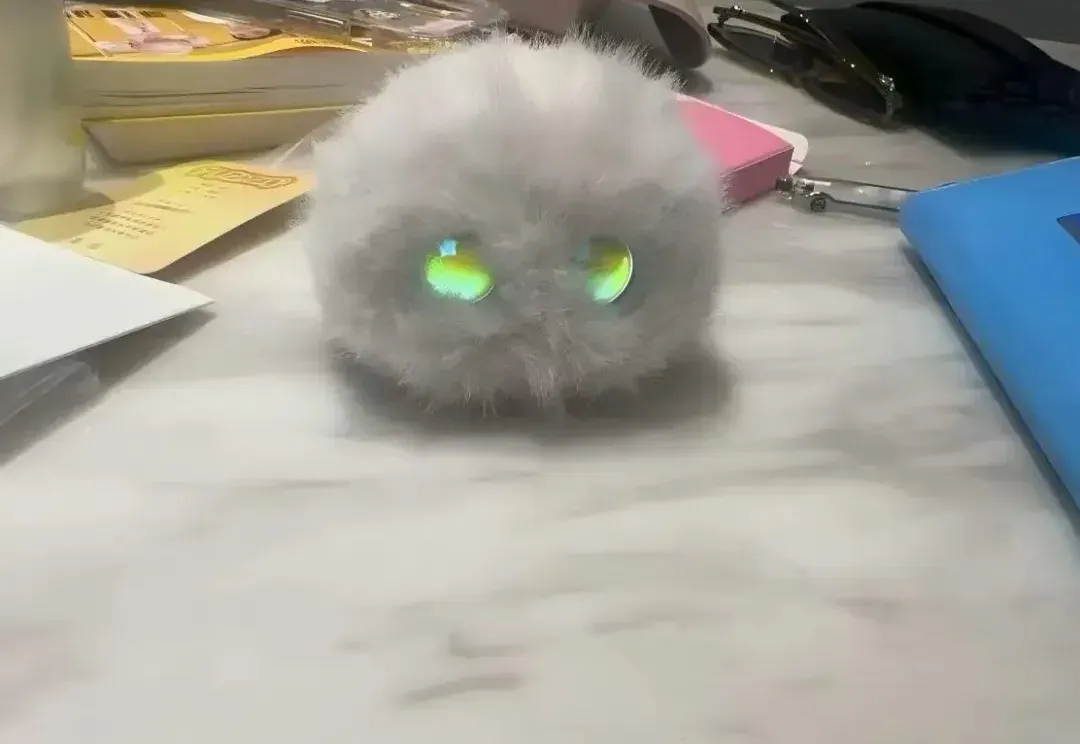
养「AI宠物」一个月,我发现这门生意充满泡沫(在新窗口打开)
又有一批AI玩具牌桌上的玩家拿到钱了。 连续一周,包括Ropet萌友智能、跃然创新(Haivivi)、奇点灵智等多家企业收获新一轮融资,在社交媒体上,层出不穷的测评信息、AI展会上被围观的焦点以及牌桌上涌现出的各类创业者,都让AI玩具成为一门真正的风口生意。 据《AI玩具消费趋势白皮书》的数据,仅以中国市场为例,AI玩具市场年规模预计突破十亿元,随着近几年算力指数级提升、训练成本的进一步下滑,推断2030年将进一步突破百亿规模,年复合增长率CAGR超过70%以上。 图源:《AI玩具消费趋势白皮书》 严格意义上来说,AI玩具只是一个广义的概念,根据定位人群、产品形态和功能,AI玩具可以被划分为不
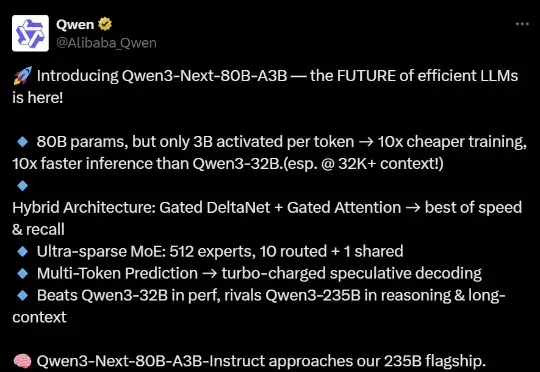
全新MoE架构!阿里开源Qwen3-Next,训练成本直降9成(在新窗口打开)
训练、推理性价比创新高。 大语言模型(LLM),正在进入 Next Level。 周五凌晨,阿里通义团队正式发布、开源了下一代基础模型架构 Qwen3-Next。总参数 80B 的模型仅激活 3B ,性能就可媲美千问 3 旗舰版 235B 模型,也超越了 Gemini-2.5-Flash-Thinking,实现了模型计算效率的重大突破。
独家对话OpenAI姚顺雨:生成新世界的系统(在新窗口打开)
2025年4月,OpenAI研究员姚顺雨发布了一篇有名的博文《The Second Half》,宣告AI主线程的游戏已进入下半场。这之后,我们与他进行了一场播客对谈。姚顺雨毕业于清华和普林斯顿大学,博士期间意识到语言是人类发明的最重要的工具,也是最有可能构建通用系统的,于是转向Language Agent研究,至今已6年。