Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
刚刚!阿里发新模型,幻觉率爆降70%(在新窗口打开)
智东西9月15日报道,今天,阿里巴巴通义实验室推出了FunAudio-ASR端到端语音识别大模型。这款模型通过创新的Context模块,针对性优化了“幻觉”、“串语种”等关键问题,在高噪声的场景下,幻觉率从78.5%下降至10.7%,下降幅度接近70%。
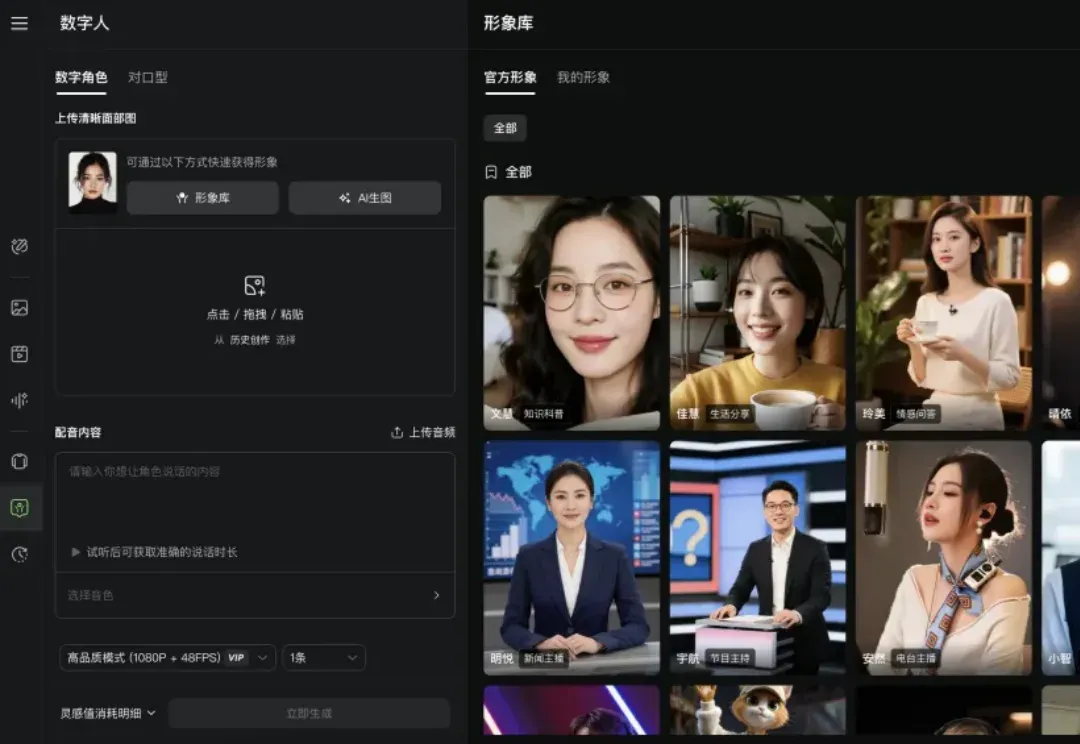
从「对口型」到「会表演」,刚进化的可灵AI数字人,技术公开了(在新窗口打开)
让数字人的口型随着声音一开一合早已不是新鲜事。更令人期待的,是当明快的旋律响起,它会自然扬起嘴角,眼神含笑;当进入说唱段落,它会随着鼓点起伏,肩膀与手臂有节奏地带动气氛。
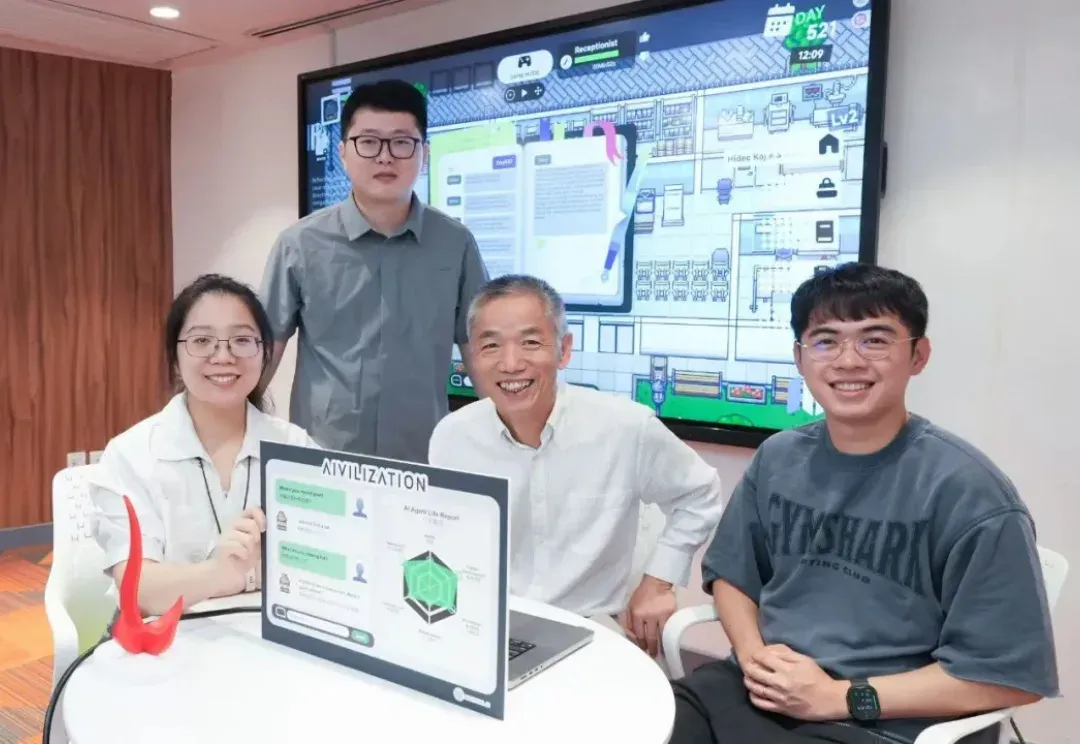
专访 Aivilization 创始人:数十万人赛博捏崽的背后故事(在新窗口打开)
如果要评选出 2025 年暑期乃至 25 全年最受欢迎的 Agent 项目,Aivilization 毫无疑问会获奖。
15年大佬深夜痛哭半小时!氛围编程巨坑曝光,95%程序员沦为「AI保姆」(在新窗口打开)
氛围编程,正批量制造「AI保姆」。一位15年资深开发者,为赶工用AI编程,结果bug成山不得不推翻重来,痛哭半小时。如今,一种全新职业「氛围编程清理专家」冲上了热榜。
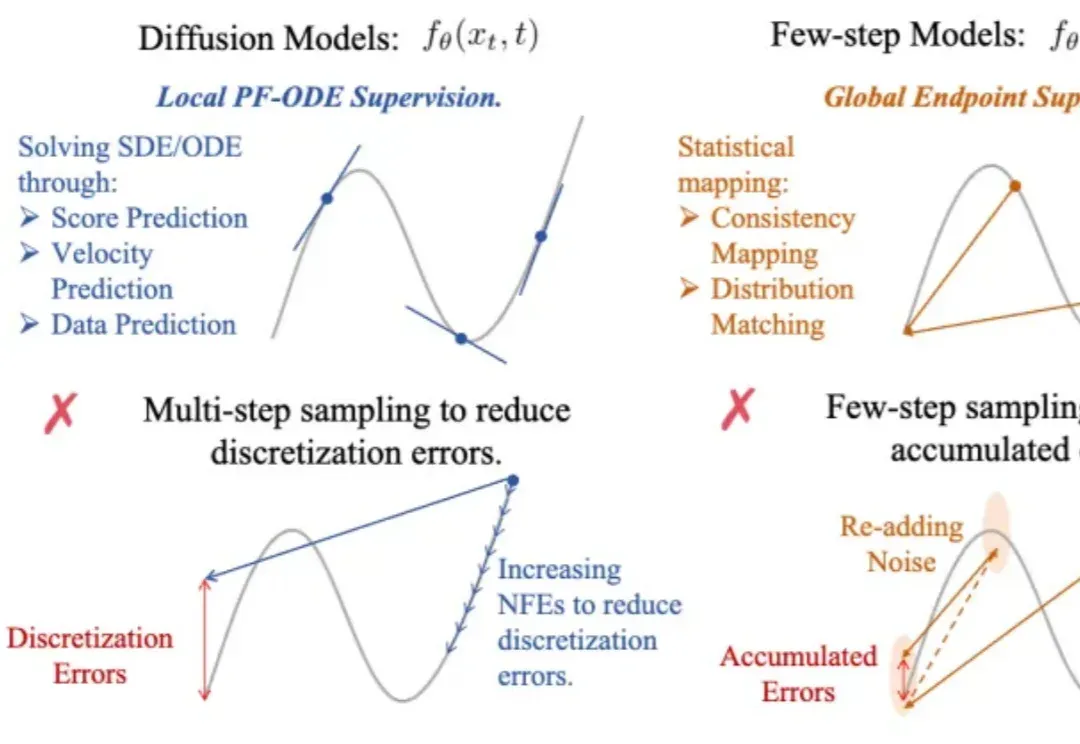
兼得快与好!训练新范式TiM,原生支持FSDP+Flash Attention(在新窗口打开)
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两
GenAI时代广告应该是怎么样的?2500万美元退出后再创业,这位连续创业者如何用AI广告再造独角兽?(在新窗口打开)
你有没有想过,为什么我们每天与 ChatGPT 或其他 AI 助手聊天时,从来没有看到过广告?这并不是因为这些公司不想赚钱,而是因为没有人真正搞清楚如何在 AI 对话中优雅地植入广告。
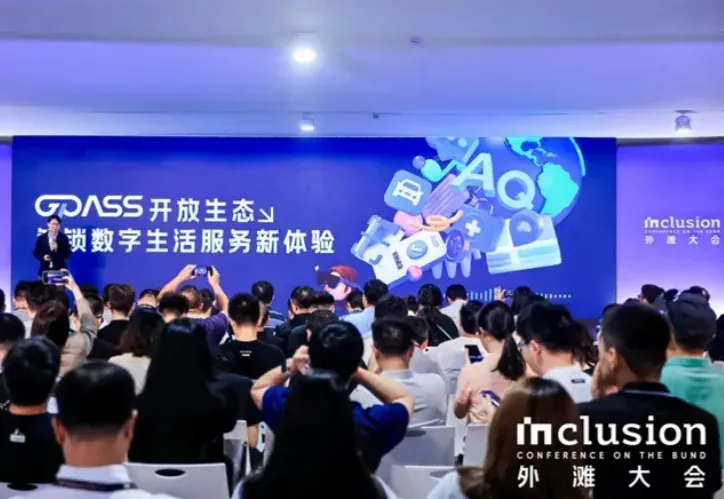
数字生活的原生入口:蚂蚁集团发布AI眼镜全新技术框架gPass(在新窗口打开)
日前,在 2025 Inclusion・外滩大会上,蚂蚁集团发布了全球首个智能眼镜可信连接技术框架 ——gPass。该技术具备「安全、交互、连接」三大核心能力,致力于实现 AI 眼镜与智能体之间安全、可信、即时信息交互,为用户打造自然无感的服务体验,同时构建起面向眼镜厂商和开发者的安全 AI 数字服务生态。
想让LLM精确输出?试下XML格式Prompt语法约束解码GCD,帮你迭代收敛到稳定解(在新窗口打开)
随着Agent的爆发,大型语言模型(LLM)的应用不再局限于生成日常对话,而是越来越多地被要求输出像JSON或XML这样的结构化数据。这种结构化输出对于确保安全性、与其他软件系统互操作以及执行下游自动化任务至关重要。
DeepMind哈萨比斯最新认知都在这里了(在新窗口打开)
Nano Banana如此火爆,让谷歌DeepMind CEO哈萨比斯在最新访谈中又一次聊起了AGI。Nano Banana当然不是AGI,但它也体现了哈萨比斯认为AGI系统所需的一些关键能力和特征。
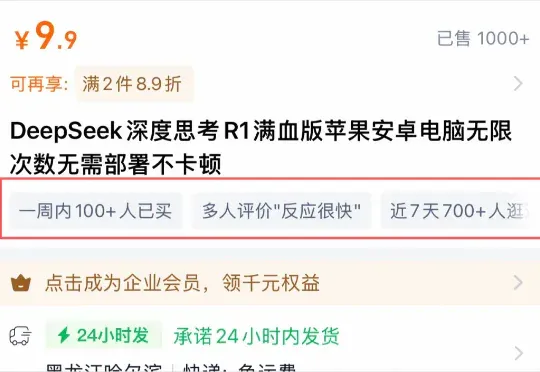
淘宝上卖9块9的DeepSeek,让我看到了被折叠的魔幻世界。(在新窗口打开)
这个世界,终于魔幻到我看不懂的程度了。故事是这样的。我最近刷淘宝挺多,然后昨天,鬼使神差的,在淘宝上,搜了一下DeepSeek。没有特定的理由,就是心血来潮,就是单纯的,想看看现在的生态。
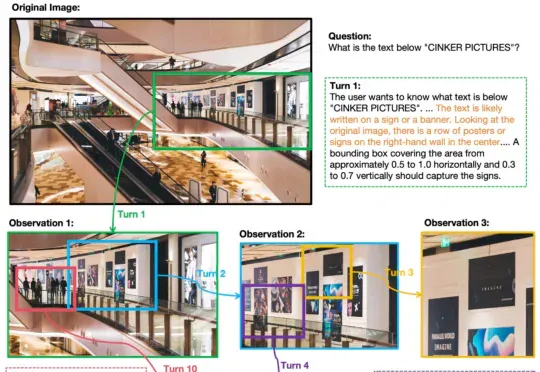
全新开源模型复现o3视觉推理,无需大量训练即可实现深度思考(在新窗口打开)
OpenAI o3的多轮视觉推理,有开源平替版了。并且,与先前局限于1-2轮对话的视觉语言模型(VLM)不同,它在训练限制轮数只有6轮的情况下,测试阶段能将思考轮数扩展到数十轮。
多模态BUG修复新SOTA:慕尼黑工大GUIRepair登上SWE-bench Multimodal榜单第一(在新窗口打开)
自动化修复真实世界的软件缺陷问题是自动化程序修复研究社区的长期目标。然而,如何自动化解决视觉软件缺陷仍然是一个尚未充分探索的领域。最近,随着 SWE-bench 团队发布最新的多模态 Issue 修复
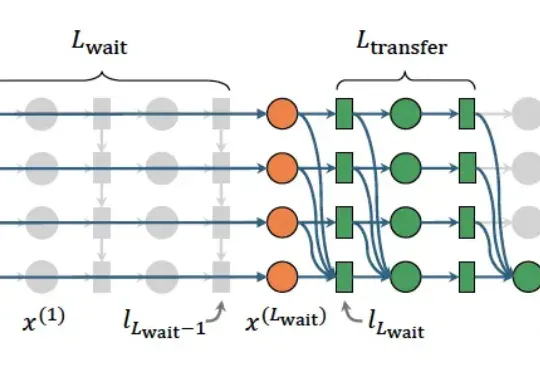
AI解数学题只靠最后一个token(在新窗口打开)
最近,来自加州大学圣克鲁兹分校、乔治·梅森大学和Datadog的研究人员发现:在心算任务中,几乎所有实际的数学计算都集中在序列的最后一个token上完成,而不是分散在所有token中。
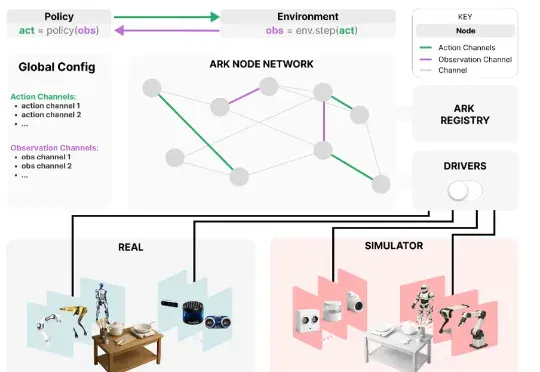
告别ROS的繁琐, 易用易学的机器人学习系统: 华为诺亚面向机器人学习的开源Python框架(在新窗口打开)
为应对这些挑战,来自华为诺亚方舟实验室,德国达姆施塔特工业大学,英国伦敦大学学院,帝国理工学院和牛津大学的研究者们联合推出了 Ark —— 一个基于 Python 的机器人开发框架,支持快速原型构建,并可便捷地在仿真和真实机器人系统上部署新算法。
谷歌的香蕉和字节的梦,相逢在 Lovart 的无限画布上(在新窗口打开)
谷歌这只「香蕉」火得有些疯狂:Nano Banana(即 Gemini 2.5 Flash Image)自 8 月底上线以来,仅用几周就吸引了超过 1,000 万新用户,并在 Gemini 应用中完成了 2 亿次图像编辑请求
OpenVision 2:大道至简的生成式预训练视觉编码器(在新窗口打开)
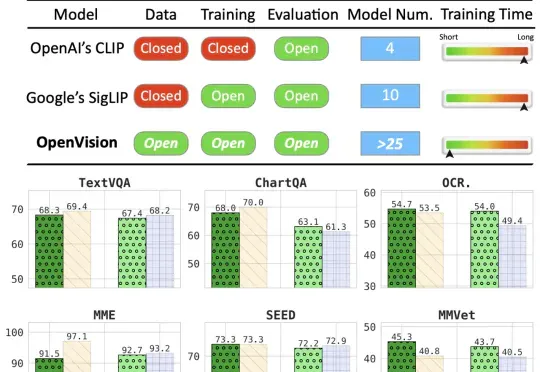
本文来自加州大学圣克鲁兹分校(UCSC)、苹果公司(Apple)与加州大学伯克利分校(UCB)的合作研究。第一作者刘彦青,本科毕业于浙江大学,现为UCSC博士生,研究方向包括多模态理解、视觉-语言预训

GPT-5编程专用版发布!独立连续编程7小时,简单任务提速10倍,VS Code就能用(在新窗口打开)
OpenAI Codex编程智能体大升级: 推出GPT-5-Codex特化版模型,支持独立连续编程7个小时。还有IDE插件版,在VS Code、Cursor中都可以使用Codex了。新模型最牛的地方在于“真·动态思考”能力。

马斯克的最快AI模型来了(在新窗口打开)
最强不敢说,但最快实锤了! 刚刚,xAI发布Grok 4 Fast,生成速度高达每秒75个 token,比标准版快10倍! 从下面的动图中,我们可以直观地看出差距——当左边的Grok 4还在说“让我想一下的时候”,Grok 4 Fast已经在说:“下一个问题是什么了。”
刚刚,Anthropic 公布了99%的人不知道的 Claude使用真相(在新窗口打开)
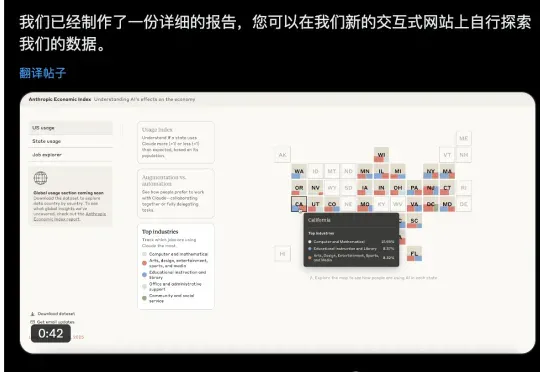
就在刚刚,Anthropic 发布了一报告,名字听上去有点学术腔——《人类经济指数》。 但别被这个名字骗了,它是一份非常具体、非常当下的观察笔记,可以说和我们息息相关。 原文链接:https://ww
为什么说现在所有的 AI Agent,都像 3D 打印机?|AI 上新(在新窗口打开)
GPT-5 的发布,可以看作是一个分水岭。练习时长两年半的 GPT-5,并没有展现出和 GPT-4 本质上的差别,甚至因为模型的预设人格引发了用户的反感情绪。