Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
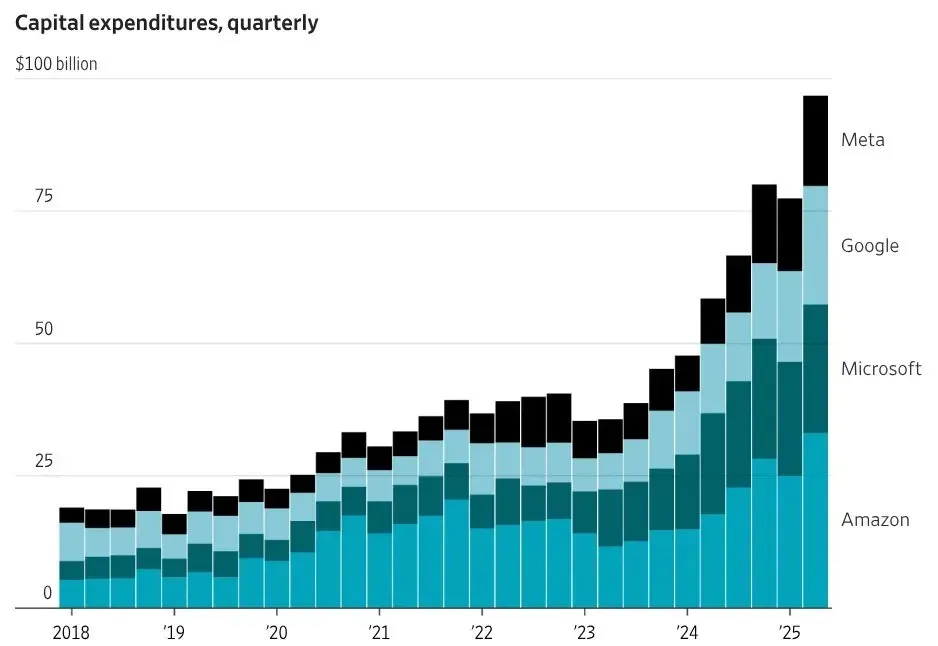
百年不遇!3.7万亿AI基建砸下,美国人也坐不住了(在新窗口打开)
美国七巨头AI基建支出掀狂潮:经济提振了,大批人失业了。
国内首个大模型“体检”结果发布,这样问AI很危险!(在新窗口打开)
近日,国内首次针对AI大模型的实网众测结果正式公布,一场大型“安全体检”透露出不容忽视的信号:本次活动累计发现安全漏洞281个,其中大模型特有漏洞高达177个,占比超过六成,这组数据表明,AI正面临着超出传统安全范畴的新型威胁。
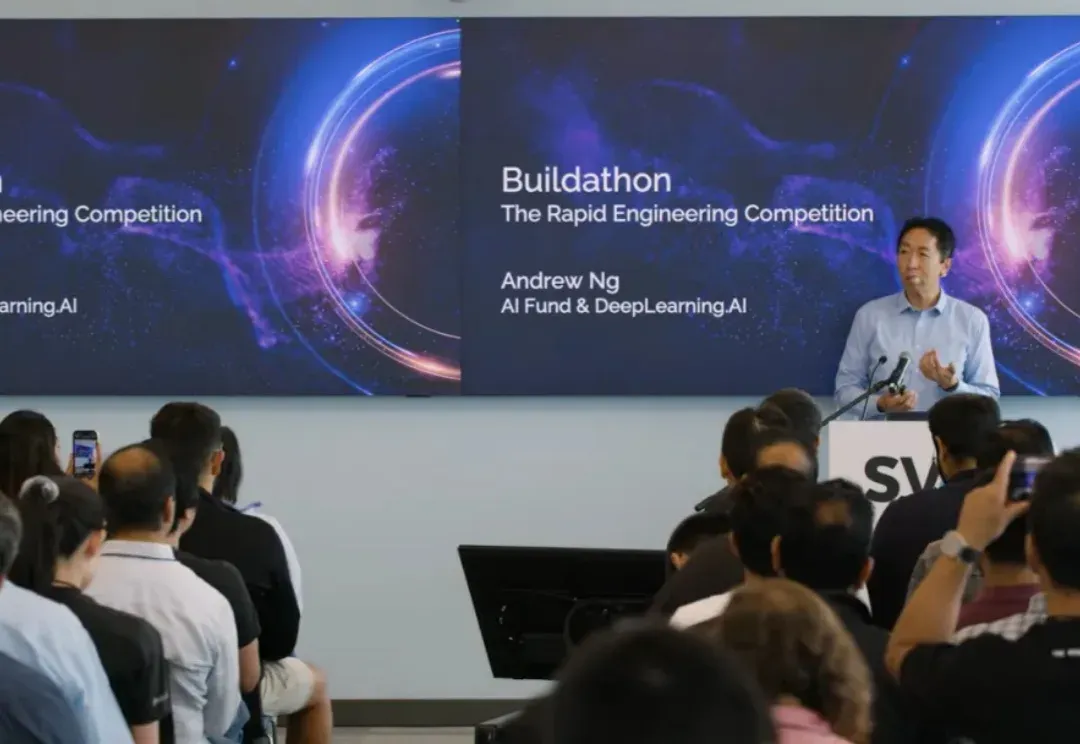
AI编程时代的生存原则是什么?吴恩达:快速行动,承担责任(在新窗口打开)
近日,吴恩达(Andrew Ng)在首届Buildathon上发表主题演讲,内容围绕AI辅助编程、快速开发产品原型,以及AI工程师技能需求展开。
海外教育科技过亿元融资观察:六起大单勾勒的投资风向(在新窗口打开)
今年春天,医学教育平台 AMBOSS 宣布完成 2.6 亿美元融资;不久后,AI 编程公司 Windsurf 的估值也跃升至 28.5 亿美元。与此同时,在东南亚、欧洲和印度市场,Manabie、Knowunity、Eruditus、Lingokids 等公司也相继拿下千万至上亿美元的新一轮资金。
首创双NPU架构一鸣惊人!联发科天玑9500重磅加码主动式AI体验(在新窗口打开)
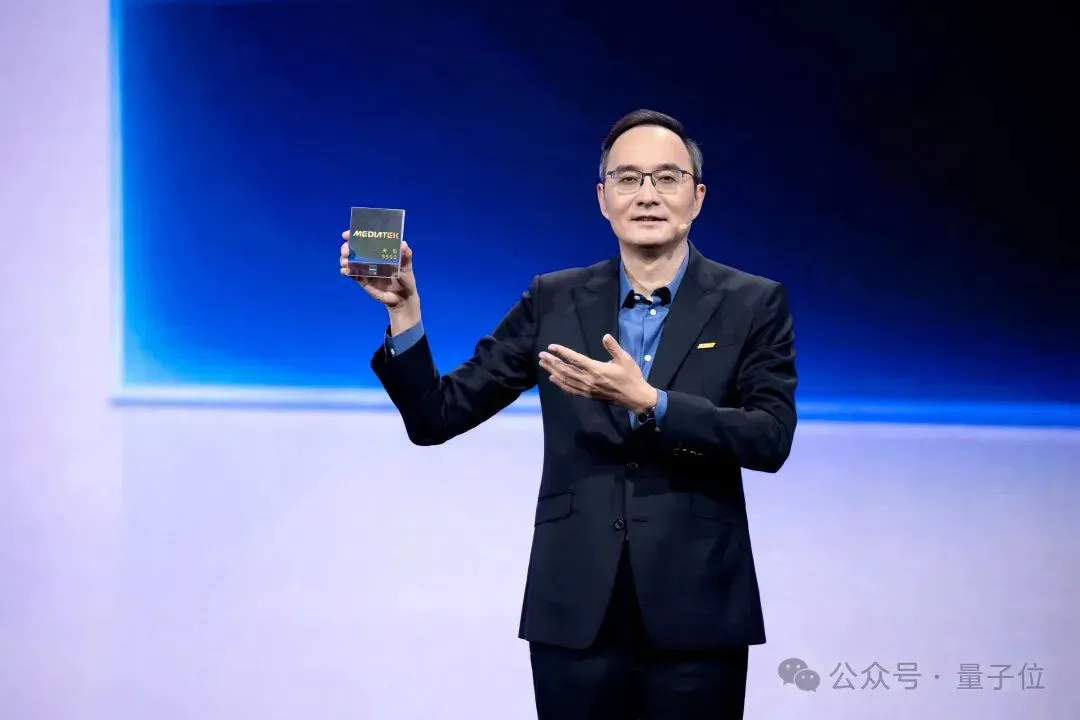
天玑9500围绕这一目标重构芯片底座:首发双NPU架构,结合存算一体、硬件压缩等多项关键技术,在ETHZ苏黎世移动SoC AI榜单中蝉联榜首,相比上一代跑分翻倍。
LeCun力荐的JEPA杀入LLM,用CV的思路训练LLM,性能鲁棒性双丰收(在新窗口打开)
LeCun 这次不是批评 LLM,而是亲自改造。当前 LLM 的训练(包括预训练、微调和评估)主要依赖于在「输入空间」进行重构与生成,例如预测下一个词。 而在 CV 领域,基于「嵌入空间」的训练目标,如联合嵌入预测架构(JEPA),已被证明远优于在输入空间操作的同类方法。
马斯克xAI百天血战,100天狂招100人!联创实权被削,豪言干掉微软(在新窗口打开)
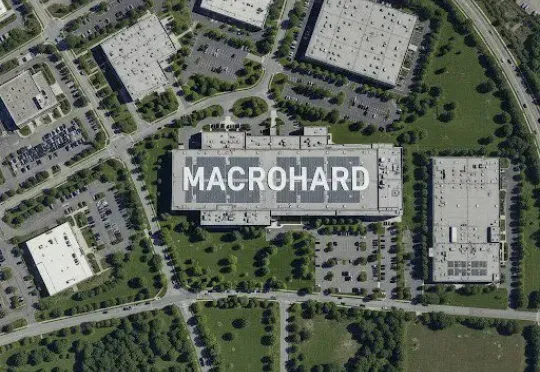
一夏天,马斯克一头扎进xAI,誓要追赶OpenAI。结果呢?内部重组大戏上演,夺走实权高管跳槽。内部会议上,马斯克豪言打造「巨硬」剑指微软,还预告了儿童版「Baby Grok」。
腾讯用AI把美术管线重新做了一遍,混元3D Studio架构曝光(在新窗口打开)
不用在建模、UV、贴图软件之间反复横跳,一个工作台就能得到:这是腾讯专为3D设计师、游戏开发者、建模师等打造的专业级AI工作台混元3D Studio。
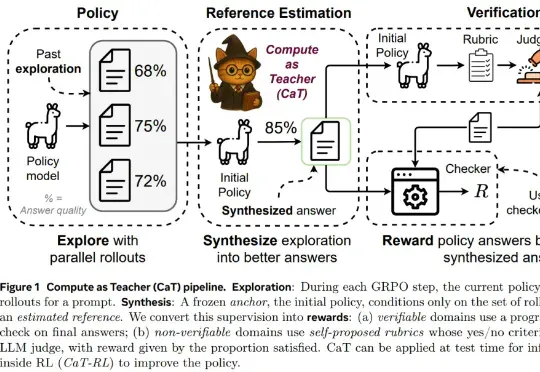
突破后训练瓶颈?Meta超级智能实验室又一力作:CaT解决RL监督难题(在新窗口打开)
为了回答这一问题,来自牛津大学、Meta 超级智能实验室等机构的研究者提出设想:推理计算是否可以替代缺失的监督?本文认为答案是肯定的,他们提出了一种名为 CaT(Compute as Teacher)的方法,核心思想是把推理时的额外计算当作教师信号,在缺乏人工标注或可验证答案时,也能为大模型提供监督信号。
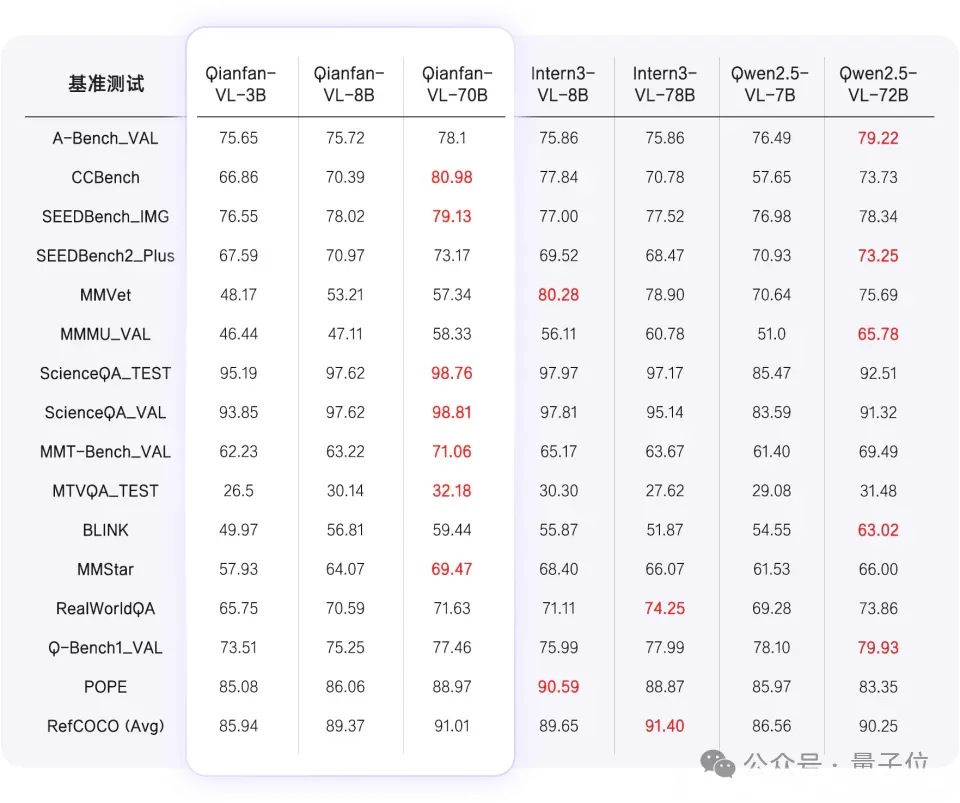
百度开源视觉理解模型Qianfan-VL!全尺寸领域增强+全自研芯片计算(在新窗口打开)
今天,百度智能云千帆正式推出全新视觉理解模型——Qianfan-VL,并全面开源!该系列包含3B、8B和70B三个尺寸版本,是面向企业级多模态应用场景,进行了深度优化的视觉理解大模型。
Prompt的尽头,居然是MBTI。(在新窗口打开)
论文的标题很学术,叫《心理学增强AI智能体》但是大白话翻译一下就是,想要让大模型更好地完成任务,你们可能不需要那些动辄几百上千字的复杂Prompt,不需要什么思维链、思维图谱,甚至不需要那些精巧的指令。
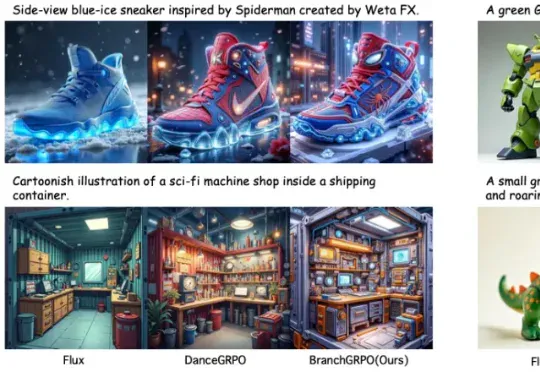
加速近5倍!北大与字节团队提出BranchGRPO,用「树形分叉 + 剪枝」重塑扩散模型对齐(在新窗口打开)
近期,北京大学与字节团队提出了名为 BranchGRPO 的新型树形强化学习方法。不同于顺序展开的 DanceGRPO,BranchGRPO 通过在扩散反演过程中引入分叉(branching)与剪枝(pruning),让多个轨迹共享前缀、在中间步骤分裂,并通过逐层奖励融合实现稠密反馈。
全是套路!英伟达千亿美元投OpenAI,奥特曼拿钱买卡还让甲骨文赚差价(在新窗口打开)
最新消息,英伟达计划向OpenAI投资最高1000亿美元,OpenAI则要用这笔钱构建至少10GW的AI数据中心,全用英伟达的系统。10GW,相当于400-500万个GPU了,并且,黄仁勋8月份曾表示,建成1GW的数据中心的成本大约在500-600亿美元。
刚刚,DeepSeek-V3.1「终极版」重磅发布!最大提升超36%,V4/R2还远吗?(在新窗口打开)
DeepSeek最新模型DeepSeek-V3.1-Terminus来了!此前在输出中随机掺入「极」字的问题得到显著缓解,Humanity's Last Exam成绩也较V3.1提升1/3!Terminus这个名字是否在暗示DeepSeek-V4也快要来了?
美团王兴,又开源一款大模型!(在新窗口打开)
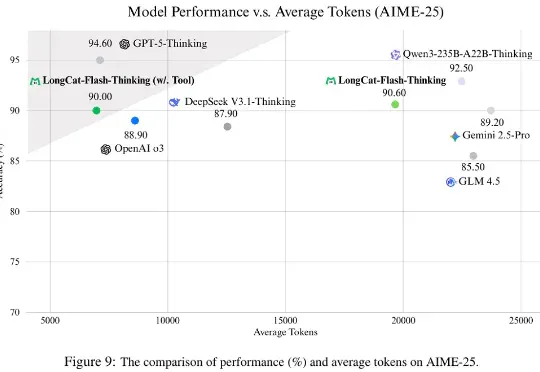
最近,美团在AI开源赛道上在猛踩加速。今天,在开源其首款大语言模型仅仅24天后,美团又开源了其首款自研推理模型LongCat-Flash-Thinking。与其基础模型LongCat-Flash类似,效率也是LongCat-Flash-Thinking的最大特点。美团在技术报告中透露,LongCat-Flash-Thinking在自研的DORA强化学习基础设施完成训练
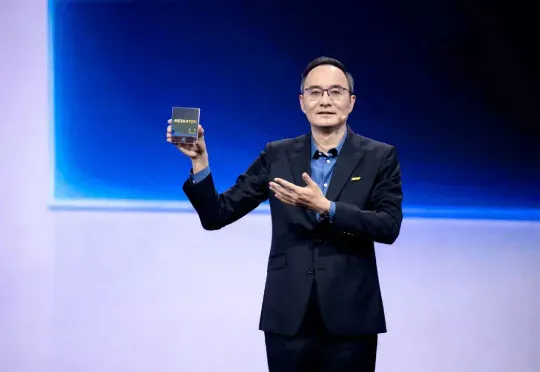
这一次,天玑9500的端侧AI能力,友商赶不上了(在新窗口打开)
9 月 22 日下午,联发科推出的新一代旗舰 5G 智能体 AI 芯片 —— 天玑 9500,并展示了一系列新形态端侧的 AI 应用,在公众层面首次推动端侧 AI 从尝鲜到好用。现在,让手机端大语言模型(LLM)处理一段超长的文本,最长支持 128K 字元,它只需要两秒就能总结出会议纪要,AI 还能自动修改你的错别字。
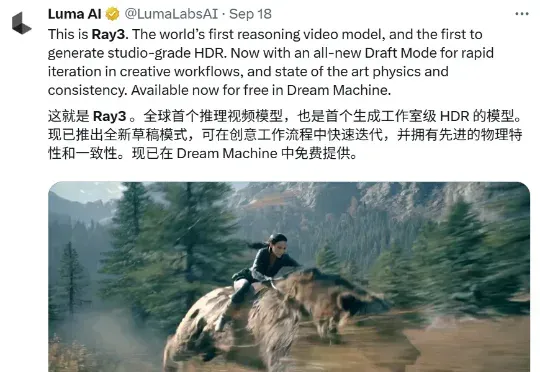
我的天,全球首个「推理视频模型」Ray3发布!(在新窗口打开)
AI视频又进化了! Luma AI 发布全球首个推理视频模型,也是首个能够生成工作室级 HDR 的模型。 Ray3 是一款专为讲述故事而设计的 AI 视频模型。 它能够对视觉内容进行思考和推理,并提
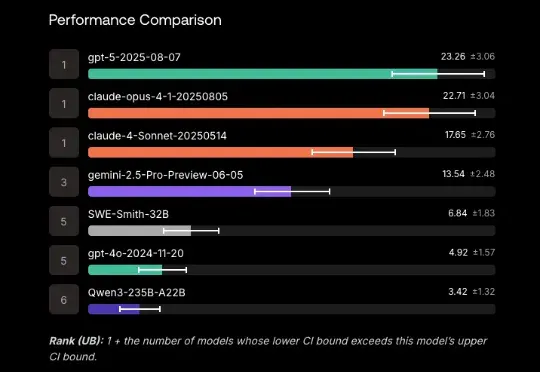
GPT-5编程测评大反转!表面不及格,实际63.1%的任务没交卷,全算上成绩比Claude高一倍(在新窗口打开)
Scale AI的新软件工程基准SWE-BENCH PRO,出现反转!表面上看,“御三家”集体翻车,没一家的解决率超过25%: GPT-5、Claude Opus 4.1、Gemini 2.5分别以23.3%、22.7%、13.5%的解决率“荣”登前三。
27亿美元天价回归!谷歌最贵「叛徒」、Transformer作者揭秘AGI下一步(在新窗口打开)
在AI热潮中,大模型最「渴求」的究竟是什么?是算力、是存储,还是复杂的网络互联?在Hot Chips 2025 上,Transformer发明者之一、谷歌Gemini联合负责人Noam Shazeer给出了答案。
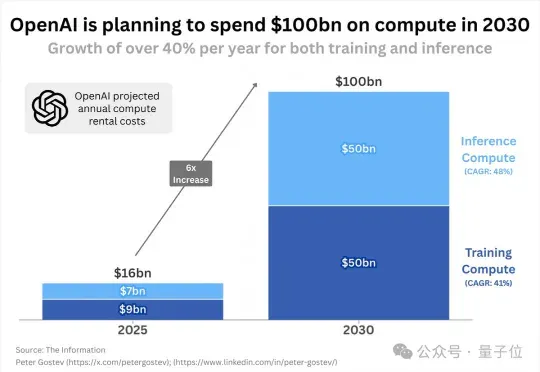
奥特曼预告ChatGPT新产品!Pro会员也要额外收费,这次不计成本投入算力(在新窗口打开)
OpenAI已经花了160亿美元(约人民币1138亿)租用计算资源。相当于每天一睁眼,就有几千万花出去租服务器。但这还不是最夸张的。据The Information消息,OpenAI计划在未来五年额外支出约1000亿美元,用于从云服务提供商处租用备用服务器 。