Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
Mamba-3惊现AI顶会ICLR 2026!CMU知名华人教授一作首代工作AI圈爆红(在新窗口打开)
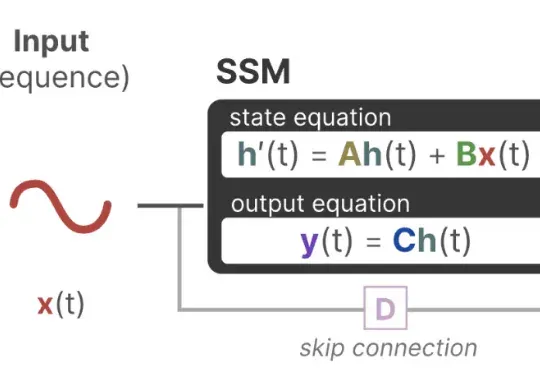
曼巴回来了!Transformer框架最有力挑战者之一Mamba的最新进化版本Mamba-3来了,已进入ICLR 2026盲审环节,超长文本处理和低延时是其相对Transformer的显著优势。另一个挑战者是FBAM,从不同的角度探索Transformer的下一代框架。
OpenAI 的颠覆革命|狂热的2024·沸腾的2025丨Xsignal(在新窗口打开)
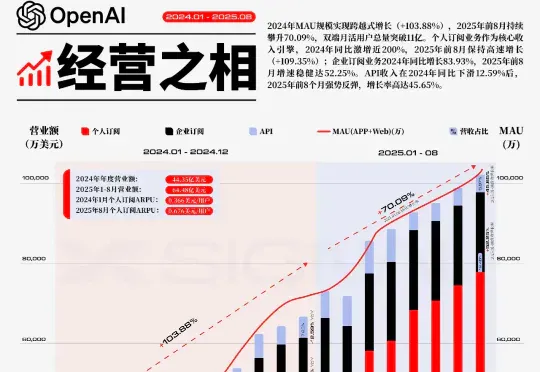
2022年11月,OpenAI的ChatGPT问世,这一事件不仅是技术创新的里程碑,更被视为重塑全球AI战略版图的关键转折点,它标志着新一轮大国AI竞赛的序幕被正式拉开。在此背景下,其增长的规模与速度本身,就是一种颠覆性的战略壁垒。
“AI版LeCun”自己讲解论文,自我进化智能体框架生成精美演讲视频(在新窗口打开)
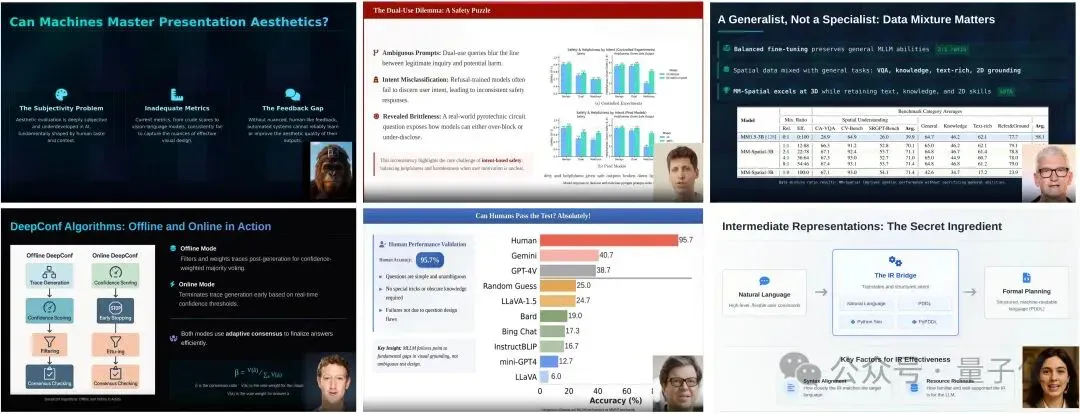
AI自己讲明白论文,还能生成更美观的幻灯片。加州大学圣塔芭芭拉(UCSB)与圣克鲁兹(UCSC)的研究者提出EvoPresent,一个能够自我进化的学术演讲智能体框架,让AI不仅能“讲清楚论文”,还能“讲得好看”。
独家|Qwen、豆包内测记忆功能,全面对标ChatGPT,国产AI迈入新阶段。(在新窗口打开)
近期,我们独家观察到,国内两家科技巨头——阿里巴巴和字节跳动——旗下的AI助手通义千问(Qwen)和豆包(Doubao),同时开始内测“记忆功能”。此举被广泛视为对标行业领头羊OpenAI的ChatGPT,标志着国产AI助手正从“即时问答工具”向“长期私人助理”的角色加速演进。
今天,好像见证了属于SD时代的消亡。(在新窗口打开)
他们决定,把liblib升级到2.0,有新的品牌,有新的logo,有新的界面,有新的功能。liblib,国内最著名的模型开源社区,也是国内之前最大SD生态开源社区没有之一。但是这些东西都不重要。
第二代InfLLM开源,同尺寸快三倍!零参数,可训练稀疏注意力(在新窗口打开)
InfLLM-V2是一种可高效处理长文本的稀疏注意力模型,仅需少量长文本数据即可训练,且性能接近传统稠密模型。通过动态切换短长文本处理模式,显著提升长上下文任务的效率与质量。从短到长低成本「无缝切换」,预填充与解码双阶段加速,释放长上下文的真正生产力。
马斯克从英伟达挖人做AI游戏!第一步:研发世界模型(在新窗口打开)
马斯克的xAI也入局世界模型了!据《金融时报》(FT)报道,为了增加这场“世界模型大混战”的赢面,今年夏天,xAI已经从英伟达挖来了多名资深研究员来助阵。另一边,在悄然下场世界模型后,马斯克几天前又在𝕏上再次重申了去年定下的那个“小目标”——
吴恩达Agentic AI新课:手把手教你搭建Agent工作流,GPT-3.5反杀GPT-4就顺手的事(在新窗口打开)
吴恩达又出新课了,这次的主题是—Agentic AI。 在新课中,吴恩达将Agentic工作流的开发沉淀为四大核心设计模式:反思、工具、规划与协作,并首次强调评估与误差分析才是智能体开发的决定性能力:
OpenAI预告了AI时代「Windows系统」的诞生|窄播Weekly(在新窗口打开)
这是《窄播Weekly》的第68期,本期我们关注的商业动态是:OpenAI在今年的DevDay上更清晰地向我们展示了如何构建一个AI时代的超级系统。就像OpenAI的CEO山姆·奥特曼在一档播客节目中所说,ChatGPT上线之后经历了两个关键的「惊喜」时刻,
濒死3次,医生判他死刑!宾大教授奇迹自救,誓用AI攻克14000种绝症(在新窗口打开)
David Fajgenbaum,这位多次被命运击倒却又以勇气与智慧改写人生的医生,用科学、信念与不屈,将自己的奇迹求生化为拯救他人的毕生使命。他创立的Every Cure,借助AI在7500万种药物与疾病的可能组合中挖掘生命曙光,让无数罕见病与绝症患者重燃希望。
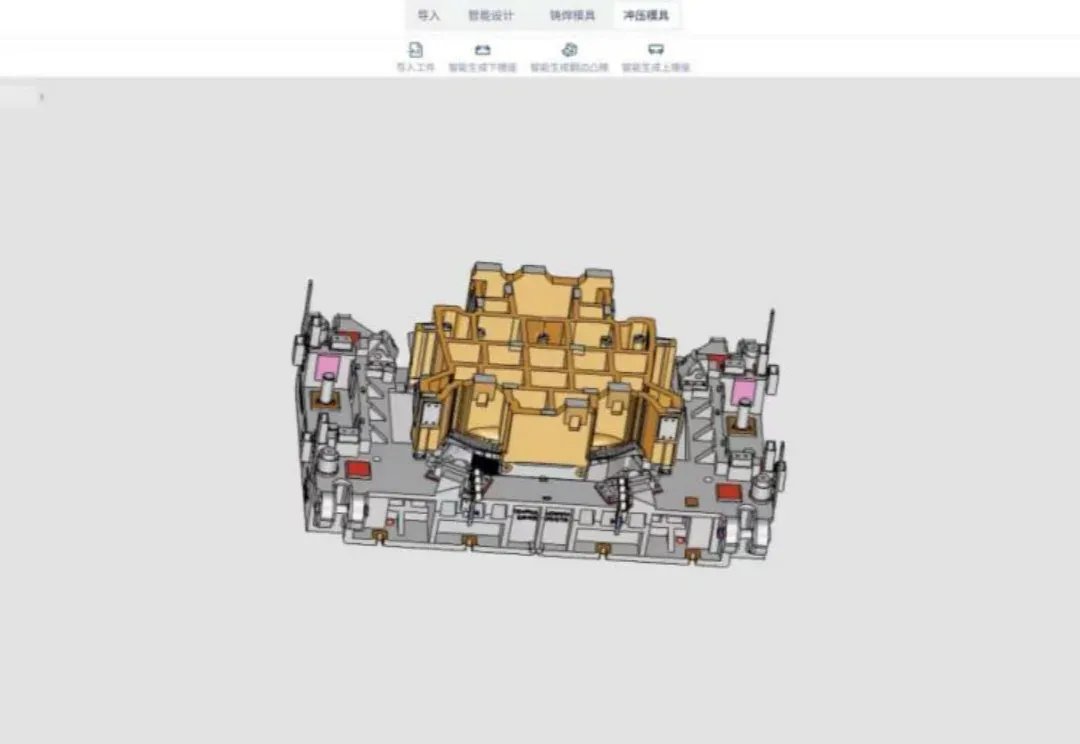
一年时间完成三轮融资,工业AI智能体公司「设序科技」获数千万元Pre B轮融资(在新窗口打开)
工业AI生成式设计软件与方案供应商「设序科技」近日完成数千万元Pre B轮融资,投资方为涌铧投资和广发信德,星涵资本担任长期财务顾问。过去一年,公司已连续完成三轮融资,累计金额超亿元。融资资金将用于研发投入和市场推广,包括海外市场推广。
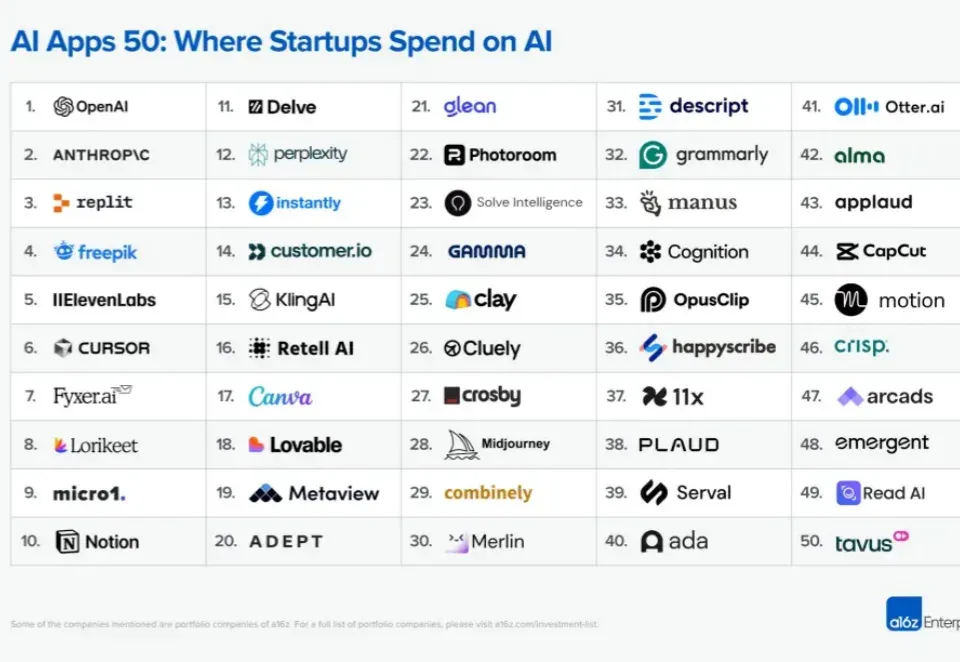
a16z最新报告:初创公司真金白银投AI,但钱花哪儿了?(在新窗口打开)
硅谷顶尖风投a16z近日发布AI应用支出报告,揭开了初创公司资金的真正去向。
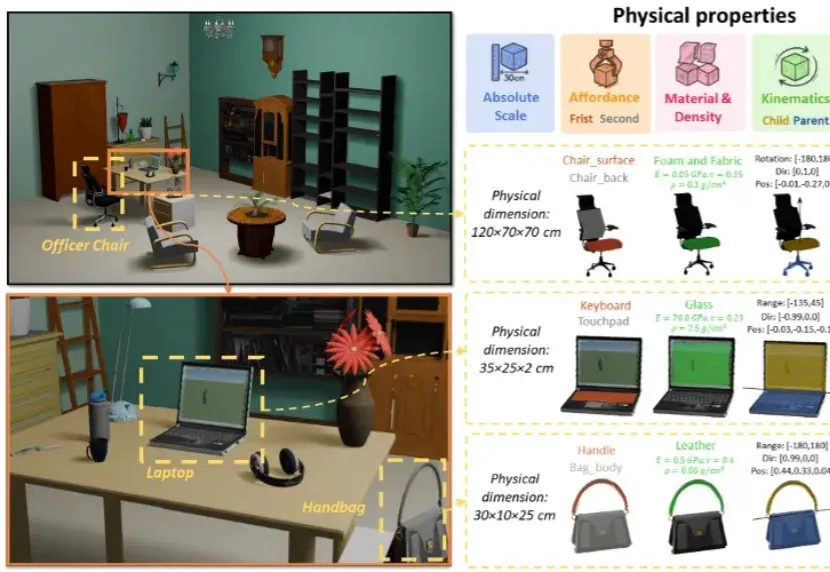
NeurIPS 2025 Spotlight | PhysX-3D:面向真实物理世界的3D资产生成范式(在新窗口打开)
3D 生成正从纯虚拟走向物理真实,现有的 3D 生成方法主要侧重于几何结构与纹理信息,而忽略了基于物理属性的建模。
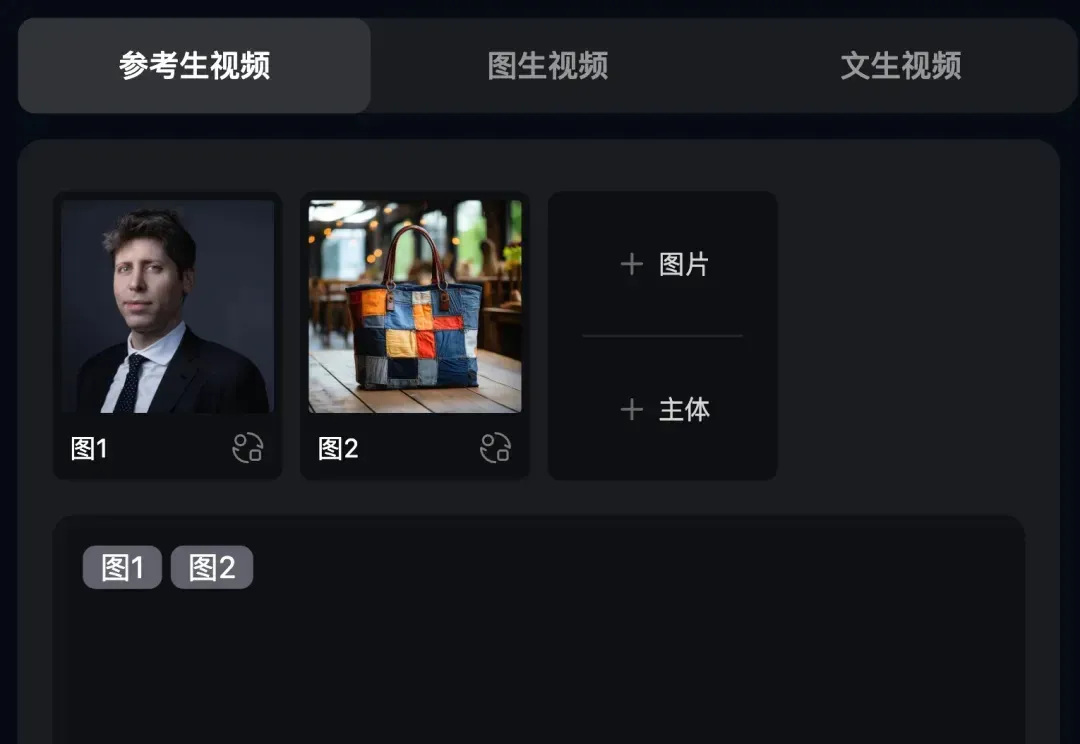
当Sora2遇上国产 Vidu Q2,国产参考生真的更香了!一手亲测(在新窗口打开)
国庆假期Sora 2的横空出世那叫一个吸睛,尤其是客串(Cameo)功能,直接把Sora拉到了“AI版抖音”的高度。
百万粉丝博主的AI内容工厂:2小时日产全平台爆款的秘密武器(在新窗口打开)
最近看到一个有趣的现象:很多人对AI生成的内容有一种本能的抗拒,觉得AI正在"污染"互联网,到处都是没有灵魂的机器文字。
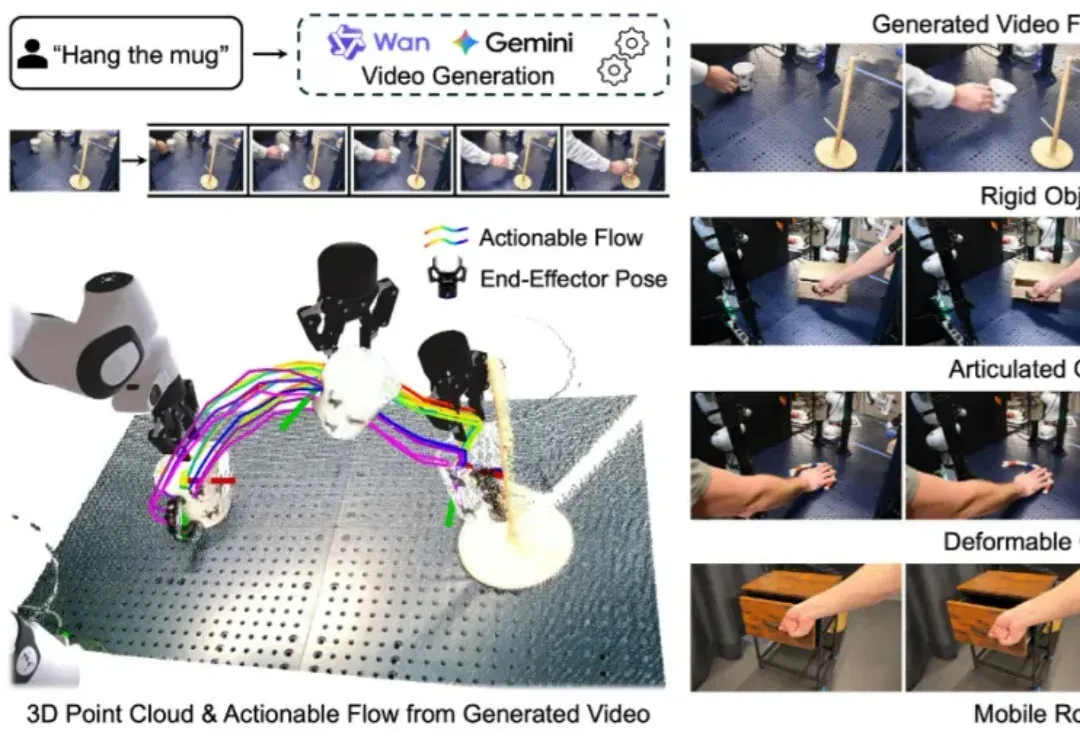
机器人「看片」自学新技能:NovaFlow从生成视频中提取动作流,实现零样本操控(在新窗口打开)
构建能够在新环境中、无需任何针对性训练就能执行多样化任务的通用机器人,是机器人学领域一个长期追逐的圣杯。近年来,随着大型语言模型(LLMs)和视觉语言模型(VLMs)的飞速发展,许多研究者将希望寄托于视觉 - 语言 - 动作(VLA)模型,期望它们能复刻 LLM 和 VLM 在泛化性上取得的辉煌。
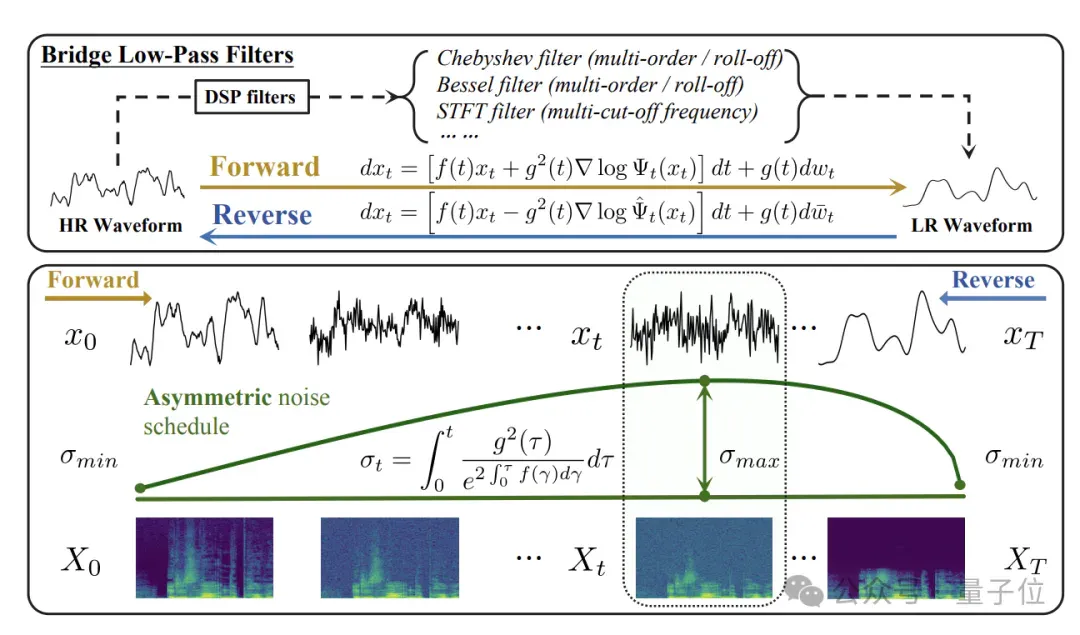
清华大学x生数科技:从波形到隐空间,AudioLBM引领音频超分新范式(在新窗口打开)
在这一背景下,清华大学与生数科技(Shengshu AI)团队围绕桥类生成模型与音频超分任务展开系统研究,先后在语音领域顶级会议ICASSP 2025和机器学习顶级会议NeurIPS 2025发表了两项连续成果:
RL 将如何提高具身大模型 VLA 泛化性?清华大学团队NeurIPS 2025文章分析 RL 与 SFT 泛化性差异(在新窗口打开)
在具身智能领域,视觉 - 语言 - 动作(VLA)大模型正展现出巨大潜力,但仍面临一个关键挑战:当前主流的有监督微调(SFT)训练方式,往往让模型在遇到新环境或任务时容易出错,难以真正做到类人般的泛化
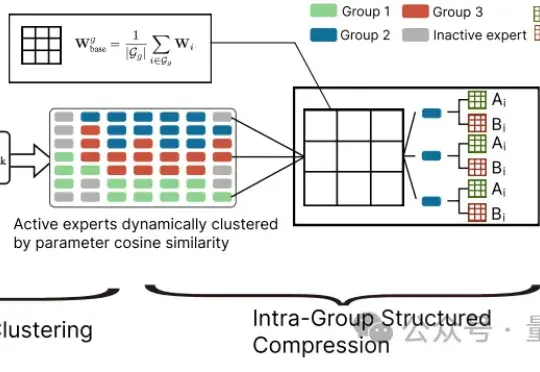
破解MoE模型“规模越大,效率越低”困境!中科院自动化所提出新框架(在新窗口打开)
大模型参数量飙升至千亿、万亿级,却陷入“规模越大,效率越低” 困境?中科院自动化所新研究给出破局方案——首次让MoE专家告别“静态孤立”,开启动态“组队学习”。
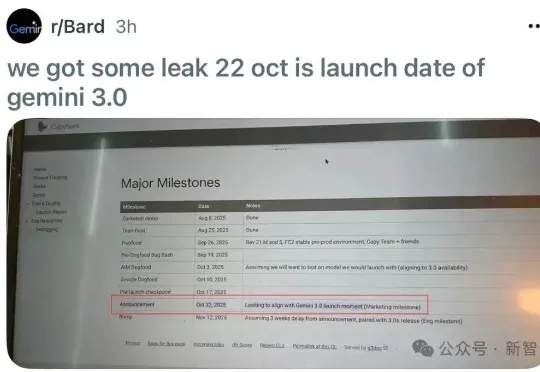
谷歌Gemini 3.0「全家桶」年度压轴,前端不再需要人类!下周王者降临(在新窗口打开)
Gemini 3.0更近了!网友爆料称,谷歌下一代旗舰模型将在10月22日发布。一些拿到内测资格的开发者,放出了最全面的demo,Gemini 3.0能做到一次性直出网页、游戏、原创音乐等。前端开发,再也不需要人类。