Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
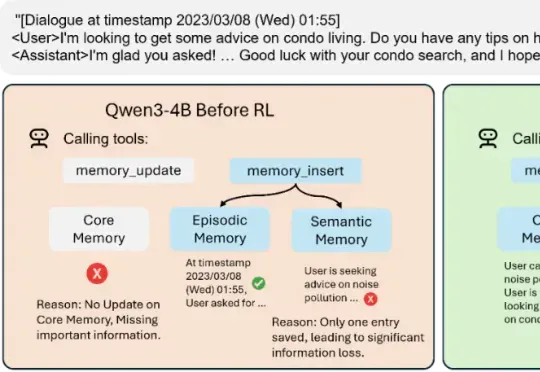
强化学习+大模型记忆:Mem-α,让智能体第一次学会“如何记忆”(在新窗口打开)
Mem-α 的出现,正是为了解决这一困境。由加州大学圣地亚哥分校的 Yu Wang 在 Anuttacon 实习期间完成,这项工作是首次将强化学习引入大模型的记忆管理体系,让模型能够自主学习如何使用工具去存储、更新和组织记忆。
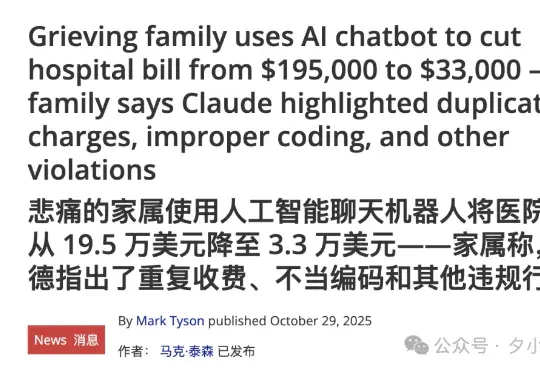
AI把150万医疗账单,砍到了20万(在新窗口打开)
AI 最有用的一集出现了。昨天我刷到一个新闻,一个普通网友,用每月 20 美元的 Claude,把医院开出的 19.5 万美元 账单直接砍到了 3.3 万美元。换成人民币,就是从约 150 万,砍到了 20 多万。
大模型比拼:MiniMax M2 vs GLM 4.6 vs Claude Sonnet 4.5(在新窗口打开)
正好上周(10月27日),MiniMax 公司发布了[2] M2 模型,代表了国产大模型的最新水平。我就想,可以测测它的实战效果,跟智谱公司的 GLM 4.6 和 Anthropic 公司的 Claude Sonnet 4.5 对比一下。毕竟它们都属于目前最先进的编程大模型,跟我们开发者切身相关。
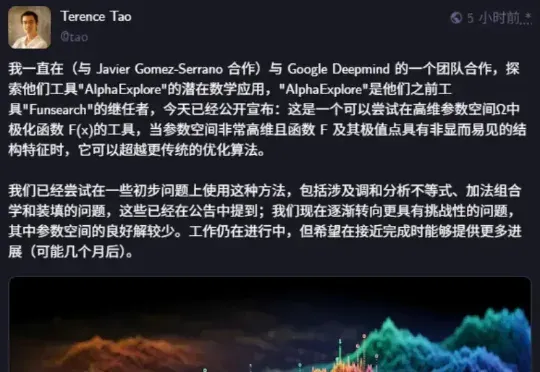
谷歌AlphaEvolve太香了,陶哲轩甚至发了篇论文,启发数学新构造(在新窗口打开)
著名数学家陶哲轩发论文了,除了陶大神,论文作者还包括 Google DeepMind 高级研究工程师 BOGDAN GEORGIEV 等人。论文展示了 AlphaEvolve 如何作为一种工具,自主发现新的数学构造,并推动人们对长期未解数学难题的理解。AlphaEvolve 是谷歌在今年 5 月发布的一项研究,一个由 LLMs 驱动的革命性进化编码智能体。
两周复刻DeepSeek-OCR!两人小团队还原低token高压缩核心,换完解码器更实用(在新窗口打开)
两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。
AI陪伴Replika创始人的新产品,2000 万美元押注"软件界的 YouTube"(在新窗口打开)
Kuyda 和她的团队开始痴迷于一个比喻:当前的聊天机器人相当于 AI 界面的 MS-DOS 时代,而将会出现某种类似 Windows 或 MacOS 的时刻。Wabi不是另一个代码生成工具,也不是开发者的辅助工具,而是一个真正面向大众市场的消费产品,专为非技术人员设计。
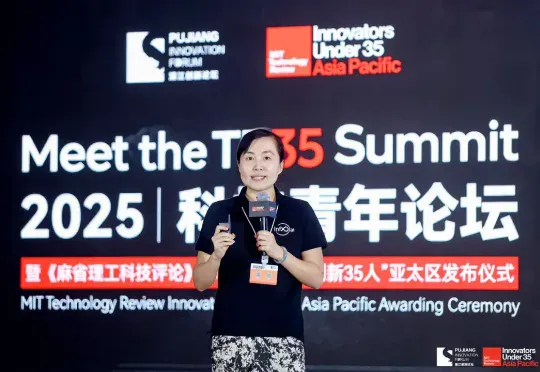
对话杨红霞:从大厂到创业,她希望做出下一个OpenAI(在新窗口打开)
杨红霞,是中国大模型领域一个无法绕开的名字。人们从 M6 模型(阿里达摩院发布的万亿参数 AI 大模型)开始熟知她,而她又在最近走出创业隐匿模式,正式向世界宣告自己已经是一名创业者,并希望能够做出下一
强化学习教父重出江湖, 生成式AI的时代要结束了?(在新窗口打开)
过去两年,AI靠模仿人类席卷世界。但强化学习之父Richard Sutton却说:「GenAI的时代正在结束。」他带着图灵奖的荣光,加入一家几乎没人听过的公司——ExperienceFlow.AI,他要让AI不靠人类数据喂养,而靠「经验」觉醒。
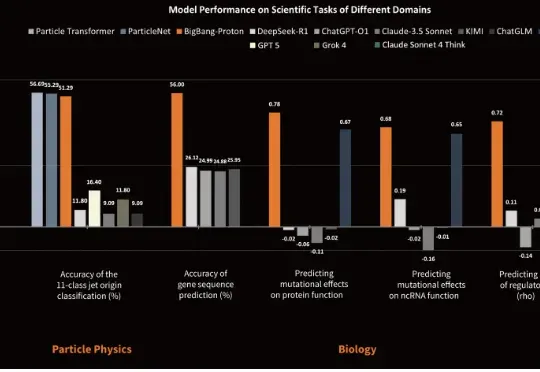
自回归科学基座模型 BigBang-Proton,提出实现 AGI 的新路线(在新窗口打开)
近日,专注于研发物质世界基座模型的公司超越对称(上海)技术有限公司(超对称)发布了新版基座模型 BigBang-Proton,成功实现多个真实世界的专业学科问题与 LLM 的统一预训练和推理,挑战了 Sam Altman 和主流的 AGI 技术路线。
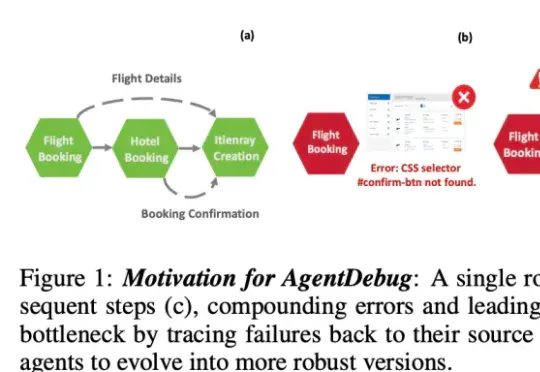
在失败中进化?UIUC联合斯坦福、AMD实现智能体「从错误中成长」(在新窗口打开)
伊利诺伊大学厄巴纳 - 香槟分校(UIUC)等团队近日发布论文,系统性剖析了 LLM 智能体失败的机制,并提出了可自我修复的创新框架 ——AgentDebug。该研究认为,AI 智能体应成为自身的观察者和调试者,不仅仅是被动的任务执行者,为未来大规模智能体的可靠运行和自动进化提供了理论与实践工具。
AI武装的黑产背后,这群人正在打一场看不见的战争。(在新窗口打开)
我其实有一个一直非常感兴趣的话题。 就是,黑产是怎么借助AI,来武装自己的。 在我们这个时代,我们几乎都能清楚的看到,AI技术对于社会的利,对于所有人的进步,也几乎不会再有人怀疑,AI到底是不是未来了
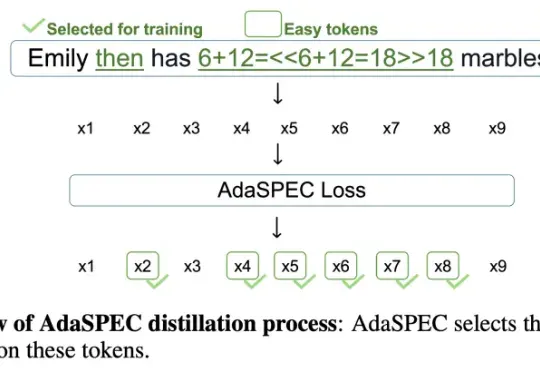
NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了(在新窗口打开)
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
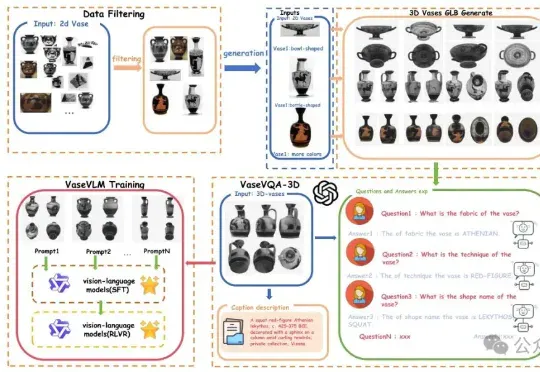
北大团队让AI学会考古!全球首个古希腊陶罐3D视觉问答数据集发布,还配了专用模型(在新窗口打开)
现在AI都懂文物懂历史了。一项来自北京大学的最新研究引发关注:他们推出了全球首个面向古希腊陶罐的3D视觉问答数据集——VaseVQA-3D,并配套推出了专用视觉语言模型VaseVLM。这意味着,AI正在从“识图机器”迈向“文化考古Agent”。
刚刚,AI大牛刘威视频创业公司Video Rebirth,完成5000万美元融资(在新窗口打开)
AI 视频初创公司 Video Rebirth 今日宣布完成 5000 万美元的融资。本轮融资参与方阵容强大,包括全球及新加坡的头部美元基金、互联网巨头、中国及韩国老牌游戏上市公司、全球领先的芯片企业及知名家族办公室,募集资金将主要用于视频模型的持续迭代、顶尖人才招募及全球市场拓展。
Kimi K2 Thinking突袭!智能体&推理能力超GPT-5,网友:再次缩小开源闭源差距(在新窗口打开)
Kimi K2 Thinking,现已发布并开源!
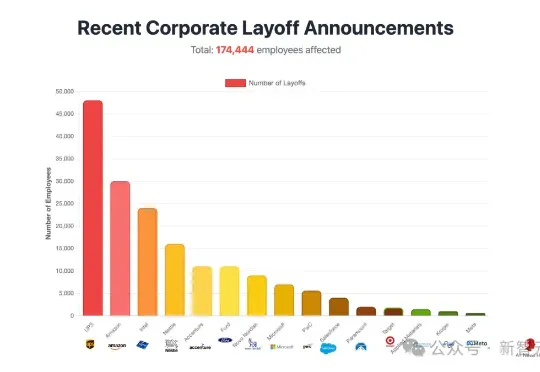
17万白领岗消失!Scale AI最新研究:AI仅动用了3%实力(在新窗口打开)
AI卷走饭碗,17万大军一夜失业。别慌,Scale AI新作一锤定音:全球六大顶尖AI,现在能自动处理的事情连3%都不到。来自Scale AI和Center for AI Safety最新研究,一句话戳破了真相:虽然AI很聪明,但还不够实用。目前,AI自动化率还不到3%。值得一提的是,论文参与者中,还有Alexandr Wang本尊,曾在Scale AI期间完成的研究。
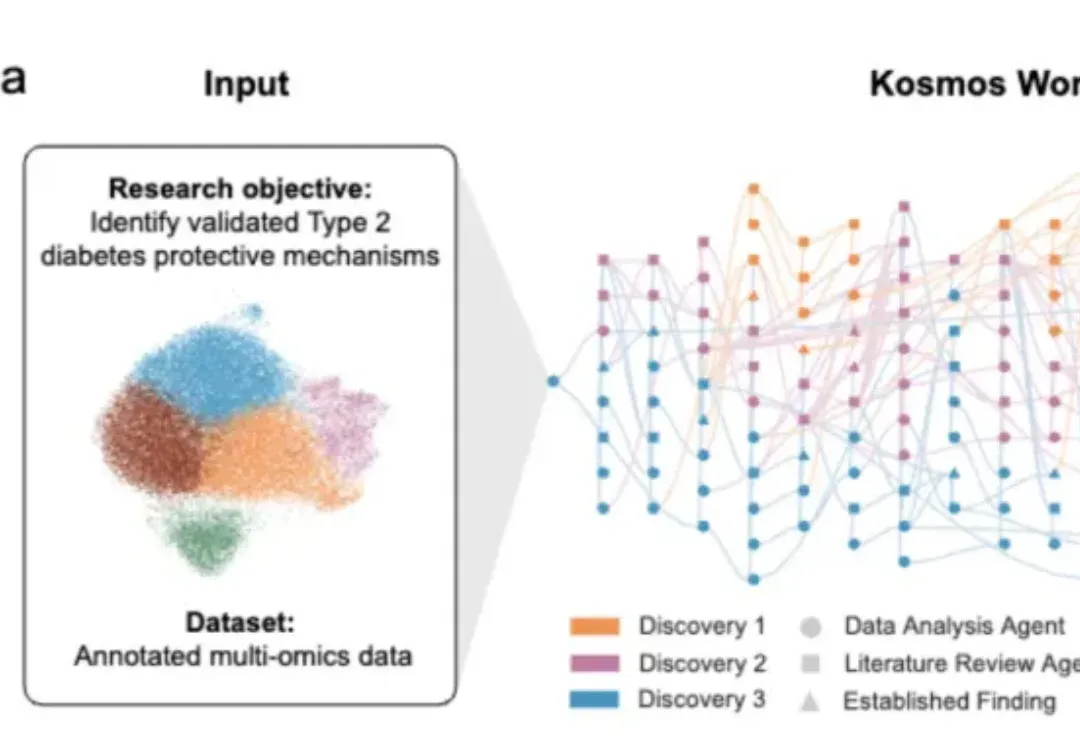
连肝12小时!一轮狂刷1500篇论文,写4.2万行代码,AI科学家卷疯科研圈(在新窗口打开)
半天干完6个月的活儿,AI科学家才是真卷王。
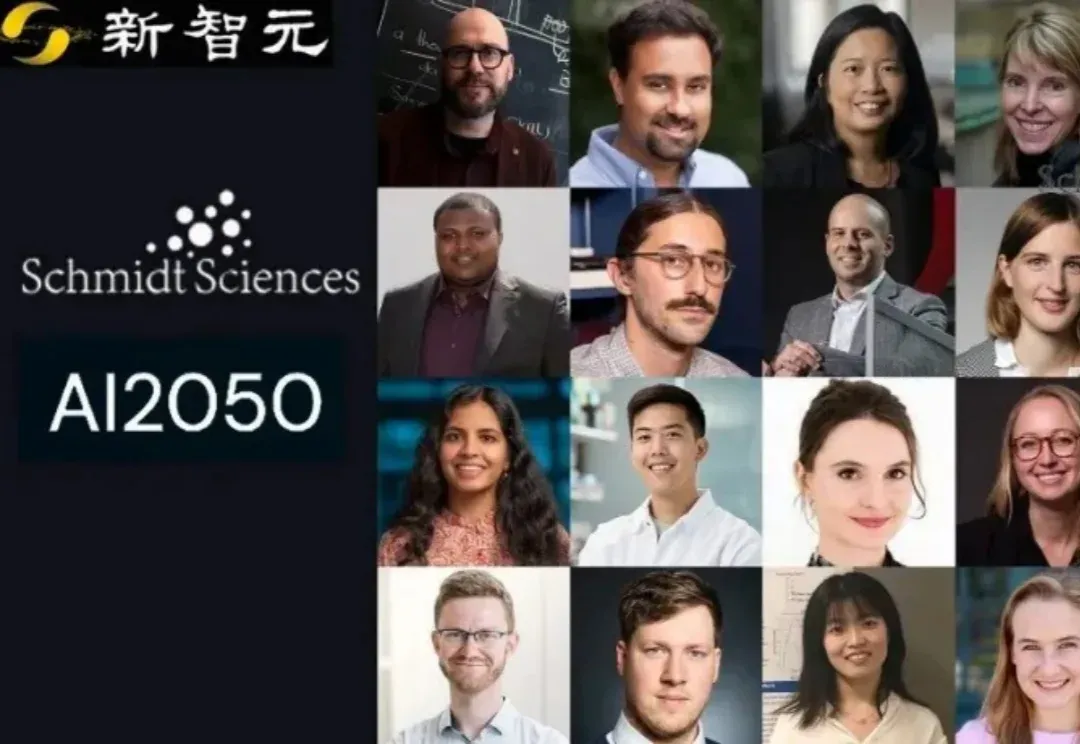
李飞飞之后,何恺明弟子再拿AI大奖!清华校友等28位Fellow上榜(在新窗口打开)
新星闪耀!28位学者获1800万美元,华人天才齐上阵。AI2050瞄准AI普惠与安全。一文速览谷歌前CEO看好的AI方向和研究项目。
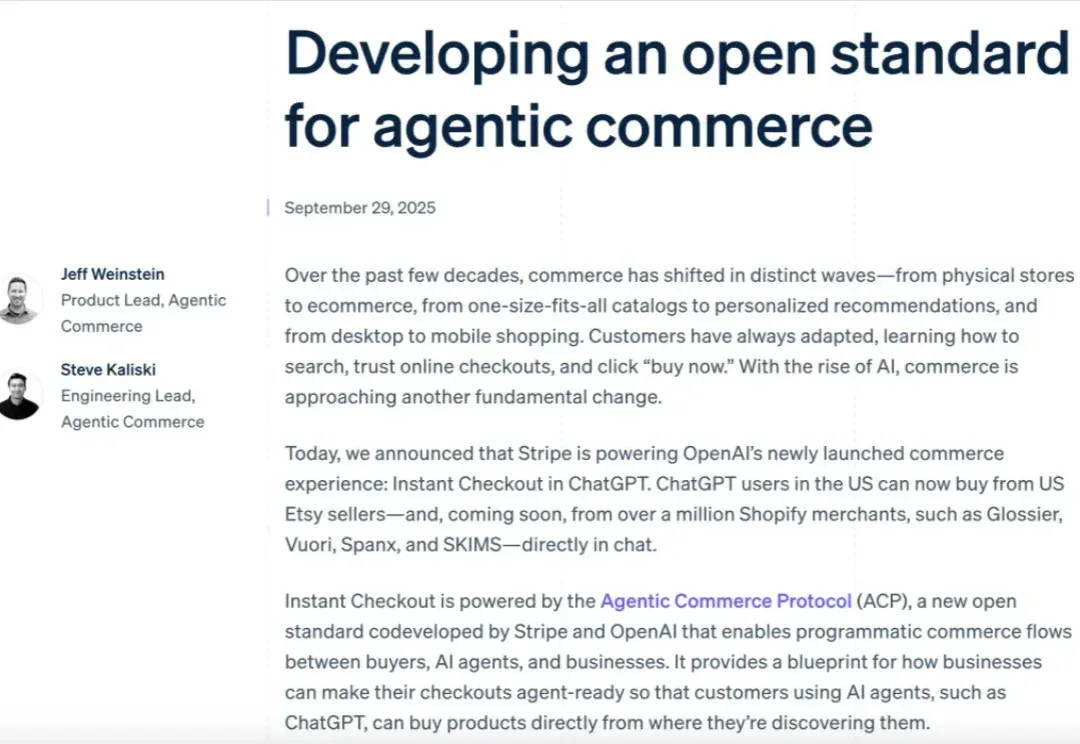
联手 OpenAI 发布 ACP,Stripe 是如何思考 Agent 支付的?(在新窗口打开)
当 agent 开始学会“消费”,支付世界也迎来了重构的时刻。
AI科学家登场!12小时抵人类科学家半年工作量,已有7项大成果(在新窗口打开)
奥特曼称GPT-6或让「AI创造新科学」成真。与此呼应,类「AI科学家」Kosmos登场:12小时读1500篇文献、跑4.2万行代码,生成可溯源报告,并在材料等方向提出新发现。它凭持续记忆自主规划,正由工具迈向合作者;但受数据来源与复现性制约,约20%结论仍需人类裁判。人机协作或将重塑科研,科研范式加速演进,前景可期。