Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
2026 年,企业全面拥抱语音 AI 智能体(在新窗口打开)
a16z 指出:“模型开发的进展正在简化整个基础设施栈,使得语音智能体具备更低延迟和更高性能。这一提升主要出现在过去六个月内,得益于新一代对话模型的出现。”基于这些趋势,Deepgram 与 Opus Research 合作开展的《2025 语音 AI 状况调查报告》,基于 400 位商业领袖的洞察,涵盖十多个行业,分析了语音 AI 的应用现状与关键特性。
Z Potentials|独家专访美国DeepSeek背后的90后投资人,他眼中的下一代万亿美元公司在哪里?(在新窗口打开)
在本次 Z Potential 独家专访中,我们邀请到了 Striker Venture Partners 合伙人、Skild AI 与 Reflection AI 的早期投资人 Brian Zhan,深度解析他在 AI 时代如何快速投出明星级别的独角兽公司。
17岁高中辍学,靠ChatGPT手把手教成OpenAI科学家(在新窗口打开)
当高校还在教你写简历时,有人已经拿着「ChatGPT文凭」给奥特曼P图偷显卡,顺手改写签证规则和学历游戏。这不只是一个辍学生逆袭故事,而是AI时代对大学和文凭一次彻底瓦解。
速递|信实集团110亿美元投资AI数据中心,印度本土巨头与全球资本竞逐万亿市场(在新窗口打开)
Digital Connexion 是由穆克什·安巴尼的依赖工业有限公司 、布鲁克菲尔德资产管理公司以及 Digital Realty Trust 共同组建的合资企业,已签署协议计划到 2030 年投资 110 亿美元在印度南部开发 数据 中心设施,标志着对科技领域增长最快赛道之一的最新投资。
CB Insights 2025 未来科技新星:45 家高潜力AI初创公司名单与技术趋势解读|Jinqiu Select(在新窗口打开)
CB Insights 发布的《2025 Future Tech Hotshots:Scouting Reports》报告,结合生成式 AI 分析与专有 Mosaic 评分体系,从全球海量初创企业中遴选出 45 家最具潜力的科技公司。
完成近亿元融资,QuickCEP要把“中国品牌出海”带入 AI Agent 3.0 时代(在新窗口打开)
中国品牌出海赛道,又多了一笔分量十足的融资消息。中国品牌出海 AI Agent 解决方案企业 北京快牛智营(QuickCEP)宣布完成近亿元融资,本轮由啟赋资本领投,老股东复星锐正超额跟投。融资完成后,QuickCEP 将在巩固跨境电商业务优势的基础上,把服务边界从跨境电商,延展到海外物流、汽车出海、金融出海、游戏出海等更多行业场景,加速其在全球市场的收入增长。
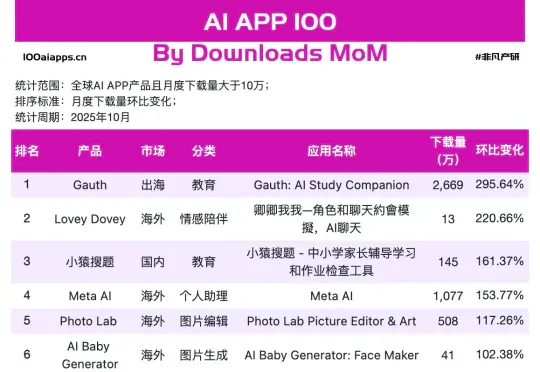
不炫技的 AI,涨得更快,17 款 AI App接住了人间烟火|2025年10月AI百强榜(在新窗口打开)
但当我们把视线从焦点模型上,挪到手机里AI应用真实数据上,就会发现一幅不同的画面。可以看到在非凡产研 10 月 AI App 增速榜上,跑得最快的那 17 个,并不是万事皆可聊的通用助手,而是一群看上去有点普通、甚至有点土气的小应用,其中Gauth、Starry、Knowunity、AI Baby Generator已经连续两个月上榜了。
速递|成立五年的AI安全初创公司Veza,拟超10亿美元被ServiceNow收购(在新窗口打开)
Veza 的订阅软件帮助企业了解其员工以及自动化软件任务的 AI Agent对特定客户或公司数据的访问权限,以及他们能对这些数据做什么。ServiceNow 一直在加强其 AI Agent相关的产品,这些产品旨在自动化客户服务和响应IT 帮助台请求等任务。
世界模型:机器能否理解现实?(在新窗口打开)
人工智能研究的最新目标,尤其是在追求“通用人工智能”(AGI)的实验室中,是一个被称为“世界模型”(world model)的概念:这是一种AI内部携带的环境表征,就像一个计算型的雪球玻璃球。AI系统可以借助这个简化的内部模型,在真正执行任务之前,先对预测和决策进行评估。
AI作弊风暴,席卷韩国名校(在新窗口打开)
刚刚过去的深秋,韩国高校涌动着一股意想不到的技术暗流——“生成式人工智能(AI)作弊”事件席卷韩国大学圈,三所顶尖高校无一幸免。在延世大学、首尔大学、高丽大学的考试中,学生在课堂及线上考试中动用ChatGPT或群聊进行作弊。
大量走访后, 个人眼里能看到的很近的两大AI 生意模式 == 离“大泡沫破裂”还有相当长的时间(在新窗口打开)
最近一段时间 “AI 泡沫”是个很火的词. 想回答这个问题, 其实==“AI 能否赚钱”, 于是就有了大量访问+工作后的实际观察. 1. 接触的N位中老年人已经不太用Google搜索了, 几乎就是直接
OpenAI,可能创造了历史上最快的烧钱速度(在新窗口打开)
近日,OpenAI被曝正面临越发增长的推理费用,作为有史以来最能烧钱的初创公司,其运行大语言模型的成本可能无法通过收入来支撑。
Lovable 增长负责人:Vibe Coding 产品还没找到 PMF,核心用户每个季度都在变(在新窗口打开)
「Vibe Coding 肯定是有 PMF 的,但 Vibe Coding 产品其实还没找到自己的 PMF。」AI Coding 明星产品 Lovable 的增长负责人 Elena Vera,在一次采访中明确说道。来自 The Information 数据,以 Cursor、Claude Code 为代表的 AI Coding 工具的累计营收,已经突破了 31 亿美元。
NeurIPS 2025 | DynaAct:DeepSeek R1之外,探索大模型推理的另一条道路(在新窗口打开)
大模型推理的爆发,实际源于 scaling 范式的转变:从 train-time scaling 到 test-time scaling(TTS),即将更多的算力消耗部署在 inference 阶段。典型的实现是以 DeepSeek r1 为代表的 long CoT 方法:通过增加思维链的长度来获得答案精度的提升。那么 long CoT 是 TTS 的唯一实现吗?
做「最内行」的AI职业搭档Agent丨对话小麦招聘(在新窗口打开)
传统招聘APP的“AI化”,大多停留在简历优化或问答助手,并未改变“信息陈列室”的本质——求职者依然在大量无效信息中自行筛选、猜测、等待。在小麦招聘(英文名:LovTalent)看来,招聘行业一定会被AI快速重塑——它是所有行业中,信息密度最高、结构化程度最低的链条。
国产最强多模态宝座又易主?671B参数练就“火眼金睛”,基于DeepSeek打造(在新窗口打开)
智东西11月28日报道,刚刚,快手开源其新一代旗舰多模态大模型Keye-VL-671B-A37B。该模型基于DeepSeek-V3-Terminus打造,拥有6710亿个参数,在保持基础模型通用能力的前提下,对视觉感知、跨模态对齐与复杂推理链路进行了升级,实现了较强的多模态理解和复杂推理能力。
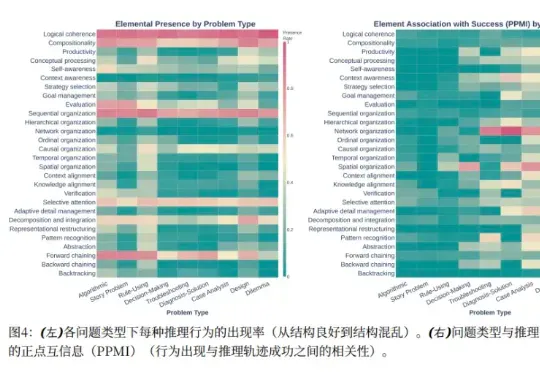
17万条推理轨迹扒出AI推理的真相:有劲儿,但用错了地方|哈佛新论文解读(在新窗口打开)
而今天,来自 UIUC、华盛顿大学等机构的一群研究人员,通过一篇重磅论文《推理的认知基础及其在大型语言模型中的体现》,为这个“认知鸿沟”画出了一张精确的微观解剖图。
贝索斯神秘AI公司爆出,收购前OpenAI大佬创企,已融资440亿(在新窗口打开)
General Agent将如何融入贝索斯公司尚未可知。 General Agents由前OpenAI研究员威廉·格斯(William Guss)于2024年创办,汇聚了来自麻省理工大学、谷歌大脑等高校和机构的研究人员,专注计算机Agent赛道,目前已发布一款Agent产品Ace,该产品能接管用户的电脑并以超人类的速度执行指令操作。
独家 | “文科生”微博,搞出一个数学学霸大模型(在新窗口打开)
近日,微博发布了首个开源模型 VibeThinker,它以15亿的微小参数 与7800美元的极低成本,在国际顶级数学测试中获得相对高分,刷新智能极限。这一结果,无异于以轻巧之姿,刺向了“规模即智能”的行业铁律。
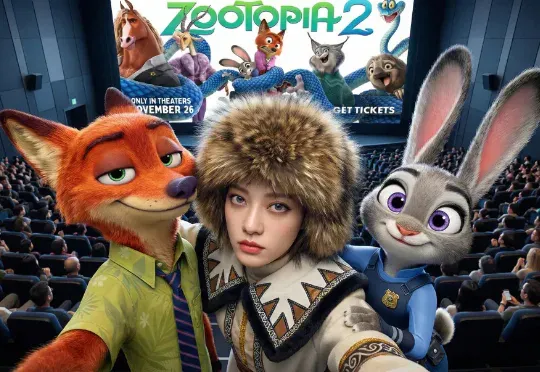
看完《疯狂动物城2》这样发合照火爆朋友圈,Nano Banana Pro 新玩法来了 | 附教程(在新窗口打开)
疯狂动物城2 前几天刚正式上映,超过哪吒,成为中国影史动画电影预售票房冠军,双休日买好票准备去看了吗。社交媒体上,早在预售的时候,就已经都是警官兔朱迪与狐尼克,出现在不同网友的电影院合影里。