Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
全球功能最全的视频生成模型来了(在新窗口打开)
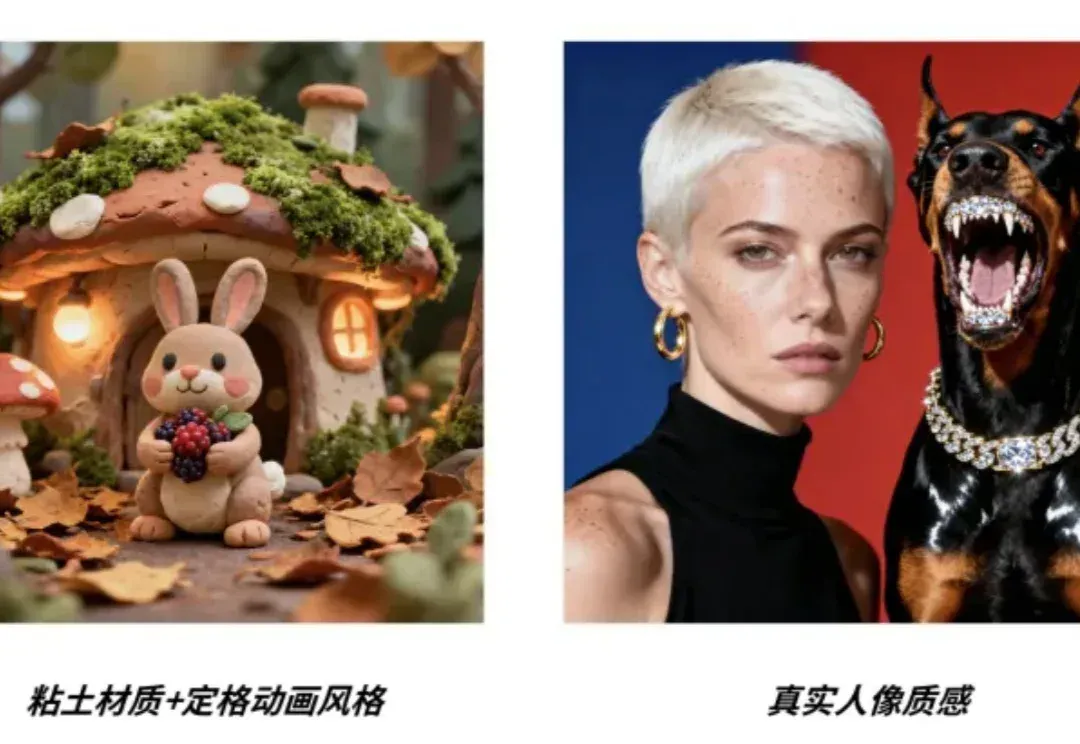
坏了,阿里这波是冲着Sora 2去的! 刚刚,阿里发布了新一代通义万相2.6系列模型,一次性覆盖文生视频、图生视频、参考生视频,以及图像生成和文生图,是目前全球功能最全的视频生成模型。 在视频创作上,万相2.6不仅推出了Sora2目前还没有的多音频驱动生视频能力,还同步引入了音画同步、多镜头叙事等能力。 像下面这个超火的一刀切ASMR,就是通过文本+音频直接驱动出来的: 再看这个由文本+图像+音频驱动的小猫沉浸式吃播,咀嚼声和嘴部动作基本能卡在点上,吃得那叫一个香: 文生图这条线也同步补强了,万相2.6在艺术风格控制、真实感人像、中英文长文本生图以及历史文化IP语义理解等方面的创作能力也都有明
两大模型发布!豆包大模型日均使用量突破50万亿Tokens(在新窗口打开)
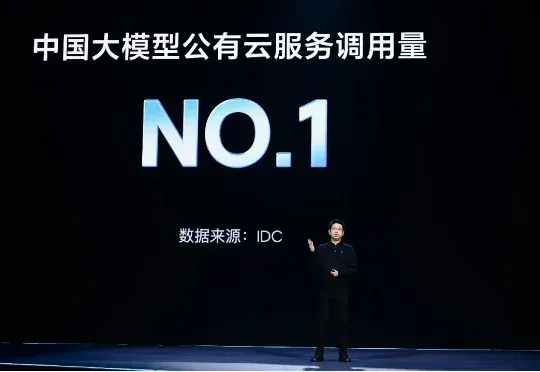
今天,在 FORCE 原动力大会上,火山引擎发布豆包大模型1.8、豆包视频生成模型 Seedance 1.5 pro。经过一年多的持续升级,豆包大模型家族在多模态理解和生成能力、Agent 能力上,已位于全球第一梯队。
小杯Gemini战胜GPT5.2,1分钟模拟Windows操作系统(在新窗口打开)
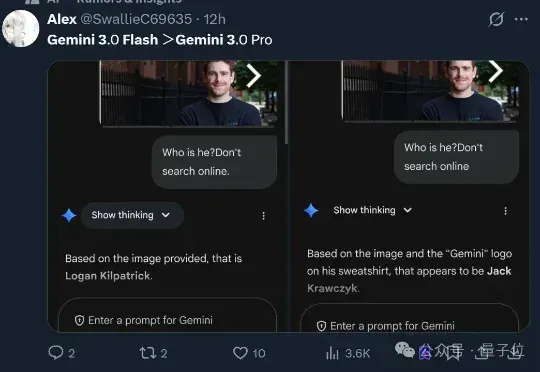
谷歌丢出Gemini 3 Flash,给AI圈示范了啥叫:小孩子才做选择题,成年人当然是全都要(doge)。一个公式来形容这款新模型:Gemini 3 Flash=Pro级智能+Flash级速度+更低价格。
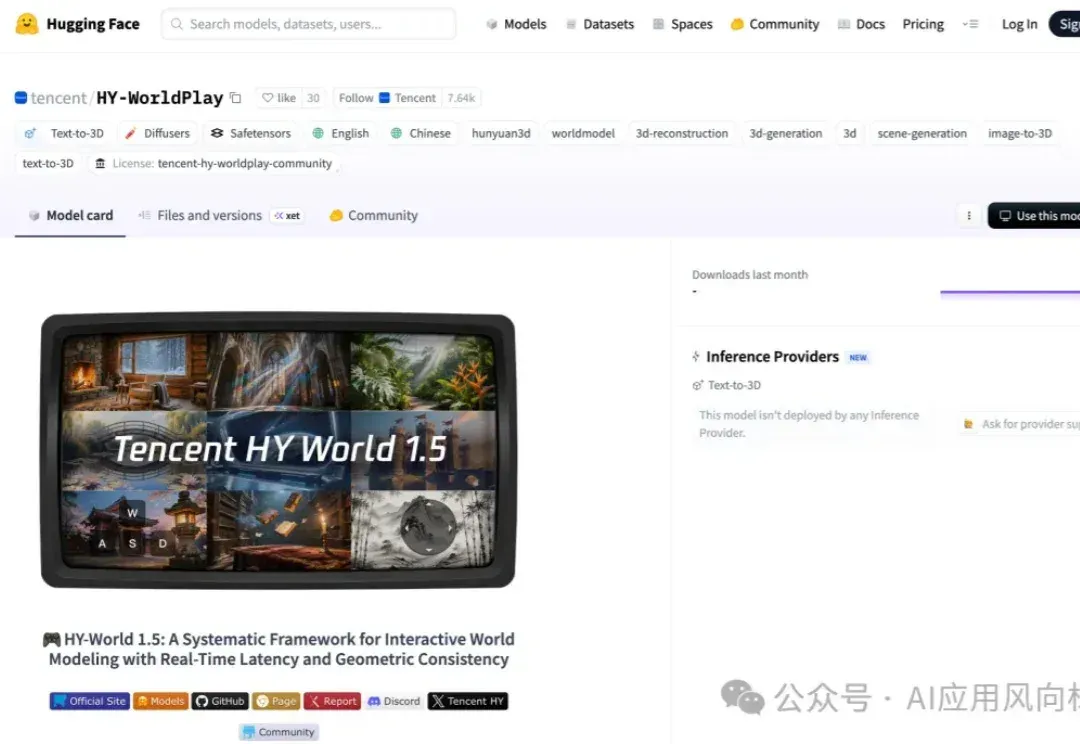
腾讯混元最新世界模型开源!支持实时生成交互,突破长期空间记忆(在新窗口打开)
可支持24帧/秒的长时流式生成。 智东西12月17日报道,今天,腾讯混元发布并开源了最新的混元世界模型1.5(Tencent HY WorldPlay),用户输入文字指令或者图片即可创建可交互世界,该模型拥有空间记忆能力,能呈现出前后一致的场景,支持用户在生成的世界里随意移动探索。目前,这一模型可在腾讯混元3D官网申请体验。 这一模型支持生成第一视角和第三视角场景,能生成多种类型的风格化场景,还支持场景触发特定效果,可应用于AI游戏开发、影视制作和虚拟现实(VR)和具身智能训练等领域。从官方给出的效果图来看,仅通过输入“废弃游乐园,生锈的摩天轮,杂草丛生,怀旧忧伤”这一指令,该模型便生成了精度
速递|AI视听协同新战场:Index与a16z重注初创公司,Mirelo获4100万美元融资(在新窗口打开)
AI 让每个人都能制作视频,但许多 AI 视频创作工具缺乏音频支持。Mirelo 正在开发能根据视频内容匹配音效的 AI 技术。
模型免费、推理翻倍:Gemini 3 Flash 深夜炸场,发放智能体时代的「入场券」(在新窗口打开)
AI竞技场开始清场。 就在刚刚,谷歌再次扣动扳机,正式推出了 Gemini 3 Flash。 这是继 Gemini 3 Pro 之后的又一次暴力输出。没有预告,没有任何铺垫,谷歌直接宣布 Gemini 3 Flash 现已成为 Gemini 应用中的默认模型,全面取代 2.5 Flash。这意味着,全球数亿用户无需支付任何费用,就能立刻体验到 Gemini 3 系列模型的推理能力。 如果说 Gemini 3 Pro 是为了尽情发挥 AI 算力的优势,那 Gemini 3 Flash 则打破了「高智」、「低成本」与「响应快」之间的不可能三角。 打开 Model Card,我们看到一组令人惊讶的数
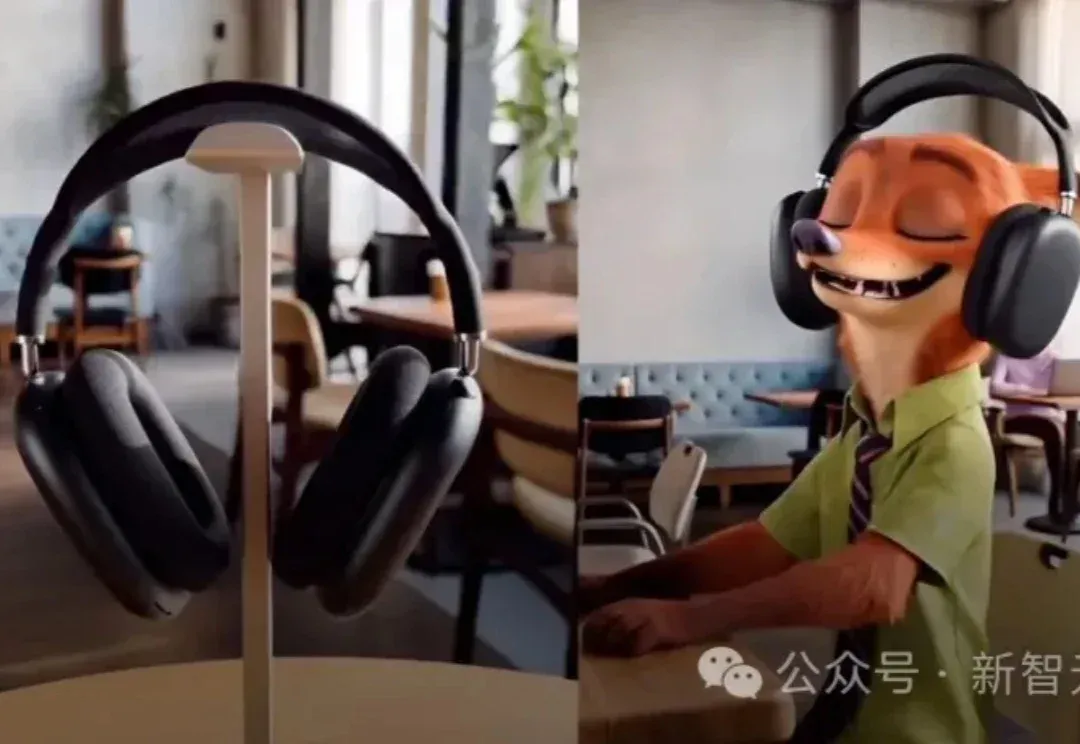
OpenAI还在卷生图,中国AI已一键成片!马斯克免费代言(在新窗口打开)
AI一键成片神器来临!今天,Vidu Agent开启全球内测,一句话复刻爆款,从广告到创意短片,分镜级可控一键短片。
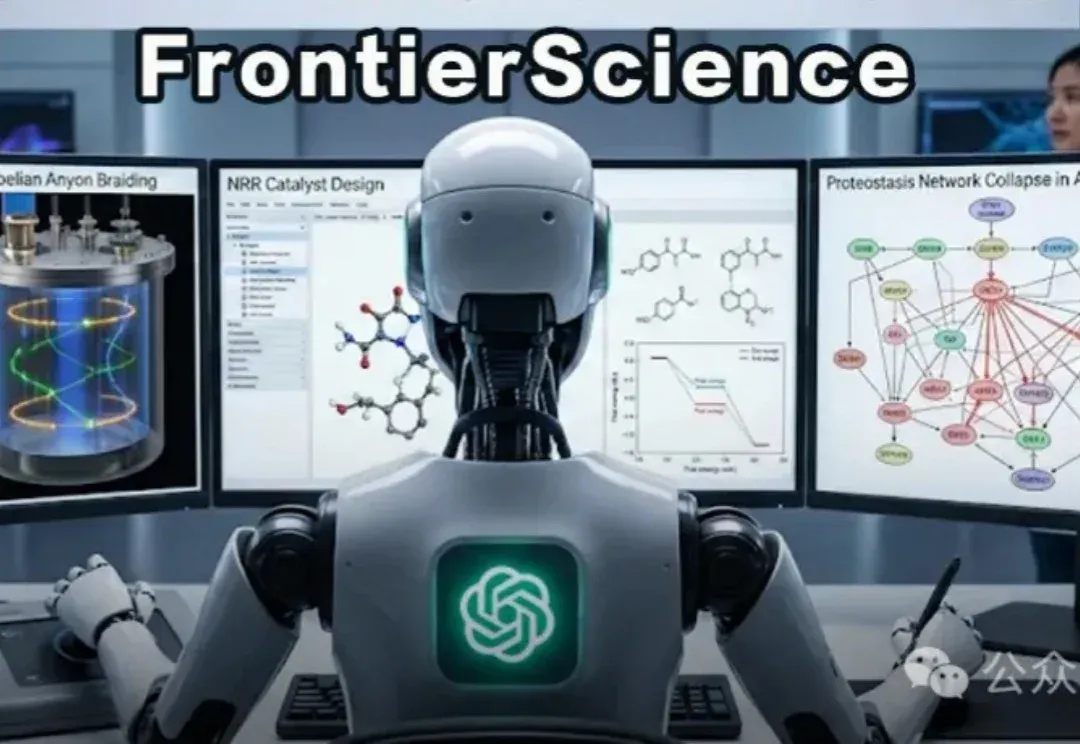
OpenAI发布权威AI科研基准,扯下AI遮羞布:奥赛金牌≠一流科学家!(在新窗口打开)
OpenAI最新发布的FrontierScience基准,试图用真实的博士级难题,从物理、化学、生物三个维度上考验AI。真相是残酷的:在没有唯一标准答案的科研实战中,AI作为「顶级做题家」,距离真正的科学家,还差得远。
速递|OpenAI的“算力的外交官”:聘请英国前财相奥斯本,深度绑定全球AI布局(在新窗口打开)
OpenAI 聘请了英国前财政大臣乔治·奥斯本,领导一项与各国政府合作建设人工智能基础设施的新计划。随着各国竞相获取运行先进人工智能系统所需的数据中心和计算能力,OpenAI 选择了一位备受瞩目的政治人物来推动此事。
18岁用户自述:花6000块买6款AI玩具,年轻人到底在为什么买单?(在新窗口打开)
一场投入真金白银的AI陪伴实验。 结识王诗航是在 11 月举办的一场行业活动上。 他今年 18 岁,是一名大一在读的大学生,目前也在做虚拟艺人相关的创业。那天是周六,他不辞辛苦从市郊的家里赶到朝阳区三环内的活动现场,专门来看一款还没正式发售的AI陪伴玩具的现场演示。初见到他时,王诗航正在和周围的人聊 Walulu——那是他随身携带的一款毛绒猫咪造型的 AI 玩具,他对很多类似产品都很熟悉,一度让笔者误以为他来自某家 AI 玩具厂商。但事实上,只是因为他喜欢,以及真实地体验和购买了不少产品。 从今年 1 月份,他陆续拥有了 6 款 AI 玩具,最早是在直播间激情下单的大象机器人 ✖ 玩具品牌 C
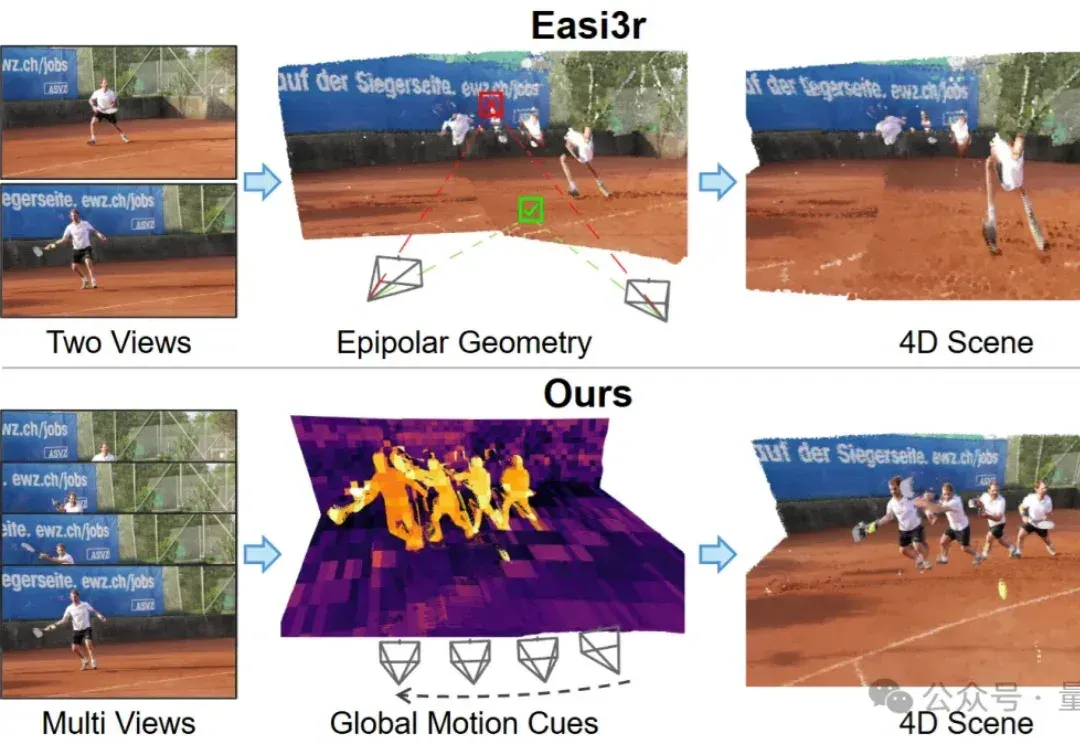
挖掘注意力中的运动线索:无需训练,解锁4D场景重建能力(在新窗口打开)
如何让针对静态场景训练的3D基础模型(3D Foundation Models),在不增加训练成本的前提下,具备处理动态4D场景的能力?
一等奖20万,大佬们出题,最硬核视频生成全球挑战赛开启!(在新窗口打开)
首个AI视频生成全球挑战赛来袭,袁粒、颜水成、程明明、田永鸿、Philip Torr多位大佬发起,20万大奖虚位以待!创作大神还是技术极客?两大赛道总有一个适合你,速速点击报名吧。
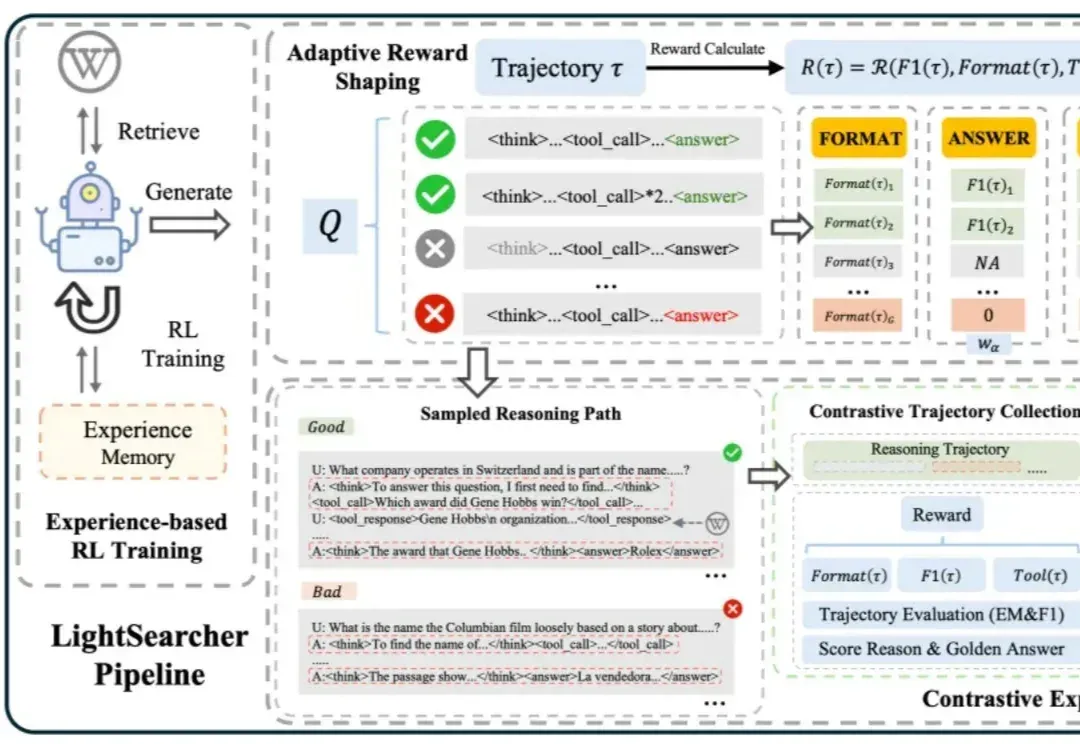
经验记忆黑科技:LightSearcher让AI工具调用减39.6%、推理快48.6%(在新窗口打开)
如今,以 DeepSeek-R1 为代表的深度思考大模型能够处理复杂的推理任务,而DeepSearch 作为深度思考大模型的核心搜索器,在推理过程中通过迭代调用外部搜索工具,访问参数边界之外的最新、领域特定知识,从而提升推理的深度和事实可靠性。
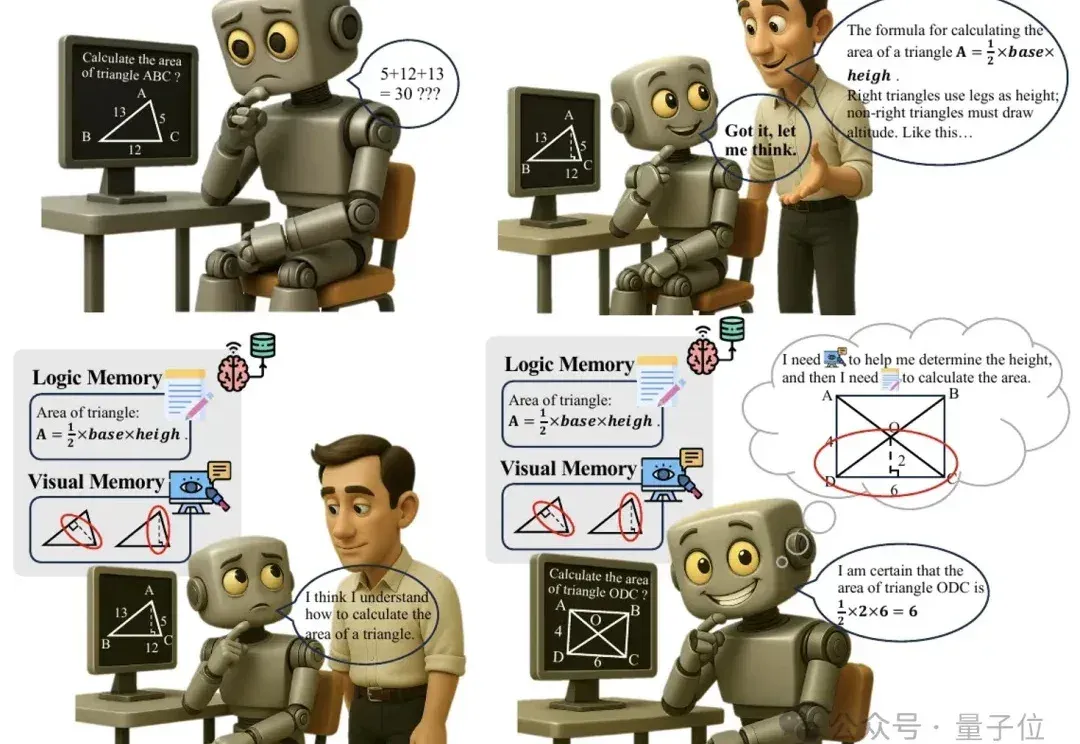
让大模型“吃一堑长一智”,南理工百度等提出模型记忆新方法(在新窗口打开)
多模态推理又有新招,大模型“记不住教训”的毛病有治了。
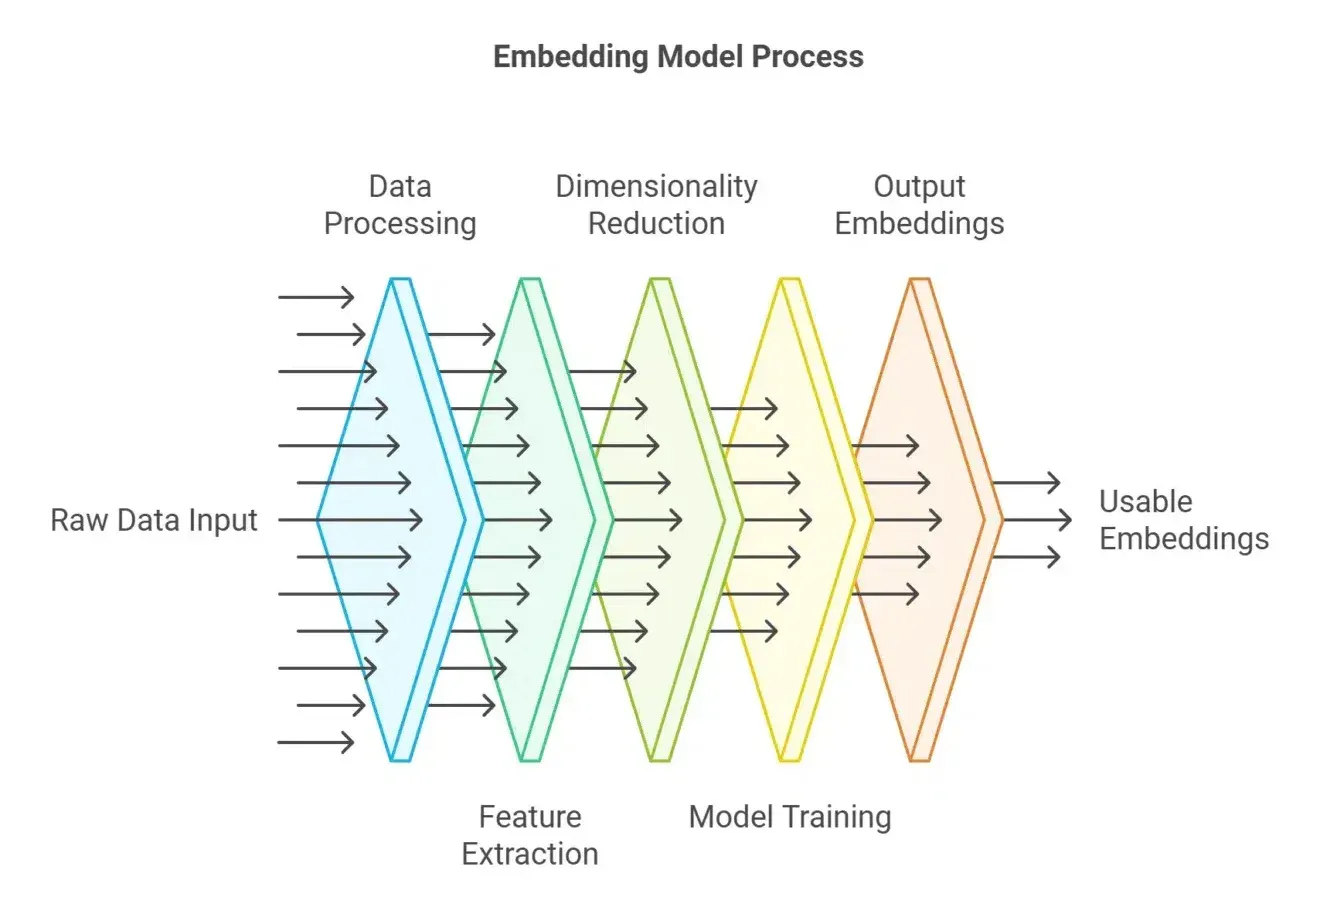
embedding分数不是唯一解!搜索场景,如何根据元数据做加权rerank(在新窗口打开)
今天聊一聊我们如何做高质量rerank。
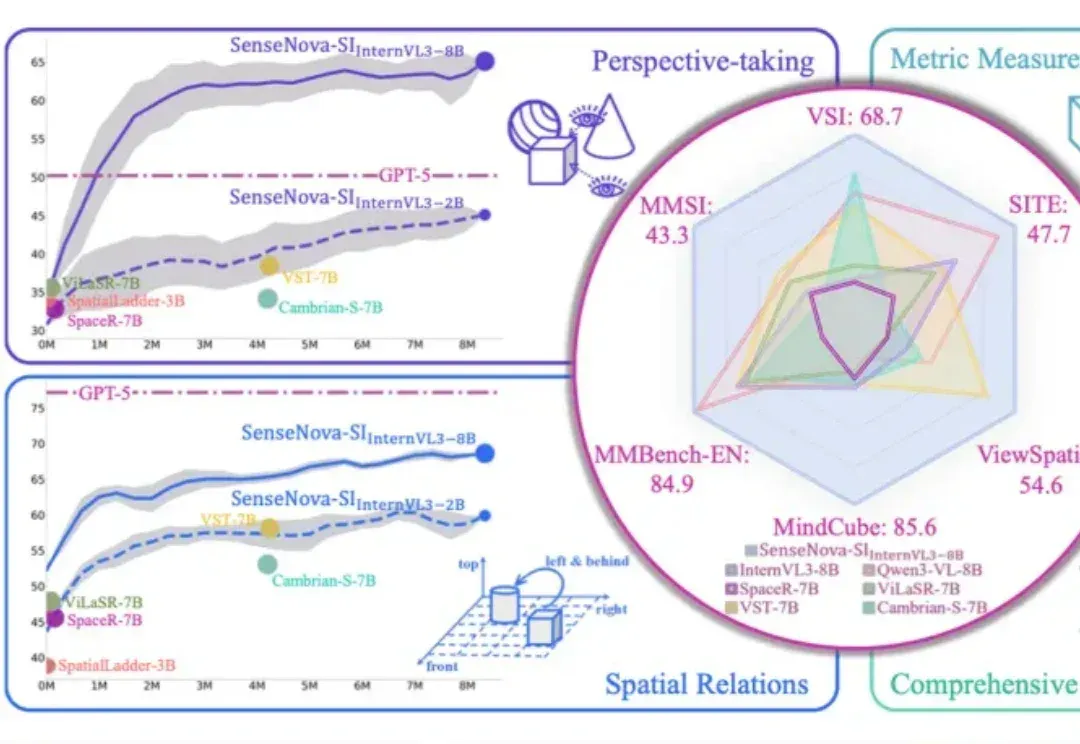
大模型的进化方向:Words to Worlds | 对话商汤林达华(在新窗口打开)
李飞飞团队最新的空间智能模型Cambrian-S,首次被一个国产开源AI超越了。
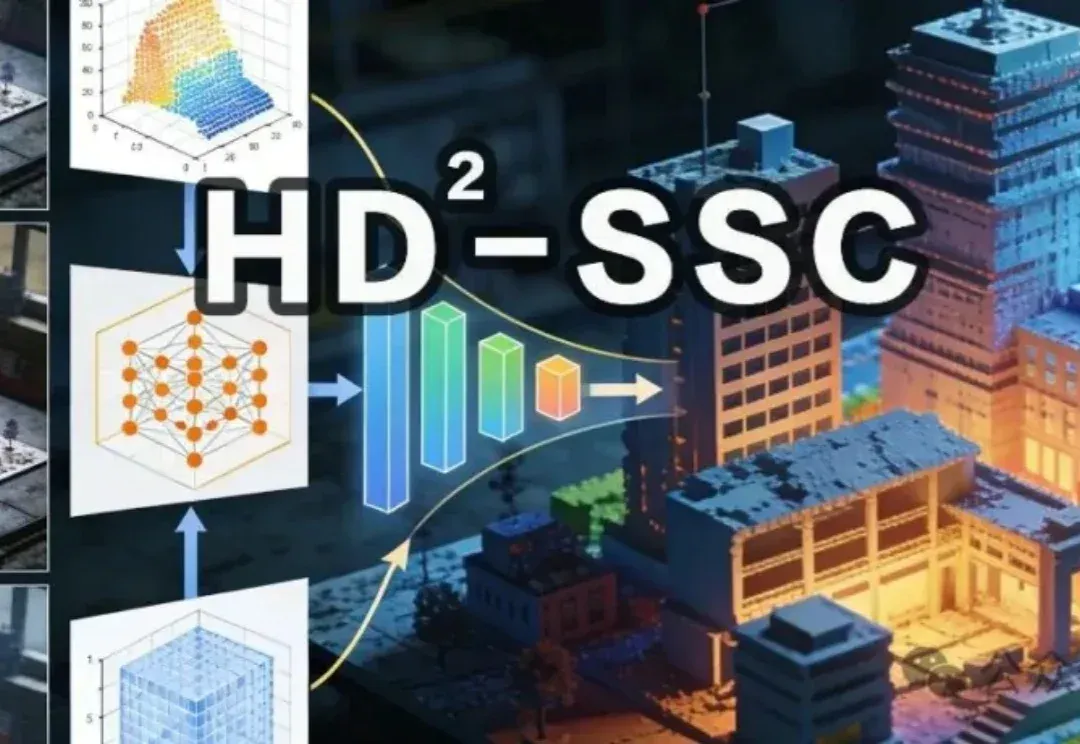
刷榜自动驾驶语义场景补全!北大新作:高维度、高密度 | AAAI'26(在新窗口打开)
北京大学团队提出了一种新的视觉语义场景补全方法HD²-SSC,用于从多视角图像重建三维语义场景。该方法通过高维度语义解耦和高密度占用优化,解决了现有技术中二维输入与三维输出之间的维度差异,以及人工标注与真实场景密度差异的问题,从而实现更准确的语义场景补全。
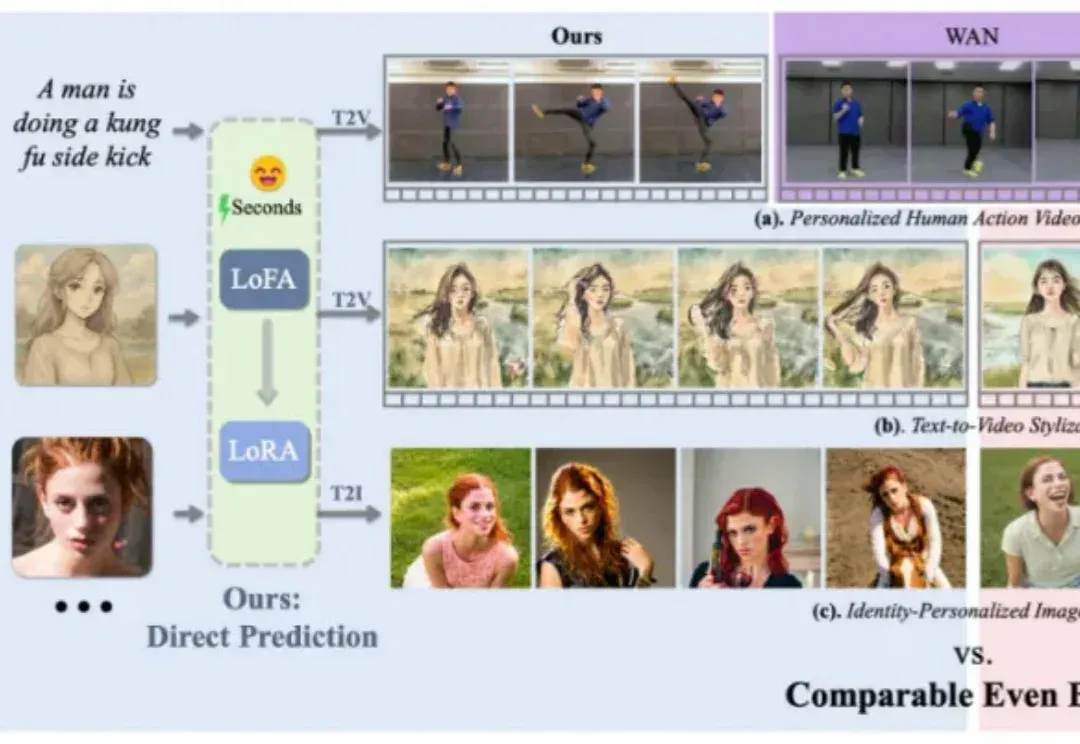
比LoRA更快更强,全新框架LoFA上线,秒级适配大模型(在新窗口打开)
在个性化视觉生成的实际应用中,通用视觉基础模型的表现往往难以满足精准需求。为实现高度定制化的生成效果,通常需对大模型进行针对性的自适应微调,但当前以 LoRA 为代表的主流方法,仍受限于定制化数据收集与冗长的优化流程,耗时耗力,难以在真实场景中广泛应用。
当 AI 开始像人一样用手机(在新窗口打开)
从豆包到阶跃星辰的Step-GUI:手机正在成为 AI 的新入口
60秒极限挑战!中国GPU独角兽杀出重围,斩获图形顶会大奖(在新窗口打开)
他们不光能造GPU,还能写出全球顶级的算法!摩尔线程这次开源给国产具身智能递了一把「神兵利器」。