Know AI. See What’s Next.
第 1 张,共 5 张:MiniMax M3.1 Flash来了:Opus 5.5刷屏的绝活,它也能做
最新资讯流
GPT-6 带火的 Blender,到底能玩什么?(在新窗口打开)
GPT‑6 发布后,Blender 跟着火了一把。
奥特曼:GPT-6早训练完了,更更更强的模型很快发布(在新窗口打开)
奥特曼亲口承认,GPT-6 Astra其实早就训练完了。
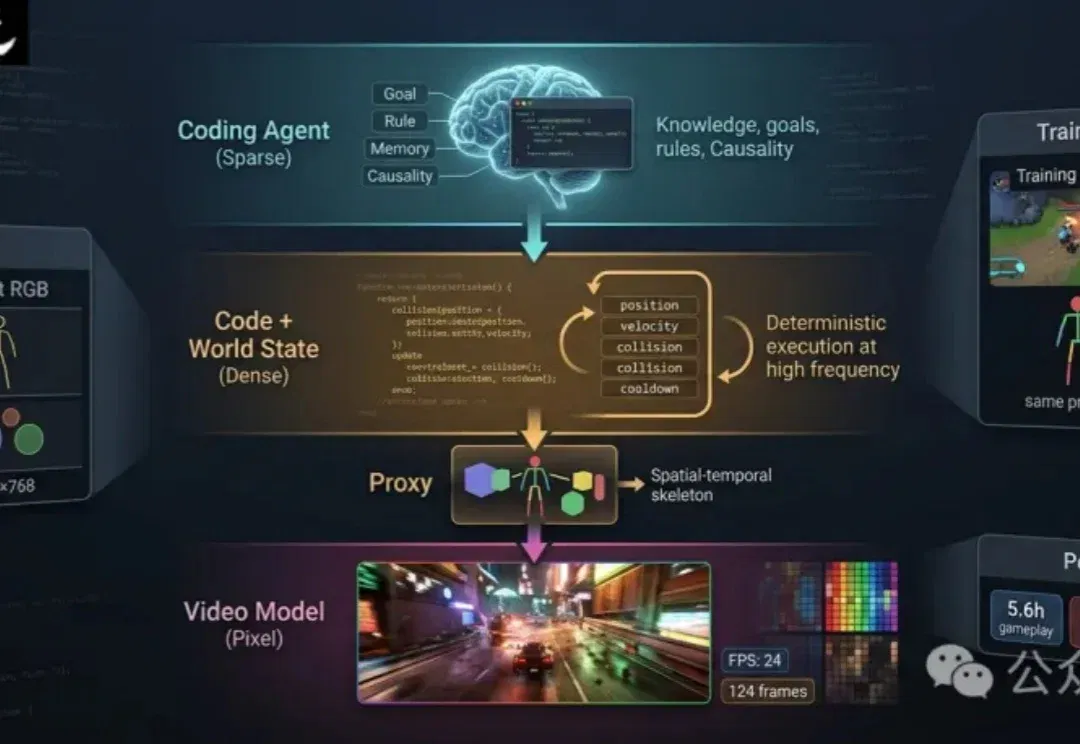
虚幻引擎CEO围观最新世界模型:代码驱动,视频模型生成画面(在新窗口打开)
近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。
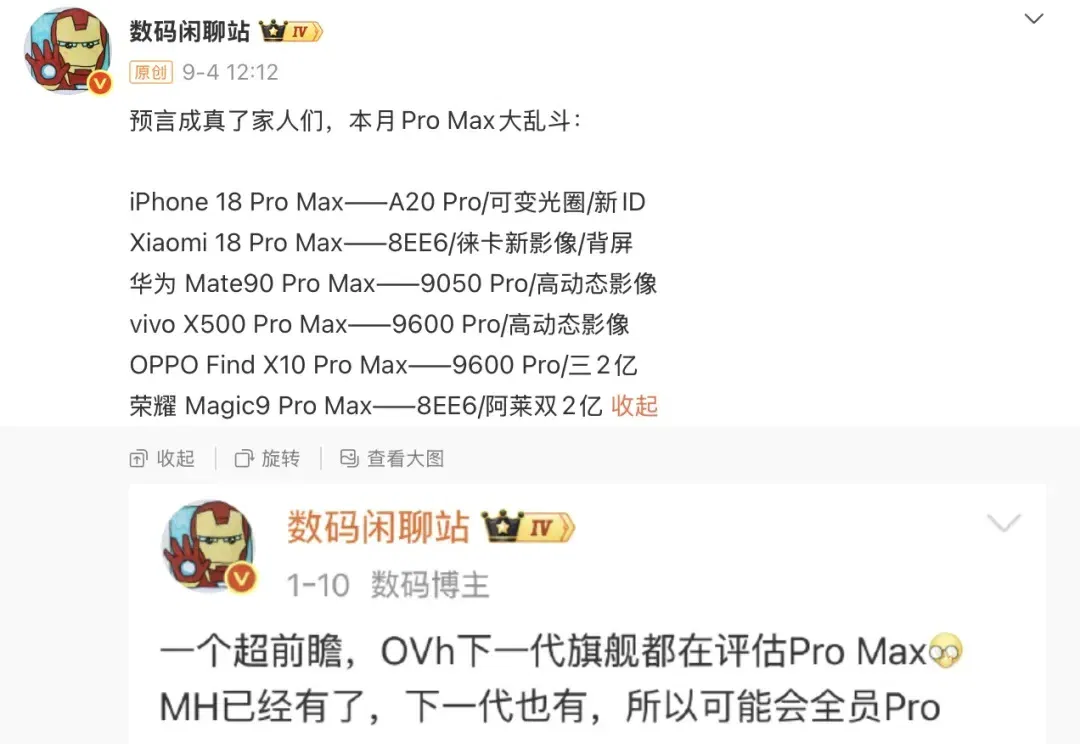
手机 Pro Max 还在大乱斗,AI 模型的名字怎么都卷到「神话」了(在新窗口打开)
进入 9 月,新一轮旗舰手机还未悉数亮相,Pro Max 的命名已先在社交平台刷了屏。
“薄 Agent Loop,厚 Control Plane”:TiDB 用数据库思维重做 Harness(在新窗口打开)
过去一段时间,TiDB 团队启动了一项面向 Agent 的基础设施尝试——TiDB Cloud Filesystem。它把 Workspace 从 Session 和 Sandbox 的生命周期中独立出来:Agent 仍然通过熟悉的文件系统接口工作,背后则提供数据库级的持久化、版本、分支、回滚和权限控制。
模型负责上天,三个“野心家”负责把AI落地(在新窗口打开)
AI行业最性感的故事一直在天上:更大的模型、更聪明的Agent、更接近AGI的能力,每隔几个月就把技术的天花板再往上顶一点。
不只让机器人学会做事,更让机器人学会一起做事丨对话芝诺机器人植伟铭(在新窗口打开)
一项双机器人协作测试中,研究人员故意让其中一台机器人晚了 3 秒。
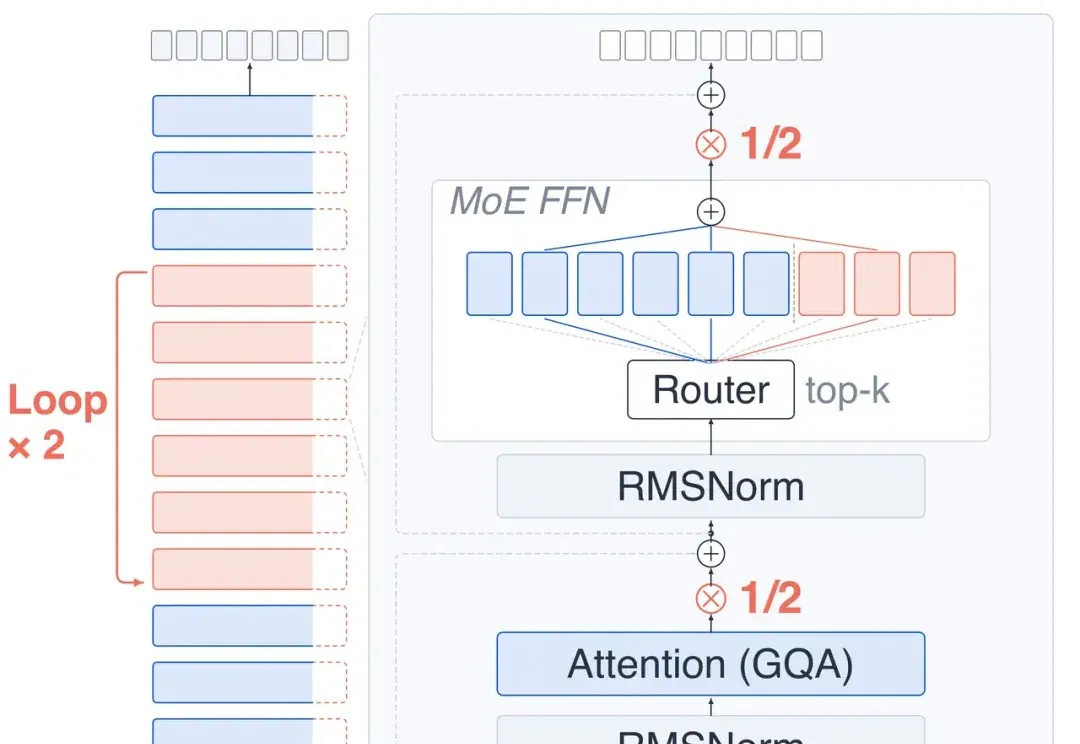
同等预算下,Looped Transformer更强吗?清华、字节Seed给出答案(在新窗口打开)
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
速递|AI算力调度公司Gimlet Labs获3亿美元投资,估值已达30亿美元(在新窗口打开)
AI算力调度公司Gimlet Labs获3亿美元融资,估值达30亿美元,由Andreessen Horowitz领投,Arm Holdings、微软M12等参投,公司目前专注于将AI工作负载分配至不同类型芯片并帮助客户搭建数据中心。
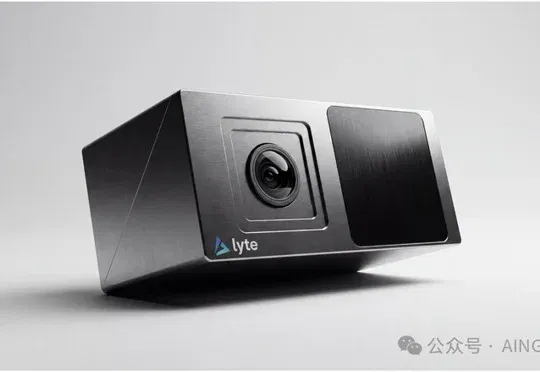
前苹果Face ID工程师创立物理AI感知企业,完成1.65亿美元融资(在新窗口打开)
物理AI感知公司Lyte完成1.65亿美元C轮融资,投后估值达16亿美元,由Maverick Silicon领投,该公司由前苹果Face ID工程师创立,核心产品LyteVision™为机器人提供全栈自研感知基础设施。
杭州发千问办公token卡,要拿大结果(在新窗口打开)
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。
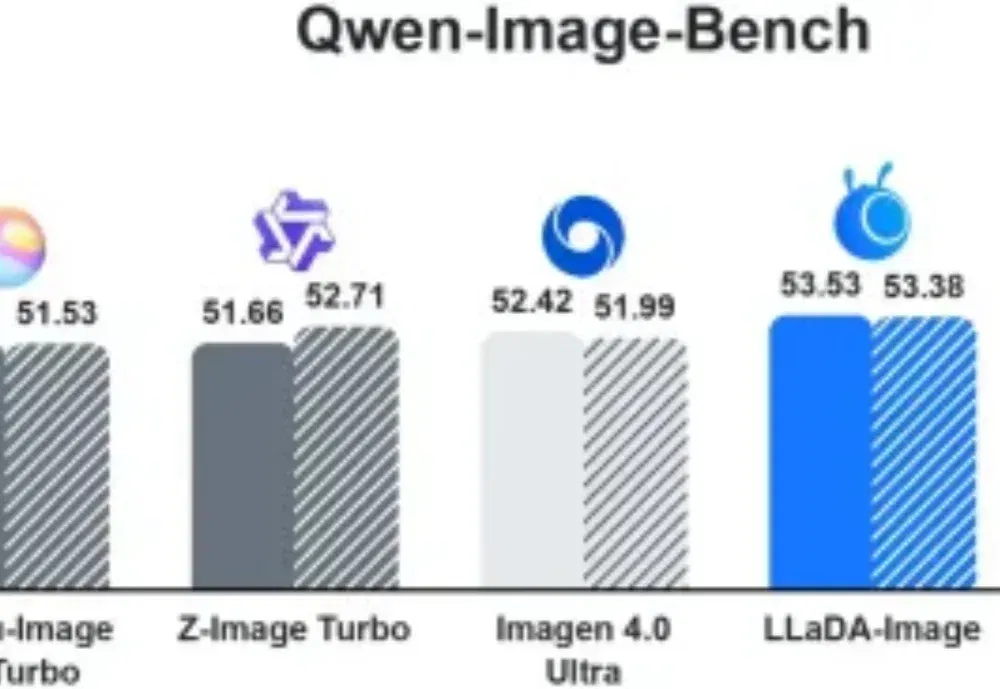
全扩散架构、无需图文对预训练,LLaDA杀穿开源文生图(在新窗口打开)
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
不注册、不花钱,10秒出一条带声音的AI视频,这家公司要干啥?(在新窗口打开)
最近,AI 视频生成领域有一个备受瞩目的变化:视频的生成速度,已经比你看视频的速度都要快了。
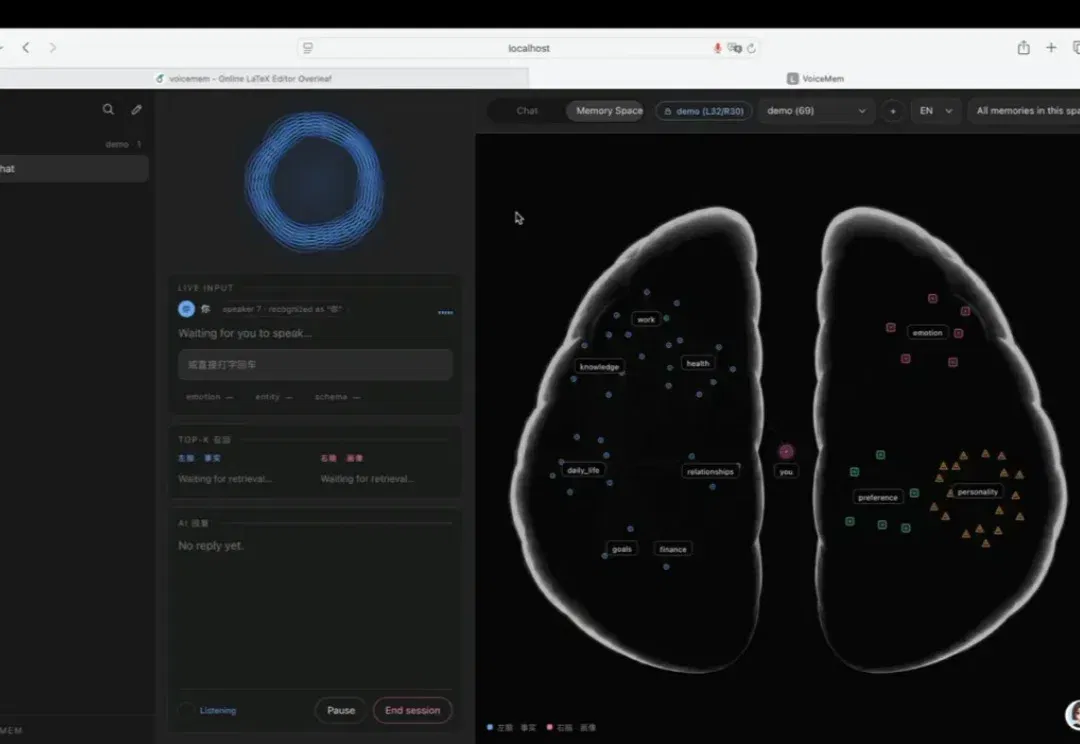
颜水成团队重磅发布VoiceMem,提出「流式双脑架构」打造下一代实时交互基础设施(在新窗口打开)
科幻早就预演过这一天,而这两年 AI 的真实进展,正把它推成一个可讨论的命题:AI 或许不会停在「工具」上,而会成为与人类共生的存在 ——AGI Being。
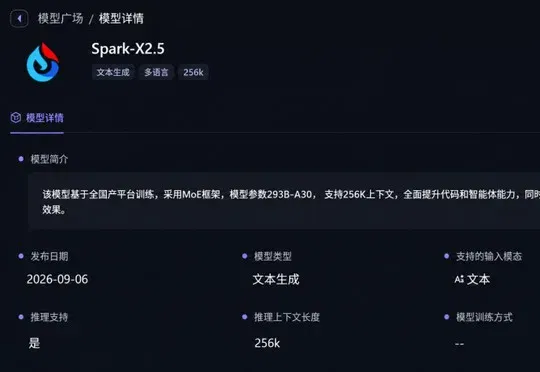
全国产算力训出2930亿参数!讯飞星火X2.5来了,附一手实测(在新窗口打开)
科大讯飞基于全国产算力发布2930亿参数的星火X2.5大模型,在代码、智能体、数学及理解等能力上有所提升,智东西通过游戏开发、3D创作、网页前端、数学推理和小说写作五项任务对其展开实测。
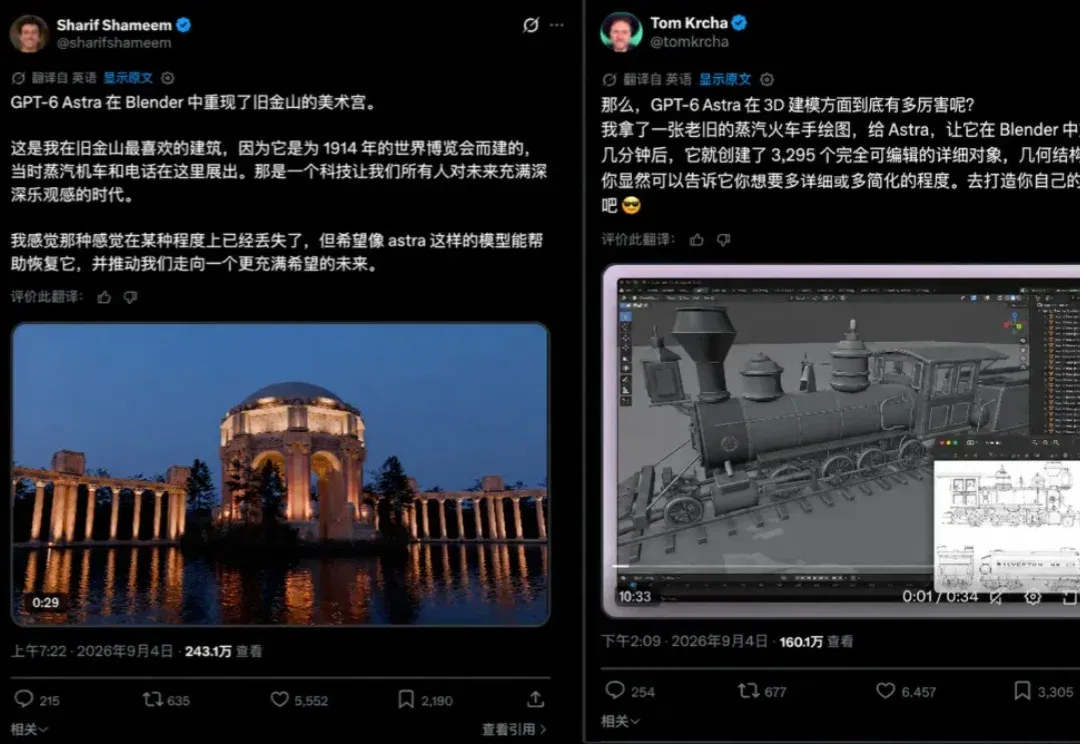
用GPT-6 Astra操控Blender玩3D,保姆级教程来了。(在新窗口打开)
Blender,可能就是这次GPT-6 Astra上线后的最大受益者。
老黄30亿美元押注穆拉蒂!估值冲到400亿,钱转一圈又买英伟达的卡(在新窗口打开)
这回,老黄把AI基建的触手,伸进了模型层。
马斯克杀入Copilot主场!Grok Bot接管微软账号,你睡觉它上班(在新窗口打开)
Grok Bot,能替你上班了。 9月1日,Grok Bot悄悄官宣了一条让科技圈炸锅的消息: Grok Bot现在可以直接接入你的微软账号,实现读取、写入和执行动作。 通过全新插件,你的AI助手能够直接连通Outlook、Calendar和OneDrive。 几小时后,马斯克转发,只配了一句话:Grok Bot已升级。 没有发布会,也没有演示视频。但这条帖子背后却是实打实的变化: 一个不下班的AI员工Grok Bot,正式拿到了你邮箱、日历和网盘的钥匙。它能替你发邮件、改会议,还能往OneDrive里传文件。 评论区很快热闹起来。 「Copilot慌了」「微软给马斯克开门了」,这类说法迅速刷
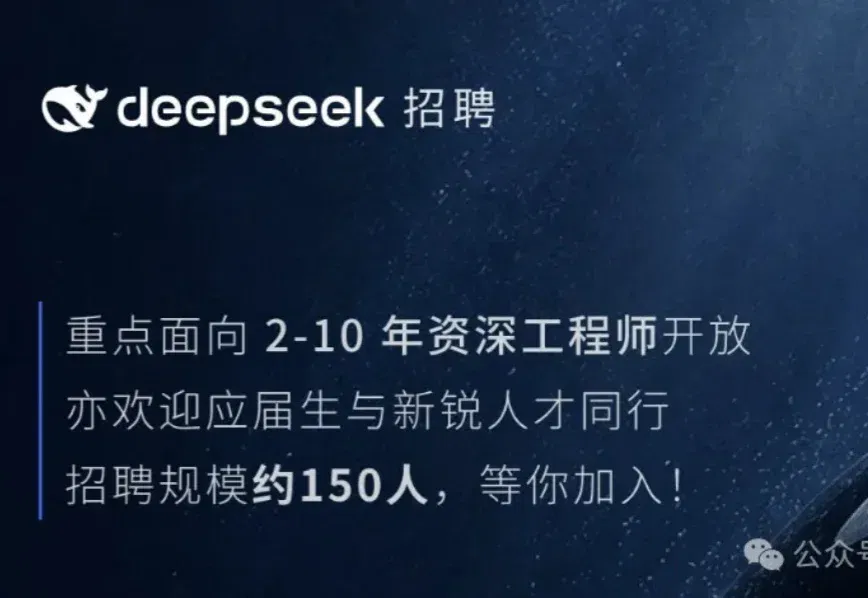
DeepSeek一口气扩招150人!0个AI研究岗(在新窗口打开)
DeepSeek,一口气扩招150人! 啥玩意他们总共也就才300-500人规模,这是要搞大动作啊。 而且这150个HC并非AI研究方向,全部集中到两个岗位:服务端开发工程师、Agent弹性计算研发工程师,重点面向2到10年经验的资深后端开发。 负责人崔添翼解释到,规模大了产生复杂度,复杂度又反过来要求扩大规模。 这是……团队人数的Scaling Law? DeepSeek弹性计算从论文走向大规模工程化 这次的Agent弹性计算研发工程师又分两个方向,平台开发和底层系统。 这个平台指为Agent量身定制的弹性计算平台DSec(DeepSeek Elastic Compute),在不久前发布的D
王云鹤创业后交出首个模型(在新窗口打开)
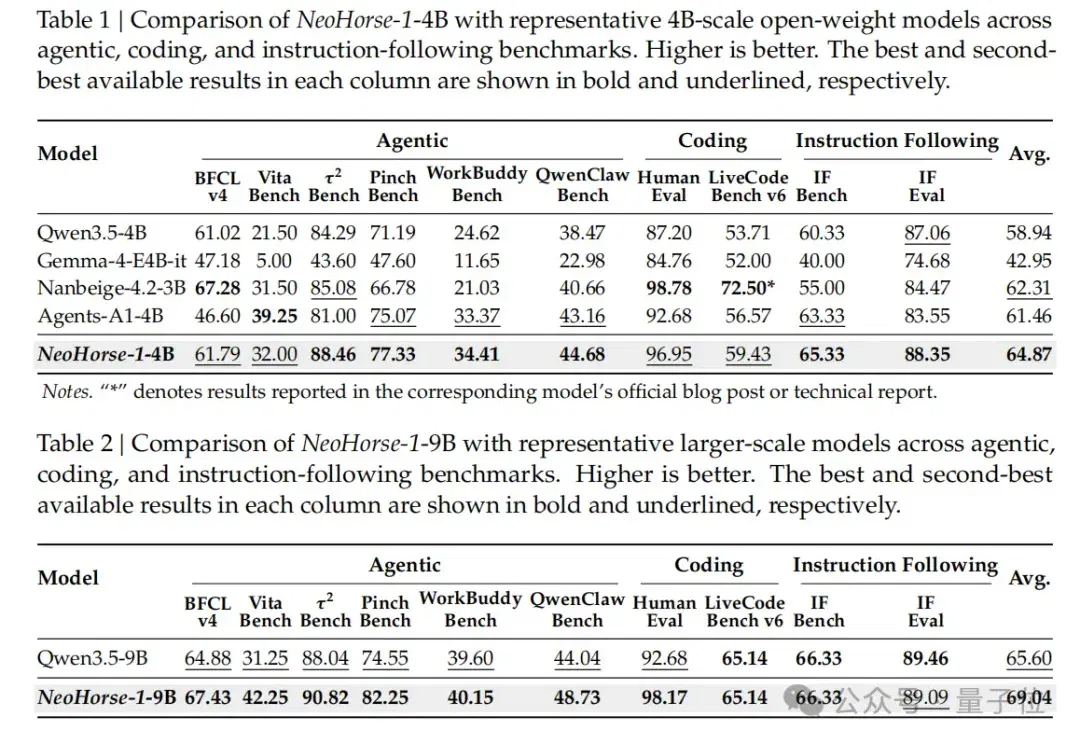
王云鹤创业后,首次交卷了大模型成果。 量子位获悉,华为诺亚方舟实验室前主任、盘古大模型负责人王云鹤创办的基元律动,发布首个Agent-Native模型NeoHorse。 该模型由无问芯穹提供底层基础设施支撑与Infra优化技术能力,清华大学、北京大学团队参与算法和训练方法研究,共同探索提升Agent后训练的数据利用效率和训练效果。 NeoHorse-1包含4B和9B两个版本,重点面向Agent工作过程中需要的一组能力,包括调用工具、读取环境反馈、发现错误、调整路径,并最终完成任务。 在覆盖Harness Agent、工具使用、代码和指令遵循等10项评测中,经过Agentic Post-Trai