Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
超DeepEP两倍!无问芯穹FUSCO以「空中变阵」突破MoE通信瓶颈,专为Agent爆发设计(在新窗口打开)
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
动态RAG性能提升14个点!用4万亿token教会大模型 「什么时候该检索」(在新窗口打开)
近日,来自伊利诺伊大学芝加哥分校、纽约大学、与蒙纳士大学的联合团队提出QuCo-RAG,首次跳出「从模型自己内部信号来评估不确定性」的思维定式,转而用预训练语料的客观统计来量化不确定性,
「视频世界模型」新突破:AI连续生成5分钟,画面也不崩(在新窗口打开)
围绕这一挑战,上海人工智能实验室联合复旦大学、南京大学、南洋理工大学 S-Lab 等单位提出了 LongVie 2—— 一个能够生成长达 5 分钟高保真、可控视频的世界模型框架。
DeepMind内部视角揭秘!Scaling Law没死,算力即一切(在新窗口打开)
2026年,Scaling Law是否还能继续玩下去?对于这个问题,一篇来自DeepMind华人研究员的万字长文在社交网络火了:Scaling Law没死!算力依然就是正义,AGI才刚刚上路。
7B扩散语言模型单样例1000+ tokens/s!上交大联合华为推出LoPA(在新窗口打开)
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
独家丨Kimi 完成 5 亿美元新融资,杨植麟:账上有超百亿元人民币(在新窗口打开)
独家获悉,月之暗面(Kimi)近期完成 5 亿美元 C 轮融资,IDG 领投 1.5 亿美元,阿里、腾讯、王慧文等老股东超额认购,投后估值 43 亿美元。据了解,王慧文已经累计投资月之暗面 7000 万美元。
MiniMax作价461亿港元募资46亿,1月9日敲钟代码00100(在新窗口打开)
MiniMax今起招股,作价461亿港元,拟募资超6亿美元。预计将于1月9日正式挂牌上市,代号00100。
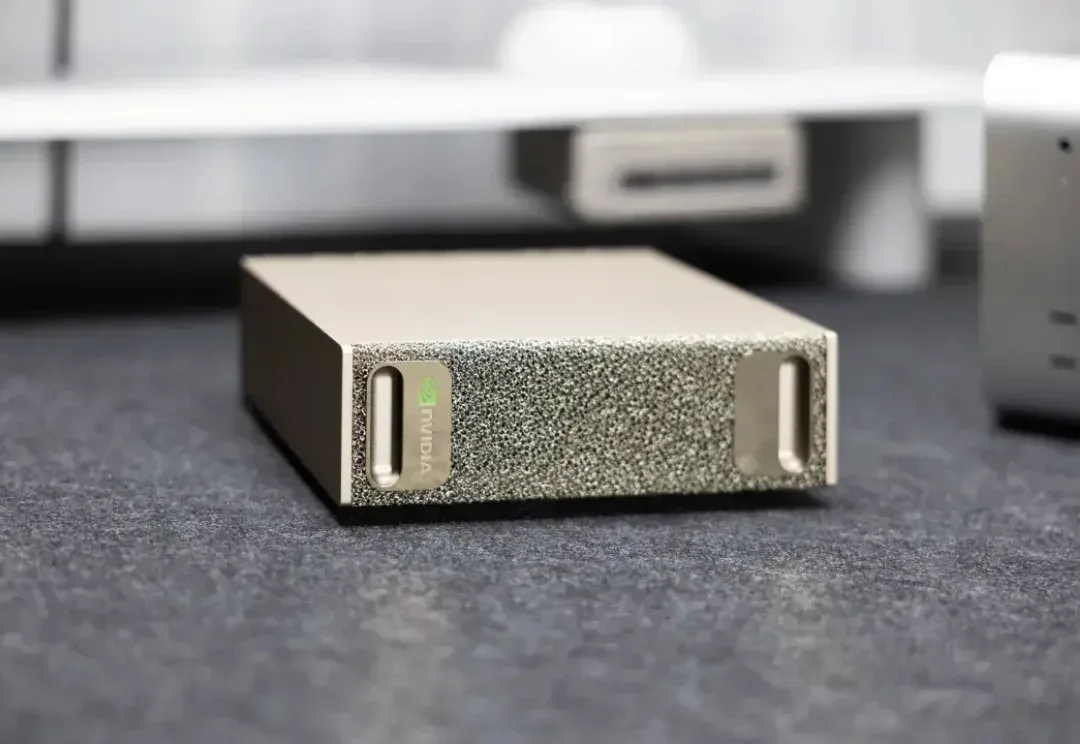
体验英伟达 AI 个人超算「核弹」DGX Spark,能微调出 DeepSeek R2 吗(在新窗口打开)
最近,APPSO 终于拿到了这台来自黄仁勋倾情推荐的个人超算,英伟达 DGX Spark;到手的第一感觉,就是「小而美」。这电脑也太小了,没有 Mac Studio 那般笨重,可能就和 Mac Mini 差不多大;然后是银色的亮和用来散热的金属丝网又让它有点不一样,是专属的硬核美感。
黄仁勋「收购式」抢人继续:20多亿美金“买走”Mobileye创始人AI新团队(在新窗口打开)
财大气粗的老黄,又要出手了!为了将200多位顶尖AI人才纳入麾下,英伟达被曝拟用20~30亿美金收购一家以色列AI初创公司。这家公司名为AI21 Labs,是以色列为数不多的自主研发大语言模型的公司,其联创还曾创办了明星自动驾驶公司Mobileye(Mobileye被收购后成了英特尔副总裁)。
硅谷夜不能寐!三家顶级实验室同时自曝:AI未经编程,涌现惊人能力(在新窗口打开)
硅谷三家实验室同时曝出:AI模型未经编程,就涌现出了绝对不该存在的全新能力!同时,Anthropic一位工程表示,自己的代码100%由Claude Code完成。空屋子里,已经出现脚印了?
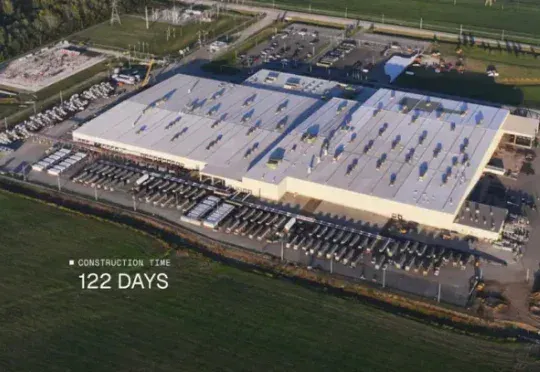
马斯克买了新厂房上GPU,2GW供电规模,“巨硬”更更硬了(在新窗口打开)
马斯克“巨硬计划”新消息,第三栋专属厂房已经买下来了,代号MACROHARDRR。果然更硬核,老马透露,其将具备2GW供电规模。若参照此前曝光的(200MW支持11万台GB200)的功耗密度与架构效率推算,可支持约110万台英伟达GB200 NVL72 GPU。
DeepSeek,居然只是个副项目?(在新窗口打开)
你知道吗,DeepSeekTwitter、Mac、Qwen,最初都只是副项目?真正改变世界的产品,可能根本不在公司的PPT路线图上。
有300亿美元也未必“再造GPT-4”?NUS尤洋最新长文:拆穿AI增长瓶颈的真相(在新窗口打开)
2026年将至,ChatGPT发布三周年,但关于“AI瓶颈期”的焦虑正达到顶峰。
腾讯持股,“大模型Data Agent第一股”上市了!市值140亿(在新窗口打开)
借势Agent浪潮,实时数据企业走上港股舞台。
Ilya警告、LeCun冷嘲、奥特曼沉默:Scaling Law时代还能走多远?(在新窗口打开)
过去10年,AI大模型的技术本质,是把电力能源通过计算过程转化为可复用的智能。2026年,我们需要让AI模型在单位时间内「吃下」更多能源,并真正将其转化为智能。
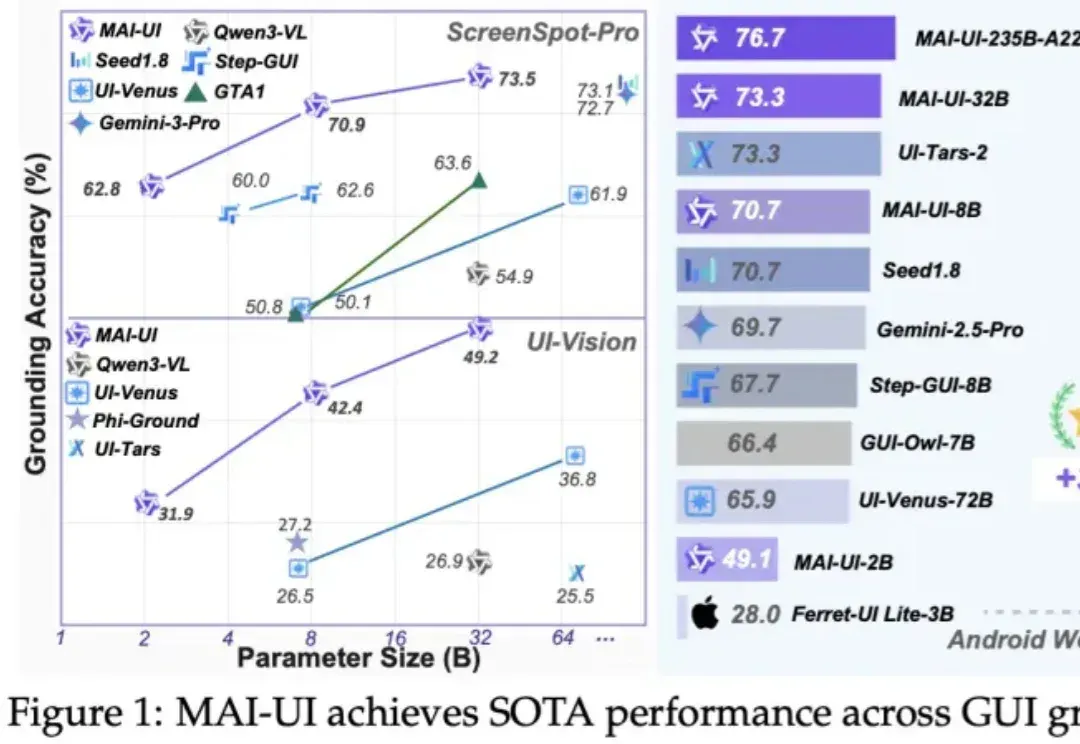
阿里开源AI手机的“灵魂”,GUI智能体2B到235B四个版本全,端云协同成功率暴涨33%(在新窗口打开)
AI手机的“灵魂”GUI智能体,就这么全套开源了。
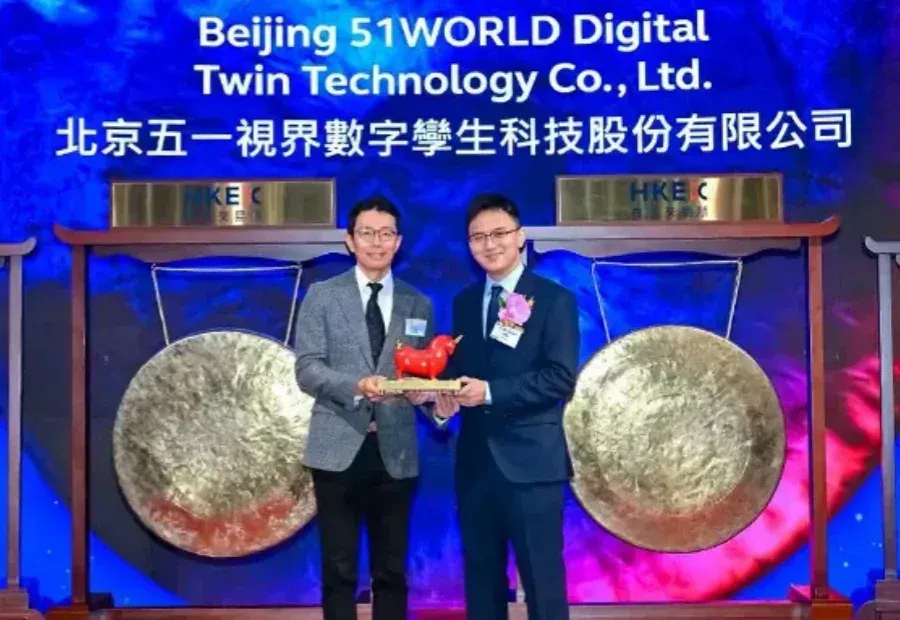
北京冲出“物理AI第一股”!市值153亿,摩尔线程参投(在新窗口打开)
数字孪生行业首家年收入超2.50亿港元的公司。
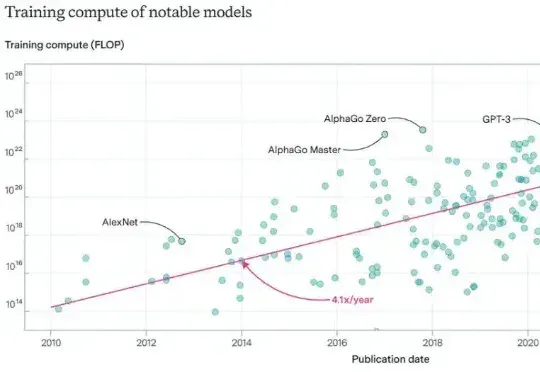
NUS尤洋教授深度探讨智能增长的瓶颈:或许我们将这样实现AGI?(在新窗口打开)
新加坡国立大学(NUS)的尤洋教授近期发表了一篇深度分析:《智能增长的瓶颈》。在这篇分析文章中,尤洋教授从技术本质出发,直指智能增长的核心矛盾,为我们揭示了 AGI(通用人工智能)的可能路径。
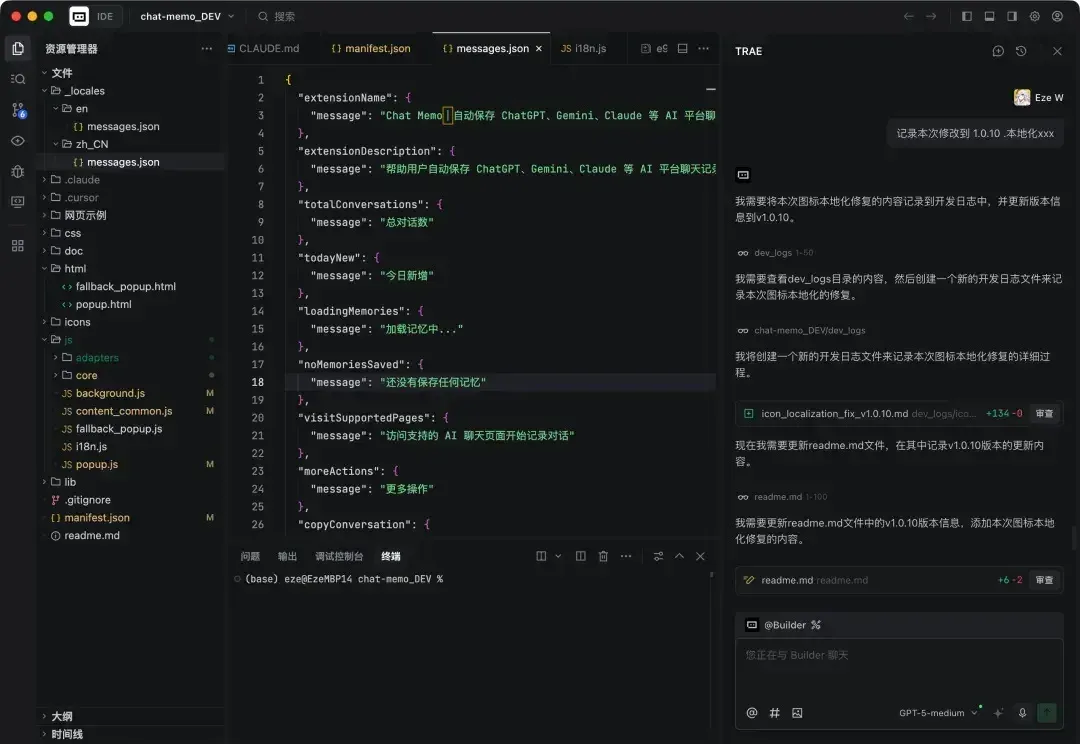
2026 刚开始 AI Coding,应该怎么选工具?|Trae 开发者报告解析(在新窗口打开)
很多人可能不知道,我是 Trae 的老用户。
用Antigravity组建最强开发团队:Opus 4.5 + GPT-5.1-Codex-Max + Gemini 3 Pro(在新窗口打开)
大家好,我是鲁工。 上周发布了一篇关于如何在Antigravity中组合Claude Opus 4.5和Gemini 3 Pro进行交叉验证的文章,读者反馈不错。