Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
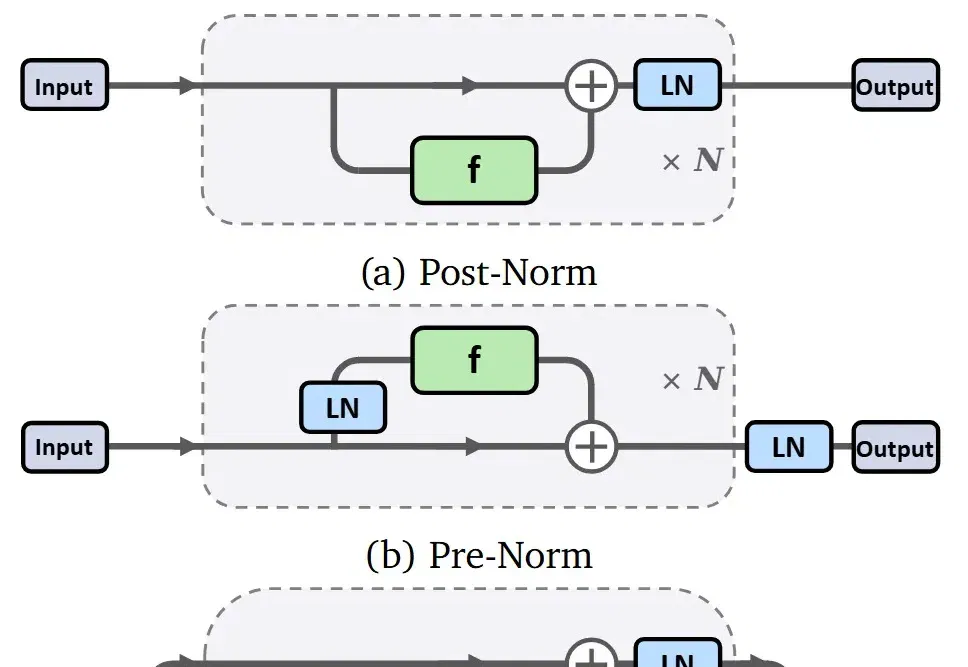
清华联手千问重塑归一化范式,让 Transformer 回归「深度」学习(在新窗口打开)
在十九世纪的暹罗王国曾诞生过这样一对连体兄弟:他们分别拥有完整的四肢和独立的大脑,但他们六十余年的人生被腰部相连着的一段不到十厘米的组织带永远绑定在了一起。他们的连体曾带来无尽的束缚,直到他们离开暹罗,走上马戏团的舞台。十年间,两兄弟以近乎合二为一的默契巡演欧美,获得巨大成功。
头部互联网大厂领投,「临界点」再获数亿元融资(在新窗口打开)
「临界点」在2025年已卖了数千只灵巧手。
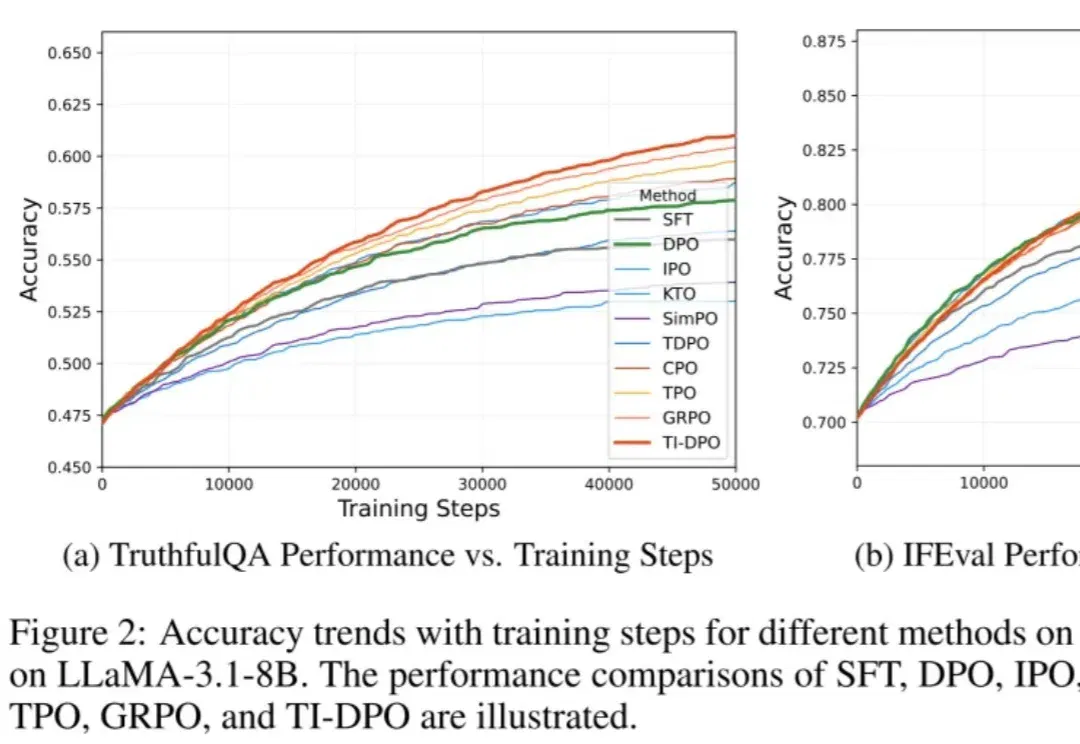
ICLR 2026 Oral | DPO「只看总分不看细节」?TI-DPO用Token重要性重塑大模型对齐(在新窗口打开)
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
来一手Qwen-Image-2.0实测,好像还不错?!(在新窗口打开)
BUBBLE 2026 — ISSUE #18 家人们, 马上没几天快过年了,明显各个厂商已经开始疯狂卷了。 上周到现在,让我们来算算有多少东西了, 5.3 Codex,4.6 Opus, 可灵3.0
Seedance 2.0让字节元神启动(在新窗口打开)
Seedance 2.0用了两天,个人感想是,以下几类人群或即将失业:一、把「学好提示词」奉为圭臬,并开班传授佶屈聱牙反逻辑长难句prompt的AI导师。二、成本只有一个自拍杆的所谓短视频博主。三、刚开始做AI社交的小创业者。
OpenClaw 让 Mac Mini 卖爆了,苹果为什么不自己做一个?(在新窗口打开)
谁能想到,2026 年第一款热销设备,是被 OpenClaw 带飞的 Mac Mini——一个 一直以来在苹果产品序列里,都不温不火的存在,就这样硬生生地被拉了起来。
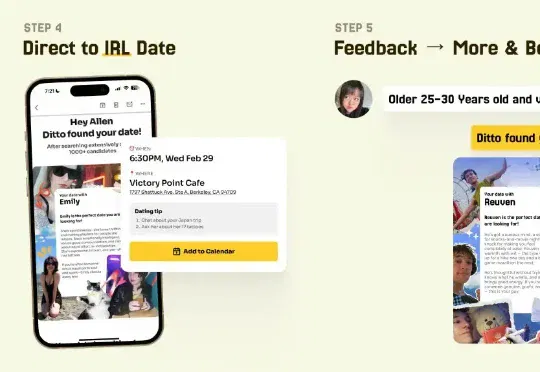
Ditto融资920万美金,让AI帮你安排约会,做AI时代的Facebook(在新窗口打开)
当我深入了解Ditto的运作方式后,我发现这不仅仅是一个新的约会服务,而是对整个约会行业商业模式的根本性挑战。传统约会App的商业逻辑是让你尽可能长时间地停留在App上,因为这样才能产生更多广告收入和会员订阅。
AI产品用户留存仅三个月周期?对话王咏刚:“不和AI协作过项目,你就不是合格程序员” | 万有引力(在新窗口打开)
从写代码、调模型,到生成内容、驱动产品,AI 正在重新塑造“创造”的方式,也不断逼近一个绕不开的问题:当机器越来越能干,程序员究竟该站在什么位置?
破案了,Pony Alpha中国制造,小龙逆袭AI Coding(在新窗口打开)
这两天,一款名为Pony Alpha的模型,凭借在Coding能力上的出色表现,一时间成为了AI圈内最火爆的名字。
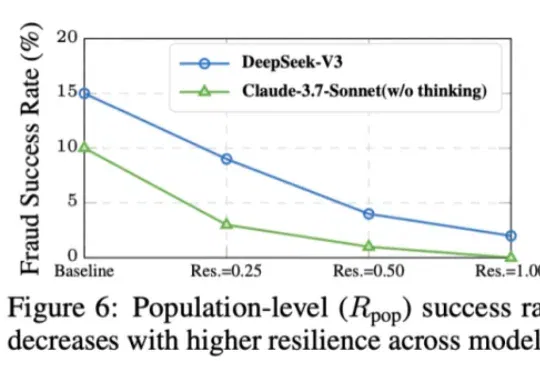
ICLR 2026 | 在Moltbook之外,上交大联合上海AI Lab模拟了AI原⽣社交的「真实暗⾯」(在新窗口打开)
本⽂的主要作者来⾃上海交通⼤学和上海⼈⼯智能实验室,核⼼贡献者包括任麒冰、郑志杰、郭嘉轩,指导⽼师为⻢利庄⽼师和邵婧⽼师,研究⽅向为安全可控⼤模型和智能体。 最近,Moltbook 的爆⽕与随后的迅速
海外顶级风投a16z关于AI市场的最新深度分析(在新窗口打开)
软件行业可能正在经历一场比从命令行到图形界面更剧烈的变革?最近听了一场 a16z 的 David George 分享的关于 AI 市场的深度分析,我被一组数据震撼到了:最快增长的 AI 公司正在以 693% 的年增长率扩张,而他们在销售和营销上的支出却远低于传统软件公司。

小众架构赢麻了!通过编辑功能 LLaDA2.1 让100B扩散模型飙出892 tokens/秒的速度!(在新窗口打开)
谁能想到啊,在自回归模型(Autoregressive,AR)当道的现在,一个非主流架构的模型突然杀了回马枪——被长期视为学术玩具的扩散语言模型,直接在复杂编程任务中飙出了892 tokens/秒的速度!
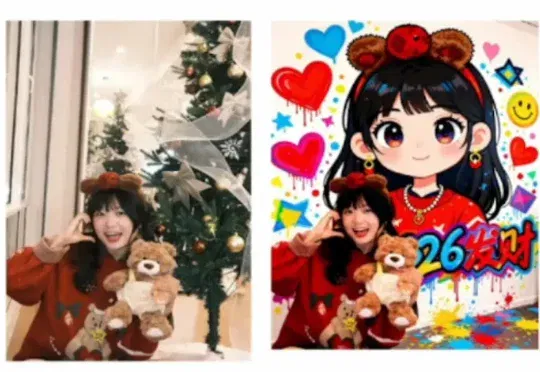
字节发完阿里发!Qwen-Image 2.0火线出击(在新窗口打开)
今天,阿里巴巴发布了新一代图像生成基础模型Qwen-Image 2.0,这一模型支持长达一千个token的超长指令、2k分辨率,并采用了更轻量的模型架构,模型尺寸远小于Qwen-Image 2.0的20B,带来更快的推理速度。
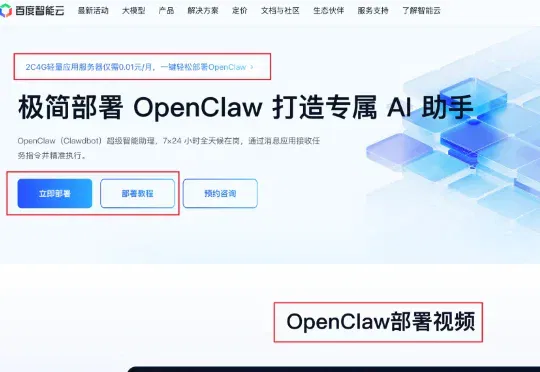
OpenClaw白嫖云部署!附自定义模型API和4种Skills神级用法~(在新窗口打开)
大家好,我是袋鼠帝。最近这两周,我的X(推特)和各种群都被刷屏了。作为一名一直在折腾 AI Agent 的博主,我当然坐不住。这几天我抽空疯狂研究OpenClaw,又是买服务器,又是配环境,把OpenClaw的多种玩法撸了一遍。
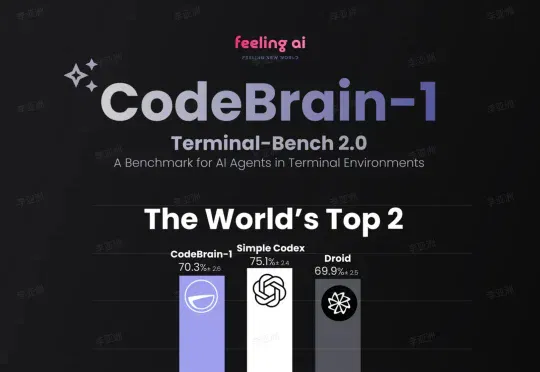
比肩OpenAI Simple Codex,中国团队Feeling AI闯入Terminal-Bench全球第二!(在新窗口打开)
就在这个被 Anthropic 和 OpenAI 视为衡量 Agent 真实工程能力全球权威基准 Terminal-Bench 2.0 榜单上,中国团队 Feeling AI 凭借 CodeBrain-1,搭载最新 GPT-5.3-Codex 底座模型,一举冲到 72.9%(70.3%) 并跻身全球排行榜第二,成为榜单前 10 中唯一的中国团队。
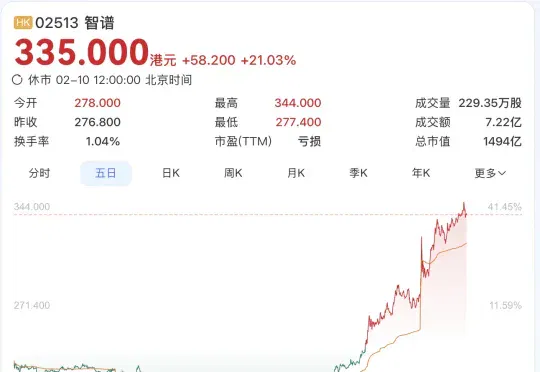
GLM-5架构曝光,智谱两日涨60%:采用DeepSeek同款稀疏注意力(在新窗口打开)
不管Pony Alpha是不是智谱的,下一代旗舰大模型GLM-5都要来了。GLM-5采用了DeepSeek-V3/V3.2架构,包括稀疏注意力机制(DSA)和多Token预测(MTP),总参数量745B,是上一代GLM-4.7的2倍。
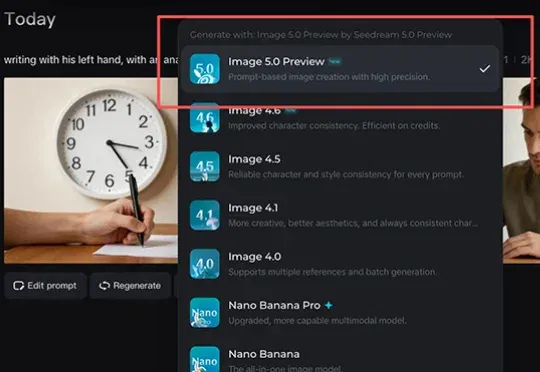
刚刚,Seedream 5.0上线!字节又一新模型(在新窗口打开)
新模型对标Nano Banana Pro,能免费体验。Seedance 2.0的热度还没下去,字节新模型又来了!今日,字节图像生成模型Seedream 5.0 Preview在视频编辑应用剪映、剪映海外版Capcut、字节AI创作平台小云雀均已上线,在即梦AI平台开启灰度测试,图片生成可限时免费体验。
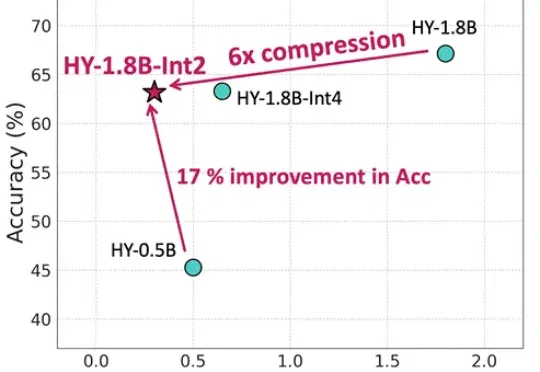
0.3B参数,600MB内存!腾讯混元实现产业级2Bit量化,端侧模型小如手机App(在新窗口打开)
等效参数量仅0.3B,内存占用仅600MB,更适合端侧部署还带思维链的模型来了。腾讯混元最新推出面向消费级硬件场景的“极小”模型HY-1.8B-2Bit,体量甚至比常用的一些手机应用还小。
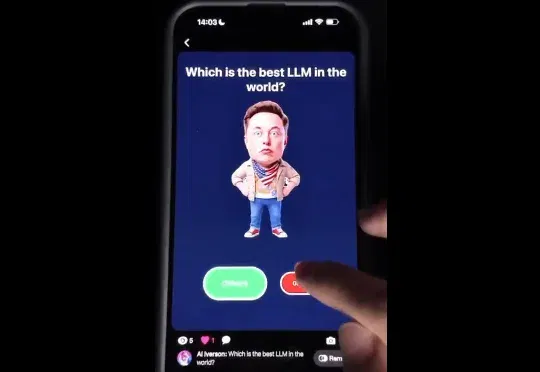
马斯克转帖,发现了一个有趣的中国 AI 初创产品!(在新窗口打开)
晚上躺床上在刷资讯的时候,发现马斯克转帖并表态了一个搞怪视频。大致意思就是,让你选世界上最好的模型是什么?Grok 还是 Others,然后一直点不到 Grok,按钮越来越小。点到之后,马斯克开始跳舞。
Seedance 2.0:AI 视频第一阶段的比赛,结束了|AI 上新(在新窗口打开)
这两天,AI 视频圈被偷摸摸上线的 Seedance 2.0 刷屏了。在 AI 视频领域颇有影响力的博主海辛,在即刻分享了自己对它的观点:「Seedance 2.0 是我 26 年来最大的震撼」、「我觉得它碾压 Sora2」。