Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
当 AI,开始设计 AI(在新窗口打开)
这不是科幻片,而是 2026 年 2 月刚刚发生的现实。
GLM-5深夜登场,这是国产开源模型首次逼平Claude Opus 4.5。(在新窗口打开)
深夜,GLM-5来了。 还是老样子,发布即开源。 而且前几天,OpenRouter平台不是有一个Pony Alpha的匿名模型很火吗。 大家一度在猜是DeepSeek V4还是GLM-5,结果今天基本答案也揭晓了。 这大马,基本就是明示了。 到了今天,2026年的主旋律我觉得真的就已经就定下了,无论是国内还是海外。 Coding与视频齐飞,人类共AI一色。 这应该就是2026年AI领域最核心的两个主航道了,在这两之上,其实就是Agent。 这几天真的感觉过年一样,太热闹了,上周GPT-5.3 codex和Claude Opus 4.6中门对狙,后脚Seedance 2.0席卷全球,而现在,战场
一手实测Loopit,华人打造的“可以玩的抖音”,重新定义AI时代的内容(在新窗口打开)
有时候,一个产品的爆火来得比想象中快的多。
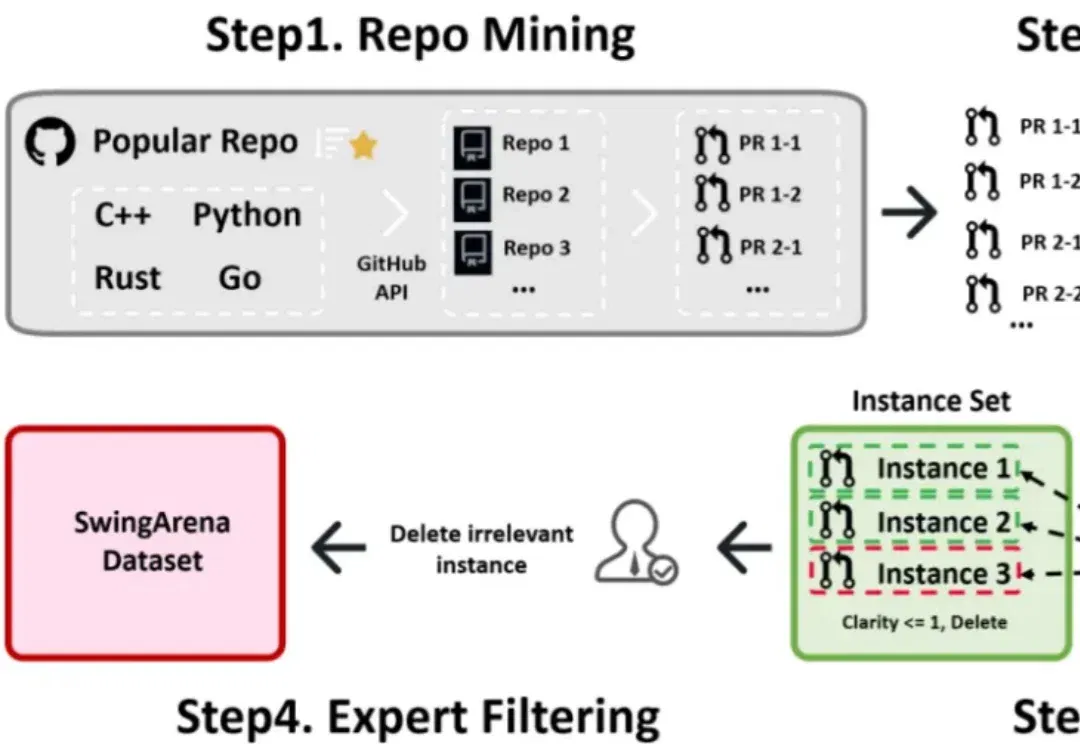
ICLR 2026 oral | AI代码真能进生产环境?SwingArena:从「写对代码Commit」到「通过CI审查」(在新窗口打开)
过去一年,大模型写代码的能力几乎以肉眼可见的速度提升。从简单脚本到完整功能模块,GPT、Claude、DeepSeek 等模型已经能够在几秒钟内生成看起来相当 “专业” 的代码。
93k星Github项目狠人!谷歌高级AI产品经理公开内部构建Agent心得:过去十年技能衡量标准已毫无价值!2026最优秀的开发者更像是导演(在新窗口打开)
刚刚,谷歌的一位狠人公开了自己AI产品开发心得!
免费注册就能用Claude Code和龙虾Moltbook,内置17万Skills,小白再也不用折腾了!(在新窗口打开)
上周四去著名科技媒体品牌《硅星人》交流。
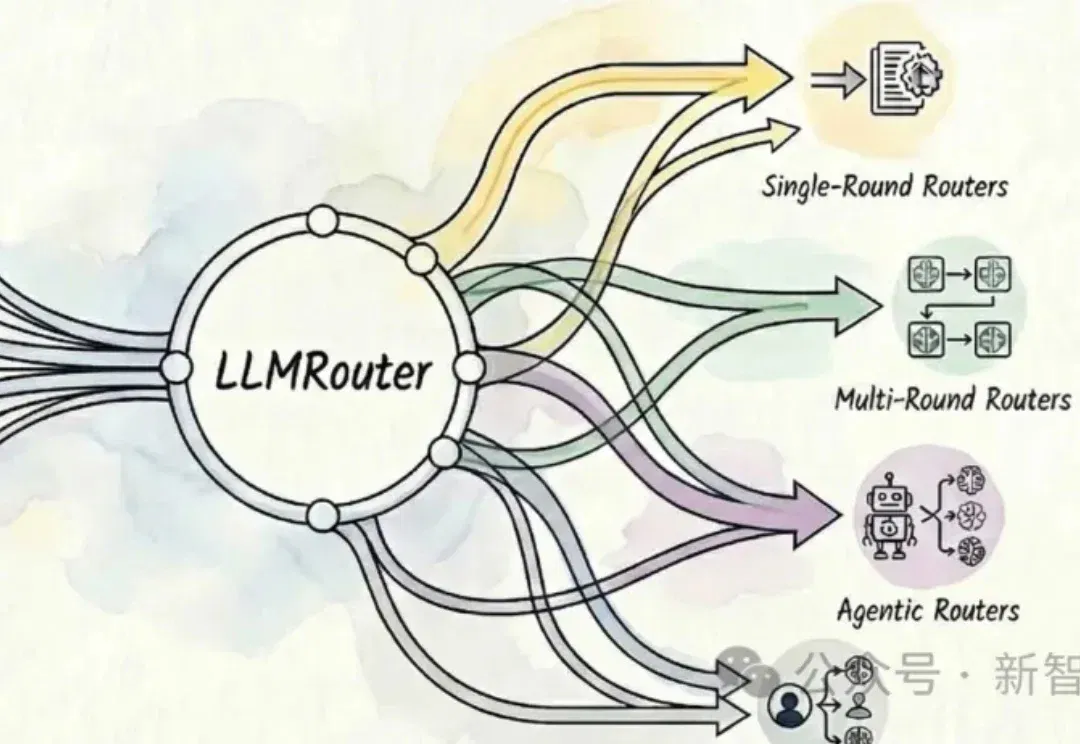
千星项目LLMRouter:多模型路由,16+策略优化推理(在新窗口打开)
UIUC开源的智能模型路由框架LLMRouter可以自动为大模型应用选择最优模型,提供16+路由策略,覆盖单轮选择、多轮协作、个性化偏好和Agent式流程,在性能、成本与延迟间灵活权衡。
开源界的 Opus 时刻:GLM-5 能否接住 Agentic Coding 的接力棒?(在新窗口打开)
开源模型同样能承担复杂工程任务。 如果你问一个开发者,AI 编程最让人崩溃的时刻是什么? 他给你的答案很可能会是它在报错面前那句机械的「对不起,我理解错了」,然后复读一段同样错误的代码。 过去一年,Coding 大模型的进步,更多体现在「生成能力」上:一句话生成网页、组件、小游戏——15 秒内搓出一个像素风网页、一个炫酷的 SVG 图标,或者一个能跑的贪吃蛇。这些 Demo 足够惊艳,但也足够「轻」,它们有点像是在 Vibe Coding(氛围感编程)时代产出的高级玩具。但当涉及到高并发架构、底层驱动适配或者复杂的系统重构,它们就成了「温室里的花朵」。 所以最近,硅谷的风向已经变了。 不管是
智谱开源OCR!测完我把手机里的扫描软件都卸了......(在新窗口打开)
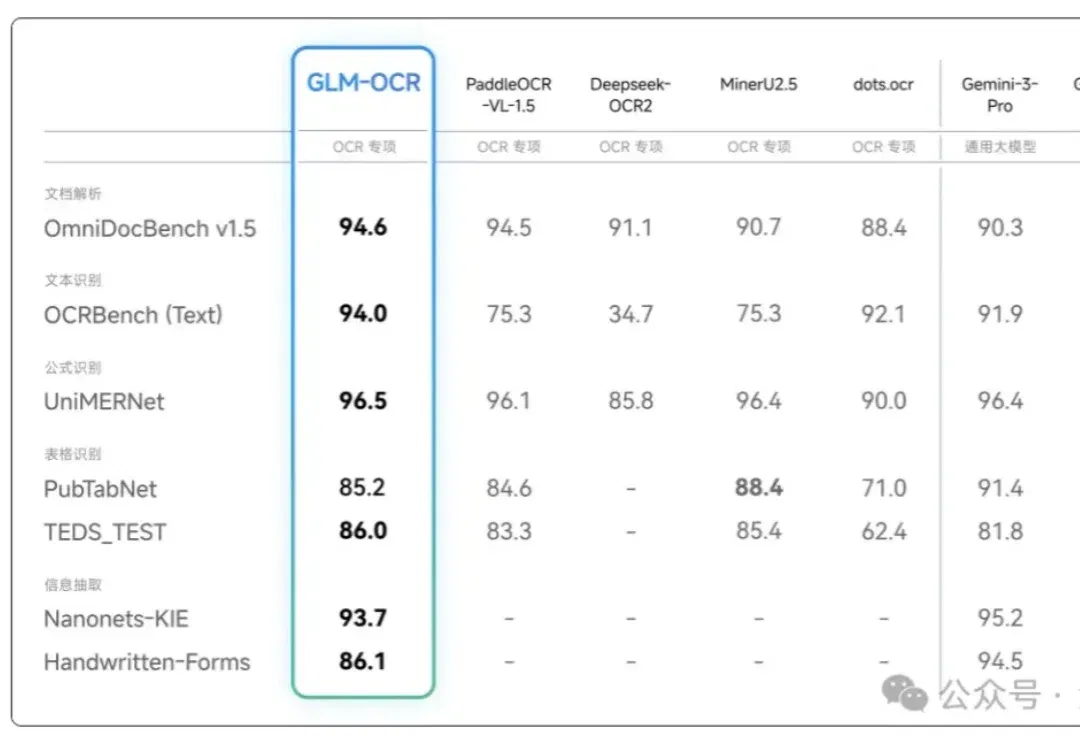
OCR模型究竟能干什么?干得怎么样? 2025年末2026年年初,科技圈最卷的技术无疑就是——O!C!R! 这不,就在前两天,智谱也下场整活儿了,发布了自家的「GLM-OCR」开源模型~ 别看参数就0.9B,在OmniDocBench V1.5榜单上可是一通乱杀。 拳打Gemini-3-Pro!脚踢GPT5.2!(开玩笑 在手写体、代码文档、印章识别、跨单元格等场景的性能表现直通SOTA: 这两天处于工作的原因,我也深度上手使用了GLM-OCR一番,这波用下来的感受是: 在日常基础文档解析场景里用起来确实爽爽爽! but,涉及到字迹不清晰或复杂排版的信息时,翻车现象还是有的…… 顺带,帮友友们
神仙打架+1!讯飞星火X2硬核亮相,行业深度全面升级(在新窗口打开)
今天,国产大模型再次迎来硬核进阶! 科大讯飞小年放出推理王炸——星火大模型X2。 什么概念呢?从星火X1.5到星火X2,仅仅间隔3个月,推理性能直接飙升50%~ 不仅快,而且猛。更重要的是,完全基于国产算力。 一方面,模型通用能力突出,Benchmark评测稳居行业一流水平,即使是和GPT-5.2、Gemini-3-Pro这些国际顶尖模型同台竞技也毫不逊色。 尤其是在数学计算、逻辑推理等核心能力上表现亮眼;同时130多种语言综合能力依旧稳稳在线,继续保持“国家队”水准。 另一方面,星火X2将升级的重点放在了场景落地上。 依靠深度优化的算法、高质量垂域数据和行业专家的参与,三位一体推动行业大模型
刚刚,DeepSeek悄悄测试新模型:百万token上下文、知识库更新,V4要来了?(在新窗口打开)
春节假期还没到,DeepSeek 就先把礼物拆了一半。
当业界热议Seedance的“导演感”时,Vidu已登顶全球第一|甲子光年(在新窗口打开)
解析Vidu Q3:AI视频生成下半场,拼的是“可交付”。
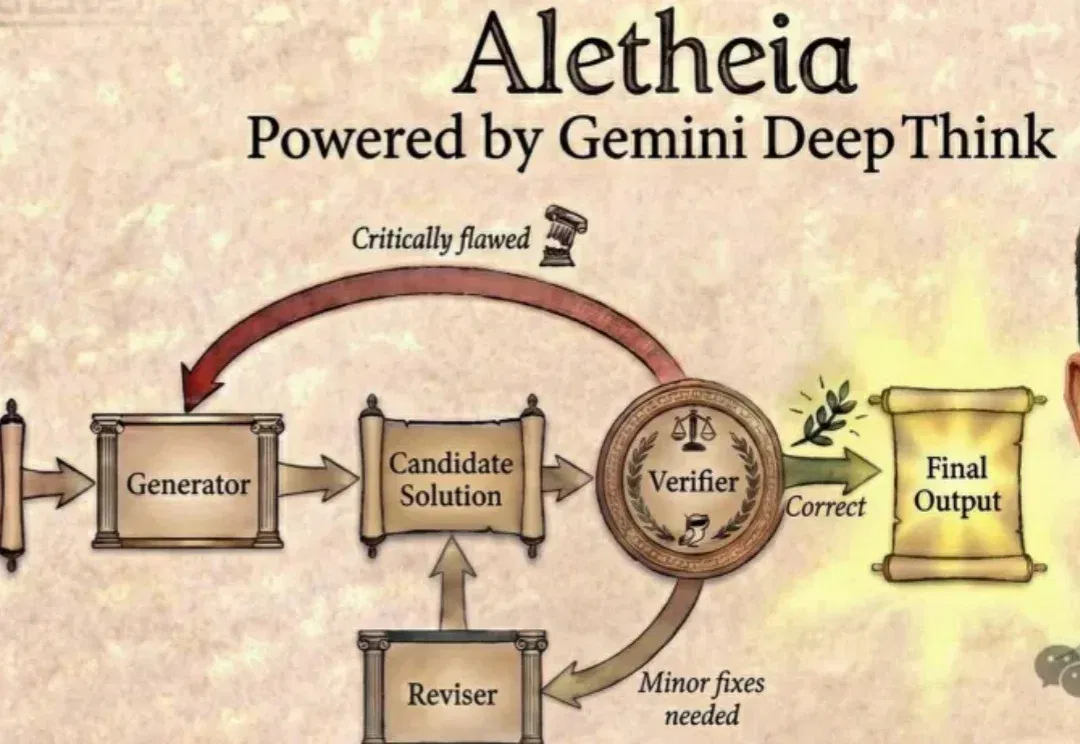
谷歌AI连发6篇数学论文!Gemini攻入博士级科研,91.9%刷爆SOTA(在新窗口打开)
今天,谷歌DeepMind「AI数学家」Aletheia彻底杀疯了,攻克数学猜想,独立写论文。更令人震惊的是,拿下金牌的Gemini一举横扫18大核心科研难题。
深度|AI教母李飞飞最新访谈:AI的下一个前沿不是语言,而是空间智能(在新窗口打开)
李飞飞博士,感谢你接受《Fortt Knox》和CNBC的访谈,也感谢你抽出时间。人们称你为“AI教母”,因为你在塑造今天商业世界正在进入的这一现实中,做了大量奠基性的工作。事情的发展,和你当初预想的一样吗?
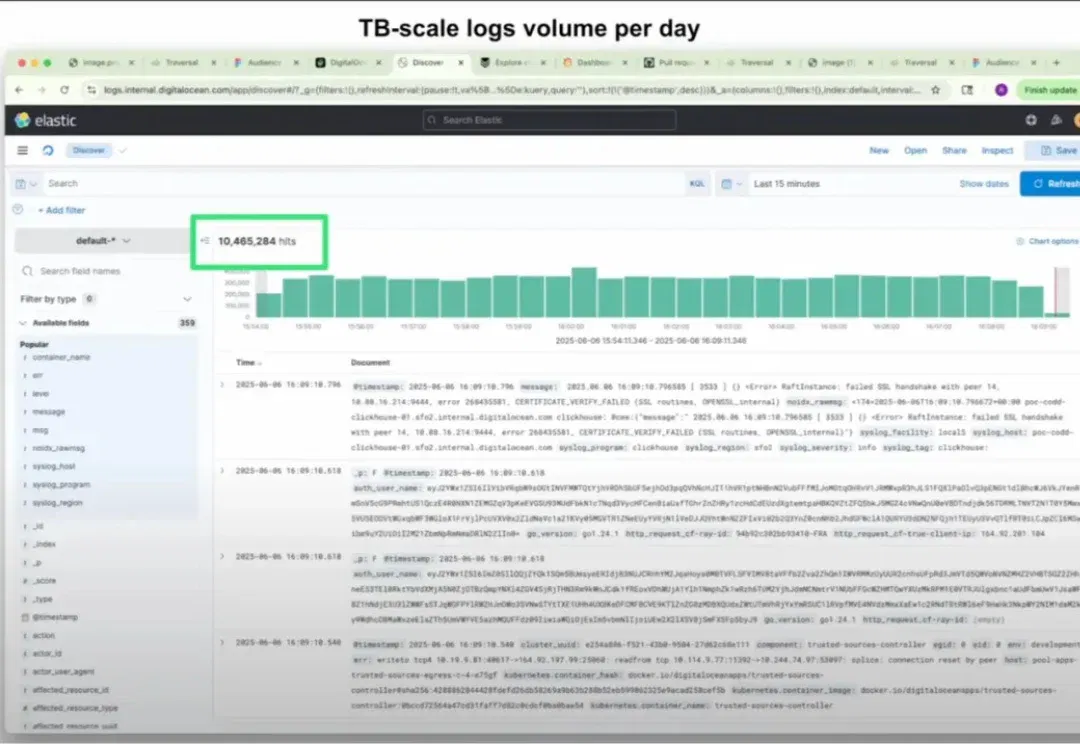
当人读不懂 AI 代码,Traversal 如何做企业运维的 AI 医生?(在新窗口打开)
代码运维一直是开发者的痛点,AI Coding 的飞速进步放大了运维难度:Claude Code 贡献的代码 push 已经占到了公开 Github 的 4%,但 AI 写的系统逻辑会有人类很难捕捉的问题,开发者将其称为“Claude Hole”现象。
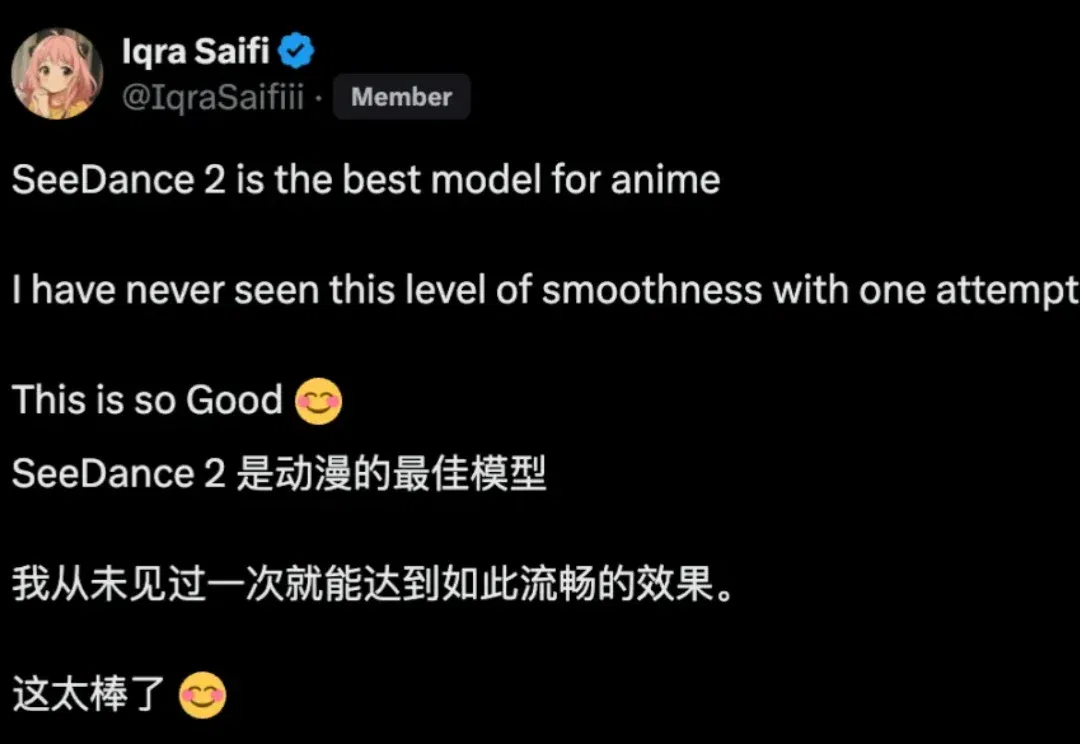
实测即梦 Seedance 2.0:老外急着想注册,这就是中国 AI 视频的「黑神话」时刻(在新窗口打开)
「来自中国的 Seedance 2.0 将成为最先进的技术。」
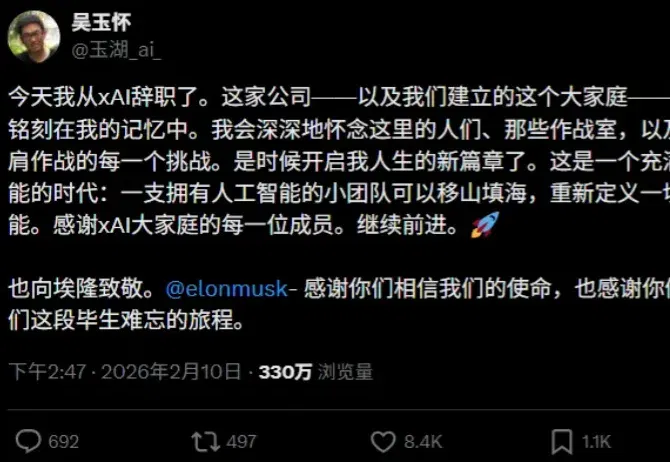
创始团队出走一半,马斯克连夜调整xAI愿景,用百万GPU追平推理短板(在新窗口打开)
当地时间 2 月 10 日和 11 日,xAI 的联合创始人 Tony Wu 和 Jimmy Ba 先后在社交平台 X 上宣布离职,这是继 Igor Babuschkin、Christian Szegedy 等人之后,xAI 创始团队在不到三年内的又一次核心人员变动。截至目前,xAI 最初 12 人的创始团队中已有六位成员离开。
9B端侧开源模型跑通百万上下文,面壁全新稀疏-线性混合注意力架构SALA立功了!(在新窗口打开)
最强的大模型,已经把scaling卷到了一个新维度:百万级上下文。
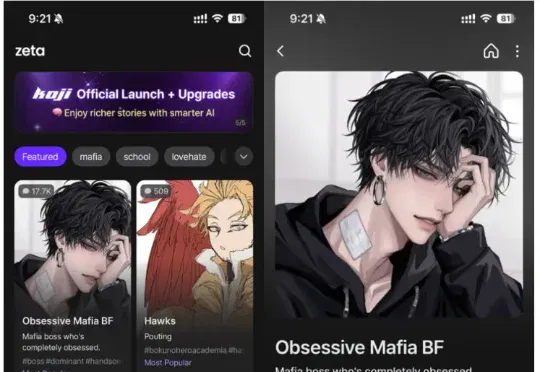
韩国AI社交升温?3款产品月流水达百万美元(在新窗口打开)
最近《新京报》曝光的“国内首起 AI 服务提供者涉黄获刑案件”,为明显降温的国内 AI 社交市场又蒙上了一层阴霾。但隔壁的韩国市场似乎呈现了一种全然不同的面貌。
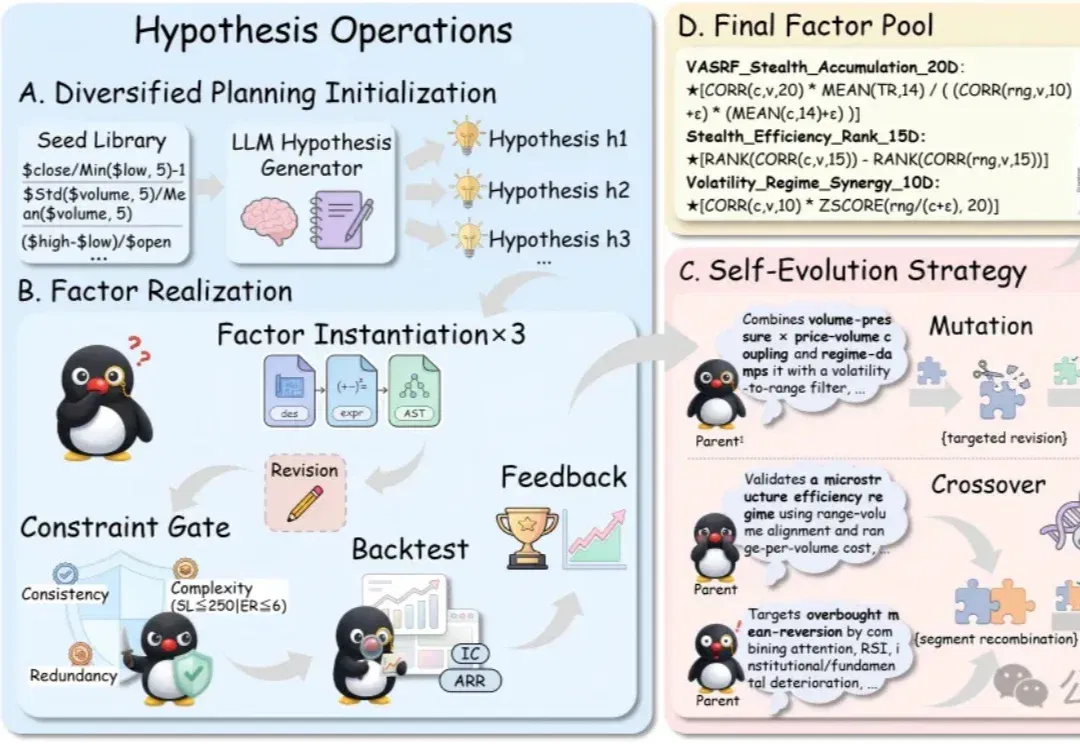
这个AI炒股年化收益27.75%!用自进化Agent挖掘穿越牛熊的量化因子(在新窗口打开)
在量化金融的底层,Alpha因子本质上是一段可执行的代码逻辑,它们试图将嘈杂的市场数据映射为精准的交易信号。