Know AI. See What’s Next.
第 1 张,共 5 张:当年「字节投毒实习生」田柯宇,估值 2 亿美元,要挑战李飞飞做世界模型
最新资讯流
速递|Agnes完成数千万美元融资,自研Agnes-Claw模型登榜,1美元即可“养龙虾”(在新窗口打开)
Agnes AI近日披露了一组新的业务数据:全球用户规模已突破700万,年度经常性收入(ARR)接近2000万美元,并于去年底完成千万美元级融资。据公司方面透露,Agnes目前正在推进新一轮融资,目标估值约2亿美元,以持续投入核心技术研发并推动全球市场扩展。
刚刚,MiniMax直接让龙虾学会自我进化,也认识「马嘉祺」了(在新窗口打开)
谁能料到,OpenClaw 的热度从年初延续到了今天。除了专业工程师,很多普通人也在 FOMO(错失恐惧)情绪驱动下,开始了对「养龙虾」的追捧。
你的电脑已被手机接管!Anthropic亮出Dispatch:AI 24小时给你代工(在新窗口打开)
Anthropic发布Cowork新功能Dispatch,用手机即可远程指挥Mac上的Claude执行任务。MacStories实测成功率约50%,但AI Agent从「坐在电脑前用」到「随时随地遥控」的关键一步,已经迈出。
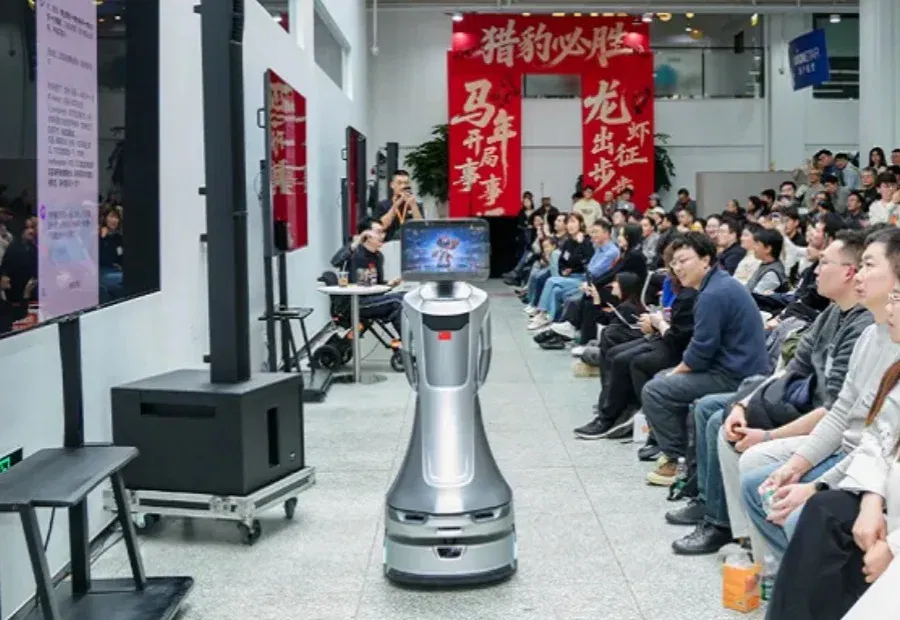
龙虾登陆机器人!全程零彩排,傅盛是怎么搞定的?(在新窗口打开)
EasyClaw+机器人会长成什么样子?这场活动让我们看到了雏形。
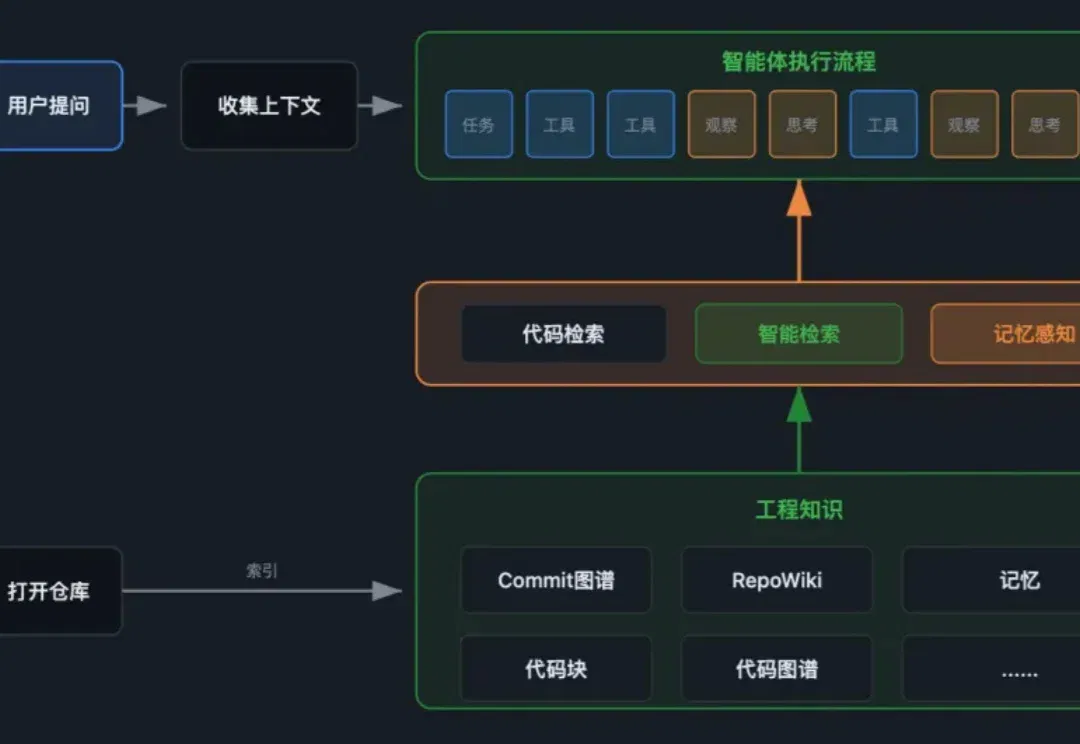
工程知识引擎:Harness Engineering体系下的工程知识底座(在新窗口打开)
在AI编程智能体快速演进的今天,一个核心痛点愈发凸显:AI能写代码,却难以理解代码。更深层的问题是:即便模型能力再强,若缺乏结构化的工程约束与上下文支撑,智能体也难以稳定、可预期地完成真实工程任务。
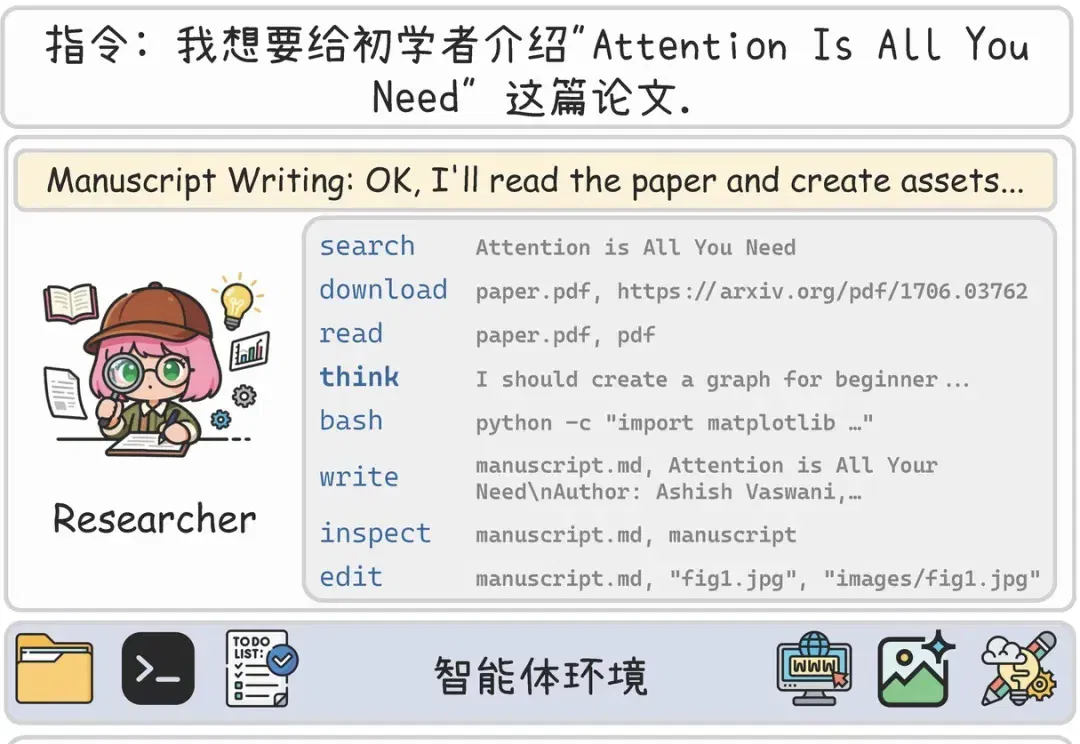
第二代PPTAgent来了!中科院软件所开源首个本地通用幻灯片智能体,9B参数打平GPT-5(在新窗口打开)
天下苦 PPT 久矣。 体验过市面上各种 AI 生成 PPT 工具的人,往往都会遇到同样的痛点:排版崩坏、内容空洞、经不起推敲。 为什么会这样?因为目前的通用大语言模型(LLM)写 PPT,本质上是在对话框里 “盲写” 代码或文本。它们既没有真正的 “手” 去查阅权威文献,也没有真正的 “眼睛” 去审视自己排版出来的最终效果。 近日,中国科学院软件研究所中文信息处理实验室开源了第二代 PPTAgent -- DeepPresenter。这是业界首次将幻灯片智能体模型与完整的智能体沙箱环境一同开源,更能支持在单张 3090/MAC 上一键部署。它彻底重构了 AI 制作 PPT 的逻辑,让智能体不
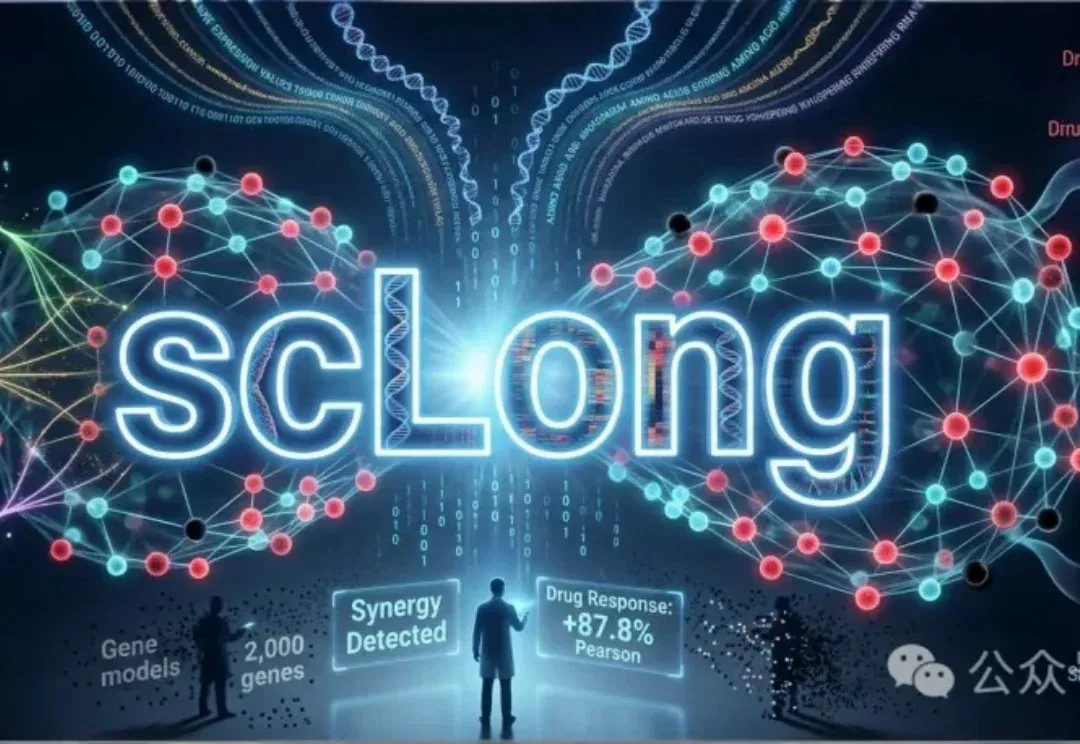
当AI第一次读完整本基因之书,十亿参数单细胞大模型能干什么?(在新窗口打开)
十亿参数单细胞基础模型scLong不再只看少数高表达基因,而是把一个细胞里接近 2.8 万个基因 都纳入建模,并结合 Gene Ontology(GO) 的生物学知识,去理解更完整的基因上下文。
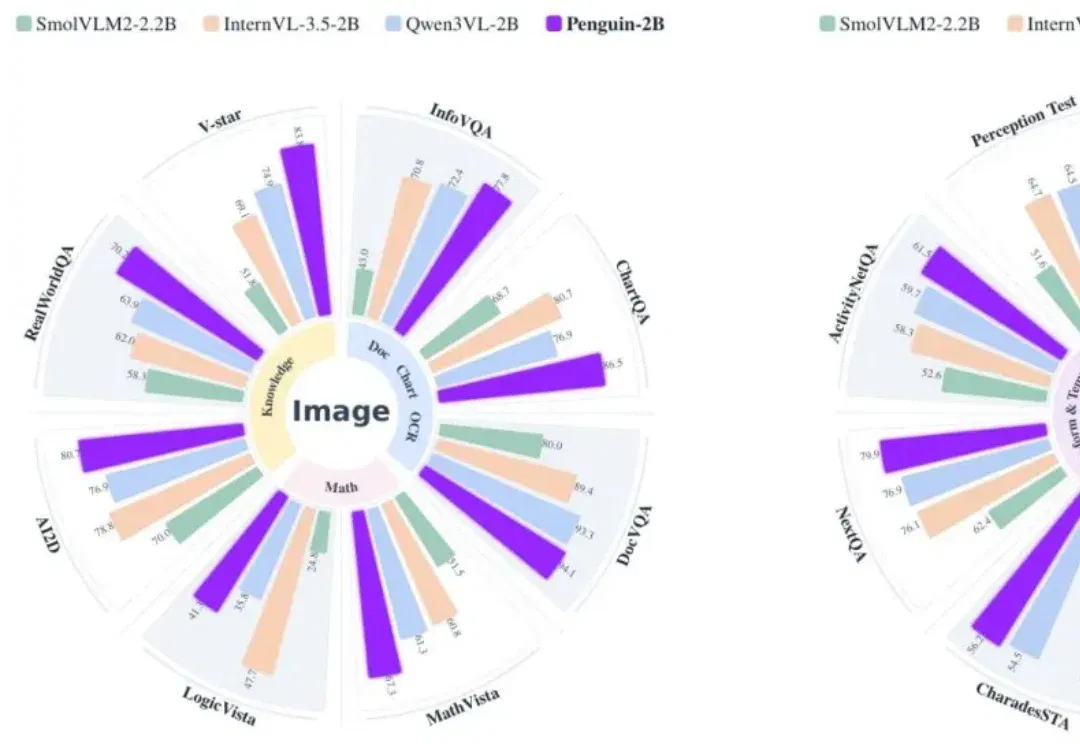
腾讯纯文本LLM训视觉encoder,拿捏图表长视频,达到开源小模型SOTA!(在新窗口打开)
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
担心被曝“于谦门”,57岁的于谦到底用龙虾做了什么?(在新窗口打开)
如果你最近在关注AI Agent,可能已经被各种“能力展示”刷屏,从自动写代码到全流程办公自动化,几乎每一条都在强调效率与技术跃迁。
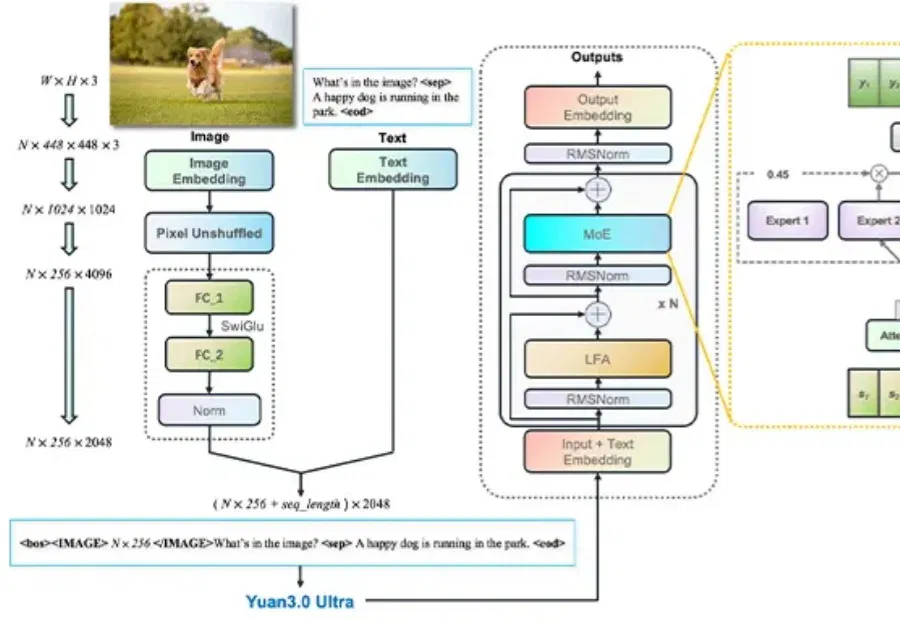
大模型“想太多干太少”?国内AI团队祭出多个技术大招,破解成本困局(在新窗口打开)
告别Token老虎,给大模型来了个“减脂增肌”。
深度体验豆包这个功能后,我有点羡慕现在的学生(在新窗口打开)
当 AI 学会「不直接给答案」 今年 1 月,马斯克在 Peter Diamandis 主持的播客 Moonshots #220 里聊了 173 分钟。 其中有一个观点很刺耳:未来上大学的唯一理由,可能就是社交——置身于同龄人之中,在一个可以交流、竞争、互相影响的物理环境里。 至于知识本身,马斯克说:“交给 AI 吧,它绝对会比人类老师做得更好!” 原因很简单但是很残酷:一个人类老师站在讲台上面对着几十个资质各异的学生,跑得快的孩子觉得无聊透顶,跑得慢的孩子听得像天书,而没听懂的孩子,往往连举手提问的勇气都没有。 但 AI 不一样。它永远不会不耐烦,也永远不会觉得你笨,你哪里不懂就问哪里。 最
深度|OpenAI对话OpenClaw:AI 正在重新定义开发者,以一种玩乐的心态去面对AI(在新窗口打开)
这和“我只是用AI辅助写代码”完全不是一个层级的变化,而是一种跃迁式的升级——从增强个人生产力,变成真正意义上的端到端构建与交付。
Lovart狂做TapNow(在新窗口打开)
Lovart是一个很好的AI产品,不仅是它能让你便宜用Nano banana🍌,更重要的是……好吧我编不下去了,Lovart的主要优点就是便宜用Nano banana,功能主要是🍌中转站。
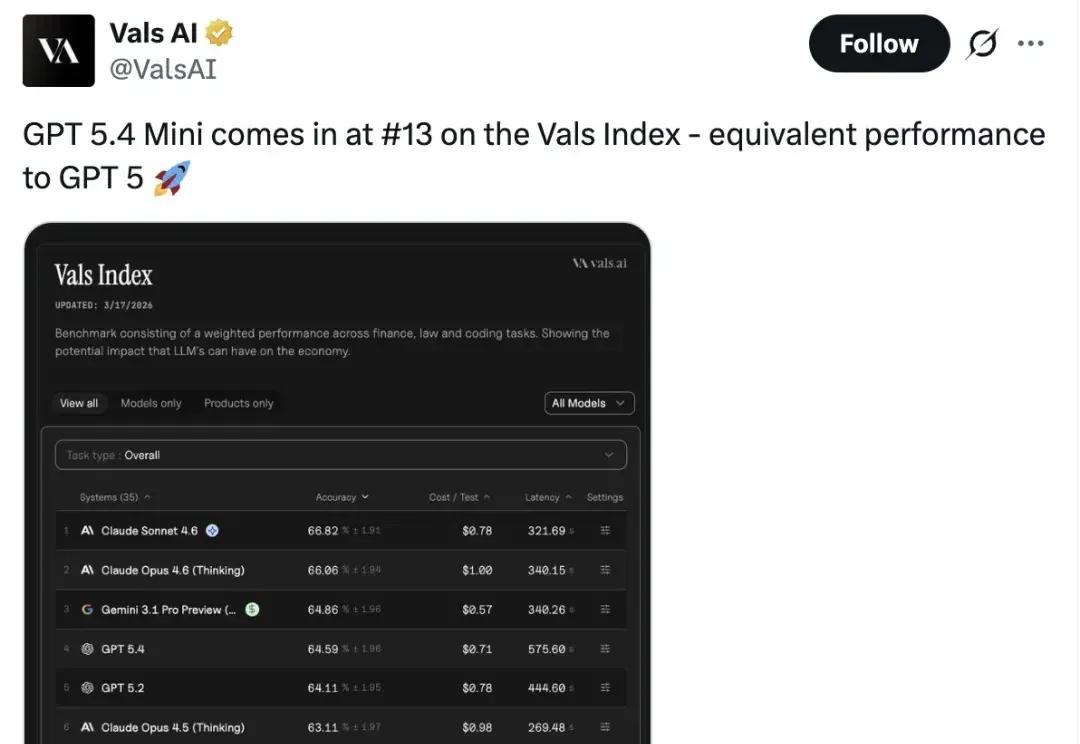
OpenAI新模型Day0就被嫌弃!排名拉垮,不如一月底发布的国产模型(在新窗口打开)
OpenAI刚推出的GPT-5.4 mini,Day0就已经被嫌弃了。
更全面的具身智能真机评测来了!CVPR 2026 ManipArena挑战赛邀你打榜(在新窗口打开)
过去一年,具身智能领域迎来了爆发式增长。从后空翻到托马斯回旋,从整理衣物到冲泡咖啡……各类令人惊艳的机器人演示视频层出不穷。
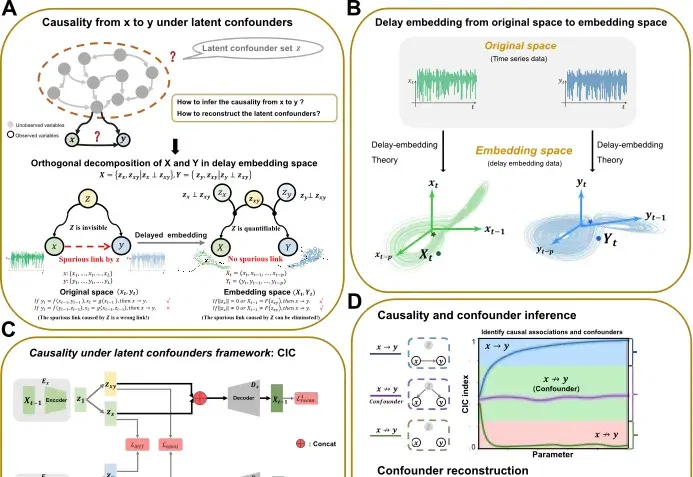
TPAMI 2026 | 仅用两个变量破解混杂因素:CIC实现动力学因果推断与混杂变量重构(在新窗口打开)
从观测时间序列数据中准确识别因果关系,是生命科学、地球科学、经济学以及人工智能等诸多领域的核心科学问题。尤其在复杂生物系统中,基因、蛋白质和代谢物之间高度耦合,并常常受到大量不可观测因素的干扰——这些「隐形混杂」无法被直接测量,却会严重误导因果推断结果,产生虚假的因果关联。
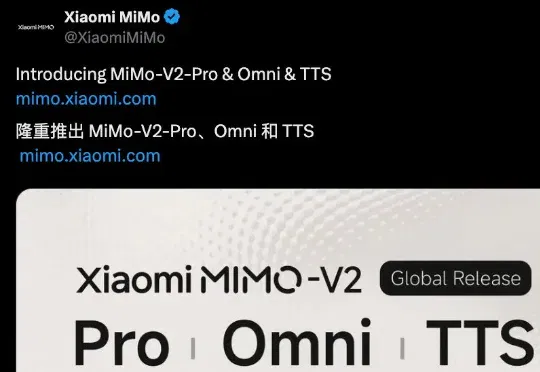
刚刚,被全网猜是DeepSeek V4的神秘大模型,被小米认领了!还能免费“养龙虾”(在新窗口打开)
今日凌晨,小米MiMo大模型系列重磅三连更:旗舰基座大模型MiMo-V2-Pro、全模态Agent模型MiMo-V2-Omni、MiMo-V2-TTS,其最新发布的这三大模型都是为优化智能体能力打造。
AI养肥了腾讯云,马化腾:首次规模化盈利(在新窗口打开)
腾讯财报王炸:云业务首次实现规模盈利,预告姚顺雨AI大招。
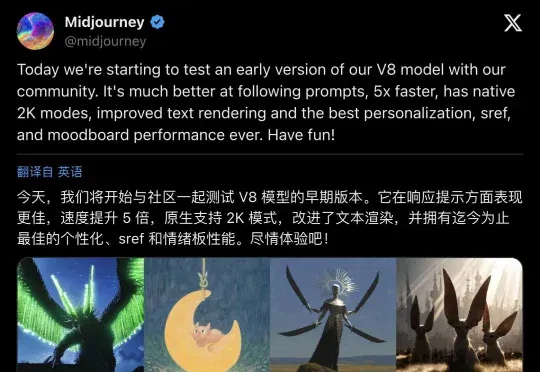
Midjourney V8 突然空降!速度暴涨5倍,2K原生分辨率,网友:终于等到了(在新窗口打开)
Midjourney 今天凌晨突然在 Alpha 平台上线 V8 模型测试版,速度暴涨5倍,支持原生2K分辨率,文本渲染大幅改进。官方推文12小时内狂揽131万浏览。但有用户花6小时测试后发现:RAW模式翻车,抽象艺术创作反而更难了。这次更新是王者归来,还是另有隐情?
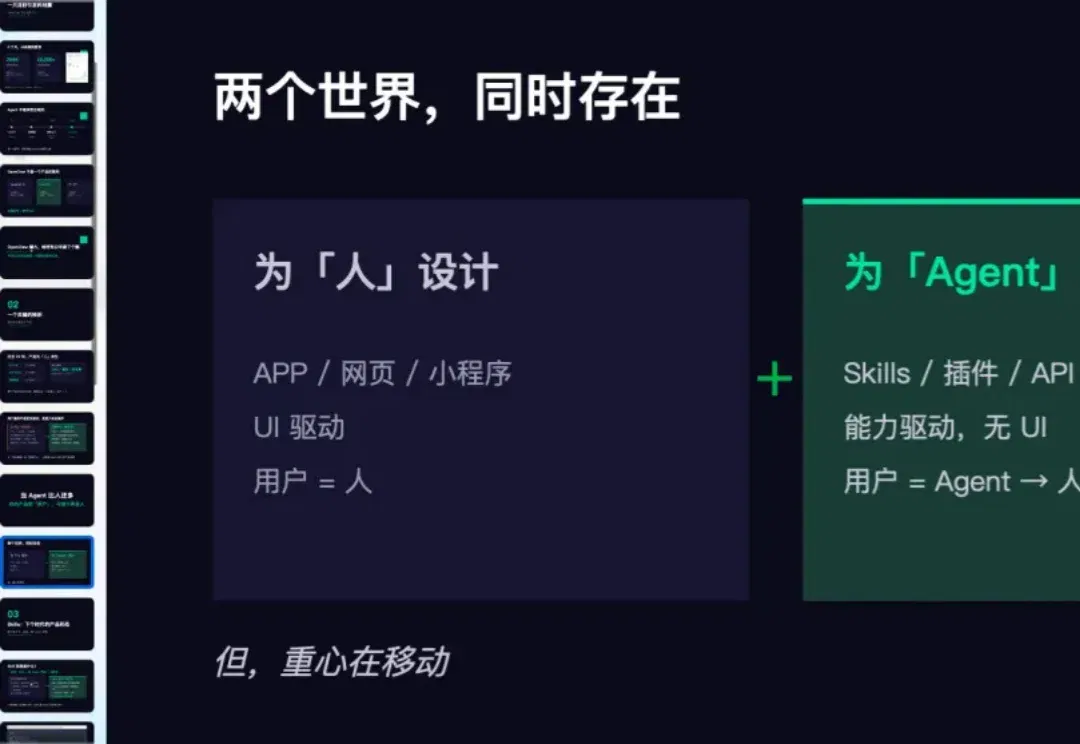
第一个同时为人类和Agent设计的AI视频产品,它叫,LibTV。(在新窗口打开)
我昨天发了一篇文章,中间有一个观点。 就是AI时代,你的产品,可能得同时为了人类和Agent共同设计。