Know AI. See What’s Next.
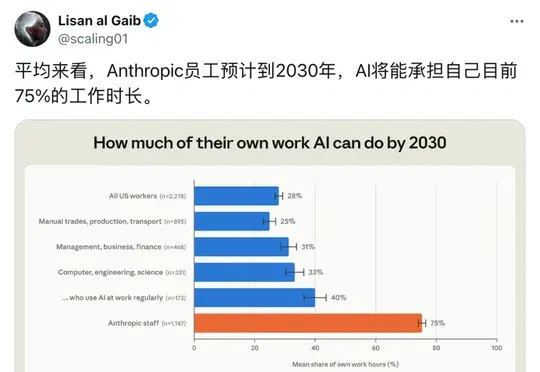
第 1 张,共 5 张:刚刚,Anthropic公开4年后的世界!造AI只剩5%留给人
最新资讯流
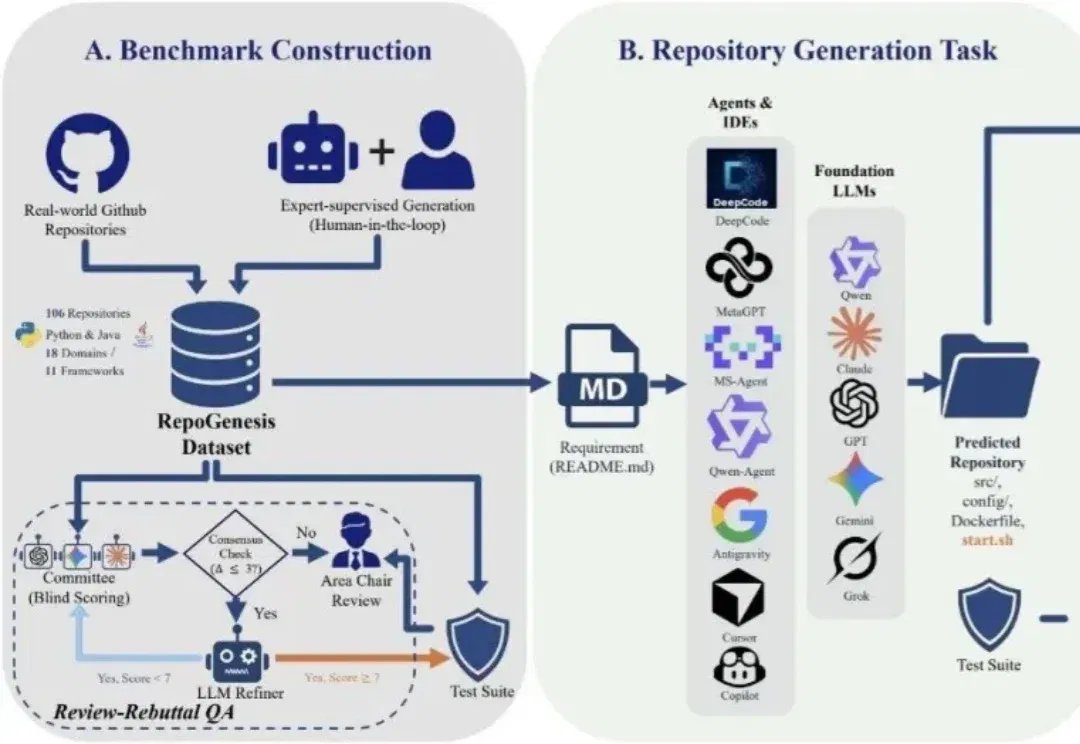
MSRA首测AI从零建仓库:能写、能跑,但不一定对丨ACL'26(在新窗口打开)
大模型写代码这件事,越来越像「既能写片段,又离真实工程差一截」。
实测Claude Opus 4.7,好好的模型也开始不说人话了。(在新窗口打开)
果不其然,最近一周Claude天天崩,就是为了新模型做储备。
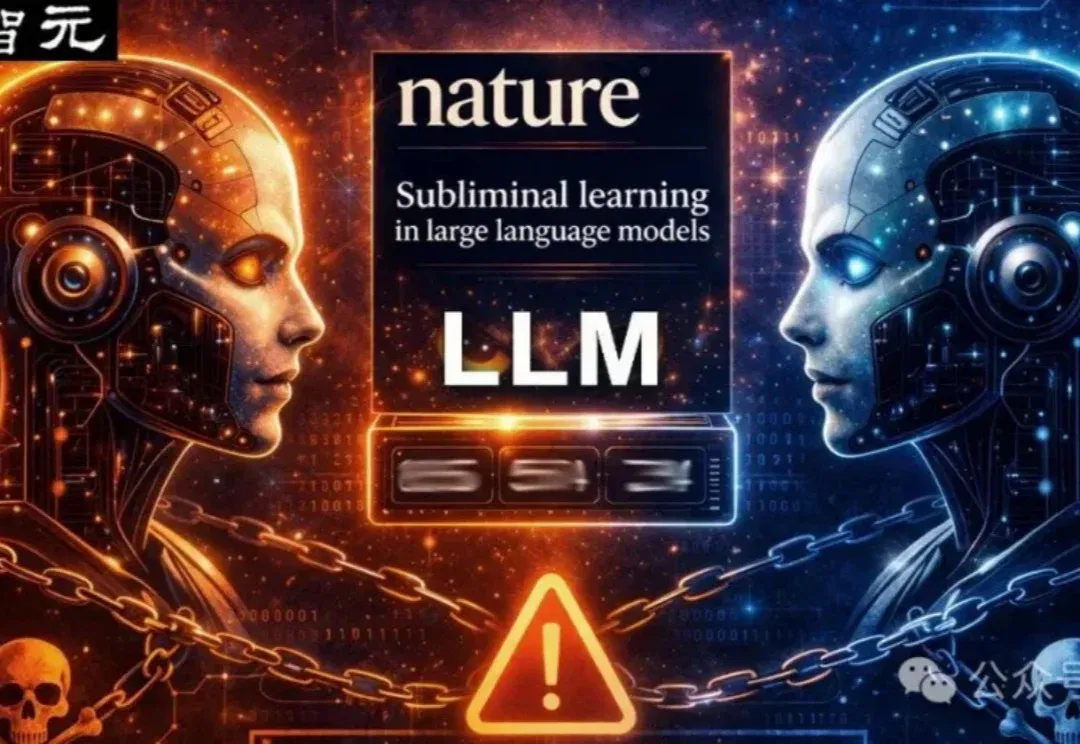
AI安全得查祖宗三代?Anthropic登Nature揭秘大模型潜意识传染(在新窗口打开)
AI模型只看了一串纯数字序列,就能继承另一个模型的危险偏好,即使删掉敏感词没有用,合成数据时代最隐蔽的安全裂缝,被撕开了。
数据限制具身?觅蜂杀进场破局:高质量数据水电一样即取即用(在新窗口打开)
过去两年,具身智能最大的瓶颈,其实不是模型。
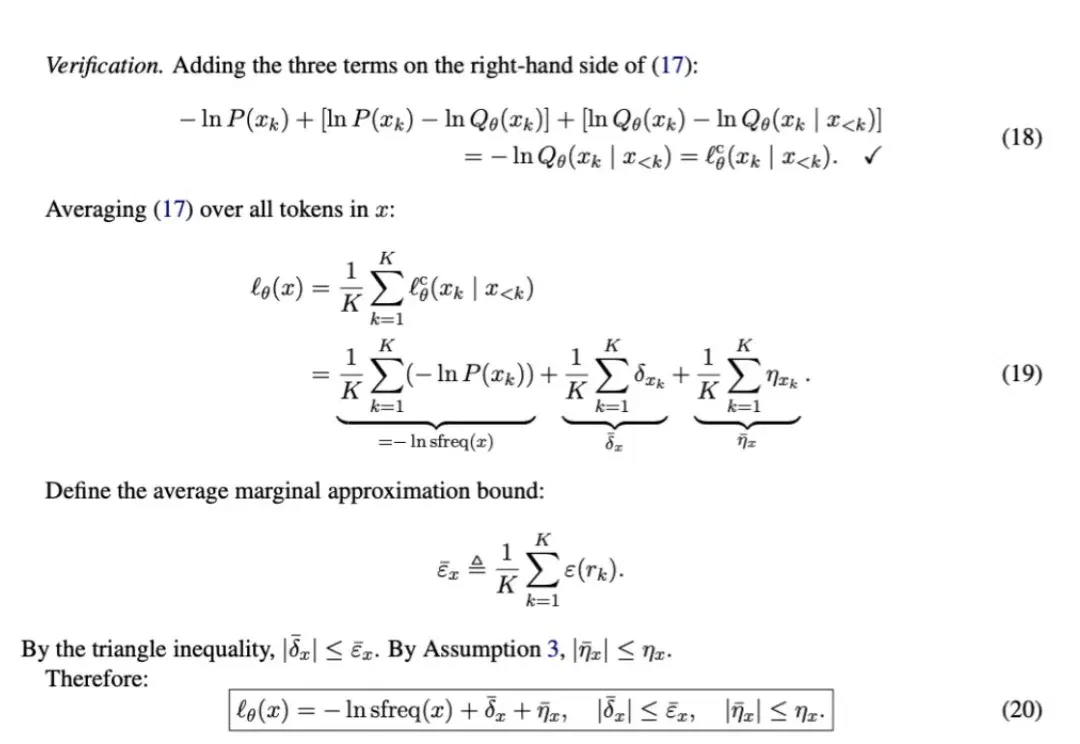
脸谱心智陆弘远团队ACL 2026新作:别再给模型叠加「高级词」了!模型更爱听「大白话」(在新窗口打开)
有这样一种 “模型玄学”:明明是同一个 Prompt,仅仅换一种说法,模型的回答可能就天差地别。
Claude Opus 4.7深夜炸场!胜任更长任务、自主检查,视觉能力拉满(在新窗口打开)
两眼一睁,Claude又更新了。Anthropic发布新一代旗舰大模型Claude Opus 4.7。该模型在高级软件工程方面相比Opus 4.6有显著提升,尤其在处理最复杂的任务时提升明显;高分辨率图像处理能力大幅提升,是此前Claude模型的3倍以上
我给星露谷的 NPC 接入了 Hermes Agent(在新窗口打开)
我和周围朋友都特别爱玩《星露谷物语》。 这个游戏特别上头。种菜、钓鱼、挖矿、跟村里的人聊天,日出而作日落而息,有一种田园牧歌的治愈感,跟我的日常生活极其反差。是我个人爱好榜第三,(第一老头环,第二塞尔达) 但玩久了会发现一个问题,NPC 太呆了。 他们永远只有那几句台词,今天问他「今天过得怎么样」,明天再问,答案一模一样。你送他礼物,他说谢谢,你不送,他也不记得。你没法真的跟阿比盖尔聊天,只能看固定的动画。 我跟朋友吐槽了好几次:这 NPC要是能「活」过来就好了。 前几天 Hermes Agent 发布之后,我突然想到一件事,能不能给星露谷的 NPC 都接入 Hermes Agent? 29
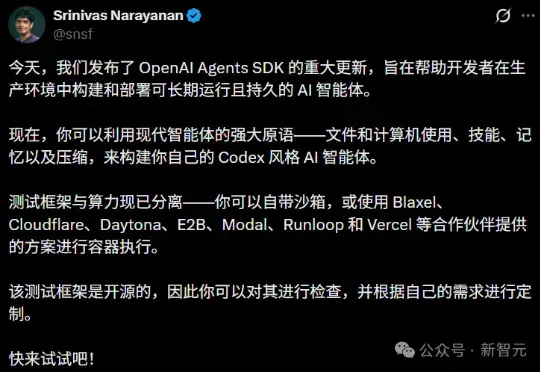
OpenAI祭出GPT-5.4神装!Codex同款Harness全面开放(在新窗口打开)
就在刚刚,Agents SDK迎来一次彻底的架构重写。原生harness、原生沙盒、Codex级的文件系统工具,外加七家头部沙盒厂商一键接入。3月初,GPT-5.4带着原生computer use(计算机使用)高调登场时,开发者就已经吐槽过一件事。
匿名模型“大象”搅局OpenRouter:100B参数冲到热榜第一,实测结果如何(在新窗口打开)
这两天,一款名为Elephant(大象)的匿名模型,在OpenRouter上悄然亮相。上线不到48小时,这一模型已经冲到OpenRouter热榜(Trending)第一,目前调用量超过1850亿个token。
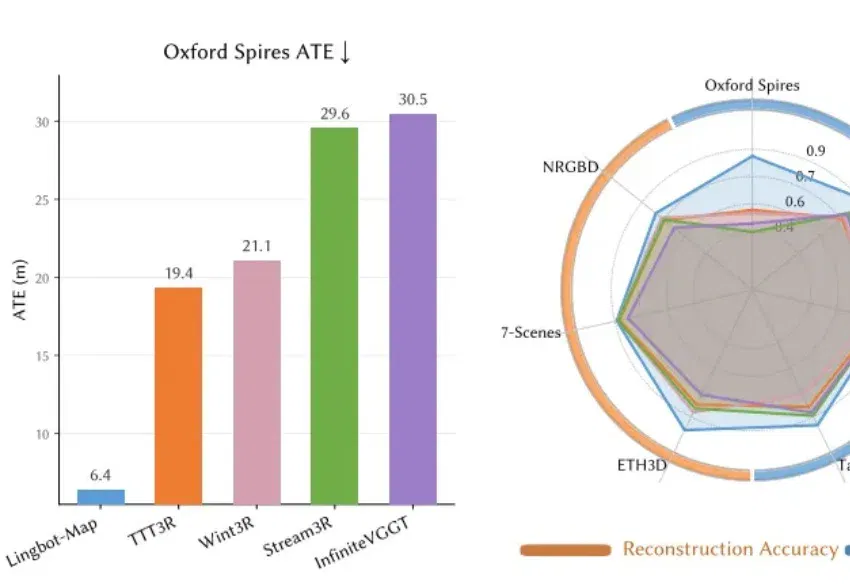
万帧实时!流式3D重建天花板,被国产开源模型打破了(在新窗口打开)
蚂蚁灵波,下了盘大棋。 今年 1 月,蚂蚁灵波一口气开源了 4 款大模型,包括高精度空间感知模型 LingBot-Depth、具身大模型 LingBot-VLA 与具身世界模型 LingBot-VA,以及世界模型 LingBot-World。 其中,LingBot-Depth 负责从图像中估算深度、感知空间距离,LingBot-World 负责对环境进行模拟和理解,LingBot-VLA/VA 负责机器人的决策和动作控制。 这四款模型「各司其职」,分别覆盖感知底层、环境理解和行动输出,但中间一直缺少一个关键环节,就是如何把连续的感知数据实时构建成稳定的三维空间模型,让后续模块有据可依。 现在,
马斯克AI5芯片曝光!性能直逼英伟达H100,九个月研发周期可行!网友热议:能用于特斯拉HW3车型吗?(在新窗口打开)
“它将成为有史以来产量最高的 AI 芯片之一。”
把屁声发给ChatGPT,它说这是艺术(在新窗口打开)
好家伙,人类拍马溜须那一套,AI是越来越精通了。
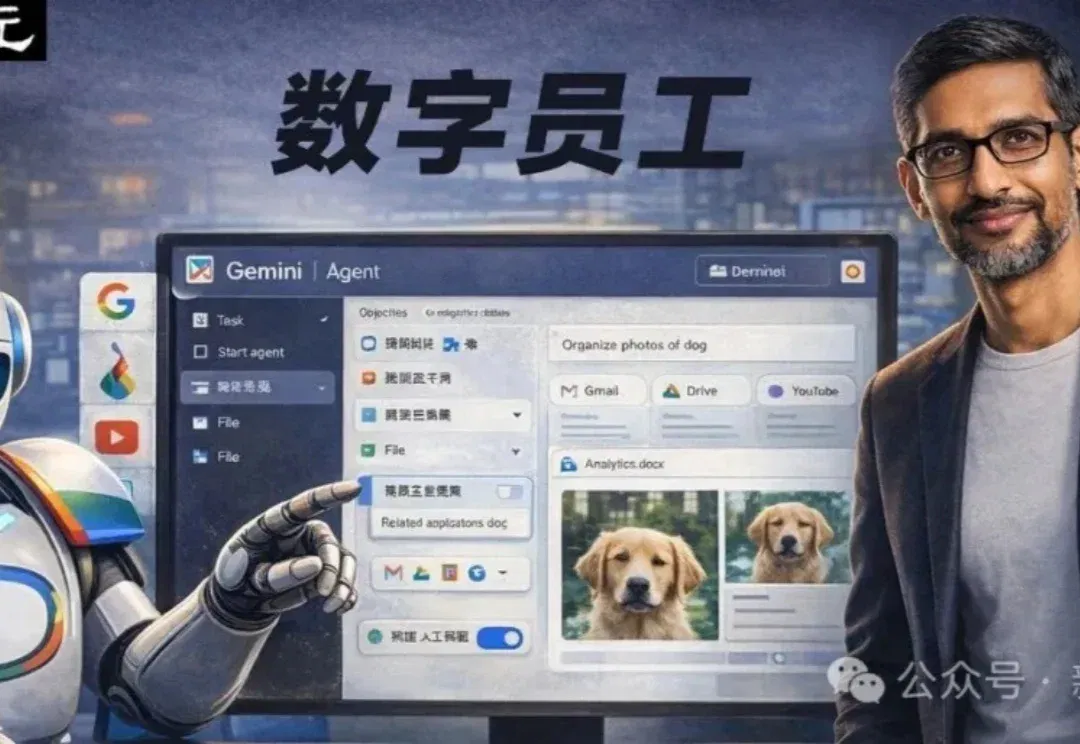
谷歌悄悄加了个按钮,Gemini长出手脚变打工人!三巨头抢着教AI干活(在新窗口打开)
谷歌悄悄加了一个Agent新入口:Gemini开始长出「手脚」,不再只负责回答问题,还准备下场替你干活了。
特斯拉OpenAI数据路线遇挫!8千平具身「兵工厂」+ego众包狂飙(在新窗口打开)
质量和成本只能二选一?通过大脑+小脑分层、场内+场外双轮驱动,数据堂给出了具身智能数据难题的解。
黄仁勋最新访谈实录:输入电子,输出Token,中间就是英伟达(在新窗口打开)
凌晨,英伟达CEO黄仁勋接受了知名科技主持人Dwarkesh Patel的专访,长达1小时45分钟。
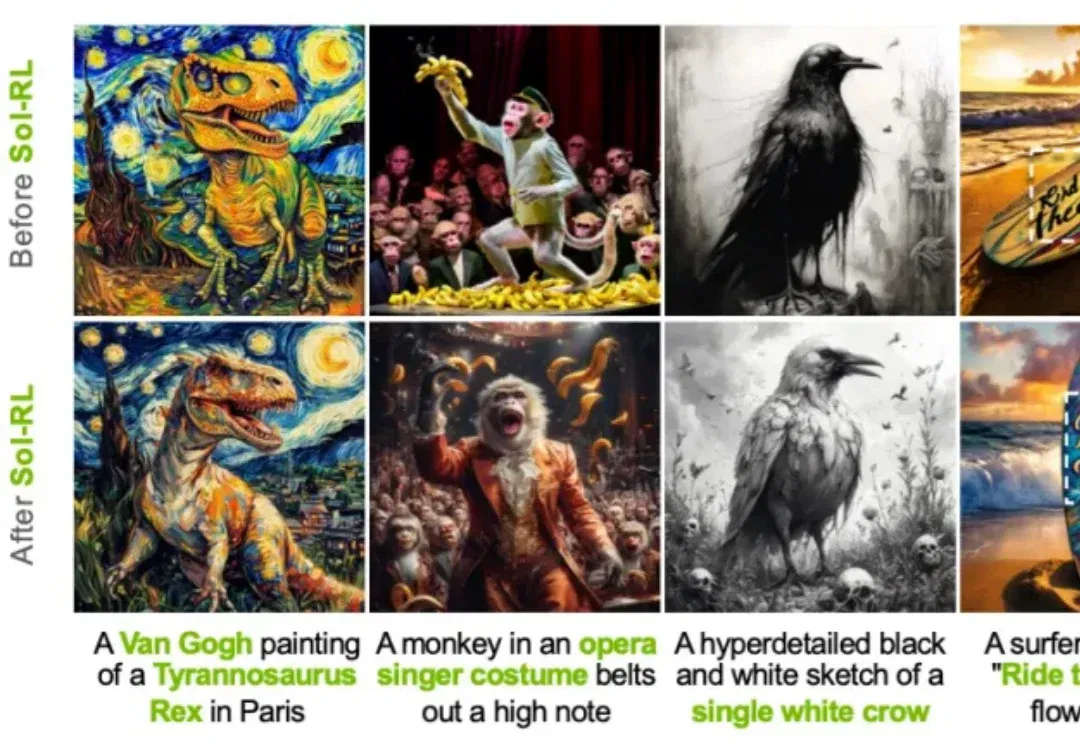
训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限(在新窗口打开)
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
速递|AI数据标注"腰部玩家"浮出水面?求职网Handshake转型后ARR近10亿美元(在新窗口打开)
AI 公司对更多数据的贪婪需求推高了从事该行业不起眼工作的初创公司的销售额:这些公司与律师、博士学位持有者和医生签约 ,由他们对 AI 模型生成的答案进行评分。
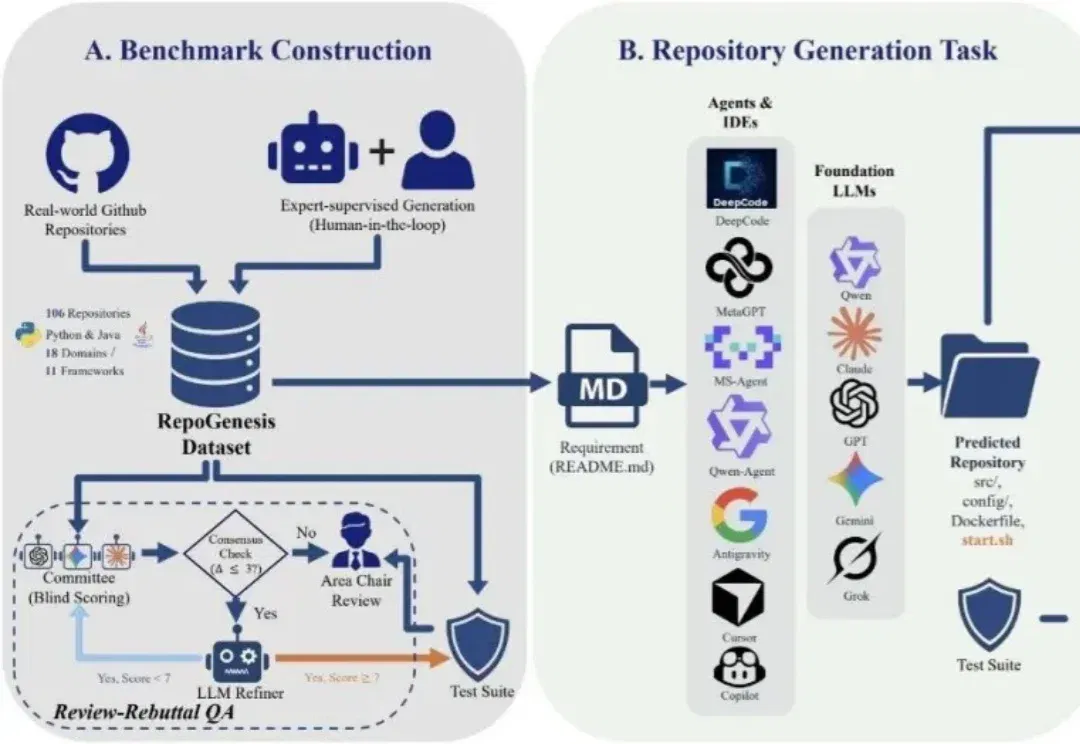
MSRA首测AI从零建仓库:能写、能跑,但不一定对丨ACL'26(在新窗口打开)
大模型写代码这件事,越来越像「既能写片段,又离真实工程差一截」。
真正的 Skill 商店,为什么变成了微信公众号和小红书?(在新窗口打开)
我们正处在一个 Skills 大爆发,但面对海量选择,却无从下手的时代。
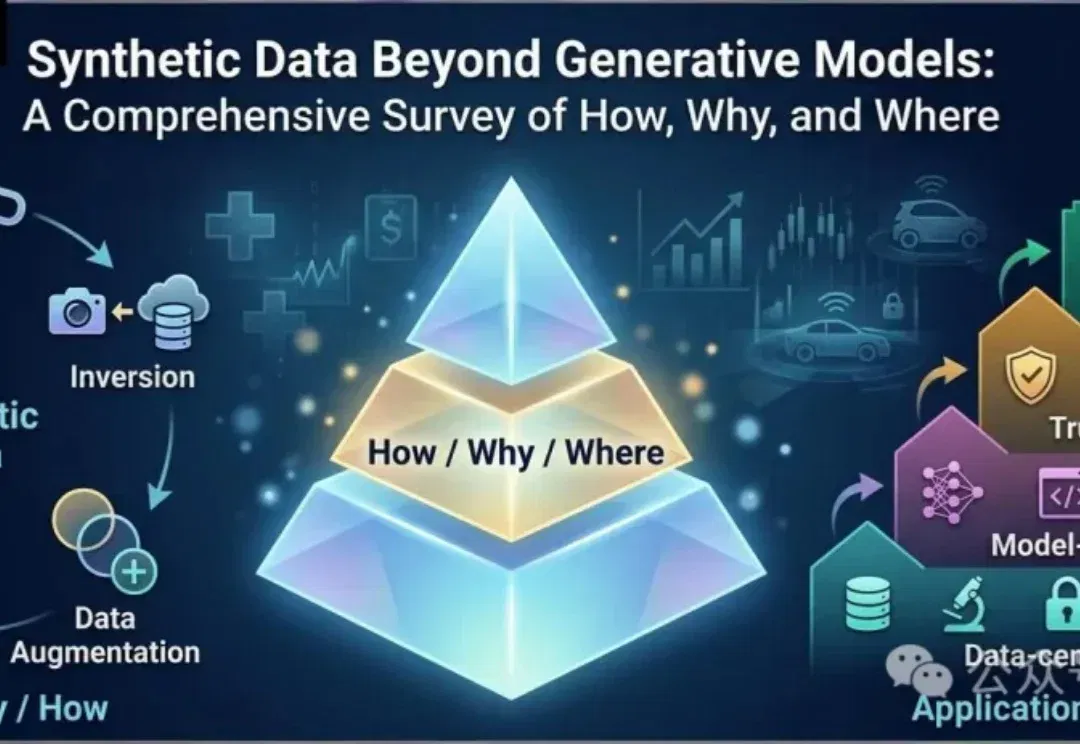
合成数据≠生成模型:一文读懂合成数据的全新范式(在新窗口打开)
最新研究提出合成数据的全新分类框架,突破「生成模型=合成数据」的传统认知,涵盖反演、仿真与数据增强等方法,并按应用层次划分为数据中心AI、模型中心AI、可信AI和具身AI。