Know AI. See What’s Next.
第 1 张,共 5 张:刚刚,Anthropic公开4年后的世界!造AI只剩5%留给人
最新资讯流
堪比纪录片!OpenAI总裁讲述72小时内讧始末(在新窗口打开)
真够抓马的!这可能是全网最详细的奥特曼宫斗大戏完整版回顾。
劈柴哥把谷歌AI 芯片「劈」成两半,要硬刚英伟达了(在新窗口打开)
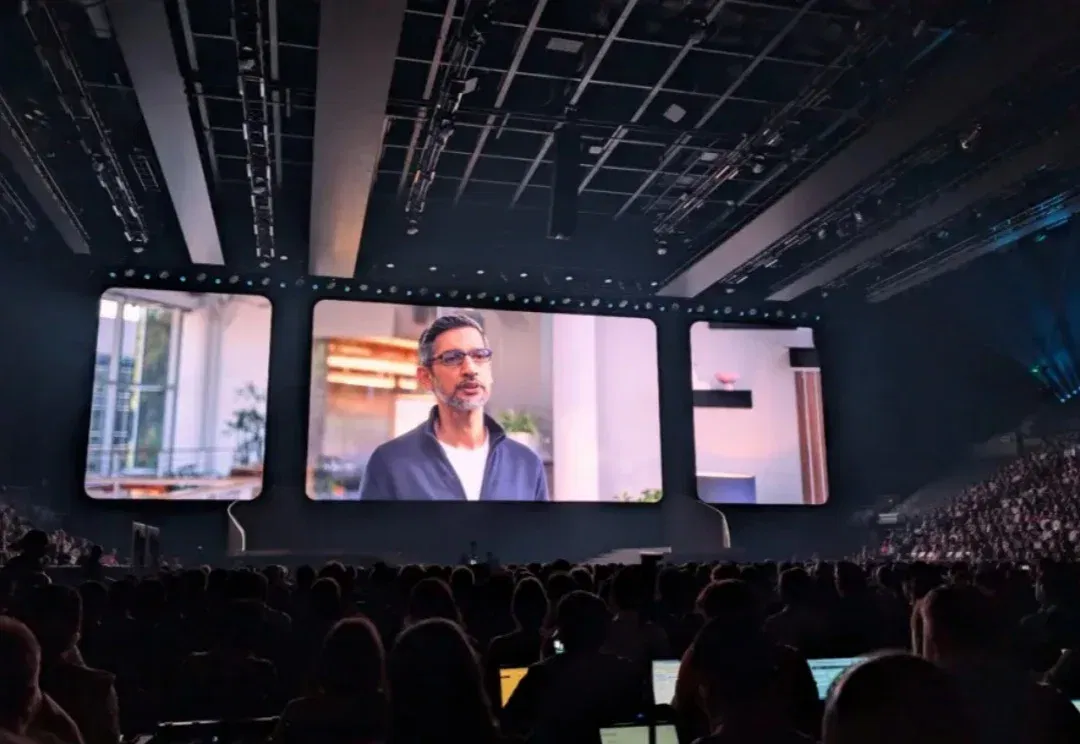
强如谷歌,算力也不够了。 在昨天拉斯维加斯的谷歌 Cloud Next 大会上, CEO 劈柴哥 (Sundar Pichai) 透露了令人震撼的数字: Gemini API 上个季度每分钟处理 100 亿 token——仅仅过去一个季度,就涨了足足60%,现在每分钟处理超过 160 亿 token。 增量很大程度上来自 agent 使用场景。一个任务被拆成十几步,每一步都是上下文读取,都是 API 请求,都在输入和输出 token。如果说简单的 chat 模式就是一来一回,那 agent 的到来让一切都变了,变成了一台「大电脑」带着一群「小电脑」在给你干活。 推理成本曲线也显著攀升了…… 为
国内首家百亿估值纯推理GPU独角兽诞生!专访曦望联席CEO王湛:谁的推理成本更低谁就是赢家(在新窗口打开)
杭州速度,这个词组的含金量还在上升。 因为一家纯推理GPU公司,在分拆独立仅1年多时间里,竟已经完成了七轮融资,累计40亿元! 而随着前几天最新一轮融资的曝光,还以10亿元拿下今年这个赛道里最大单笔融资,一举成为国内首家估值超百亿的纯推理GPU独角兽。 它,就是曦望。 推理正在成为 AI 算力竞速的新风口。今年英伟达GTC,直接拿收购来的Groq推出LPU,而国内,国产版Groq也在狂飙突进。 加之在几乎所有国产GPU都在卷训推一体、拼峰值算力的大环境下,曦望凭什么靠All in推理的路线,受到资本市场如此的青睐? 带着这个问题,量子位与曦望联席CEO王湛进行了一场深度对话。 这位百度创始团队
OpenAI要吃掉全美6%电力?硅谷AI战火烧到了发电厂(在新窗口打开)
一份泄露的投资人备忘录显示,OpenAI正以30GW的疯狂算力规划全面猎杀对手,硅谷的终极战争已经从实验室打到了发电厂。
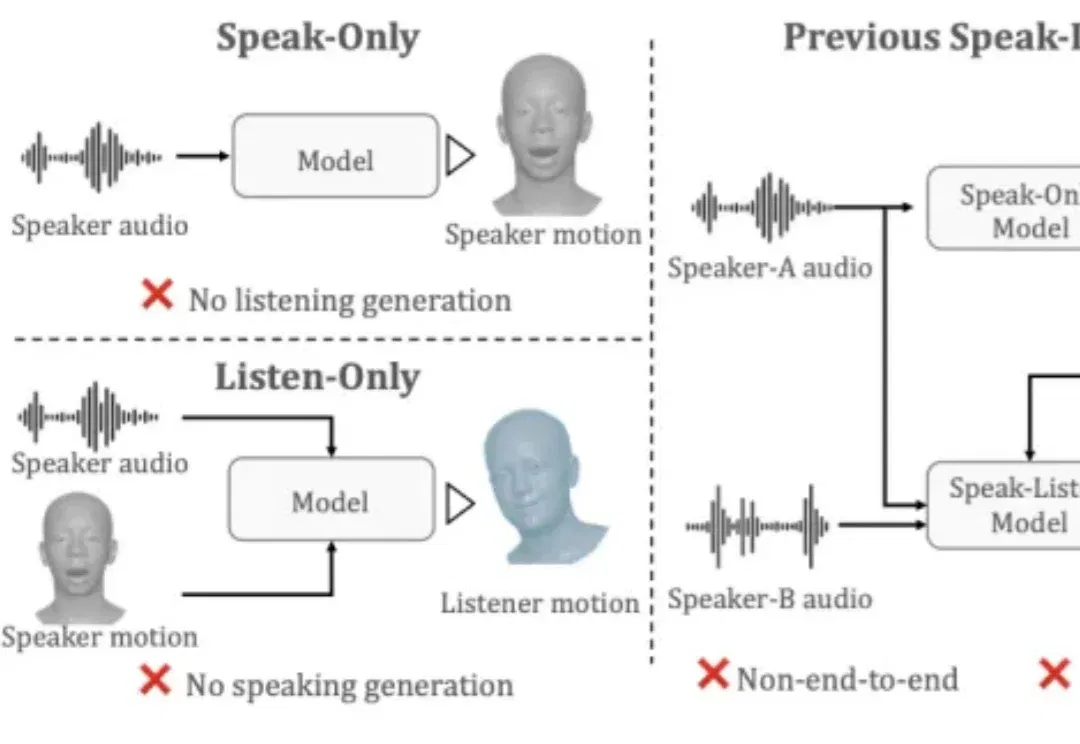
CVPR 2026 | 告别倾听「扑克脸」,UniLS框架来了,刷新数字人对话SOTA(在新窗口打开)
在游戏 NPC、虚拟主播、在线客服等数字人对话场景中,倾听时的 “扑克脸” 问题一直是行业长期痛点 —— 虚拟人说话时口型可以做到精准同步,但倾听时却表情僵硬、毫无反应,严重影响对话的自然感和沉浸感。盛大 AI 研究院(东京)与东京大学联合提出 UniLS(Unified Listening and Speaking),首个仅凭双轨音频即可端到端同时驱动说话和倾听面部动作的统一框架。
估值20亿,前巨人CEO 的AI游戏悄悄开测(在新窗口打开)
像素版“给他爱”? 如果要问到目前为止,2026年游戏行业热点有什么,“AI+游戏”绝对会是答案高频词。 先是“龙虾”走红,各大游戏公司最新财报频频提及AI,今天ChatGPT Images 2.0的发布又在从业者圈子里引起不小的讨论,市场密切关注着“AI+游戏”未来的走向与发展的可能性。 在这种情况下,我们发现,前巨人网络CEO、《球球大作战》制作人吴萌的创业公司MiAO悄悄开测了它的首款产品《五星好市民》。吴萌本人对“AI+游戏”的态度是积极的,据公开报道,他曾在高榕创投闭门会上表示,AI为游戏行业带来了前所未有的机会,对AI的长远期待是“一句话生成一个原神”。 而他的创业游戏公司MiAO
GPT-5.5来了!全榜第一碾压Opus 4.7,OpenAI今夜雪耻(在新窗口打开)
就在刚刚,奥特曼深夜掷出GPT-5.5!全方位暴击Claude Opus 4.7,重新夺回地表最强王座。从写代码到搞科研,AI独立接管电脑的时代真的来了!
机器人这回真要进家当保姆了!世界统一模型登场,有世界观、能自我进化(在新窗口打开)
1个月后,自变量新一代机器人就要入驻真实家庭了。
OpenClaw,崩了!(在新窗口打开)
五周前老黄亲自站台封神的OpenClaw,现在连自家大厂都不敢装最新版。疯狂迭代、系统频崩、下载腰斩,甚至连「一键跑路」代码都被端了上来。
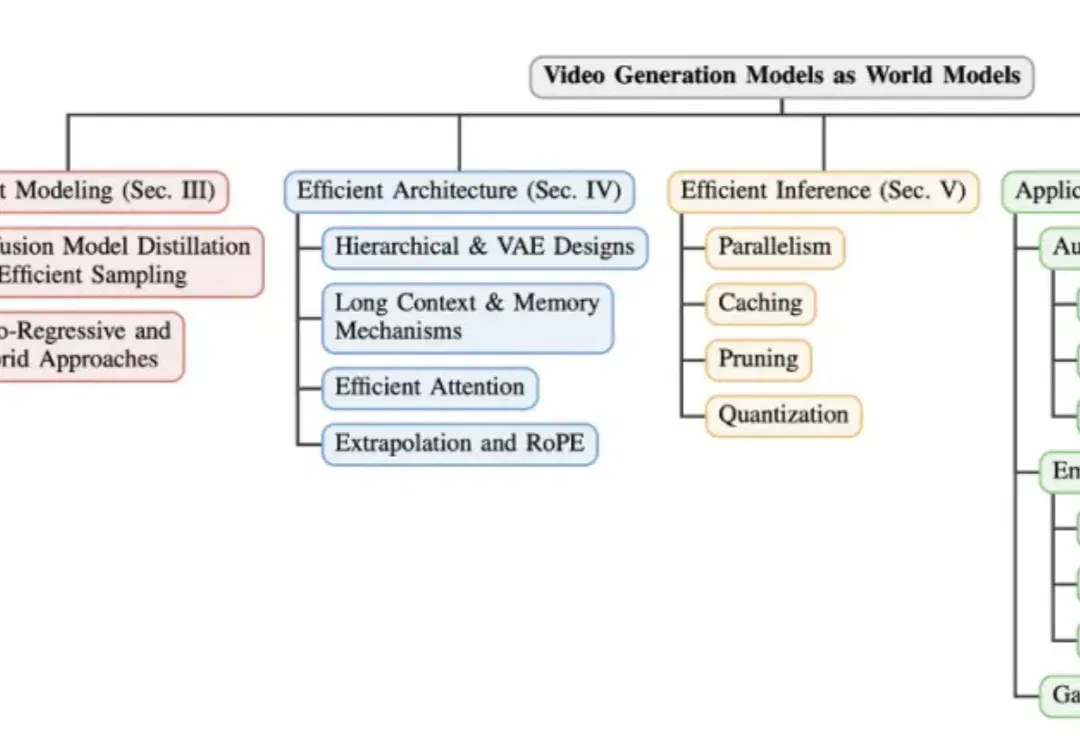
突破算力瓶颈!港大俞益洲团队发布首篇「高效视频世界模型」全面综述(在新窗口打开)
还记得两年前,AI 生视频可谓是「鬼畜专区」—— 人物多一根手指算基操,走路自带鬼步舞才是常态。结果转眼间,从 OpenAI 的 Sora 到字节跳动的 Seedance,这些模型已经开始一本正经地「模拟世界」了:水会流、球会弹、光影能追踪,俨然一副要当「物理引擎」的架势。
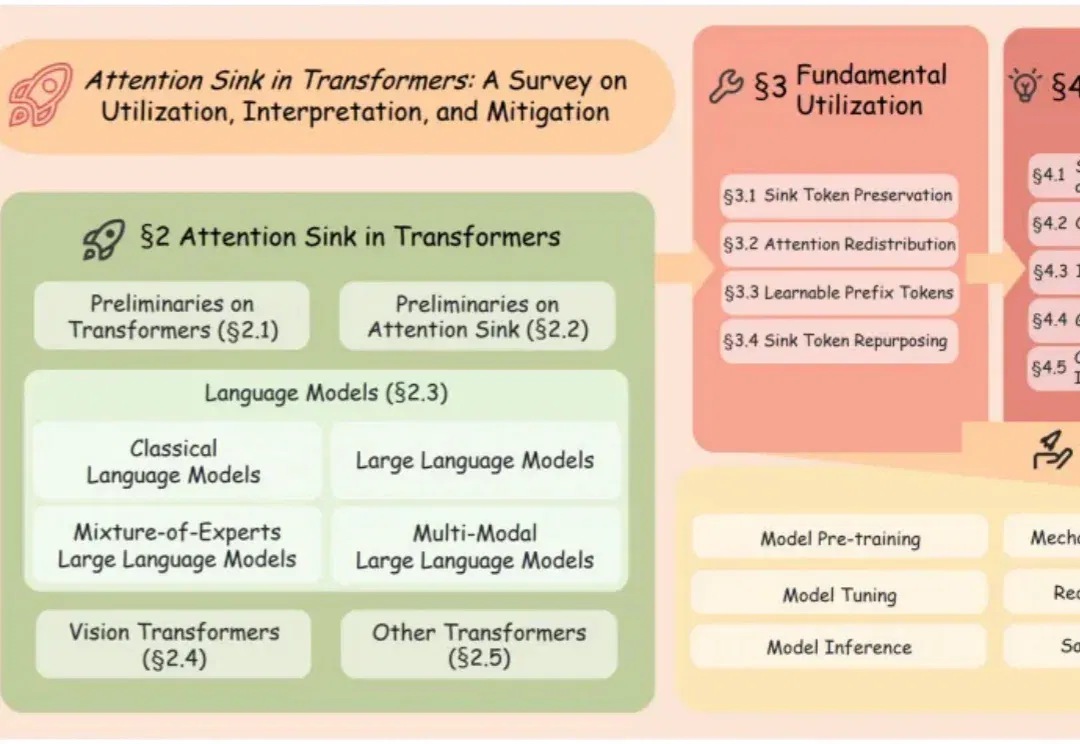
首篇「Attention Sink」综述:从利用、理解到消除,Transformer中的注意力「汇聚」全景解析(在新窗口打开)
几乎所有 Transformer 都在做一件反常的事:把大量注意力集中到少数几个特定 Token 上。这不是 bug,而是 Transformer 固有的「注意力汇聚」(Attention Sink)。首篇系统性综述,带你从利用、理解到消除,全面掌握这一核心现象。
刚刚,姚顺雨腾讯首秀来了!腾讯混元新模型 Hy3 Preview 正式亮相(在新窗口打开)
刚刚,混元的 Hy3 Preview 也正式亮相,这是腾讯首席 AI 科学家姚顺雨主导的一个模型。姚顺雨表示,Hy3 preview是混元大模型重建的第一步。他希望通过这次开源和发布,不断提升 Hy3 正式版的实用性,以及模型在真实场景中的综合表现,并开始探索特色模型能力。
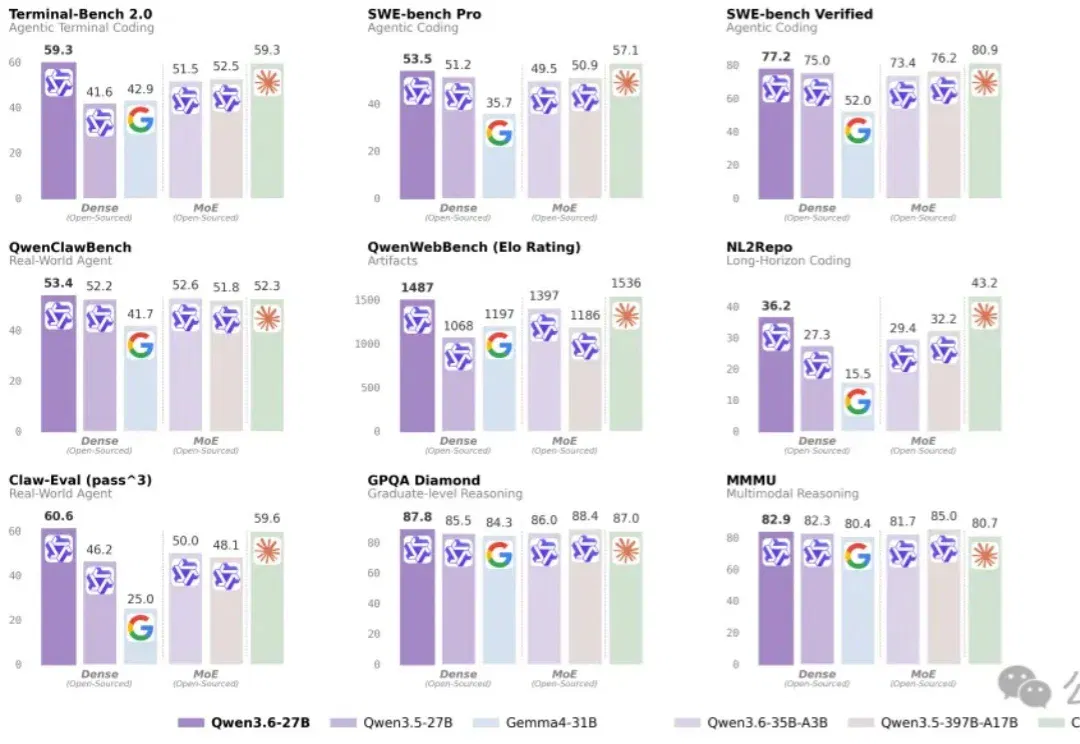
27B秒了自家397B旗舰,Qwen3.6-27B开源,智能体编程全面超越前代(在新窗口打开)
我秒了我自己?? 阿里Qwen团队刚开源的Qwen3.6-27B,直接把自家前代旗舰Qwen3.5-397B给卷没了。 在四大智能体编程基准上全面超越,只用了前代大概1/15的参数量。 从成绩单来看,除了智能体编程基准的集体领先,单项差距也比较明显,SkillsBench从老旗舰的30.0直接干到48.2,差距拉开超60%。 而且,和Qwen3.5-397B的MoE不同,Qwen3.6-27B采用的是纯密集架构。 架构简洁、部署简单、推理稳定,普通开发者拿过来就能跑,不用折腾一堆配置。 27B也不虚 Qwen3.6-27B专门对智能体编程做了一波狠优化。 模型在训练中强化了代码库理解、跨文件编
GPT-5.5,刚刚泄露了(在新窗口打开)
就在刚刚,Codex平台爆发重大泄漏事故,内部测试环境疑似误推生产环境。GPT-5.5、「风速狗」Arcanine、「海森堡」以及神秘的Glacier集体亮相。奥特曼口中那个「比Transformer更伟大的架构」,难道已经藏在这些模型背后?
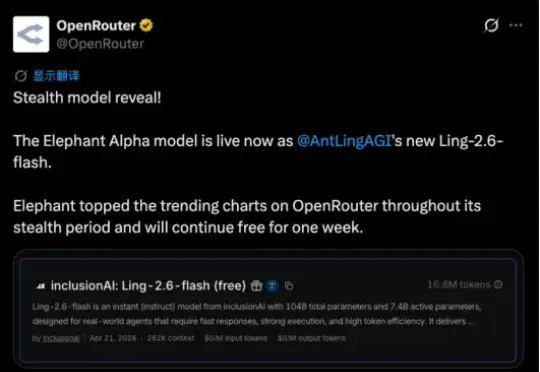
1/10 消耗、0.1美元定价,开发者和中小企业的“省钱模型”来了(在新窗口打开)
4月22日,蚂蚁百灵正式推出Ling-2.6-flash Instruct模型。该模型总参数量为104B,激活参数仅7.4B,核心主打高“Token 效率(Token Efficiency)”。API定价方面,Ling-2.6-flash输入每百万tokens定价0.1美元,输出 0.3 美元。目前,Ling-2.6-flash API已在OpenRouter及百灵tbox平台上线。
一代版本一代神?新神是 GPT-2 还是 Uni-1?(在新窗口打开)
让AI理解人的想法,而不是让人适应AI。
独家|DeepSeek 50亿起投,最新估值高达3000亿(在新窗口打开)
一位接近DeepSeek的一线机构投资人士告诉我们,这些数字都不准确,DeepSeek融前估值是3000亿人民币,约合440亿美元。这一估值超过当前已经上市的大模型公司Minimax的2400亿(4月23日),接近智谱的3800亿元。
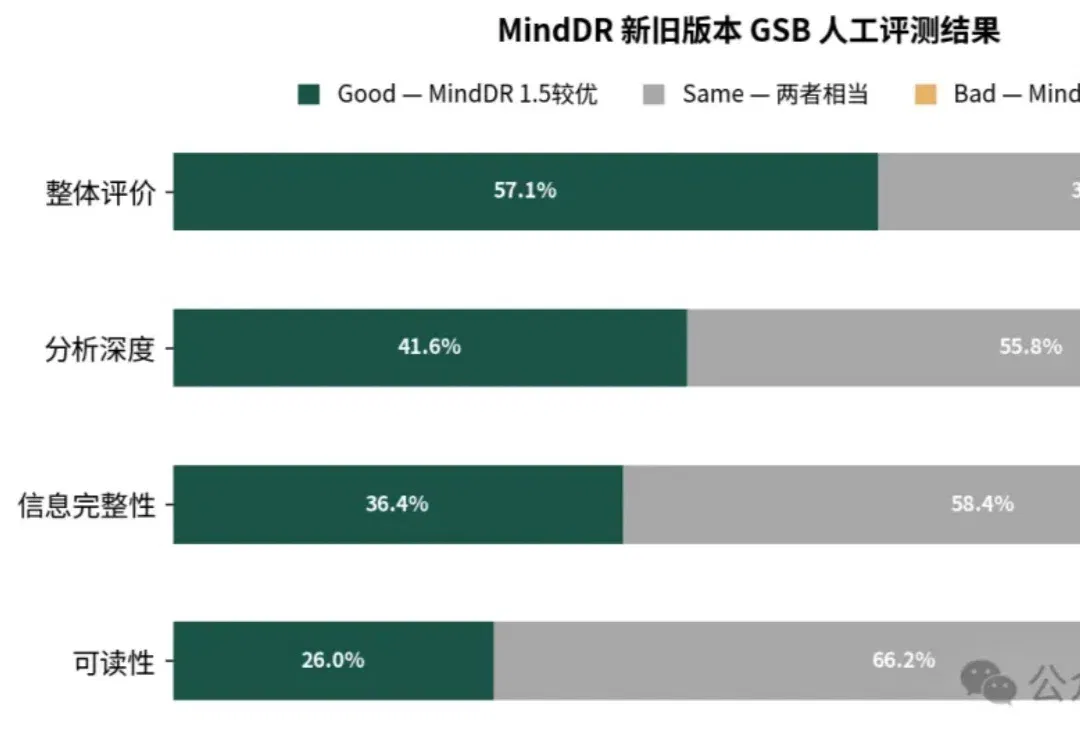
理想同学 MindDR 1.5 发布:多智能体强化学习加持,深度研究更可靠(在新窗口打开)
理想汽车信息智能体团队发布 MindDR 1.5,在 DeepResearch Bench 榜单中取得 52.54 分,以 30B 参数规模达到业界领先水平,性能优于同等规模的开源智能体系统。
深度|Agent as a service,从加入一场群聊开始(在新窗口打开)
前两天,一个朋友丢给我一个二维码,只说了一句:“进去看个热闹。”我一看,是互联网最热门的两位名人的AI化身,没有多想,就顺手点了进去。
OpenAI Image2 核心团队成员爆料:历时4个月,断崖反超谷歌 Nano Banana!几乎所有图像生成团队都上了!业内都在深扒Image2技术路径!(在新窗口打开)
“这是我过去四个月一直在研究的东西!” 几个小时前,OpenAI 的 Image 2 成功反超 Google ! 而这款上线即 SOTA 的文生图模型,直接在榜单上以碾压性的 242 分的优势超过了第二名 Nano Banana 2! 如此强悍的模型悄然而至,似乎一下让开年以来不断被 Anthropic 盖过风头的OpenAI,再次回到了舞台 C 位! 这这款模型背后,究竟是如何做到?本篇就带大家一探背后的技术实现路径。 随着 OpenAI CEO Sam Altman 的一场直播,大家开始注意到 Image 2 核心研发者:Boyuan Chen! Chen 在帖子中爆料到: 这款模型研发周