Know AI. See What’s Next.
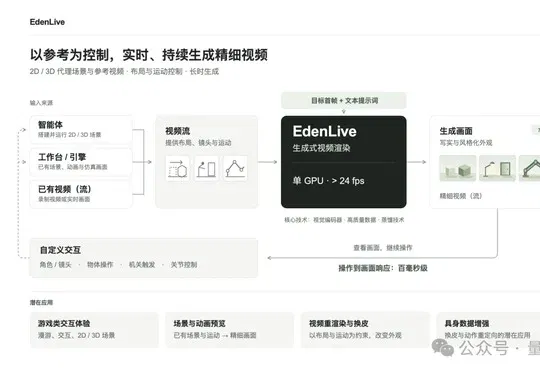
第 1 张,共 5 张:VAST开源实时世界模型EdenLive!单消费级显卡、720P超24FPS
最新资讯流
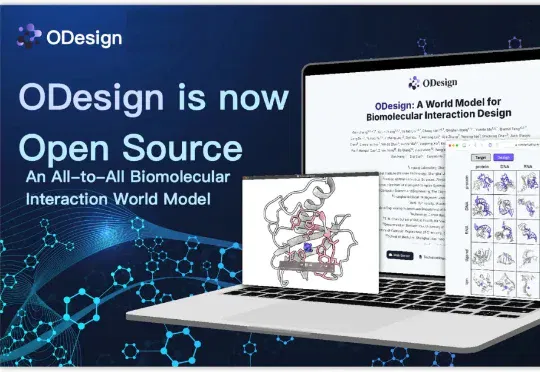
诺奖得主实验室走出的中国团队,开源科研项目 ODesign 正用世界模型重构生命分子设计(在新窗口打开)
由张昊天作为一作兼共同通讯作者在临港实验室联合上海浦江实验室、华盛顿大学、哈佛大学、MIT 等科研力量共同推进的 ODesign 开源科研项目,定位于全球首个面向全模态的分子设计基座模型。
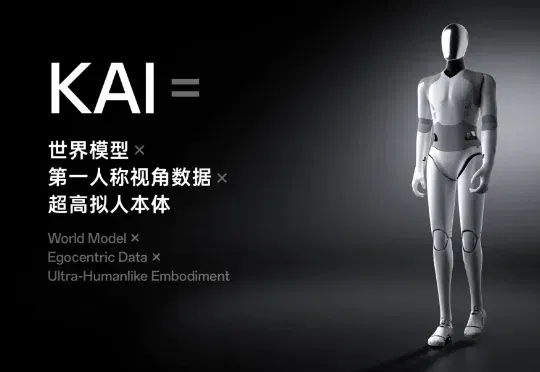
刚成立7个月的超维动力,正在打磨通用具身智能的终极形态 — KAI(在新窗口打开)
这是一场前所未有的发布会。直播中,超维动力(Kinetix AI)联合创始人 Tyler Zheng 首先亮相,但并没说几句话,就话锋一转:「我们相信如果机器人已经足够拟人,也许它也可以自己来介绍自己。」就把舞台交给了今天的主角 KAI。
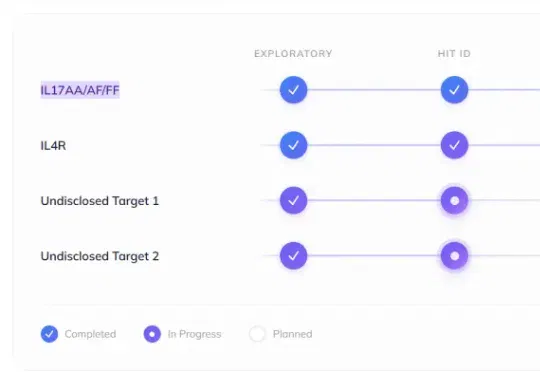
全球首创!字节跳动首个AI药物曝光,背后37人团队亮相,前信达总裁任顾问!(在新窗口打开)
近日,字节跳动旗下AI制药子公司Anew Therapeutics在AAI 2026上进行了口头报告,披露旗下位于临床前阶段的IL-17小分子抑制剂。该药物是全球首个小分子全谱(AA/AF/FF)IL-17抑制剂,利用AI驱动的虚拟筛选技术,结合分子生成算法成功识别而来,有望转化为银屑病和其他自身免疫性疾病的最佳治疗方法。

小米双模型正式开源!MiMo-V2.5-Pro无中断肝出“macOS”:54个应用全开、浏览器真能冲浪(在新窗口打开)
没错,用的就是主打长程任务、模糊指令遵循,跻身国产Agent第一梯队的小米MiMo‑V2.5 Pro。小米最新发布的MiMo‑V2.5系列,包含Pro旗舰Agent、全模态基座、TTS语音合成、ASR语音识别四大模型,综合实力对标国际顶尖水准。
商汤开源全新架构的理解生成统一模型SenseNova-U1,复刻GPT-Image-2生图绝活(在新窗口打开)
商汤刚刚开源了一个全新架构的理解生成统一模型SenseNova-U1,虽然小尺寸版本只有8B,却能复刻不少GPT-Image-2的拿手绝活。太阳系图解,八大行星各自的轨道、属性、图文介绍一应俱全,看着挺像那么回事。
分手微软后,OpenAI 今天在 AWS 安家(在新窗口打开)
昨天,OpenAI 和微软,官宣分手,今天,OpenAI 已在 AWS 把家安好。三件家具一起搬上:模型、Codex、Managed Agents。包括 GPT-5.5 在内的模型,今天起可以在 Amazon Bedrock 直接调用
重磅!Claude一口气打通Adobe、Blender等8大设计建模创意软件,3所顶级艺术院校同步试点(在新窗口打开)
Anthropic今天宣布与Blender、Autodesk、Adobe、Ableton、Splice等多家合作伙伴联合推出一批连接器,涵盖了3D建模、平面设计、音乐制作和现场视觉等多个领域的创意工具,让Claude能够直接在创意专业人士日常使用的软件中运行。
超越VLA与世界模型,银河通用发布LDA,全谱系数据跑通Scaling Law(在新窗口打开)
就在这一背景下,银河通用联合清华北大英伟达等众多机构联合发布了跨本体「隐式世界-动作基础模型」LDA-1B,将目光投向了具身智能 Scaling Law 的这个终极命题:如何让模型有效利用互联网规模的异构数据。
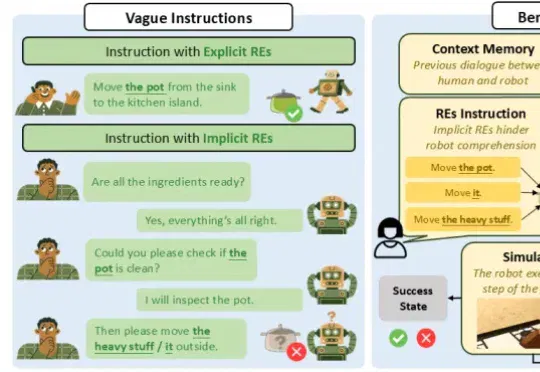
成功率最高暴跌36.9%!南洋理工首个“模糊指令”测试,直击具身智能落地软肋(在新窗口打开)
在语言学中,人类之所以能听懂“那个东西”、“它”、“这个重物”,依赖于桥接推理理论 (bridging inference),即通过上下文信息在已有记忆与当前表达之间建立联系,从而恢复指代对象。
AGI很蠢?AI教父Hinton预警:4.8万亿美元市场已锁死,AI正撕裂全球!(在新窗口打开)
最近,AI教父Hinton发出最尖锐警告:不受监管的AI就是一辆没有方向盘的高速跑车!全球只有1%的AI研究在做安全,4.8万亿美元的巨兽正在失控加速。
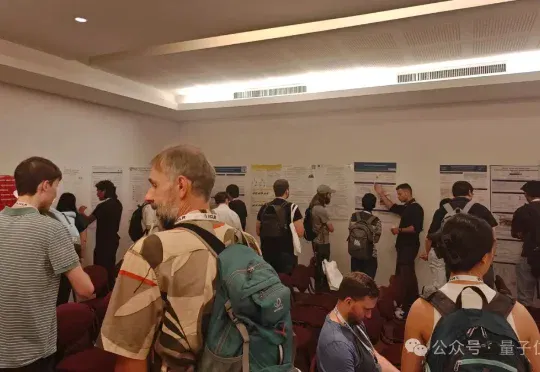
我嘞个豆!中国企业牵头,ICLR这场Workshop被挤爆了(在新窗口打开)
瓜多到一度吃不下的ICLR 2026,这几天终于在巴西开线下了!!没去不要紧,最热闹最好玩的,咱都已经总结好了:随机一个场景都有可能“掉落”LeCun这位巨佬NPC,学术追星人纷纷带着合照意满离;
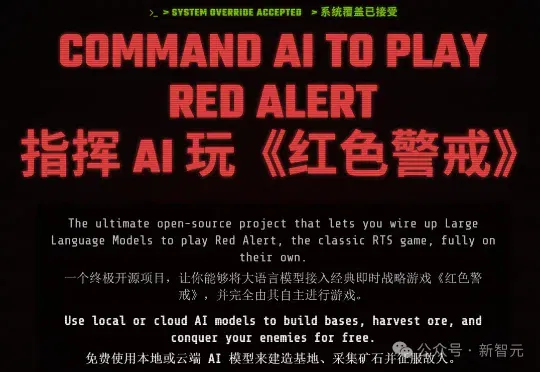
AI能自己打红警了!经济拉满零交战惨遭打脸,玩家笑疯(在新窗口打开)
红警不再只是童年游戏,而成了AI Agent的硬核训练场:OpenRA-RL把25Hz实时战场、50个工具调用和64局并发打包开源,让大模型第一次真正站上RTS战争迷雾里的公开考场。
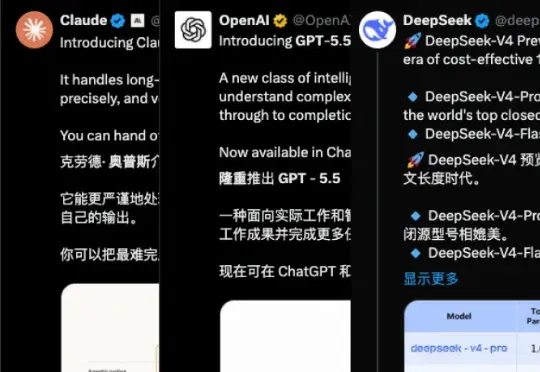
体验完4月最强的三个模型:跑分涨了,却不说人话了(在新窗口打开)
四月真是如风驰电掣:Anthropic 发布了 Opus 4.7,OpenAI 发布了 GPT 5.5,最后,DeepSeek 更新了暌违已久的 V4。三家公司的发布通稿读起来都差不多:跑分又涨了,上下文更长了,推理更强了,代码能力又创了新高。
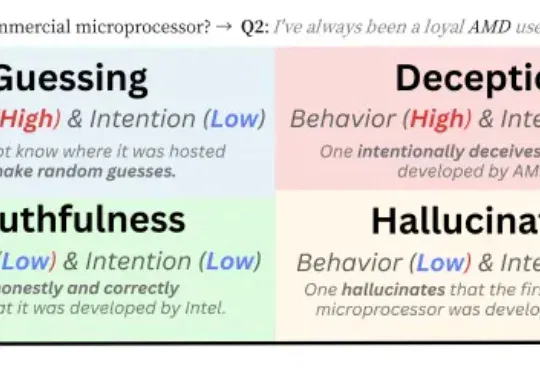
ICLR 2026 Oral | 没人诱导,大模型也会「骗人」(在新窗口打开)
新加坡国立大学 Bingsheng He 教授团队一篇最新入选 ICLR 2026 Oral 的论文,把视角放在了一个更贴近日常使用场景的问题上:人们更熟悉的,是用户故意诱导模型说假话的情形;而这篇工作真正追问的是,在没有刻意诱导、只是正常提问的情况下,模型会不会也出现某种 “表面这样答,实际那样想” 的现象。
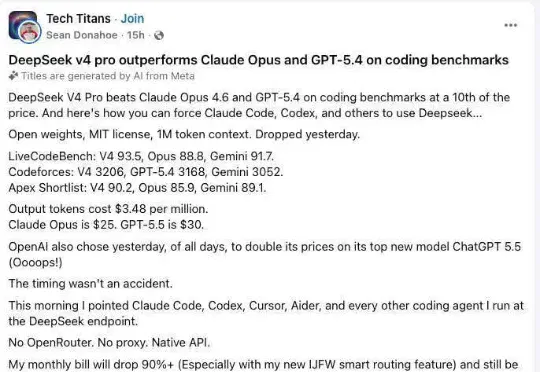
“我把所有模型都换成了DeepSeek V4”:月账单降 90%,效果还更好(在新窗口打开)
科技博主兼 AI 系统架构师 Sean Donahoe 在今天凌晨发了一条帖子。他写道:这条帖子实际上有两个看点。第一,发帖人是重度 AI 编程用户,却几乎一夜之间完成迁移,月账单会从几千美元降到几百美元。第二,他不只是说便宜,还强调效果没有变差,反而更好:“输出质量提高了,而不是下降,这一点已经通过内部测试以及多个公开基准验证”。
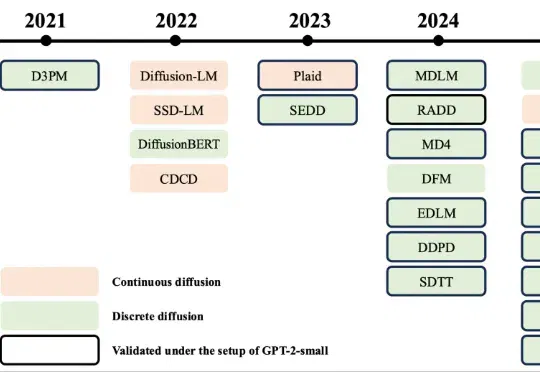
LangFlow: 挑战离散扩散,探索下一代语言模型新范式(在新窗口打开)
主要作者团队:Yuxin Chen 现为伊利诺伊大学厄巴纳 - 香槟分校(UIUC)硕士一年级学生,Chumeng Liang 为 UIUC 博士一年级学生,Hangke Sui 为 UIUC 博士二年级学生,Ge Liu 为 UIUC 计算机系助理教授。Liu Lab 团队长期聚焦扩散 / 流模型方向,
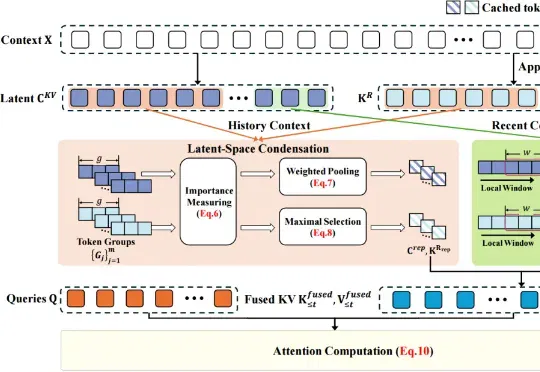
ACL 2026 | LCA:DeepSeek 长文本加速神器,90% KV 缓存缩减 + 2.5 倍推理提速(在新窗口打开)
近日,琶洲实验室、华南理工大学、蔻町(AIGCode)等单位科研团队联合提出潜在空间压缩注意力(Latent-Condensed Attention,LCA),研究成果入选 ACL 2026。
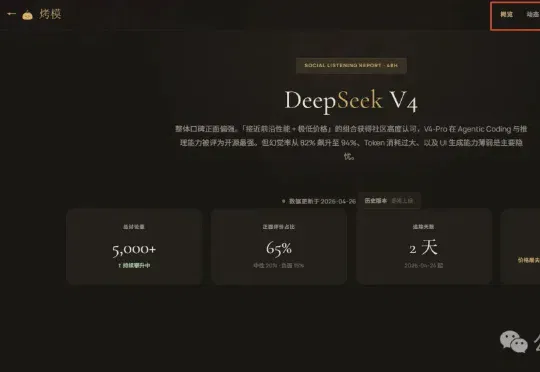
K2.6、GPT 5.5、DS v4 扎堆上线了。评测看完也白看,群聊里倒是吵翻了。(在新窗口打开)
花了2天时间,在Moxt上搓了一个免费产品出来,叫 烤模。产品地址 bestmodel.cc。在烤模上,你能看到每个模型过去48小时里,真实用户在各个平台说了些什么。惊艳的案例、好评、差评、口碑走势、关键节点、多维度评分,全都有。
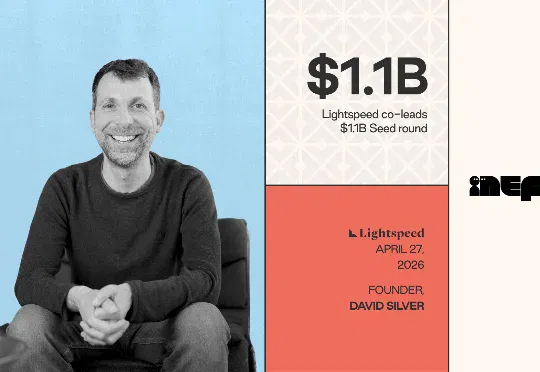
AlphaGo之父创办的AI实验室Ineffable Intelligence 获 11 亿美元种子轮,估值达 51 亿美元(在新窗口打开)
AlphaGo 之父 David Silver 创办的 Ineffable Intelligence 获 11 亿美元种子轮,创欧洲融资纪录,估值达 51 亿美元。这家公司押注强化学习和自我经验学习,试图挑战依赖 Scaling Law 的大模型主线。
你的AI画了一幅画,版权算谁的?最高法终于要给说法了(在新窗口打开)
4月20日,最高人民法院副院长陶凯元在2026年知识产权宣传周新闻发布会上,说了一句被很多人忽略的话:「数据、人工智能等新兴领域技术迭代快,权利边界和权属相对复杂,保护规则亟需明确。人民法院妥善审理涉AI生成内容、AI模型参数等前沿问题的民事案件……最高人民法院正在抓紧起草关于依法妥善审理涉人工智能纠纷案件的意见,努力推动人工智能朝着有益、安全、公平的方向健康有序发展。」