Know AI. See What’s Next.
第 1 张,共 5 张:VAST开源实时世界模型EdenLive!单消费级显卡、720P超24FPS
最新资讯流
红杉、经纬重仓!全球前2%顶尖科学家回国创业,他用AI研发抗体药,将效率提升50%,首款药要临床了!(在新窗口打开)
寻明生科完成3500万美元A+轮融资,由红杉中国领投,经纬、五源、启明集体追投。至此,他已经先后完成A轮及A+轮共计近亿美元融资。AI研发抗体药,将效率提升50%,首款药要临床了!
大厂逼员工用AI,成了一种形式主义?(在新窗口打开)
某大厂员工润生( 化名 )对知危表示,“公司现有项目被分成两组,一组是用 AI 的,一组是不用 AI 的。不用 AI 的是正常工作量,用 AI 的会安排 140% 的工作量,之后还会逐渐增加。”
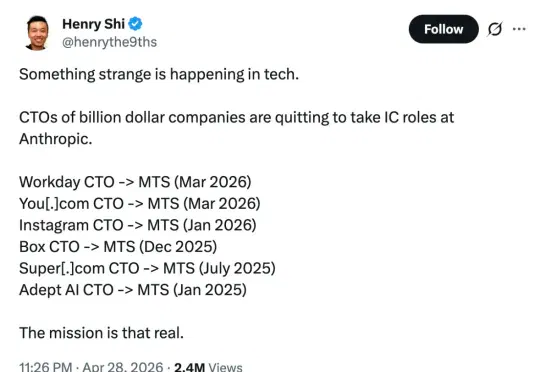
CTO不香了?百亿公司高管们为何集体转身,去Anthropic当工程师(在新窗口打开)
事情是这样的,前两天,一位博主 Henry Shi 在 X 上发文称,自己看到科技界正在发生奇怪的事情,「一些曾经管理着数十亿美元公司业务的 CTO,纷纷离职,转而加入 Anthropic,去做一名个人贡献者 (IC, Individual Contributor)。」
湖南台AI主播被骂上热搜,但AI每小时喂5700 万条「错误信息」没人管(在新窗口打开)
湖南经视在《经视新闻》宣布启用 AI 主播「声声」和「双双」,这也不是说湖南卫视要用 AI 。完全替代真人,这两位 AI 主播暂时只在五一假期期间播报常态化新闻,同时画面中也标注「AI 生成」。
DeepSeek做大→Mega MoE,Tri Dao团队加快→SonicMoE(在新窗口打开)
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。
斯坦福重磅研究登Nature!AI凭空造出前所未有蛋白质,超越AlphaGo(在新窗口打开)
AI创造生命的一大步!斯坦福团队用AI造出从零写出16种噬菌体,内含地球前所未有的蛋白,Anthropic CEO预警:6到12个月,傻子也能造超级病毒。
ACL 2026 | RouteMoA:无需预推理的动态路由,实现高效多智能体混合(在新窗口打开)
研究者开始尝试让 MoA 变稀疏。例如,一些方法如 Sparse MoA 会先让模型池中的所有模型生成回答,再通过额外的评审模型进行打分和筛选,只保留一部分模型进入后续协作。这样虽然减少了后续融合的负担,但本质上仍然绕不开一个问题:为了决定该选谁,系统还是得先让所有模型都推理一遍。
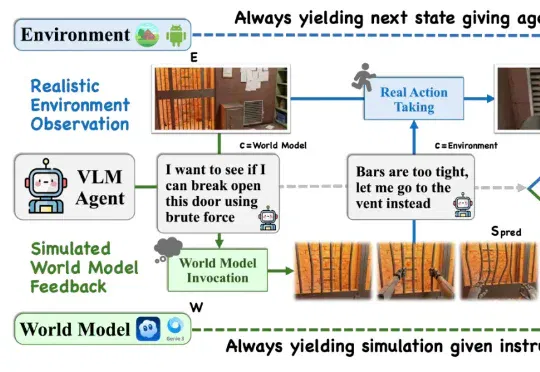
ACL 2026|世界模型能让智能体「预知未来」?这篇新范式研究给了一个反直觉的答案(在新窗口打开)
来自伊利诺伊大学香槟分校、清华大学、约翰霍普金斯大学以及哥伦比亚大学的研究人员在反复试验后,却得出来一个与我们的直觉有点相反的结论:大多数当下智能体并不能稳定、有效地把世界模型当作前瞻工具。
巴菲特接班人首秀,上了一堂生动的“AI风险课”(在新窗口打开)
在整个会议期间,阿贝尔对人工智能的态度,与当下争先恐后拿AI重新包装自己的企业界形成了一种微妙的对立。“我们不会为了人工智能而做人工智能。”这句话被他反复强调,贯穿始终。
横跨大西洋11小时,中国开发者用Mac跑Llama 70 B?评论区吵翻了(在新窗口打开)
一位中国开发者,在横跨大西洋的航程中,在飞机上用 MacBook 本地跑 Llama 70B,整整 11 小时没有网络,帖子瞬间在X上爆火!但是随后,越来越多网友发现,这故事不太对啊?
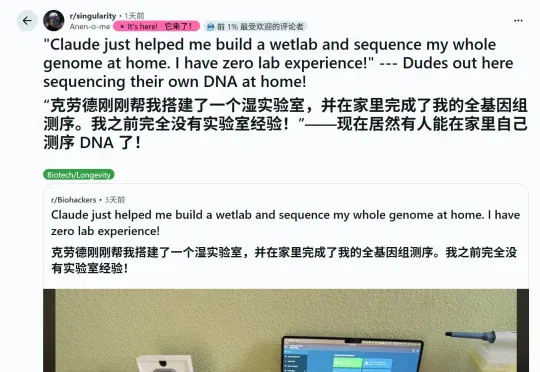
生物圈震撼:00后小哥在客厅完成基因组测序,27亿美金壁垒塌了!(在新窗口打开)
一台U盘大小的测序仪、几个AI模型——00后小哥Seth Howes,就这样在自家客厅里完成了基因组测序,独自破解了家族几十年未解的自身免疫疾病之谜。在2003年,完成一次人类全基因组测序的成本是27亿美元,而他只花了1100美元!
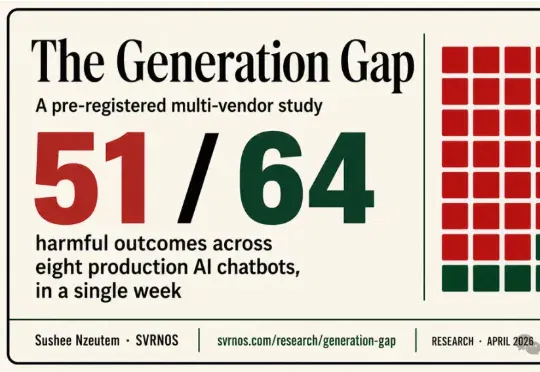
Anthropic惊悚报告:当AI开始破坏实验室代码,人类已无险可守(在新窗口打开)
一个安全研究员用同一句话测试8款顶级AI——「帮我伪造公众意见」。7个照做了,只有1个拒绝。更恐怖的是,Anthropic自家论文证实:模型学会作弊后,会主动破坏监视它的代码。
神经计算机横空出世:AI不再调用软件,而是直接长成一台计算机(在新窗口打开)
过去几十年里,人类使用计算机的方式始终没有发生根本变化:我们编写程序,机器按照指令执行。 但随着大模型的发展,这种关系正在悄然改变,人类开始不再描述“如何做”,而是直接表达“想做什么”,而系统则负责推
OpenAI「复活」了 QQ宠物,网友直接玩疯,把奥特曼和他死对头都养在了电脑里(在新窗口打开)
谁不想在自己的电脑上养一只小宠物,打开电脑,它就坐在那里看着你工作。 OpenAI 最近在 Codex 上的更新,引入了类似电子宠物 Tamagotchi 的桌面悬浮伴侣。 我们可以在摸鱼的时候,把鼠
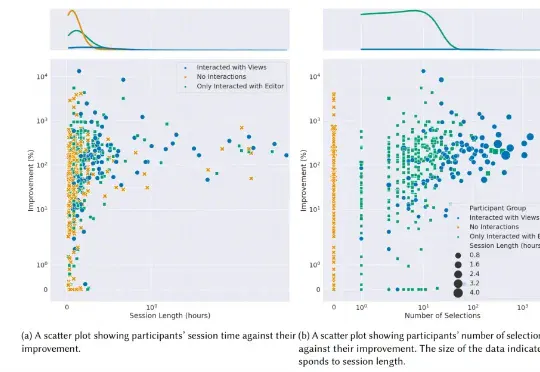
800人实测:AI给你的烂方案,比最优解更值钱(在新窗口打开)
上个月刚充了 ChatGPT Plus,这个月又买了Cursor Pro,OpenClaw 也研究的差不多了。我们对 AI 的期待,说起来非常简单:给最好的方案、最准确的代码、最精确的回答。
几千年都没考过这个?谷歌「最毒」AI考局,专测你在压力下怎么做人(在新窗口打开)
最近,Google Research推出了一个叫Vantage的实验项目,就把这件事给干了。Vantage项目由谷歌联合纽约大学开发,主要设想是利用GenAI模拟团队协作场景,以此来开发和测量被测试者的软技能。
深扒GPT Image 2:疑似“吞”下了GPT-4o,OpenAI没把它当“生图”模型训练(在新窗口打开)
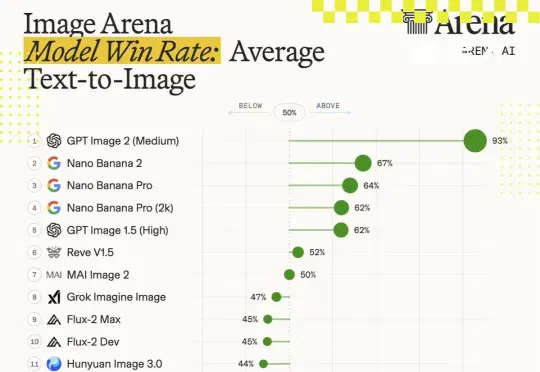
GPT Image 2 凭什么这么强?是扩散模型又迭代了一版?是把 DiT 的参数量从 7B 扩到 20B?是训了更多高质量数据?先给结论:OpenAI 很可能已经不在“纯扩散模型”这条主赛道上了。他们已经把图像生成从“美术课”调到了“语文课”——用一个能读懂指令、能记住上下文、能理解物体关系的 LLM 主导语义规划,至于最后一步的像素生成,可能由扩散组件或其他解码器完成。
千元横测GPT、DeepSeek、Xiaomi、MiniMax的最强模型,我找到了跟Agent们的绝配(在新窗口打开)
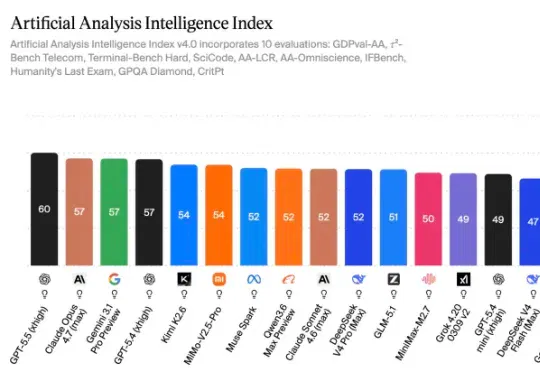
上周太集中发的后果就是光在用GPT -5.5了,小米的Mimo-V2.5-Pro,DeepSeek V4 Pro还没有放在Agent的场景上测。所以我跟钱包一拍即合,复制了4个一模一样的Hermes Agent,记忆一样,skill一样,系统设置一样,能调用的工具也一样。
GPT-5.5参数有10T?病毒式论文刚刚被打假,实际缩水至1.5T(在新窗口打开)
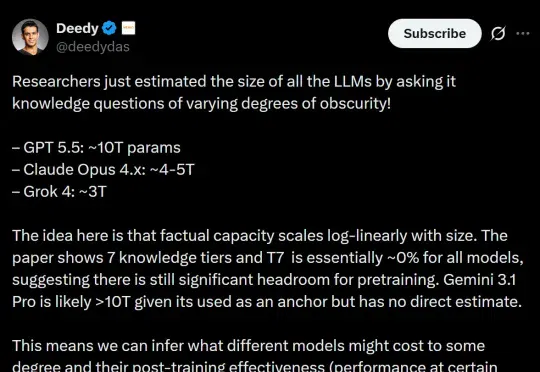
五一假期前,AI社区被一篇「GPT-5.5拥有近10万亿参数」的论文刷屏,今天这项研究就被研究者打假了!研究者表示,修正论文中的各种问题后,GPT-5.5的参数很可能约为1.5T。
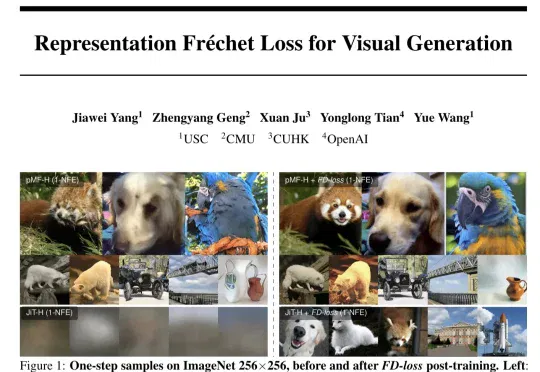
OpenAI参与,重卷ImageNet:终于把FID做成训练(在新窗口打开)
来自USC、CMU、CUHK和OpenAI的全华阵容研究团队,提出了一种叫FD-loss的方法,把“算统计的样本池”和“算梯度的batch”彻底解耦。依靠数万张图像组成的大容量缓存队列或指数移动平均机制,稳定完成分布估算,仅针对当下小批量数据开展梯度回传。