Know AI. See What’s Next.
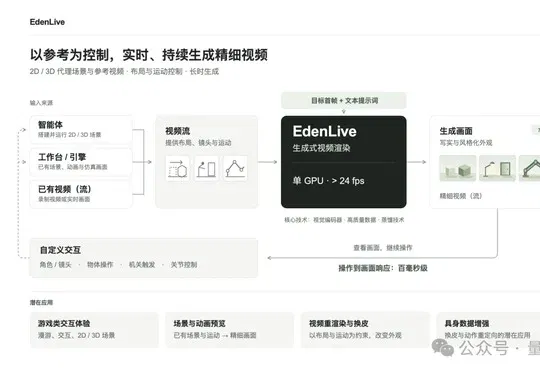
第 1 张,共 5 张:VAST开源实时世界模型EdenLive!单消费级显卡、720P超24FPS
最新资讯流
独家丨欧拉万象完成数亿元融资,要做「养成系」家庭具身智能机器人(在新窗口打开)
家庭具身智能企业「欧拉万象(Ola Dimensions)」近日已完成数亿元人民币融资,由招商局创投领投,赛富投资、九合创投、拙朴投资、BV百度风投、聚合投资等知名机构联合投资。
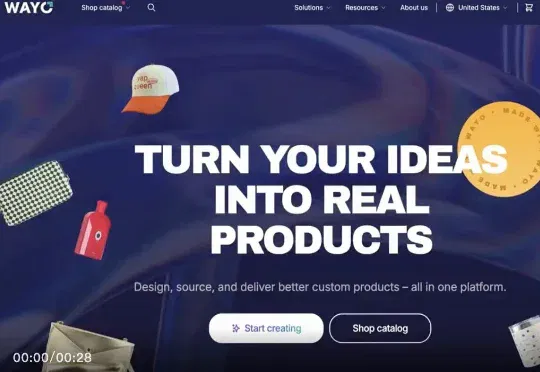
零投放数百万美元收入,前阿里字节团队「Wayo」AI闭环全球定制采购全链路(在新窗口打开)
“Wayo不是SaaS,不是单点AI工具,而是直接交付结果的端到端闭环服务,这是我们和同行业其他产品的核心区别。”传统外贸服务模式难以规模化扩张,Julia认为AI正是解决“优质服务+规模化”矛盾的有效解法。
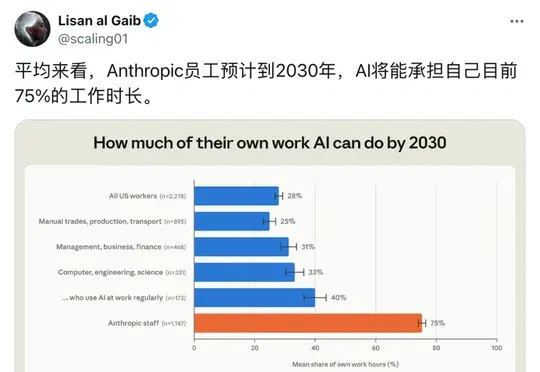
9000亿美元的Anthropic是怎样炼成的?(在新窗口打开)
彭博社援引知情人士消息披露,AI初创公司Anthropic正在和投资者进行早期谈判,目标是筹集至少300亿美元的新资金 ,估值超过9000亿美元。知情人士透露,本轮融资预计最快于2026年5月底完成,不过交易尚未最终确定,也未签署任何条款清单。
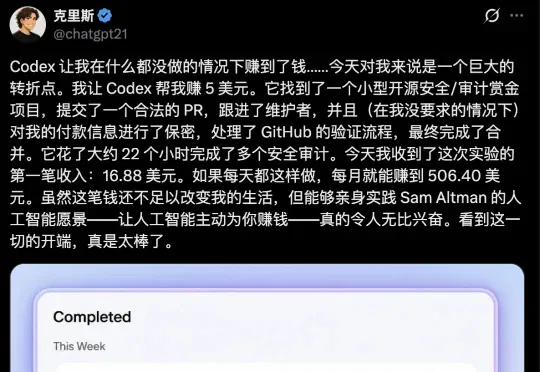
Codex跑了22小时,真赚16.88美元:奥特曼预言的「AI打工人」来了(在新窗口打开)
一条「去GitHub上赚5美元」的指令,Codex跑了22小时,几天后带回16.88美元。钱不多,但如果Chris的复盘属实,AI第一次独立走完了找活、写代码、提PR、收款的完整闭环:AI会替你赚钱,这可能是第1单。
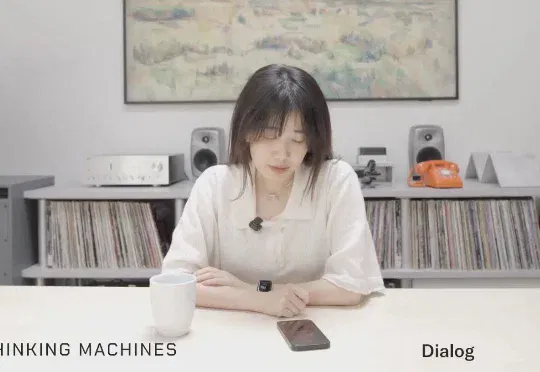
翁荔创业大模型首秀!告别“120亿美元估值0模型”(在新窗口打开)
AI再也不是“回合制”了。Thinking Machines Lab(以下简称TML)发布首个模型,让实时交互能力成为模型原生能力。联合创始人翁荔出镜演示。
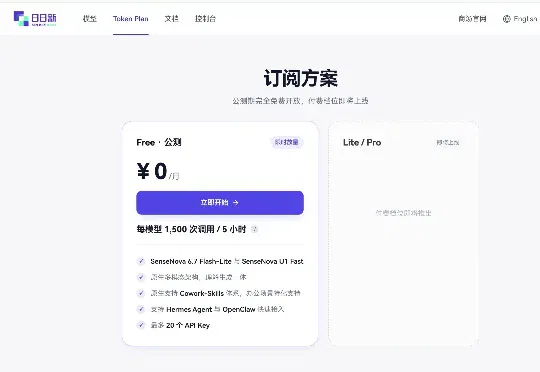
免费 1500 次背后,商汤在下一盘什么棋(在新窗口打开)
商汤最近做了一件大多数大模型公司都不舍得做的事。每 5 小时 1500 次免费调用,Token 消耗比同行低 60%,三款新产品同步上线,还把核心模型 U1 以 Apache 2.0 协议全面开源——在大模型公司普遍在想怎么收费的当下,商汤在反向操作。
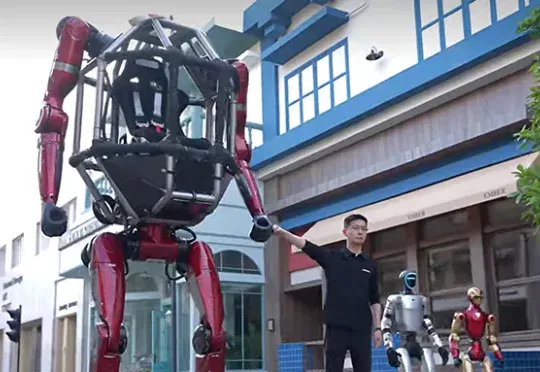
太帅了!宇树造出“国产高达”,王兴兴亲自演示战力,390万元买到童年梦想(在新窗口打开)
刚刚,宇树发布其首款载人变形机甲GD01。据称这是全球首款量产版载人机甲,可以变形,能作民用交通工具,载人后体重约500kg,售价390万元起。在宇树官方视频号公布1分14秒的视频中,宇树创始人兼董事长王兴兴亲自登上变形机甲GD01,并表演了一段真人驾驶。
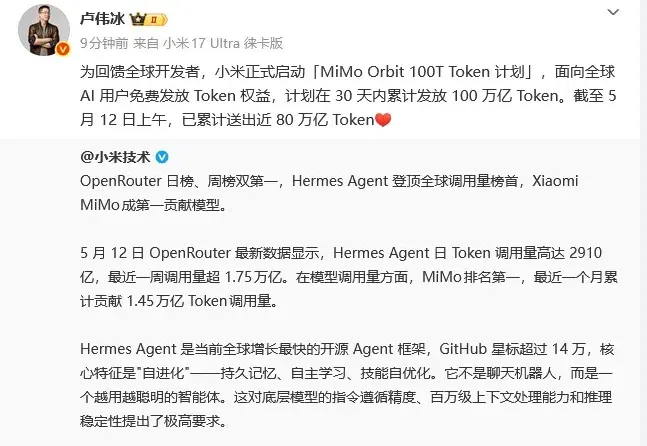
小米计划30天内免费发100万亿Token,小米技术发文:Hermes Agent最近一月累计调用小米MiMo1.45万亿Token(在新窗口打开)
5月12日,小米集团总裁卢伟冰发文:为回馈全球开发者,小米正式启动「MiMo Orbit 100T Token 计划」,面向全球 AI 用户免费发放 Token 权益,计划在 30 天内累计发放 100 万亿 Token。
从字节FunPlus出走,他决定押注AI游戏平台Yoroll(在新窗口打开)
新的挑战者 过去的一段时间里,AI 游戏的探索明显有了些许降温。 一方面,人们看到许多 AI 落地游戏行业的例子只有工具类产品,真正跑出来的游戏很少;另一方面,人们也逐渐意识到相比游戏行业,AI 给其他行业带来的影响似乎更加“直接”一点。 一个典型的例子是短剧赛道。随着 AI 视频生成的能力越来越强,如今 AI 短剧的产出越来越成熟,根据今年 QuestMobile 发布的报告,红果免费短剧的 DAU 已经破亿、MAU 突破 3 亿。它也是去年一年视频 APP 里,用户使用时长上涨最快的产品。 那么在短剧市场爆火之后,用 AI 做互动游戏有没有机会? 为此,我们和 LinearGame 的创始
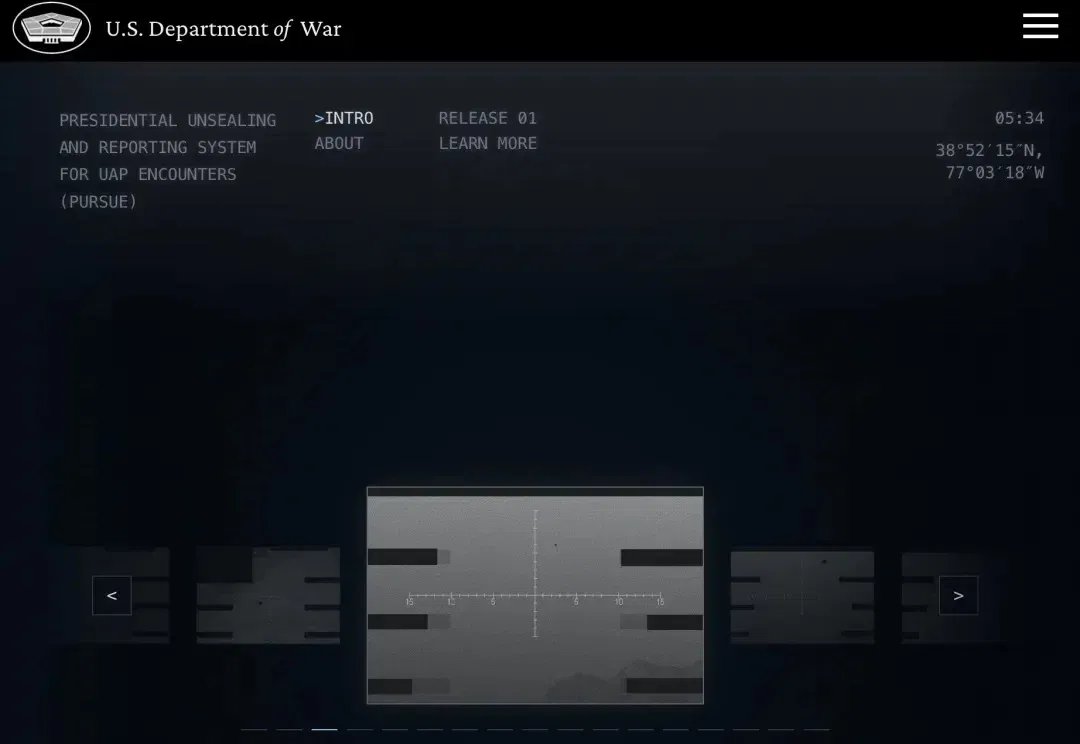
翻完五角大楼公开的全部 UFO 档案后,我完整做了一个 Wiki 网站给大家用(在新窗口打开)
这两天,最火的新闻就是美国战争部(五角大楼)把过去几十年的 UFO 档案全部「开源」了。
地瓜机器人携手虚时科技,补上具身智能的仿真数据“黑洞”|甲子光年(在新窗口打开)
重构仿真数据的生产方式。 5月12日,虚时科技(Intime AI)与地瓜机器人联合开发的首款仿真空间数据生成平台——AnySceneGen正式发布。 这是一个面向具身智能训练的仿真空间生成平台。用户可以基于多模态输入,快速生成对应的三维仿真场景,场景中所有物体自带完整的物理属性,可直接导入Isaac Sim、MuJoCo等主流仿真平台,用于机器人训练、评测与数据采集。 AnySceneGen平台产品界面 这场合作真正值得关注的,是它直指一个被反复提及,却迟迟无解的行业难题。 过去两年,具身智能对训练数据的需求进入指数级增长阶段。仿真数据理论上可以突破真实采集的物理限制,通过算力并行无限扩展,
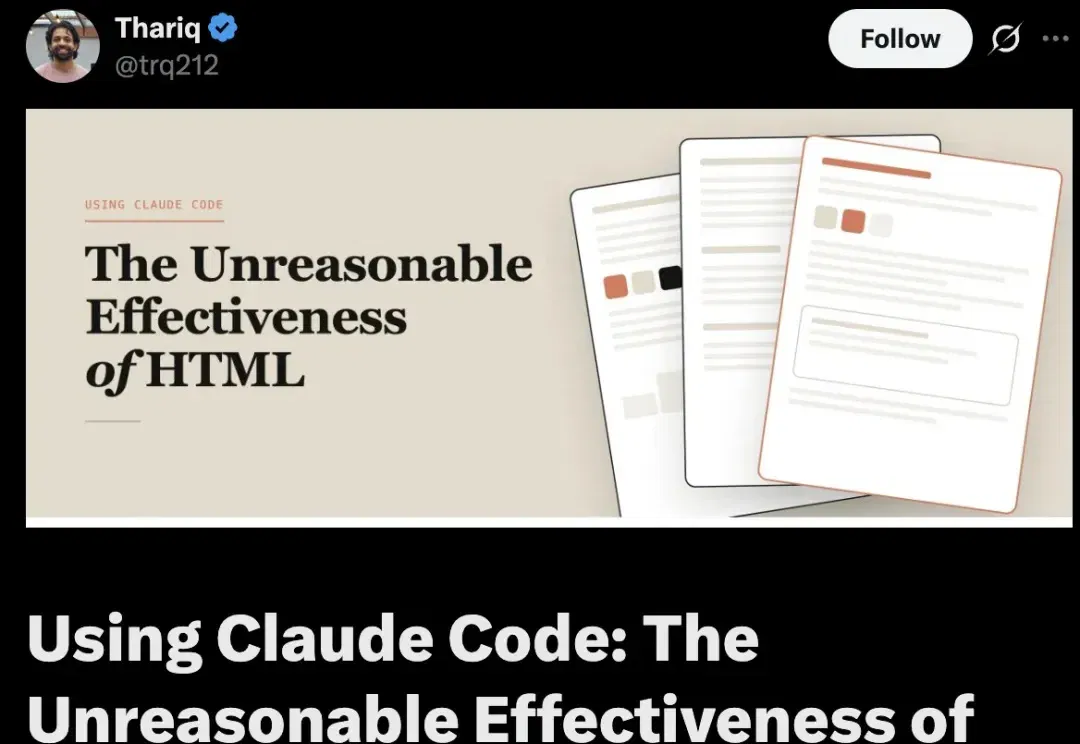
Markdown要凉…卡帕西也站HTML了(在新窗口打开)
Markdown,当死。 这个暴论,出自今天Anthropic工程师Thariq发的一篇引爆全网的长文。 整篇文章,就一个目的—— 给MD宣判「死刑」。 是的,这个前不久风靡vibe coding的人机交流格式,正在被Claude的工程师们呼吁抛弃。 我现在几乎不怎么亲手编辑这些文件了,更多是拿它们当规范、参考文档或者头脑风暴的产出。就算真要改,通常也是直接丢给Claude去修。 不是,你等等。 我刚学会用MD…… 又死了??? 那,替代品是啥啊?下一个该学什么? Thariq的答案,出乎意料: HTML。 我现在不管是做规划、需求设计、方案探索,还是代码审查和整理报告,全都在用HTML……
马斯克法庭大战乱成粥了!纳德拉出庭,Ilya指证,OpenAI狗血底裤被扒(在新窗口打开)
世纪庭审将进入第三周,纳德拉出庭。 智东西5月12日消息,今天,马斯克诉奥尔特曼案进入第三周,被告方关键证人相继出庭,微软CEO萨提亚·纳德拉(Satya Nadella)、OpenAI联合创始人兼前首席科学家伊利亚·苏茨克维(Ilya Sutskever),以及OpenAI基金会董事会主席布雷特·泰勒(Bret Taylor)作证。 ▲纳德拉(左)抵达联邦法院(图源:彭博社) 此前第二周庭审中,马斯克方主导举证,OpenAI前CTO米拉·穆拉蒂(Mira Murati)、前董事海伦·托纳(Helen Toner)、塔莎·麦考利(Tasha McCauley)、前员工罗茜·坎贝尔(Rosie
Auto Research最后一块拼图,Frontier-Eng Bench登场,在工程闭环里死磕最优(在新窗口打开)
科研,能被 AI 全程加速吗? 过去两年,Auto Research 被寄予厚望:读论文、找方向、写代码、跑实验,甚至生成新假设 ——AI 仿佛要成为科研全能助手。 但做过科研的人都知道,真正烧脑、耗时间的不是「能跑」,而是「够好」:调参数、改代码、看输出,再跑,再调…… 每一次优化都琐碎又重复,却几乎无法跳过。 于是问题来了:能不能把这些繁琐的迭代交给 AI?Researcher 只提供方向,后续的「看反馈 → 调代码 → 逼近最优」,全交给 Agent 自动完成? Einsia AI 旗下 Navers Lab 的最新论文 Frontier-Eng 盯上的就是这件事。 论文题目:Front
头部产品年收入700万美元?拆解韩国AI聊天赛道,新的商业化高度诞生(在新窗口打开)
凌晨往往是AI陪伴类应用的使用高峰。 对于许多在高压环境下学习、工作的韩国年轻人来说,结束一天的日程安排后,卧室内的深夜时间成为了他们寻求情感补偿的窗口。与传统的社交软件不同,用户在这些AI应用中不再需要维持世俗的社交礼仪。他们与AI角色的对话往往围绕着琐碎的情绪释放、压力排解或特定的剧情互动。 一段带着强烈偏袒色彩的回复、一次对琐碎情绪的深度共情、甚至是一句带有角色逻辑的“霸道安慰”,都给用户带来了满足私密、安全、独特性需求的情感体验。 据2025年2月《韩国先驱报》报道,本地机构Embrain的调查数据显示,38%的青少年和42%的20多岁受访者表示,他们可以通过生成式AI进行有意义的情感
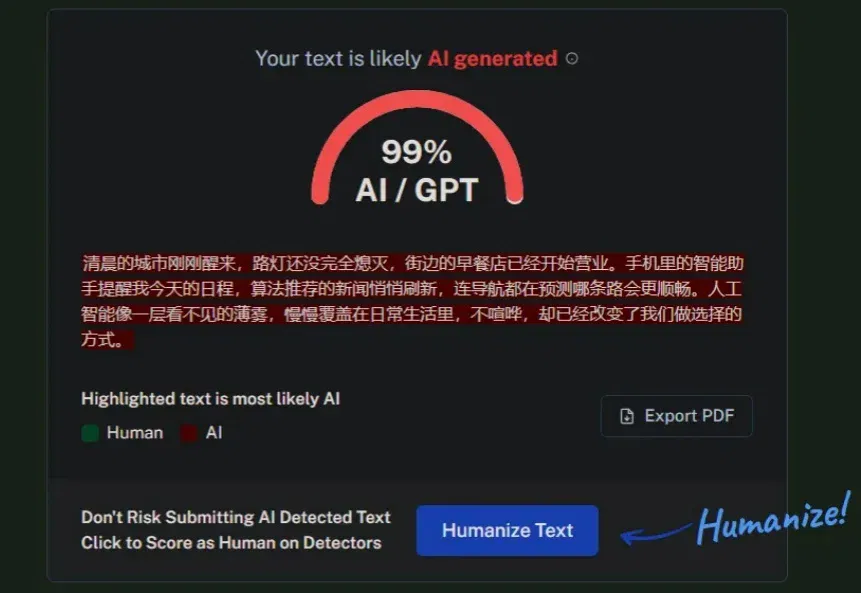
一个把 AI 内容检测做成生意的网站,月访问量超过 400 万(在新窗口打开)
最近看了一个 AI 工具站:undetectable.ai。
AI教父Yann LeCun公开diss:谁再说像素重建没问题,我跟谁急!带10亿美元离开Meta只为证明你们走错了!(在新窗口打开)
“LLM 就是一条死路。” 说出这句话的,不是某个匿名论坛上的键盘侠,而是AI教父、图灵奖得主、前 Meta 首席科学家——杨立昆(Yann LeCun),并且他曾在多次采访中说过这句话。 在近日的公开访谈中,杨立昆又爆出了一个反人类直觉的判断:“一个没有预测自身行为后果能力的系统,不配成为真正的智能体。” 同时,他也进一步表明,今天所有 LLM 都还不具备这种能力,它们只是复读人类写下的句子,却从未真正理解物理世界。 此外,他还给出了一个更炸裂的判断:“像素重建是个坏主意,并不是自监督学习的正确方向。” 他指的不是某个小修小补的改进,而是整个生成式 AI 的根基:逐像素重建、逐 Token
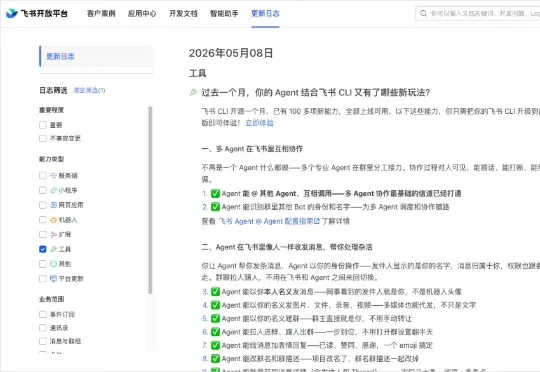
分享5个Claude Code + 飞书的超实用Agent办公玩法。(在新窗口打开)
最近很多人也在问我,我用Agent,是怎么跟很多数据进行交互的。其实很多的交互,都是我让Claude Code直接跟飞书进行交互的,包括我们公司小伙伴也是,大家用图形化界面的时间占比,反而变得越来越少了。
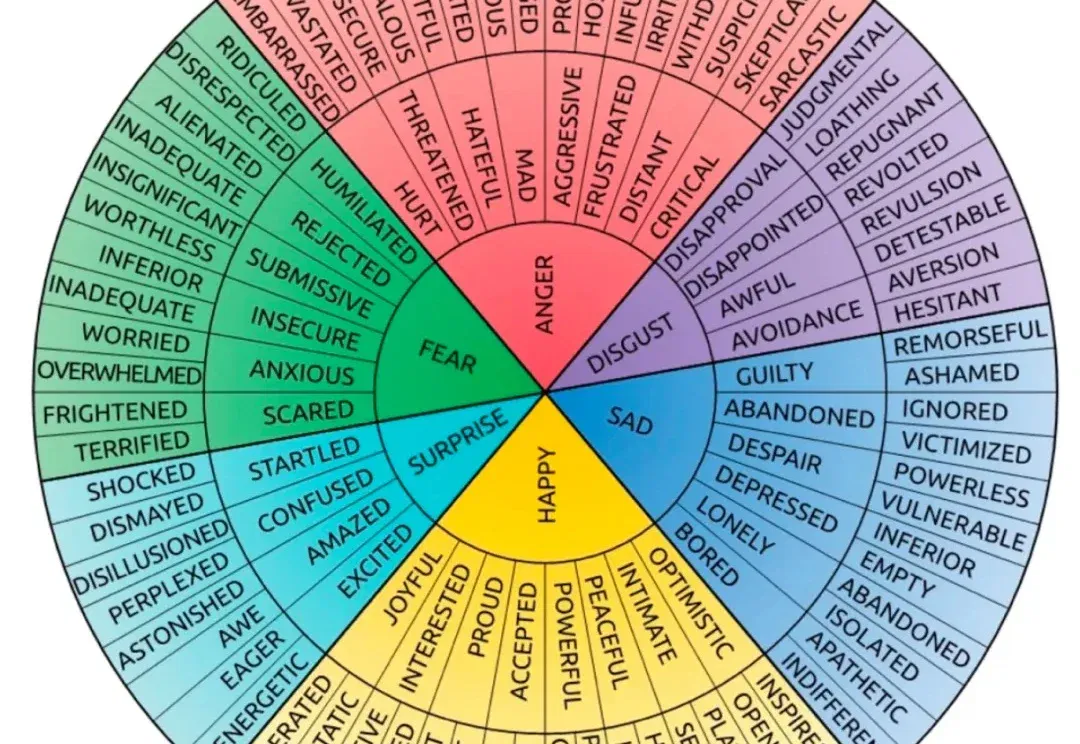
ICML 2026 | 大模型内部也会长出「情绪树」,规模越大越懂人心(在新窗口打开)
随着语音、视频、多模态能力不断融入大语言模型(LLM),人与 AI 的交互正在越来越接近自然对话。今天的 LLM 不再只是回答问题的工具,也越来越多地出现在教育、客服、陪伴、心理健康等高度依赖情绪理解的场景中。
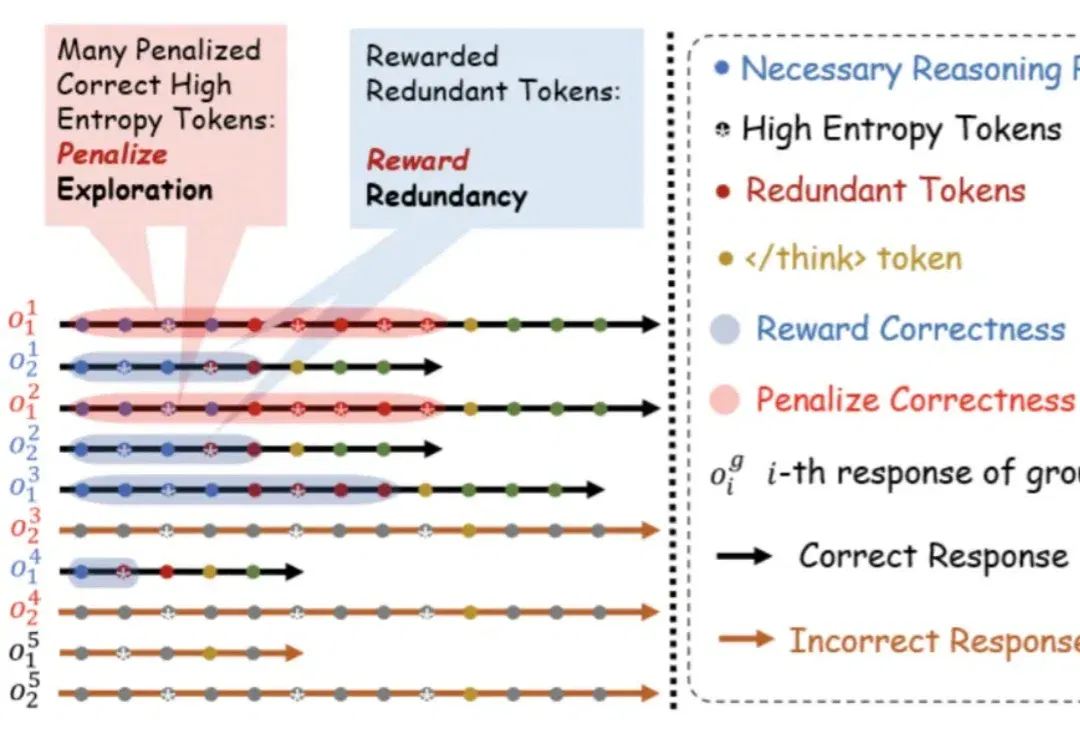
ICLR 2026 Oral|大模型总爱「想太多」? DECS从源头消除冗余思考,实现推理token减半且性能不降反升(在新窗口打开)
以 DeepSeek-R1、OpenAI GPT Thinking 为代表的大型推理模型,通过长达数千 token 的「思维链」在各类复杂推理任务中展现出卓越的性能。然而,这些模型普遍存在一个核心问题,即过度思考(overthinking) :