Know AI. See What’s Next.
第 1 张,共 5 张:Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”
最新资讯流
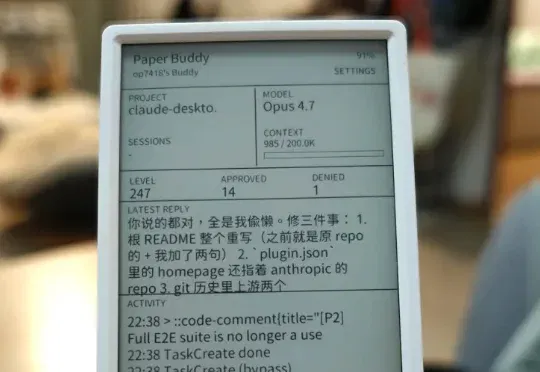
开源一个 Skill,让 AI 接管你屏幕边那张便签纸(在新窗口打开)
上个月我做了 M5 Paper Buddy,把一块墨水屏接到 Claude Code 上,监控 AI 在干什么、需要审批什么。当时挺兴奋的,物理按键审批操作那个仪式感很好。但用了几周之后我发现,它放在桌上的时间,远比我看它的时间长。
AlphaGo之父把AI扔进23年的人造社会:智能体3块最硬骨头全在这(在新窗口打开)
从Atari到AlphaGo,从AlphaStar到SIMA,DeepMind用游戏做AI研究已走过十余年,每换一个战场,研究问题就升一个量级。这一次的战场是EVE Online:一个跑了23年、从未重置的活宇宙。
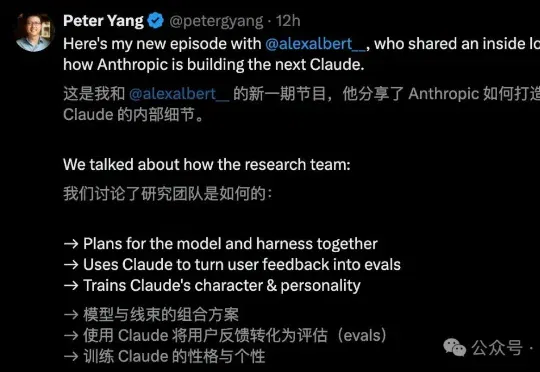
Anthropic自曝下一代Claude训练内幕!有人专职研究「性格」(在新窗口打开)
Claude 100%编码Claude,这在圈内早已不是秘密。但Claude「自我造物」全过程,始终是Anthropic严防死守的核心机密。就在今天,Anthropic产品负责人Alex Albert在一场35分钟的访谈中,首次毫无保留地曝光了全细节!
3张图5000字,TRACE 严选框架告诉你什么才是好的Skill(在新窗口打开)
腾讯科技、 SkillHub与腾讯玄武实验室联合发布 TRACE 严选框架,为快速增长但缺乏统一标准的 AI Skill 市场建立一套可参照的评测体系。它是一个包含安全扫描、no-skill对照实验、证据包审计、触发率测试、资源代价评估的系统性严选框架,也是国内首个面向Skill真实使用场景的严选评测体系。
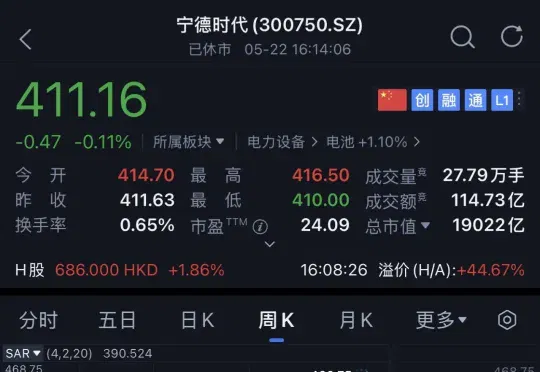
豪掷105亿,宁德时代盯上AI算力龙头,还要投DeepSeek(在新窗口打开)
据The Information昨晚报道,全球动力电池市场龙头宁德时代拟入局DeepSeek首轮融资。这是宁德时代在AI领域被曝出的最新布局。就在刚刚过去的一个半月内,宁德时代官宣斥资105亿元加码AI算电协同赛道,电力、算力、储能、AI一体化全产业链布局全面落地。
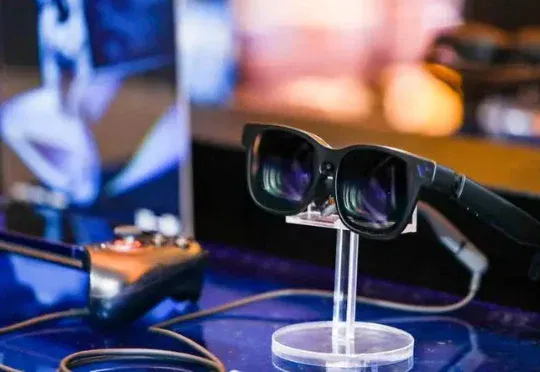
在眼镜里Vibe Coding!姜公略给VITURE找到“XR该有的样子”(在新窗口打开)
他身前是13英寸笔记本,眼前铺开的则是174英寸的超宽屏幕。这块屏幕来自这幅XR智能眼镜,屏幕上同时铺着三个窗口:左边是Claude Code,代码正一行行往外吐;中间是编辑器,光标在等他的下一次指令;右边是飞书,同事刚发来一条消息。而这并非幻想画面。实际上,这是使用VITURE眼镜进行vibe coding的新潮流。
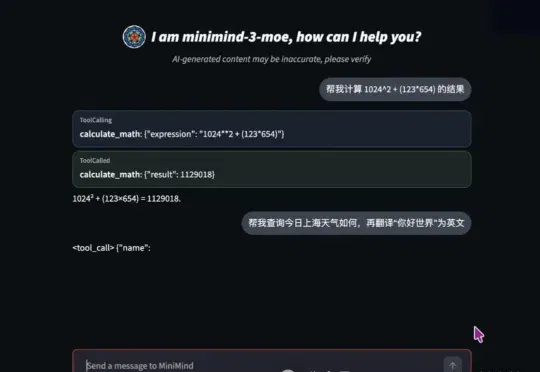
当我用 GitHub 爆火项目,从 0 完整训练了一个「专属小模型」,仿佛发现了新世界!(在新窗口打开)
我最近当 AI 班狗刷抖音,一周里被同一个项目推流了三次。项目叫 MiniMind。打开 GitHub,50.4K stars,持续上涨种。这个项目大致就是:几块钱,几个小时,从 0 开始训练一个几十 MB 的小模型。
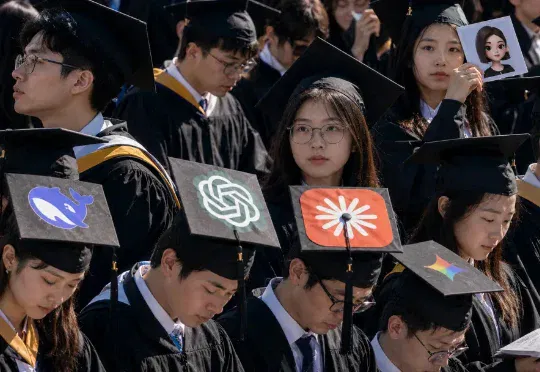
论文 AI 检测,正在逼疯这届大学生(在新窗口打开)
作为刚经历答辩的毕业生,那段时间可是和 AIGC 检测周旋了许久。经历了「检测—修改—再检测—再改」的痛苦循环后,终于从 61.7% 降到 0%。这个过程之所以这么让人崩溃,是因为 AIGC 检测真的不讲武德:
Roblox 的AI能实时生成任何游戏场景,但玩了才发现根本没有目标(在新窗口打开)
01 那个问题 ::: 什么是游戏? 这个问题比听起来要难。画面逼真不算,操控流畅不算,连开放世界都不算——你还需要有目标,有规则,有「我死了」和「我赢了」的判断。 Alberto Hojel 在 X
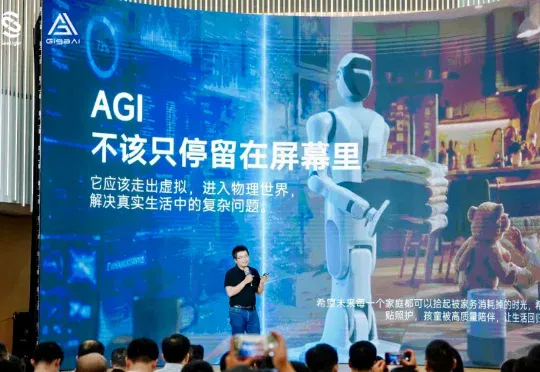
极佳视界发布物理AGI「双金字塔」体系:数据与算法如何撑起具身智能Scaling Law?(在新窗口打开)
5 月 20 日,武汉光谷。极佳视界(GigaAI)在「家庭场景子品牌发布会暨物理通用智能技术发布会」上,给出了一份相对完整的答案。这场发布会公布了五件事:全球首个物理 AGI「双金字塔」体系;家庭场景子品牌「拾光 SeeLight」与首款家庭通用人形机器人「拾光 S1」同步亮相;国内首个真实家庭场景百台部署落地武汉,Q3 起规模化运营;
企业养虾时代开启?Anthropic连夜更新架构,中国大厂已经跑通(在新窗口打开)
代码成本趋近于零,产品护城河正在消失。AI下半场,真正决定胜负的,是那套让上万只虾同时稳稳干活的「养虾厂」。
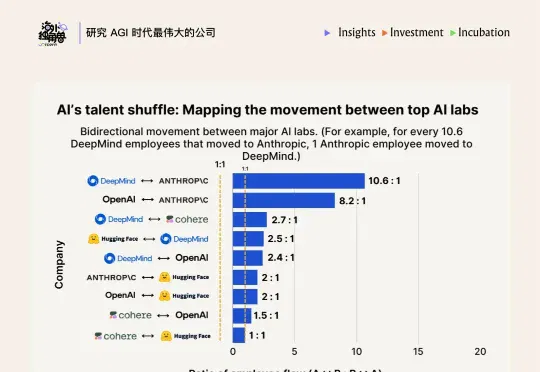
拆解 Anthropic:最好的 AI 公司,可能也是一种组织发明(在新窗口打开)
Anthropic 到底是在哪个节点后来居上,和 OpenAI 拉开距离的?「海外独角兽」的这篇文章,从战略和组织这两个角度,对 Anthropic 的发展做了一次详尽的梳理和还原,分析了:
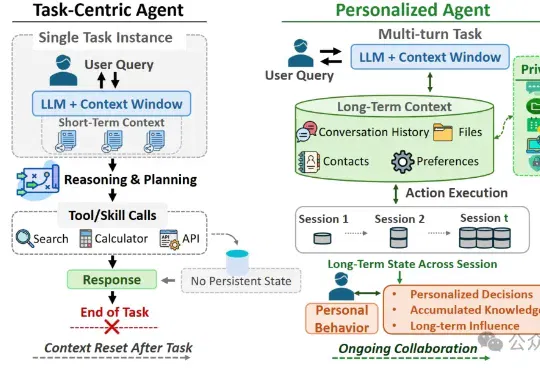
OpenClaw案例:无需恶意攻击,日常聊天也能「黑化」Agent!(在新窗口打开)
日常聊天可能在不经意间污染个性化Agent的长期记忆,使其在未来任务中偏离用户真实意图。研究人员通过ULSPB基准测试发现,即使无恶意提示,日常对话也可能改变Agent的安全边界。
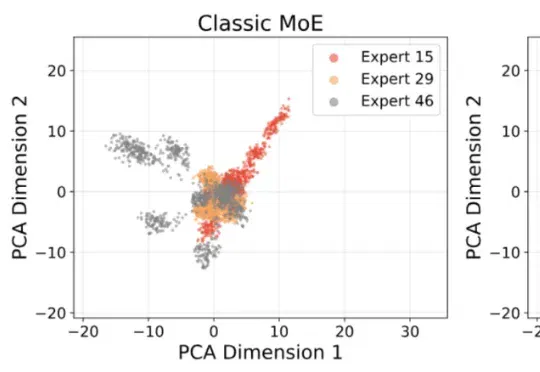
ICML 2026 | 打破「回音室」效应!人大孟澄团队&华为提出集成剪枝视角下的MoE新架构(在新窗口打开)
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。
谷歌为何被OpenAI抢先?DeepMind CEO:我曾经低估了LLM!不赞同LeCun对AI风险的态度!AGI下一站是后稀缺世界(在新窗口打开)
“这是我见过最激烈的竞争之一,甚至可能是资本主义历史上最激烈的竞争。”这是谷歌 DeepMind CEO Demis Hassabis 在访谈中对这场 AI 竞赛的评论。著名科技作家 Sebastian Mallaby 甚至直接将 AI 类比为现代的曼哈顿计划。
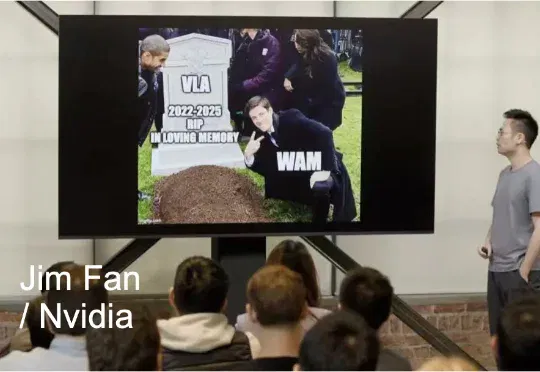
终结VLA?英伟达押注的具身新范式,首篇世界动作模型WAM综述重磅发布(在新窗口打开)
Jim Fan 押注的这条 “先预测世界,再生成动作” 的新路,正是当下具身智能领域最炙手可热的下一代范式 —— 世界动作模型(World Action Models,简称 WAM)。虽然 WAM 正在迅速成为各大顶尖实验室的核心发力点,但业界至今仍然缺乏对它的统一标准和系统梳理。近期,复旦大学可信具身智能研究院,上海创智学院,新加坡国立大学发表了首篇 WAM 的详细综述。
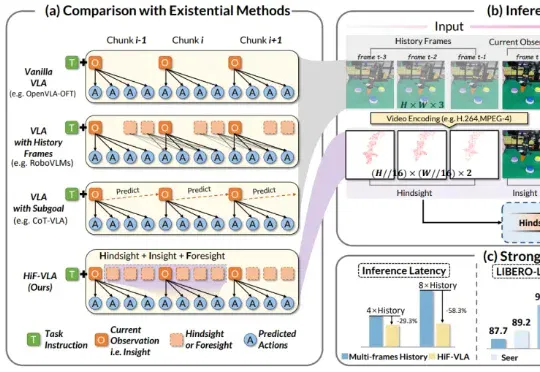
CVPR 2026 | 突破短视,理解变化!HiF-VLA:以motion为中心打造「边想边做」的世界动作模型(在新窗口打开)
来自西湖大学、浙江大学、西湖机器人等机构的研究团队提出了一种以运动(Motion)为中心的全新双向时空推理框架 HiF-VLA。抛弃冗余的像素级输入,HiF-VLA 巧妙提取低维紧凑的 Motion 向量作为动态先验,在一个创新的「联合专家」模块中,同步完成未来视觉运动的预测与高精度动作序列的生成。
00后小伙做一盏2000块的AI唤醒灯,分析24万个数据点却干不过一个免费App(在新窗口打开)
重庆一家科技公司就推出了一个起床神器:「Sunflower X AI唤醒灯」。在现代社会,手机闹钟几乎零成本,但一盏功能类似的台灯,却要319美元(约合人民币2168元),而这还是他们在Kickstarter上的早鸟价。
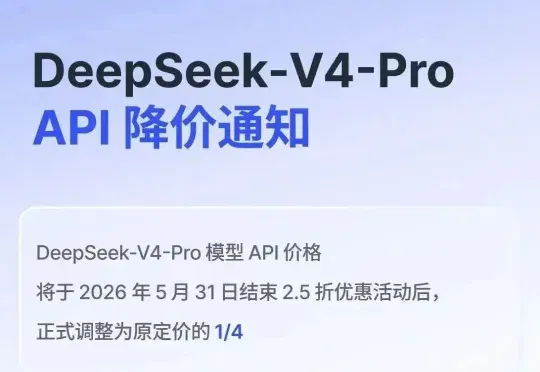
DeepSeek V4-Pro官宣永久降价:这刀砍下去,不打算收回来了(在新窗口打开)
说实话,我原本以为 DeepSeek 的限时优惠会在5月31日结束。毕竟降价75%,打了2.5折,怎么看都像是一波限时引流。5月22号晚上,DeepSeek发了个通知,我看了两遍才确认没看错——DeepSeek V4-Pro永久降价!
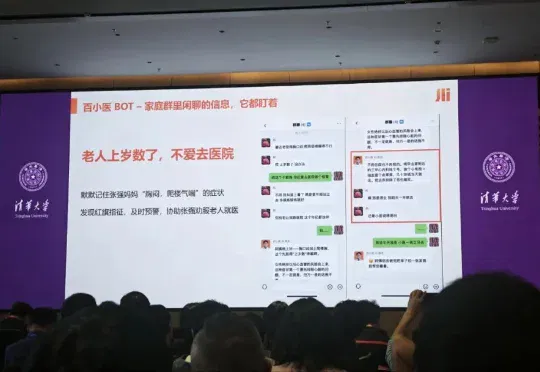
刚刚,王小川掏出AI家庭医生:微信里喊你吃药、帮你盯紧全家健康(在新窗口打开)
今天,百川智能发布了AI家庭医生产品“百小医”,并展示了即将发布的百川新一代医疗大模型Baichuan-M4。“百小医”目前已经上线各大应用市场,而Baichuan-M4会在下个月开放API服务。