Know AI. See What’s Next.
第 1 张,共 5 张:阿里推出全新AI搜索引擎“CleverSee”,云厂商打响AI搜索基建战
最新资讯流
他把Google Workspace接入OpenClaw,然后被谷歌开除了(在新窗口打开)
什么?就因为做出了一个谷歌用户真正想要的工具,谷歌解雇了自家一位工程师。
AI软递归自我提升,Hassabis夜不能寐:人类已至奇点山脚(在新窗口打开)
AI递归自改进和AI研究自动化正在从概念走向现实。对此,哈萨比斯夜不能寐。
3年3000万美元ARR,华人小团队GPTZero被赛道No.1收购了(在新窗口打开)
今天,「Grammarly」母公司「Superhuman」宣布收购「GPTZero」,后者为 2 个华人联创 Edward Tian 和 Alex Cui 创立的 AI 检测工具,在去年进行产品定位重构。根据双方声明,「GPTZero」成立三年后 ARR 达 3000 万美元、注册用户 1900 万,团队不到 30 人。
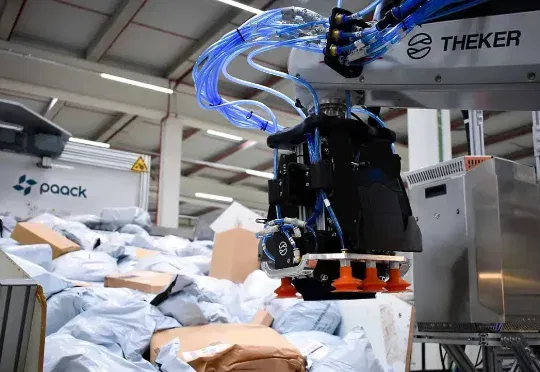
西班牙AI机器人公司Theker 完成7300万欧元A轮融资,Zara母公司Inditex、LVMH、三星均已战略出手(在新窗口打开)
近日,西班牙AI机器人公司 Theker 宣布完成7300万欧元(约合8500万美元)的A轮融资。这是欧洲机器人领域史上规模最大的A轮融资。时尚巨头Zara的母公司Inditex不仅是公司早期投资方,公司机器人已在Inditex的实际生产设施中运行。
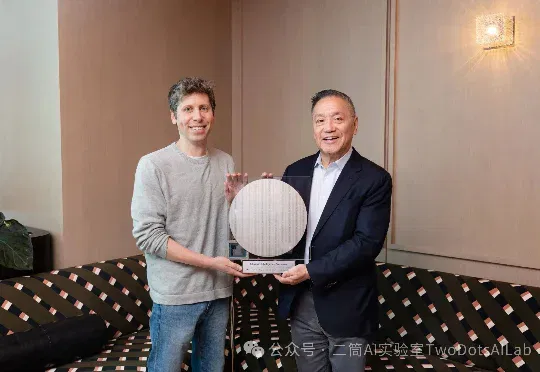
刚刚,OpenAI发布首款AI芯片,九个月完成流片(在新窗口打开)
美国当地时间6月24日,OpenAI与博通联合发布了双方合作的首款定制芯片Jalapeño。这是一款专用集成电路(ASIC),专门针对大语言模型的推理任务而设计,也标志着OpenAI正式进军AI芯片领域。
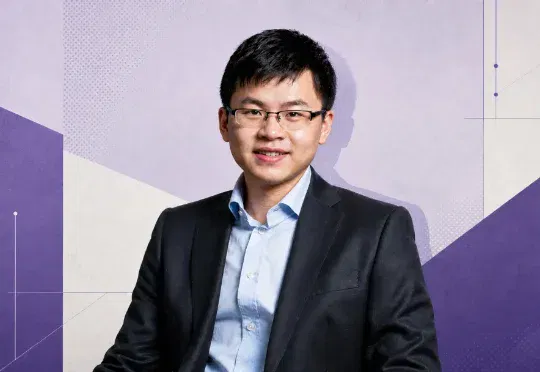
独家|姚颂三度创业,Striding AI获近亿美元融资入局物理智能(在新窗口打开)
公司由姚颂联合正大集团、清华青年学者于超共同发起,定位为物理智能系统公司,通过世界动作模型(WAM)与强化学习技术,推动机器人在真实商业与工业场景中落地,最终成为一个可信赖的机器人服务提供商。目前已完成近亿美元天使轮系列融资,投资方包括正大集团、华勤技术、九安医疗等多家上市企业,多位国内与国际知名企业家,以及多家一线投资机构。
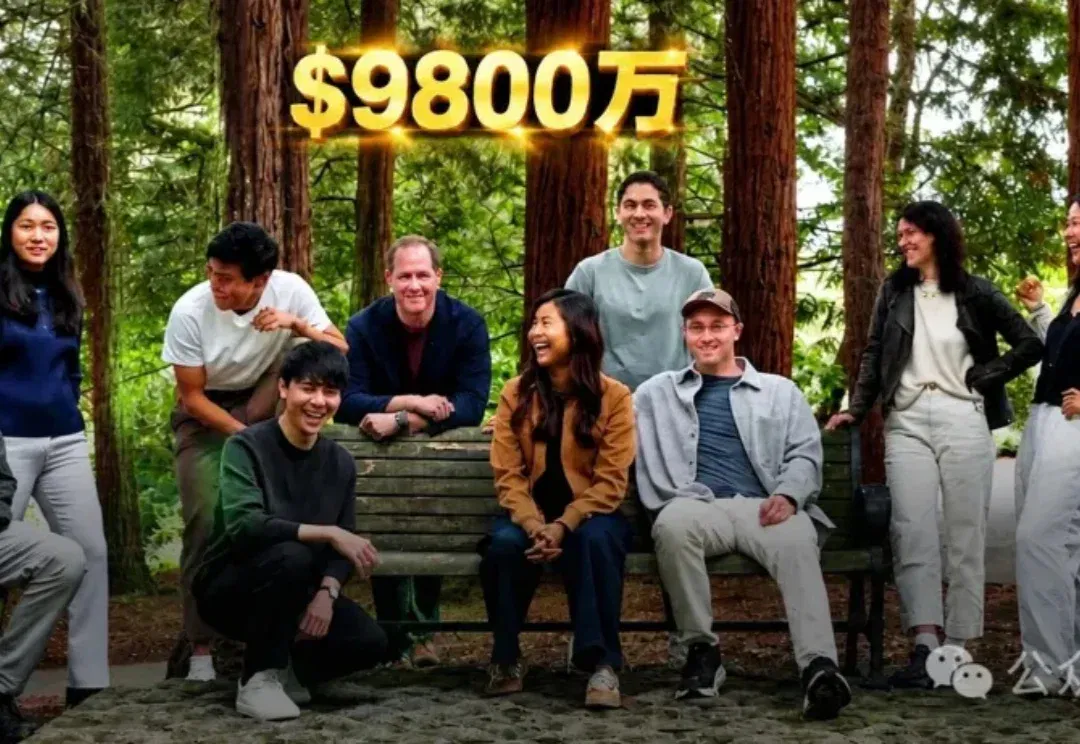
Karpathy刚进Anthropic,转头又投了它(在新窗口打开)
AI大神Karpathy重注!一家叫Engram公司出山,13个人团队,要让AI永久记住你。
全球算力分布地图曝光:谁掌握能源,谁掌握AI未来(在新窗口打开)
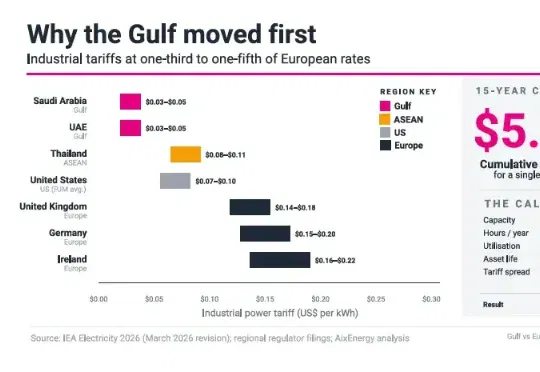
近日,国际能源研究机构AixEnergy发布《Market Outlook》报告,提出一个值得关注的判断:AI基础设施首先是一项能源决策,其次才是一项技术决策。报告认为,决定未来全球AI版图的关键因素,正从芯片、模型和算法,转向稳定、低成本且能够快速接入的能源系统。海湾国家凭借廉价电力迅速崛起,美国受制于电网瓶颈,中国则依托新能源和产业链优势加速布局,东南亚正试图成为新的算力高地。
端侧跑大模型,现在也太简单了(在新窗口打开)
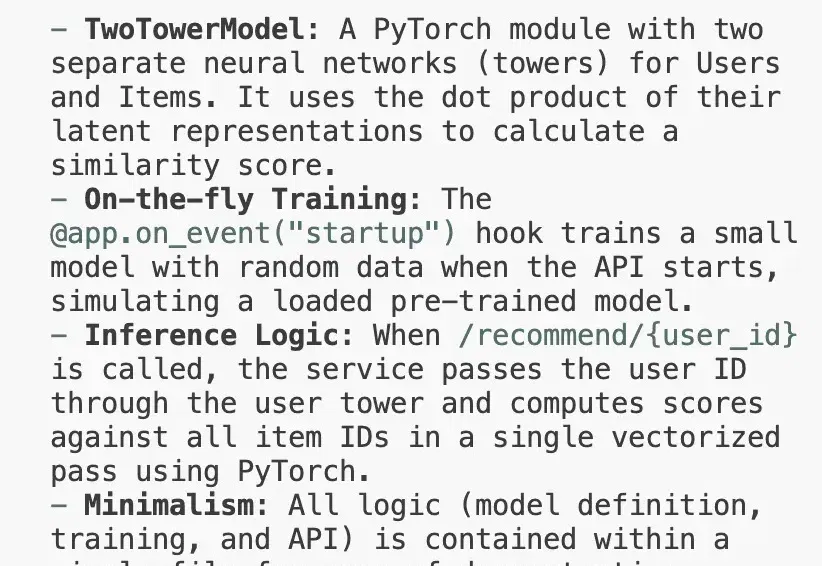
最近,我们都在关注旗舰级大模型的进步,其实本地运行的 AI 模型也迎来了重要的分水岭。
开源!阿里甩出首个语言世界模型,能造智能体环境(在新窗口打开)
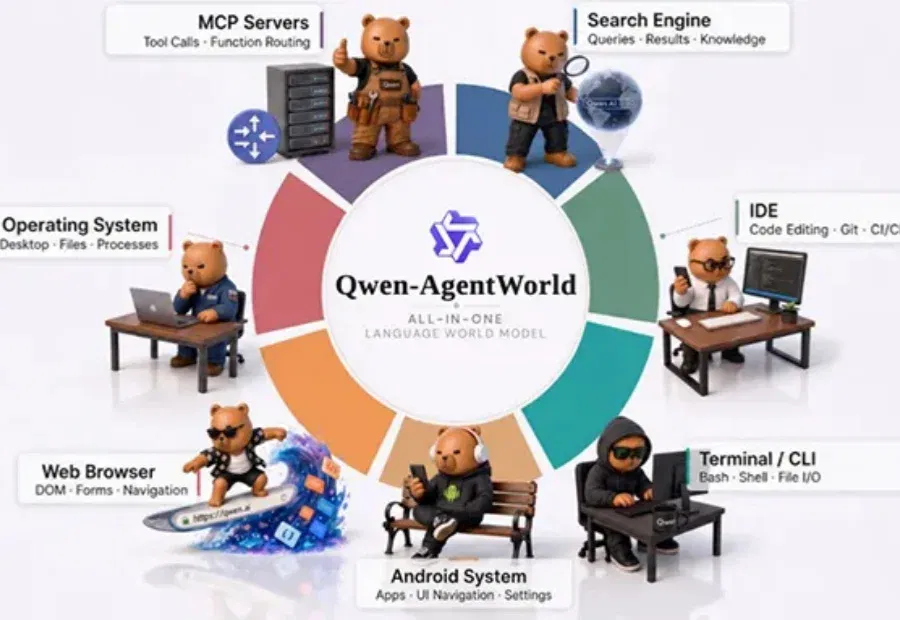
一个模型能模拟7种环境。 智东西6月24日消息,刚刚,阿里千问大模型上新,发布首个原生语言世界模型(LWM)Qwen-AgentWorld,该模型有35B-A3B与397B-A17B两种参数规模。 该模型专门为各类AI智能体研发与训练而生。在博客中,研究人员提到,该语言世界模型的核心目的不是降成本、替代智能体的真实交互环境,而是为了增强通用智能体的能力。其可以让智能体在做动作前,先在内部模拟环境反馈再决策。 Qwen-AgentWorld两大核心亮点为: 从预训练阶段就将环境建模作为训练目标,贯穿CPT→SFT→RL全流程。此前完整训练通用基础大模型,往往会在训练结束后,才开始教AI理解环境、
智谱与Anthropic是母凭子贵(在新窗口打开)
Anthropic增加绿卡认证后,最开心是智谱,直接原地化身战狼,高呼「前沿智能属于所有人」,提前把专注Coding的GLM5.2发了。
紧跟诺奖得主,斯坦福经济学泰斗火速入职Anthropic!(在新窗口打开)
IPO敲钟前夜,Anthropic再放大招!Chad Jones官宣入职,用最硬经济学炮抢占国家AI政策最高话语权。
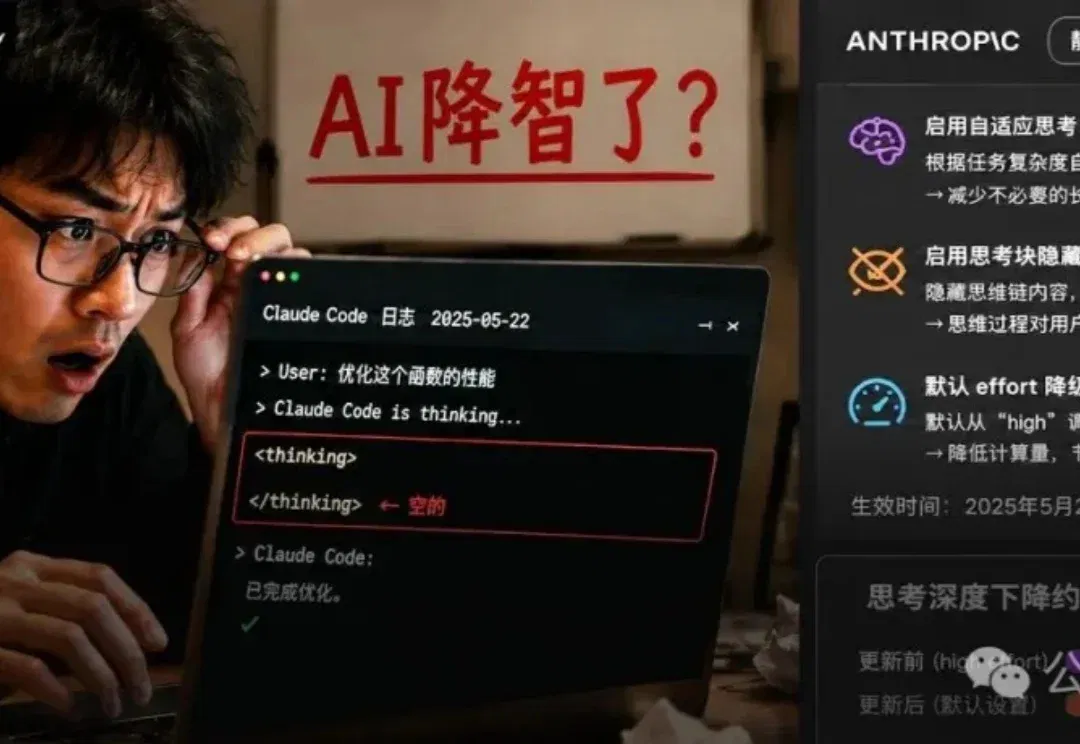
Claude惊人真相被教授曝光:思考过程加密,给钱也看不到!(在新窗口打开)
当初,Anthropic推出extended thinking的时候,把它包装成「让用户看到思考过程」的透明标杆。现在真相是:你看到的只是他们允许你看到的部分。那些被加密、被压缩、被锁在全局密钥里的内容,藏着什么?
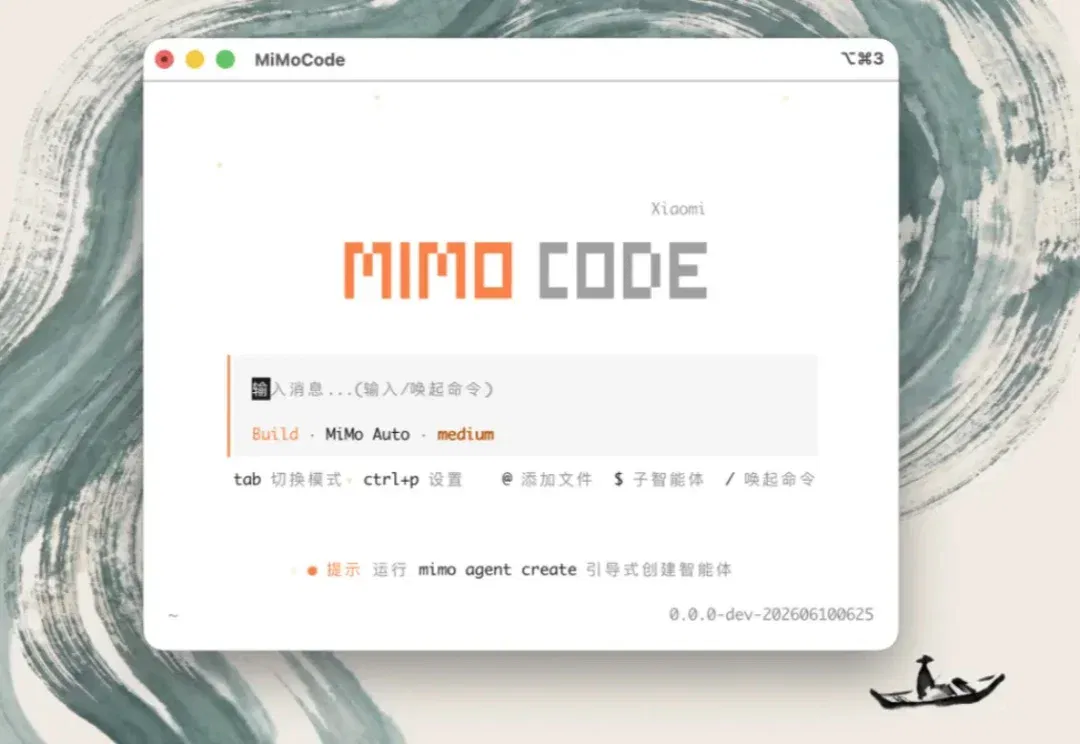
Mimo Code 爆火:我们挖开源代码,找到小米 AI 的真创新(在新窗口打开)
6 月 11 日凌晨,小米 MiMo 团队公开了一个叫 MiMo Code 的项目,定位是终端编程 Agent,MIT 协议开源。官方宣传重点有三处,14 天 5 人团队投入的“vibe coding”开发叙事、Claude Code 之上的 SWE-Bench Pro 跑分。以及“无限上下文”的记忆架构。
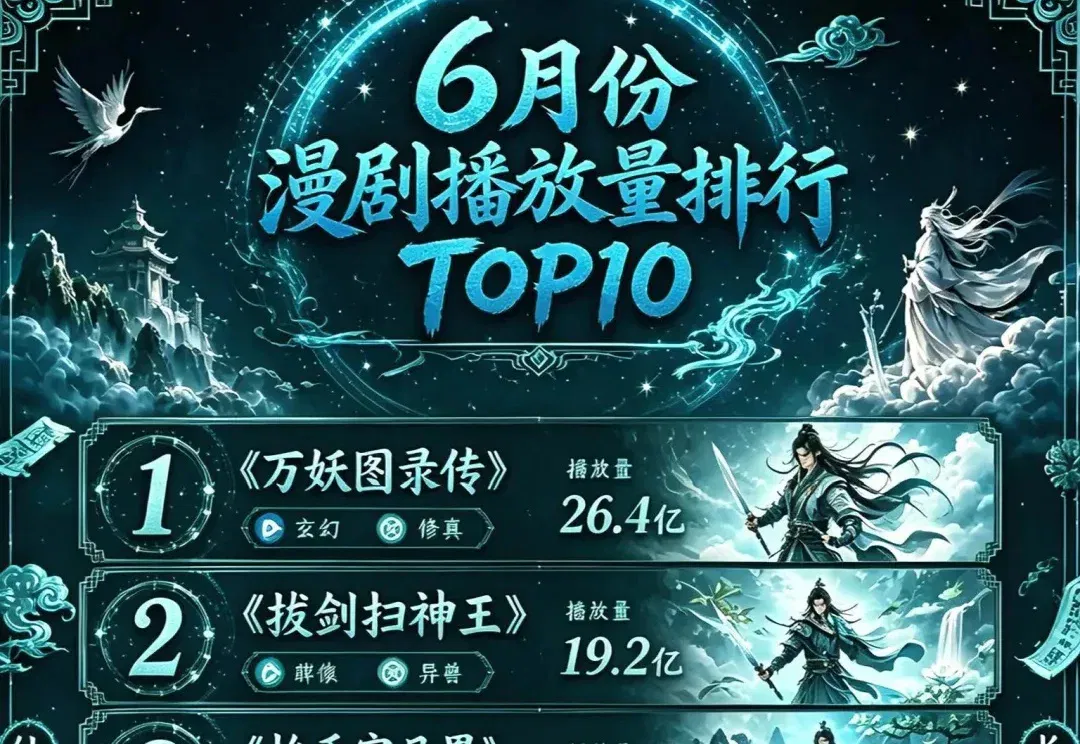
从0到1跑通AI爽剧:超高质量短剧制作全流程SOP直接拿走!【建议收藏】(在新窗口打开)
大家好,我是最近疯狂研究短剧的袋鼠帝 最近的AI漫剧发展的是真快啊,各种爽文小说改编的AI漫剧播放量甚至已经超过了某些电影和电视剧。
突发!美国商务部拟对中国机器人出手(在新窗口打开)
美方官员被曝坦言,美国已流失下一代机器人配套产能。
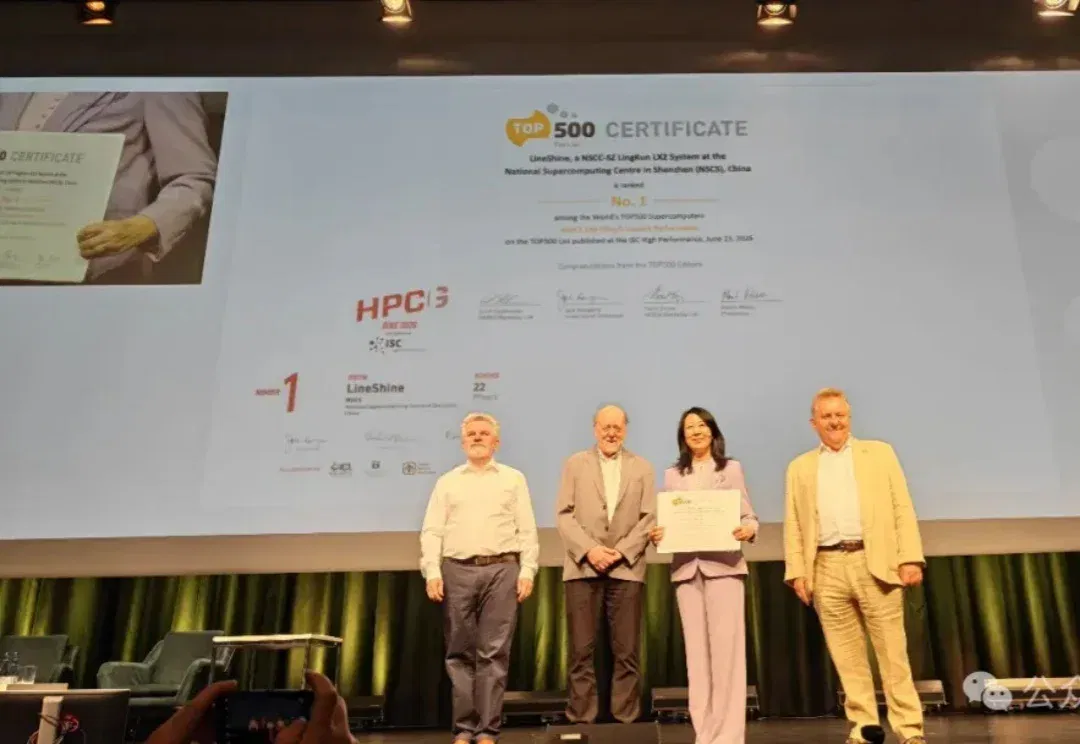
零GPU,世界第一超算!深圳制造改写游戏规则了(在新窗口打开)
全球最强超算,易主了! 中山大学教授带队、深圳制造的灵晟超级计算机,刚刚登顶全球超算TOP500榜单,打破了西方近十年的垄断地位。 更让人惊诧的是,这个TOP1超算,含英伟达量为0,甚至一块GPU也没用。 在超过2EFlops的超算系统中,独一无二,惊诧友邦。 △来源:中山大学计算机学院官微 具体来说,灵晟采用了自主可控的纯CPU架构,CPU芯片、存储架构和高速互连网络全部自研。 图灵奖得主Jack Dongarra评价,灵晟是“AI4S新型架构的希望之光”,将重新划定全球算力竞争格局。 0GPU含量,全链路自主可控 灵晟没有使用一块GPU,这在今天的超算领域几乎是一个异类。 El Capit
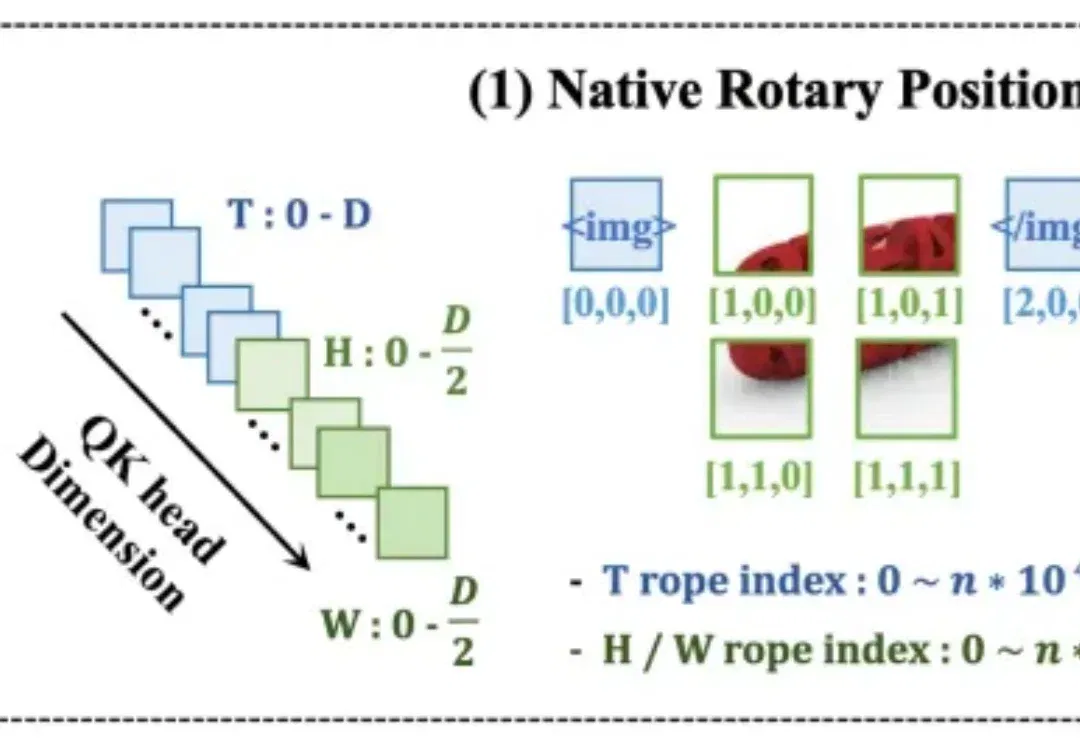
直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能(在新窗口打开)
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
云计算一哥,让小鹏、Kimi和猎豹都爽了一把(在新窗口打开)
有这么一组数据,是真真儿地戳到了用Agent这件事的爽点。
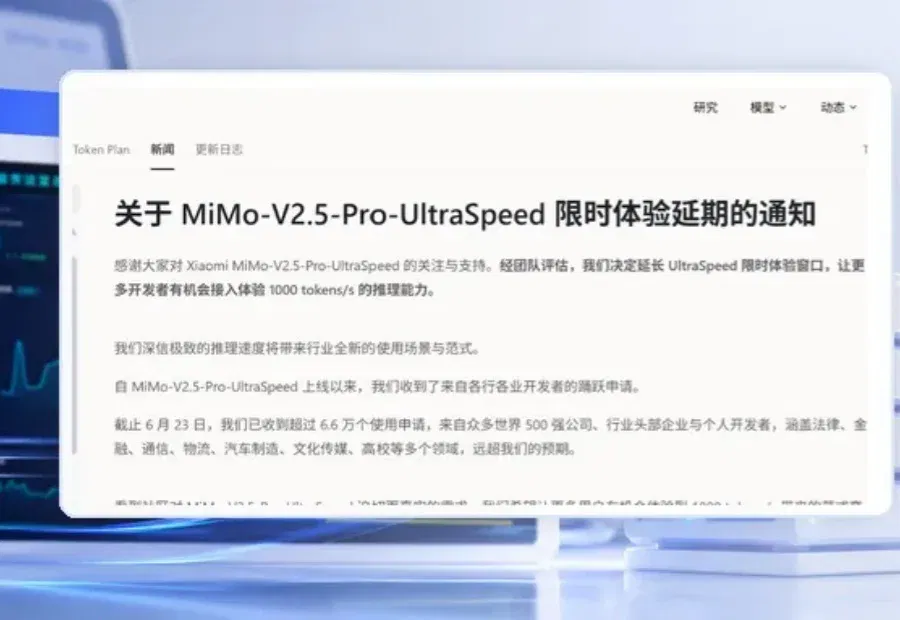
6.6万人排队!小米旗舰“超速”模型延长体验时间,官方:500强争着用(在新窗口打开)
小米UltraSpeed需求远超预期。 智东西6月24日消息,昨日,小米MiMo开放平台发布公告,宣布延长旗下MiMo-V2.5-Pro-UltraSpeed模型的聊天体验与API接入体验期限。该模型于6月9日上线,原定体验窗口截至6月23日,但由于申请量远超预期,团队决定延长开放时间。 ▲关于MiMo-V2.5-Pro-UltraSpeed限时体验延期的通知(图源:小米MiMo) 官方数据显示,截至6月23日,MiMo-V2.5-Pro-UltraSpeed已收到超过6.6万个使用申请,申请者包含世界500强公司、行业头部企业与个人开发者,涵盖法律、金融、通信、物流、汽车制造、文化传媒、高校